For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/grok-4-6-released-agentic-performance.md.
SpaceXAIは2026年8月12日にGrok 4.6を発表し、プログラミング、長時間実行されるエージェントタスク、知識業務向けの最先端モデルとして位置づけました。このモデルはGrok 4.5を直接ベースに構築されており、b
SpaceXAI は 2026 年 8 月 12 日に Grok 4.6 をリリースし、プログラミング、長期エージェントタスク、ナレッジワーク向けの最先端モデルとして位置づけました。
本モデルは Grok 4.5 を直接ベースに構築されていますが、焦点はより明確かつ実用的です:より長い連続的な作業における効率性の維持、複数ステップにわたるツールの使用、インタラクティブおよびビジュアルアプリケーション向けの高品質な初期バージョンの生成です。
SpaceXAI と Cursor によると、Grok 4.6 は Artificial Analysis インテリジェンス指数において GPT-5.6 Sol と同等の水準に達しており、GDPval-AA v2 や AA-Briefcase などの実世界エージェント評価では特に優れた成績を示しています。
AIBase の原文では、Grok 4.6 の価格とサービス速度も重点的に紹介されています。価格優位性は公式ドキュメントで十分に裏付けられています。速度データについてはより詳細な解釈が必要です:AIBase は 80 TPS と報告していますが、Artificial Analysis が現在測定したファーストパーティの Grok 4.6 API は約毎秒 68 出力トークンです。実行時速度はインフラストラクチャ、プロンプト長、推論強度、プロバイダーの負荷によって変動します。
Grok 4.6 は、まったく新しいアーキテクチャのリリースではなく、段階的なモデル世代です。
SpaceXAI によると、新モデルは Grok 4.5 よりも長時間の追加トレーニングを受けています。トレーニングデータの構成は以下の通りです:
同社は、Grok 4.5 を STEM、ソフトウェアエンジニアリング、ナレッジワークタスクの教師ありファインチューニング軌跡の再生成にも使用し、モデルベースのフィルターで問題のある痕跡を除去したと述べています。
Grok 4.5 は、すでに超大規模なトレーニングを完了していました。
SpaceXAI は公式に、Grok 4.5 のトレーニングには数万基の NVIDIA GB300 GPU が使用されたと述べています。そのトレーニングデータはプログラミング、科学、エンジニアリング、数学をカバーし、強化学習は主にマルチステップのソフトウェアエンジニアリングタスクやその他の長期技術作業に焦点を当てていました。
Grok 4.6 は、この基盤の延長線上にあるものであり、置き換えるものではありません。
最も重要な変化は、持続的なエージェント行動への重視にあります:モデルは孤立したプログラミング問題を解決するだけでなく、研究、ファイル編集、ツール使用、自身の作業のテスト、複数ラウンドのフィードバックによる反復プロセスを通じて一貫性を維持する必要があります。
SpaceXAI によると、Grok 4.6 は広範なエージェント強化学習タスクセットでトレーニングされています。
これらの環境には以下が含まれます:
これは、短い回答の推論よりも拡張的な作業を伴う評価で本モデルが最も顕著な成績を示す理由を説明するのに役立ちます。
SpaceXAI と Cursor はまた、以下の点も強調しています:
本モデルが幅広い製品コンセプトを実用的な初期バージョンに変換する能力です。
内部テストにおいて、Grok 4.6 は以下を実行できました:
これは、一度の生成で完成したアプリケーションがすべて本番環境対応レベルに達していることを意味するものではありません。これは単に、同社が初期出力の品質が Grok 4.5 よりも優れていることを発見したことを示しています。特に、コード、デザイン、インタラクション、反復的なツール使用を組み合わせる必要があるタスクにおいて顕著です。
Artificial Analysis は現在、Grok 4.6(ハイバージョン) にインテリジェンス指数 61 のスコアを与えています。
これは、SpaceXAI が発表した比較における GPT-5.6 Sol(最高バージョン) の合計スコアと同じです。
この指数は単一のテストではなく、9 つの評価の複合結果であるため、両モデルがすべてのワークロードで完全に同じ性能を持つことを証明するものではなく、広範な比較の参考シグナルとして適しています。
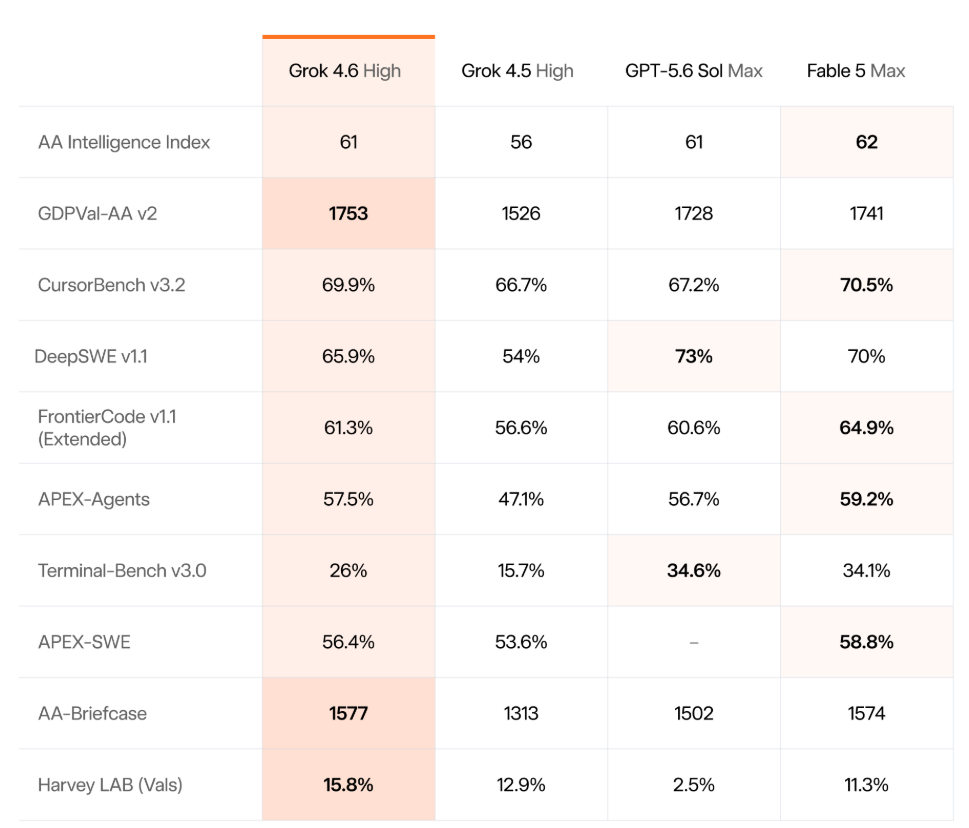
リリース時に添付されたベンチマーク表には、以下の結果が含まれています:
| ベンチマーク | Grok 4.6 ハイバージョン | Grok 4.5 ハイバージョン | GPT-5.6 Sol Max | Fable 5 Max |
|---|---|---|---|---|
| AA インテリジェンス指数 | 61 | 56 | 61 | 62 |
| GDPval-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54.0% | 73.0% | 70.0% |
| FrontierCode v1.1 拡張版 | 61.3% | 56.6% | 60.6% | 63.6% |
| APEX-Agents | 57.5% | 47.1% | 56.7% | 59.2% |
| Terminal-Bench v3.0 | 26.0% | 15.7% | 34.6% | 34.1% |
| APEX-SWE | 56.4% | 53.6% | — | 58.8% |
| AA-Briefcase | 1577 | 1313 | 1502 | 1574 |
| Harvey LAB (Vals) | 15.8% | 12.9% | 2.5% | 11.3% |
ベンチマークの順位は、モデル、テストフレームワーク、評価バージョンの更新に伴って変化します。上記の表はリリース時点の比較結果を反映したものであり、永続的なランキングではありません。
GDPval-AA v2 において、Grok 4.6 は 1753 Elo のスコアを獲得しました。
Artificial Analysis は GDPval-AA v2 を、複数の専門職をカバーする実世界のエージェント型ナレッジワーク評価として説明しています。
Grok 4.6 の分析リリース時点で、Artificial Analysis はこのスコアが Claude Opus 5 シリーズに次ぐものであり、同時に信頼区間は Claude Fable 5 や Qwen3.8 Max などの他の主要モデルと重複していると述べています。
これは、Grok 4.6 が明確に 2 位であると直接宣言するよりも厳密な表現です。
Elo ベースの評価には不確実性があり、近似したスコアは統計的に互いに重複する可能性があります。
Grok 4.6 は AA-Briefcase でも 1577 Elo を獲得しました。
のスコア。これはArtificial Analysisが長期型エージェント知識業務向けに設定したプライベートベンチマークです。
これにより、そのスコアは——
公開されたスナップショットでは、Grok 4.6の性能はおおよそFable 5レベルに相当し、Claude Opus 5シリーズにはやや及ばない水準です。
その効率性の高さも注目に値します。
Artificial Analysisの報告によると、Grok 4.6はAA-Briefcaseタスクの完了時に、おおよそ以下のリソースを使用しました:
一方、Claude Opus 5(最大バージョン)は以下のリソースを使用したと報じられています:
これはGrok 4.6がすべての状況でClaude Opus 5より効率的であることを意味するものではありません。特定のベンチマークにおける観察結果に過ぎません。とはいえ、長期稼働するインテリジェントエージェントにとって、より少ないラウンド数と累積コンテキストの削減は、タスクコストを大幅に引き下げることができます。
標準的な公開API価格は、依然としてGrok 4.6の最も強力な競争優位性の一つです。
長いコンテキスト価格閾値未満のプロンプトの場合、SpaceXAIのドキュメントには以下のように記載されています:
| トークン種別 | 100万トークンあたりの価格 |
|---|---|
| 入力 | 2.00ドル |
| キャッシュ入力 | 0.50ドル |
| 出力 | 6.00ドル |
Artificial Analysisは、インテリジェンス指数スコアが56から61に向上したにもかかわらず、この公開価格がGrok 4.5から据え置かれていることを指摘しています。
比較として、本稿執筆時点では:
これにより、Grok 4.6は高スループットのエージェントループにとって特に魅力的です。これらのシナリオでは、出力トークンと反復コンテキストが総コストの大部分を占める傾向があるためです。
SpaceXAIの公式リリースノートには、短いAIBase記事では言及されていない重要な詳細が追加されています。
20万トークンを超えるプロンプトの場合、Grok 4.6はより高い価格層を適用します:
| トークン種別 | 20万超プロンプト時の100万トークンあたりの価格 |
|---|---|
| 入力 | 4.00ドル |
| キャッシュ入力 | 1.00ドル |
| 出力 | 12.00ドル |
したがって、「入力2ドル/出力6ドル」は開始価格であり、すべてのリクエストに適用される普遍的な価格ではありません。
Cursorは、高速バリアントの価格が標準価格の2倍であるとしています。
これは上記の長いプロンプト価格ルールとは別です。プラットフォームとワークロードに応じて、ユーザーは生産コストを見積もる前に、適用される速度層とコンテキスト層を確認する必要があります。
AIBaseの記事は、Grok 4.6が毎秒80トークンの速度で動作できると述べています。
この数字は慎重に扱う必要があります。
SpaceXAI公式のGrok 4.6発表では、固定の80 TPSサービス速度の保証は発表されていません。Artificial Analysisは現在、ベンチマークワークロードにおいて、ファーストパーティAPI上のGrok 4.6(高)の出力速度を約毎秒67.6出力トークンと測定しています。
比較として、SpaceXAI公式のGrok 4.5発表ページでは、Grok 4.5が80 TPSでサービス提供されることが明記されています。
したがって、短いソース記事は初期の80 TPSの数字を踏襲したか、異なるサービス層を引用した可能性があります。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
実際の要点はよりシンプルです:
Grok 4.6はフロンティア推論モデルとしてはかなり高速ですが、すべてのプロンプト、プロバイダー、推論強度、速度層に適用される単一の固定TPS数値は存在しません。
SpaceXAI APIドキュメントは、grok-4.6のコンテキストウィンドウを50万トークンと記載しています。
このモデルは以下をサポートしています:
公式モデルページには、知識カットオフ日が2026年2月1日と記載されています。
CursorのGrok 4.6モデルドキュメントは現在、Cursor内の256kコンテキストウィンドウを記載しています。
これはベースモデルの仕様と矛盾するものではありません。プラットフォーム統合が、ファーストパーティのSpaceXAI APIよりも小さいコンテキスト制限を公開できることを意味します。
モデル制限を比較する際は、使用している正確なプロバイダーと統合方法を常に確認してください。
SpaceXAIの公式モデルIDは以下の通りです:
grok-4.6
最小限のResponses APIリクエストは以下のようになります:
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -d '{
    "model": "grok-4.6",
    "input": "バグを見つけて修正し、説明してください:function median(a){a.sort();return a[a.length/2]}"
  }'
同じモデルは、公式xAI SDKおよびOpenAI互換のAPIクライアントからも利用可能です。
import os
from xai_sdk import Client
from xai_sdk.chat import user

client = Client(api_key=os.getenv("XAI_API_KEY"))

chat = client.chat.create(model="grok-4.6")
chat.append(
    user(
        "バグを見つけて修正し、説明してください:"
        "function median(a){a.sort();return a[a.length/2]}"
    )
)

response = chat.sample()
print(response.content)
長時間稼働するエージェントループでは、SpaceXAIは適切な場合にプロンプトキャッシュとコンテキスト圧縮を使用して、反復コンテキストのコストを削減することを推奨しています。
リリース時点で、Grok 4.6は以下のプラットフォームで利用可能です:
SpaceXAIとCursorはまた、CursorとGrok Buildで初週2倍の包含利用量を提供しています。
このリリースプロモーションは期間限定であり、恒久的な価格として見なされるべきではありません。
CursorはGrok 4.6を4つの推論強度レベルで表示します:
highがデフォルトの推論強度です。
対象となるCursorプランでは、高速速度層も利用可能です。
Cursor内では、このモデルはプラットフォームのエージェントツールを使用して以下のタスクを実行できます:
これは、Grok 4.6のリリースがエージェントベンチマークをこれほど重視した理由の一つです。その想定用途は孤立したチャット補完に限定されないからです。
Grok 4.6は、持続的な作業を必要とするタスクで最も強力です。
ベンチマークテストの結果は、Grok 4.6の最大の進歩が単なる静的推論にあるわけではないことを示しています。
その改善は、タスクが以下の要素を含む場合に最も顕著です:
これにより、以下の用途に特に適しています:
長時間実行されるナレッジワーカータスク
短くシンプルなプロンプトでは、この優位性はそれほど顕著ではないかもしれません。
公開データは以下の明確な結論を裏付けています:
しかし、データはGrok 4.6がGPT-5.6 SolやClaudeよりもすべてのタスクで普遍的に優れていることを証明するものではありません。
例えば、同じ公開テーブルでは、GPT-5.6 Sol が DeepSWE v1.1 と Terminal-Bench v3.0 でリードし、Claude Fable 5 は他の複数のプログラミングおよびエージェント評価でリードしています。
したがって、モデル選択は単一の総合スコアではなく、実際のワークロードに基づいて行うべきです。
Grok 4.6は、プログラミング、エージェントタスク、ナレッジワーク向けのSpaceXAIのフロンティアモデルです。Grok 4.5に追加のトレーニングを施し、長時間実行されるエージェント、より強力な初回アプリ構築能力、より持続的なマルチステップワークを強化しました。
それはタスクによります。公開比較では、Grok 4.6 は Artificial Analysis インテリジェンス指数で GPT-5.6 Sol と同等であり、一部のエージェント評価ではリードしていますが、GPT-5.6 Sol は一部のプログラミングベンチマークで依然として強力です。両モデルは価格とコンテキスト長にも大きな違いがあります。
標準価格は、入力トークン100万あたり2ドル、キャッシュ入力トークン100万あたり0.50ドル、出力トークン100万あたり6ドルです。20万トークンを超えるプロンプトの場合、SpaceXAIのドキュメントでは、入力、キャッシュ入力、出力それぞれ100万あたり4ドル/1ドル/12ドルのより高い価格帯が規定されています。
SpaceXAIのファーストパーティAPIは50万トークンのコンテキストウィンドウをサポートしています。Cursorは現在、独自のGrok 4.6統合に対して25.6万トークンのコンテキストウィンドウを提供しているため、実際の制限はプラットフォームに依存します。
はい。SpaceXAIはGrok 4.6をテキストおよび画像入力、テキスト出力をサポートするモデルとしてリストしています。また、このモデルは関数呼び出し、ウェブ検索、X検索、コード実行などのツールもサポートしており、xAI APIを通じて利用できます。
はい。Grok 4.6はCursorで利用可能であり、xhigh、high、medium、lowの推論強度をサポートしています。Cursorはまた、ファイル操作、シェルコマンド、ブラウジング、その他のプログラミングワークフローのためのエージェントツールセットへのアクセスを提供しています。
いいえ。Grok 4.6はプロプライエタリなモデルであり、SpaceXAIはモデルの重みやパラメータ数を公開していません。
AIBaseは毎秒80トークンと報告していますが、現在のArtificial Analysisの測定では、ファーストパーティのGrok 4.6 APIはベンチマークワークロード下で毎秒約68出力トークンです。速度は、推論強度、プロンプトサイズ、インフラストラクチャ負荷、プラットフォーム層によって異なります。
Grok 4.6 は Grok 4.5 のターゲットを絞ったアップグレードであり、長時間実行されるエージェント、コーディング、ナレッジワーク、インタラクティブなプロジェクトでの初回実行品質に重点を置いています。そのリリース結果により、現在のモデル評価の最前線に位置し、Artificial Analysisインテリジェンス指数で61点を達成——公開比較ではGPT-5.6 Solと同等です。
今回のリリースの最大の強みは、エージェント性能と価格の組み合わせです。Grok 4.6は入力トークン100万あたり2ドル、出力トークン100万あたり6ドルから始まり、GDPval-AA v2 と AA-Briefcase でも高いスコアを記録しています。長いプロンプトや高速層はコスト増加をもたらす可能性があるため、本番環境の見積もりには正確なプロバイダー設定を使用すべきです。
公表された80 TPSのデータは注意して扱う必要があります:現在の独立した測定値は毎秒約68出力トークンに近く、サービス速度は時間とともに変化します。
**Grok 4.6
の主な強みは、すべてのベンチマークテストで勝利したことではなく、現在、非常に競争力のある価格で最先端レベルのエージェント性能を提供していることにある。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



