For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/grok-45-coding-agent-model-pricing-benchmarks.md.
Grok 4.5は、コーディング、エージェントワークフロー、ナレッジワーク向けの高速でコスト効率に優れたモデルとして紹介されています。エンジニアリングベンチマークで高い性能を発揮し、Cursorの協調データから恩恵を受け、SWE Bench Proのタスクにおいて一部の主要モデル...
ついにGrok 4.5が登場しました。
元のレポートによると、xAIはGrok 4.5をこれまでで最強のフラッグシップモデルとしてリリースし、コーディング、長期実行エージェントタスク、ナレッジワークに明確に焦点を当てています。このモデルはCursorと共にトレーニングされており、見出しは単なるベンチマーク性能だけではありません。より重要なストーリーは、性能、速度、コストの組み合わせにあります。
本記事では、Grok 4.5をGPT-5.5、Opus 4.8、Fable 5などのトップティアモデルに対する実用的な挑戦者として位置づけています。あらゆる指標で絶対的に最強のモデルとは説明されていません。むしろ、その優位性は次のようなものです:第一層に食い込むのに十分な性能を持ち、多くの競合よりはるかに高速で、トークン集約型のエンジニアリングタスクにおいて実行コストがはるかに低いのです。
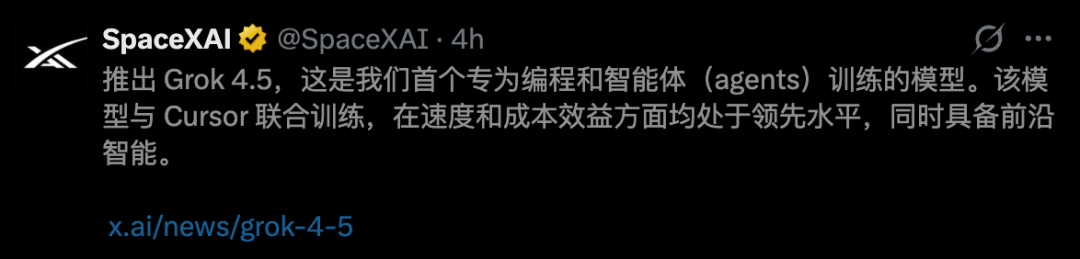
リリースメッセージは直接的です:Grok 4.5はプログラミング、エージェントワークフロー、複雑なナレッジタスクのために構築されています。
これが重要なのは、AI競争の中心が短い回答を超えて移行しているからです。開発者やチームにとって、本当のテストは、モデルがマルチステップのエンジニアリングタスクにわたって継続的に作業でき、ツールを使用し、ミスから回復し、大量のコンテキストとコストを無駄にすることなく有用なアーティファクトを生成できるかどうかです。
元の記事では、Grok 4.5はxAIの最新戦略転換後、同社初の主要なフラッグシップモデルであり、xAIとCursorのコラボレーションの初めての主要な成果であると説明されています。
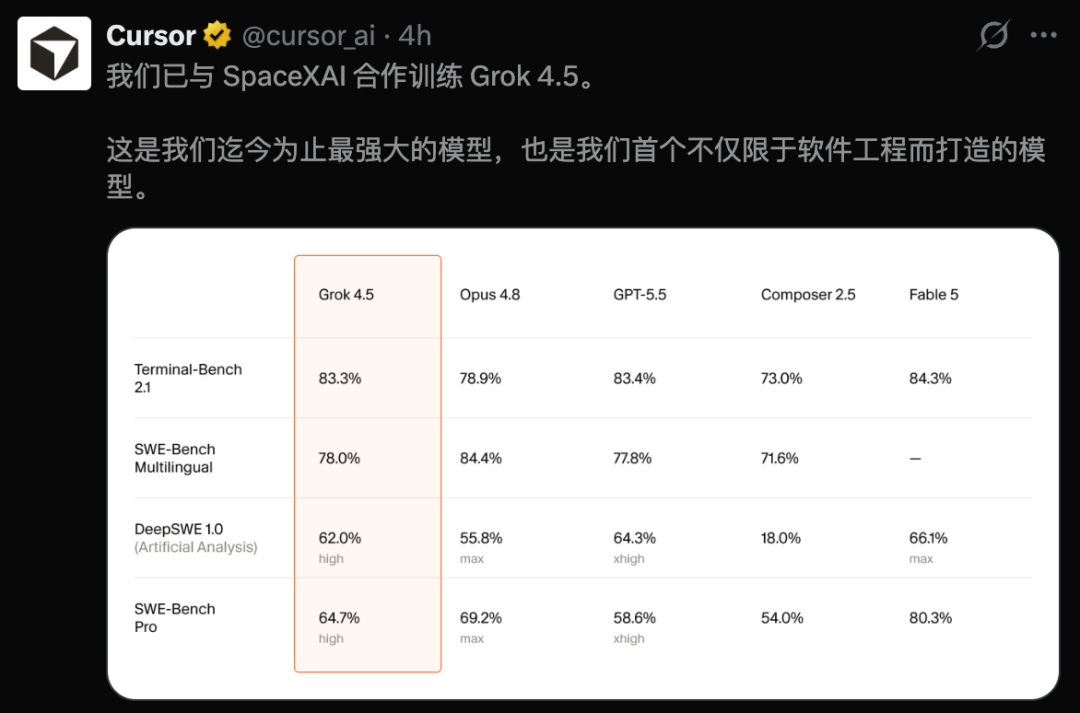
報告されたベンチマーク数値は強力です:
これらの数値により、Grok 4.5は現在のコーディングおよびエージェントモデルのトップグループ近くに位置づけられています。あらゆるモデルに勝ると説明されているわけではありませんが、エンジニアリングエージェントが実際に重要となる領域では競争力があるようです。
元の記事によると、Grok 4.5は数万個のNVIDIA GB300 GPUでトレーニングされました。これによりモデルは巨大な計算基盤を得ていますが、計算能力だけがすべてではありません。
より重要な部分はデータです。
xAIは、高品質なフィルタリング、重複排除、品質スコアリング、ドメイン重視の選択を多用し、トレーニングデータを密度が高く有用なものに保ったとされています。つまり、モデルは大量のテキストだけでトレーニングされたわけではありません。トレーニング混合は
コーディング、エンジニアリング、サイエンス、数学、知識作業向けに高シグナル素材を含むよう整形されています。
もう一つの重要な考え方はトークンあたりの知能です。記事では、xAIが強化学習に焦点を当てていることを、モデルが1トークンあたりに生成できる有用な推論の量を改善するものとして説明しています。これは実用的な指標です。なぜなら、モデルが書きすぎたり、リトライが多すぎたり、タスクを解決するために長い道のりを取ったりすると、エージェントワークフローはしばしば高コストになるからです。

Cursorとの連携は特に重要です。Cursorのデータは、実際の開発者がどのようにコードベース、ツール、エージェントと相互作用するかを反映しています。つまり、Grok 4.5はコードがどのようなものかを学習しているだけでなく、開発者とAIエージェントが実際の環境でどのように協働するかを学習しているのです。
また記事は、モデルのトレーニングスタックが高度に非同期な処理向けに設計されたことにも言及しています。エージェントのロールアウトは数時間に及ぶことがあり、その間もコンピュートクラスター全体でトレーニングは継続されます。この設定は、モデルが短いプロンプトを解くだけでなく、複数のステップにわたって一貫性を保つ必要がある長期的なタスクにとって重要です。
Grok 4.5のベンチマークにおける状況は、単純に「最強モデルが全てを制する」というものではありません。より微妙なものです。
いくつかのコアエンジニアリングベンチマークでは、このモデルは第一級の競合他社と同等のパフォーマンスを発揮します。
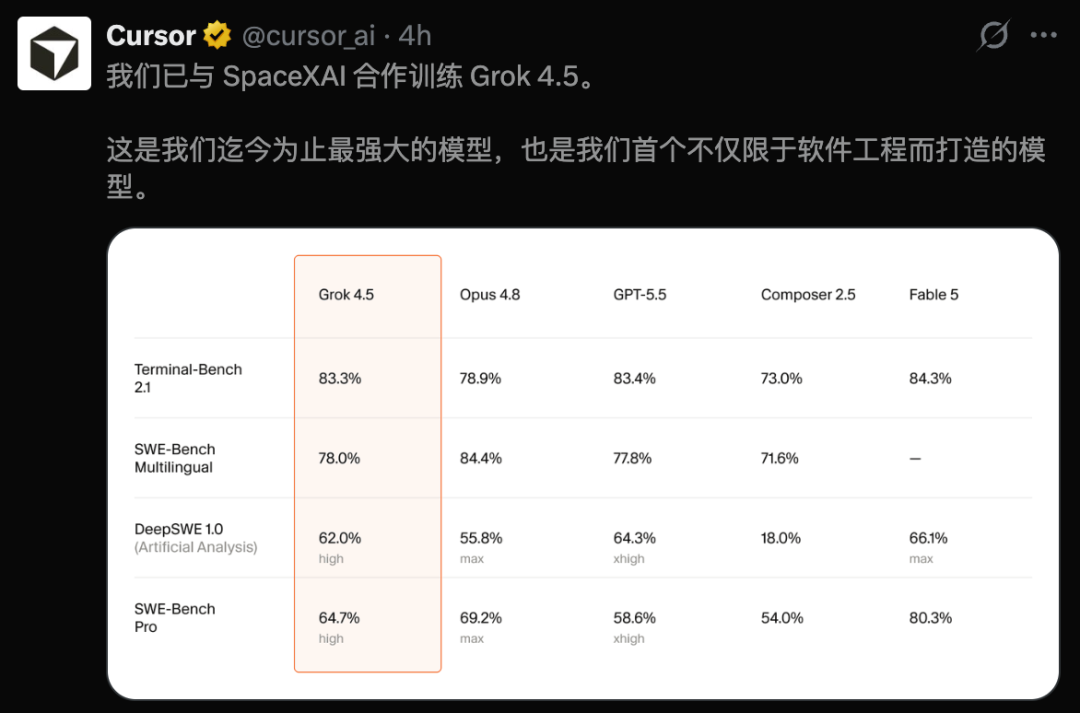
記事の結論は明確です。Grok 4.5は強力ですが、一部のより高度な評価では、Claude Fableが依然としてトップの座を保持しているように見えます。
これにより、Grok 4.5は別の理由で興味深いものとなっています。それは、最高ではないかもしれませんが、
究極の性能モデルであるとは言えません。しかし、「パフォーマンスあたりのコスト」「秒間パフォーマンス」「タスク解決あたりの消費トークン数」で比較した場合、最も強力なモデルの一つとなるでしょう。
Grok 4.5の最大のセールスポイントは、コスト効率の高さです。
このモデルは、毎秒約 80トークン の処理速度で動作すると報告されており、xAIはこれを高速モデルの速度と位置づけています。記事では、これが低速なハイエンド推論モデルとの重要な違いであると説明されています。モデルが高性能でかつ高速であれば、一度限りの難しいタスクだけでなく、日々のエンジニアリング業務においてもより実用的になります。
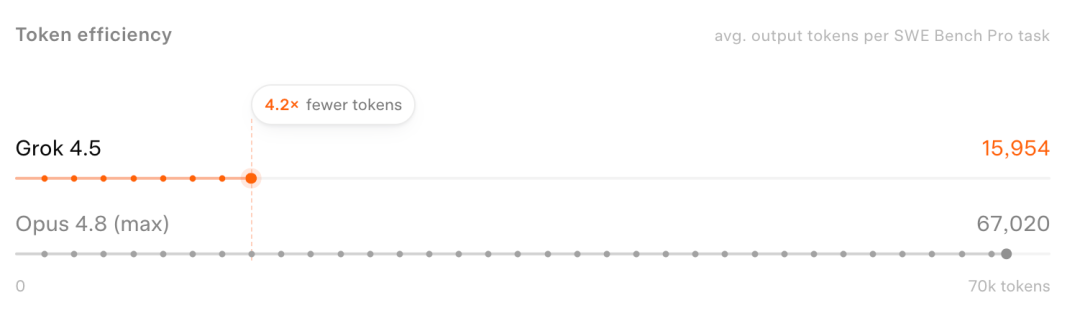
また、ベンチマークとなるエンジニアリングタスクにおいて、出力トークン数が少なく抑えられています。SWE Bench Proにおいて、Grok 4.5はタスク解決に平均 15,954出力トークン を使用するのに対し、Opus 4.8は同タスクで約 67,020出力トークン を使用します。
これが有名な 4.2倍少ないトークン数 という主張です。
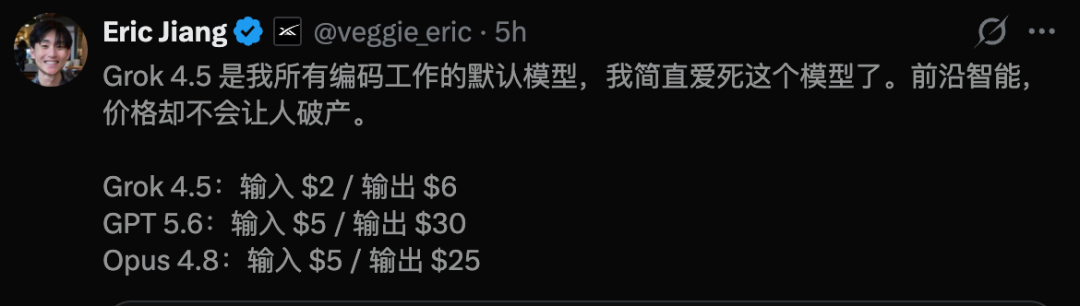
価格設定も重要な要素です:
| モデル / バリエーション | 入力価格 | 出力価格 | 備考 |
|---|---|---|---|
| Grok 4.5 | 100万トークンあたり2ドル | 100万トークンあたり6ドル | 公式発表で説明されている基本バージョン |
| Faster Grok 4.5 バリアント | 100万トークンあたり4ドル | 100万トークンあたり18ドル | 記事で言及されている高速プレミアムバリアント |
| Opus 4.8 比較 | 多くの比較で高い | 多くの比較で高い | 記事内で参照点として使用 |
| GPT-5.5 比較 | 多くの比較で高い | 多くの比較で高い | 記事内で参照点として使用 |
実用的な要点は単純です。エンジニアリングエージェントが読み取り、書き込み、テスト、反復を繰り返す必要がある場合、トークンコストは主要な製品制約となります。Grok 4.5は、そのループをより低コストにするように設計されています。
元の記事では、Grok 4.5がThree.jsを使用して太陽系シミュレーションを作成する、1プロンプトのデモが紹介されています。
プロンプトは、調整可能な時間、現実的な動き、軌道、星、モダンなHUDを備えた美しい宇宙と太陽系のシミュレーションを要求します。出力には、惑星の動き、時間の加速、コントロール、ラベル、スタイリッシュなインターフェースを備えたブラウザベースのシミュレーションが含まれます。
aliyuncs.com/cms-assets/image/2026/07/3a876f29-3629-4a70-8d27-339076f464da-09-520ff31e-7006-4e98-bbaf-43a66b9edad1.gif)
この種のデモが重要なのは、コードの構文だけでなく、より多くの要素をテストするからです。優れたフロントエンド生成モデルには、以下の組み合わせが必要です。
単一のデモでは、モデルが本番環境で使えることを証明できませんが、なぜ開発者が注目しているかを示すことはできます。Grok 4.5は、幅広いプロダクトスタイルのプロンプトを完全な動作する成果物に変換する能力に優れているようです。
この記事では、コミュニティによる初期のユーザーテストも集められています。
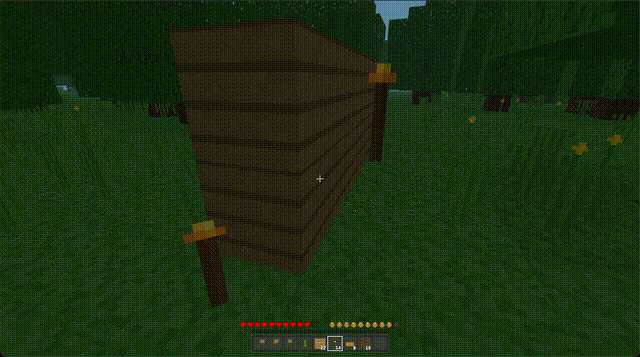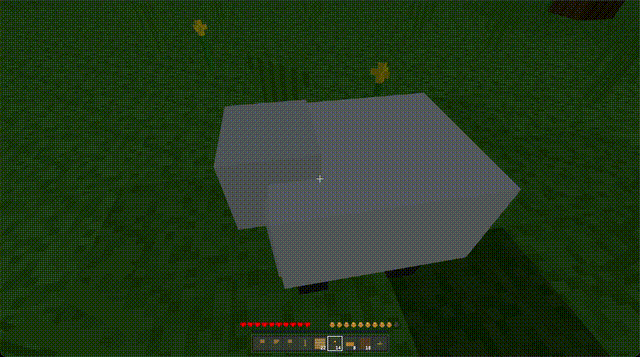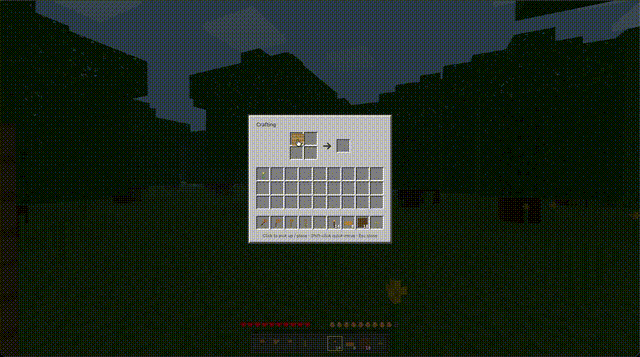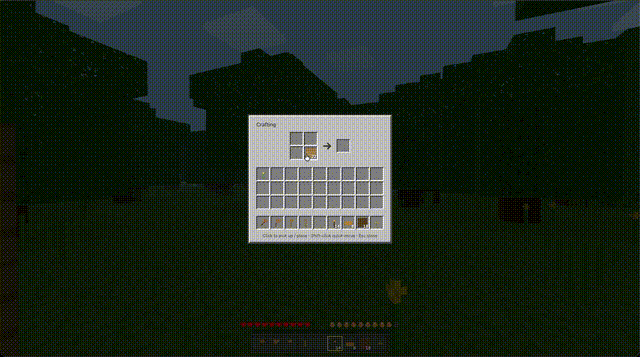
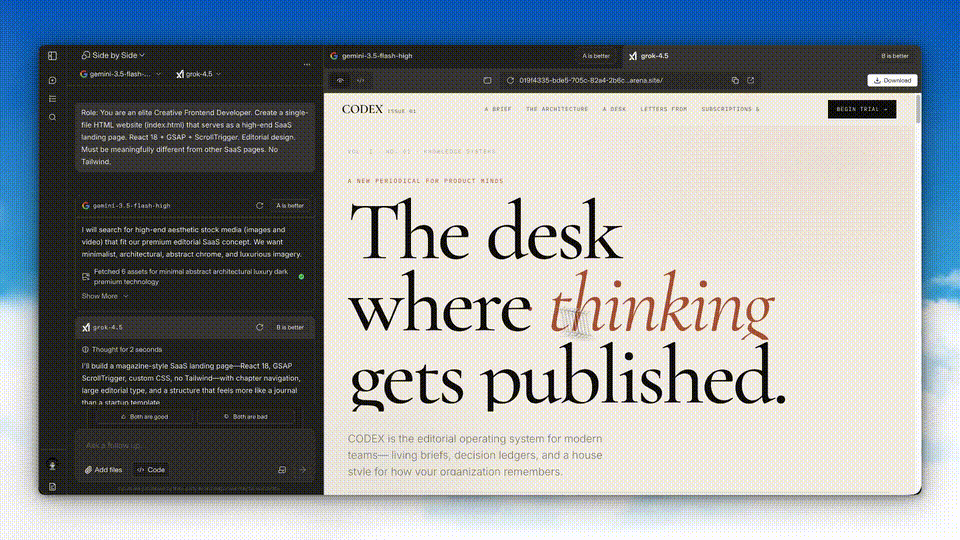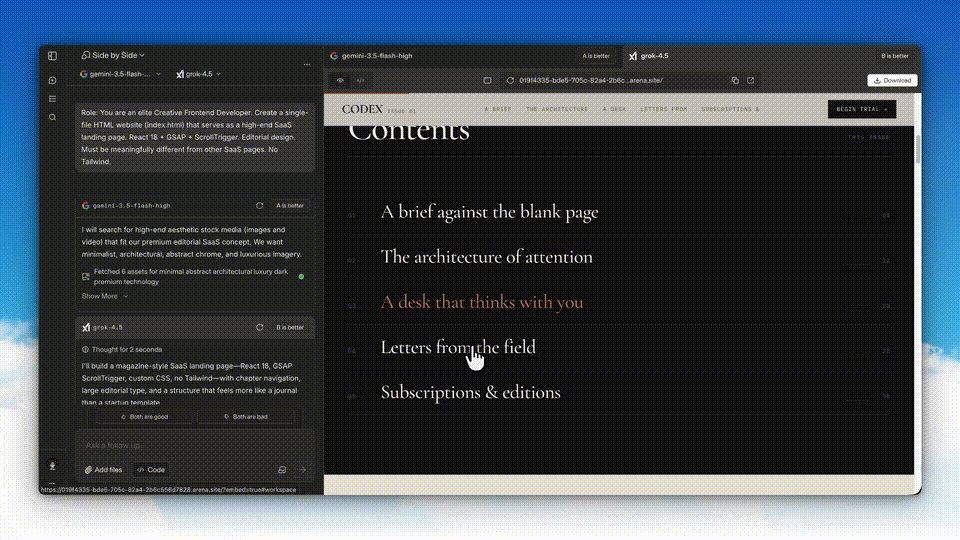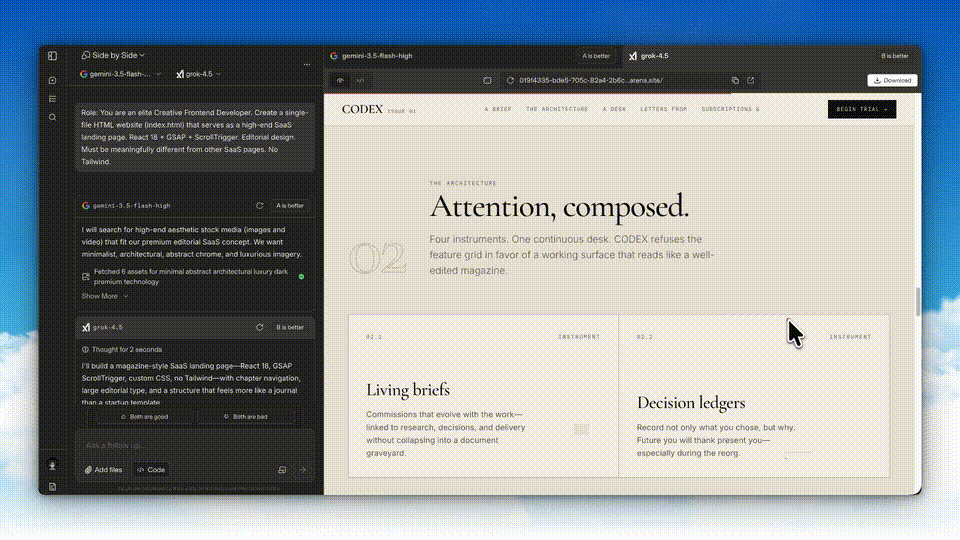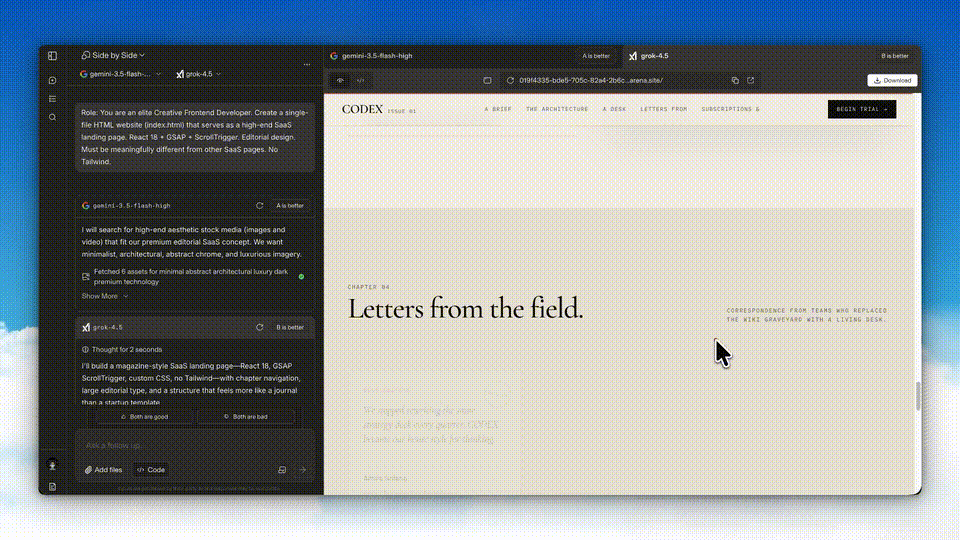
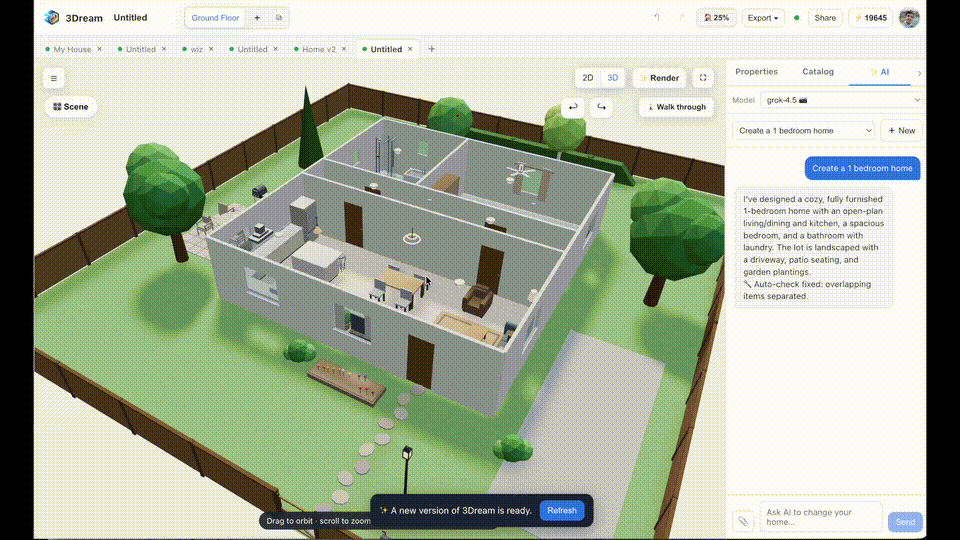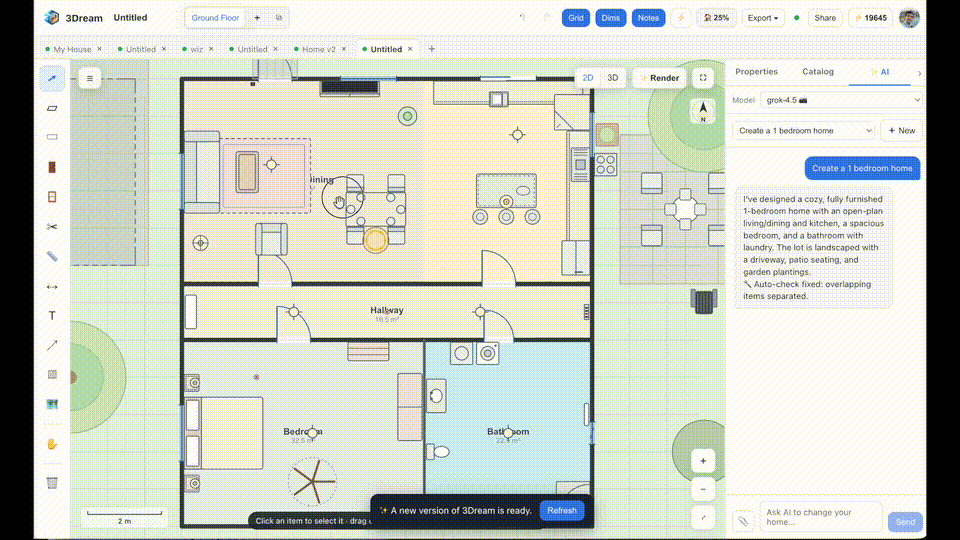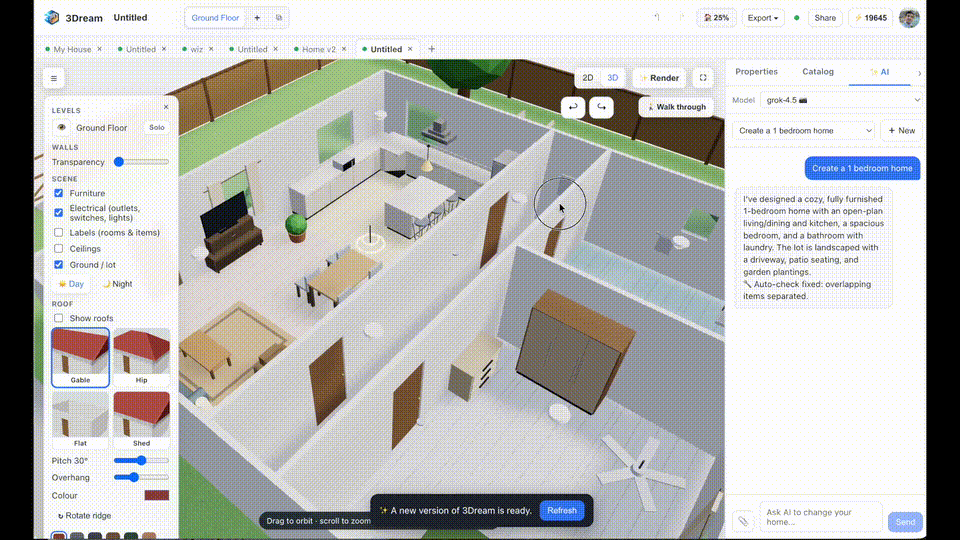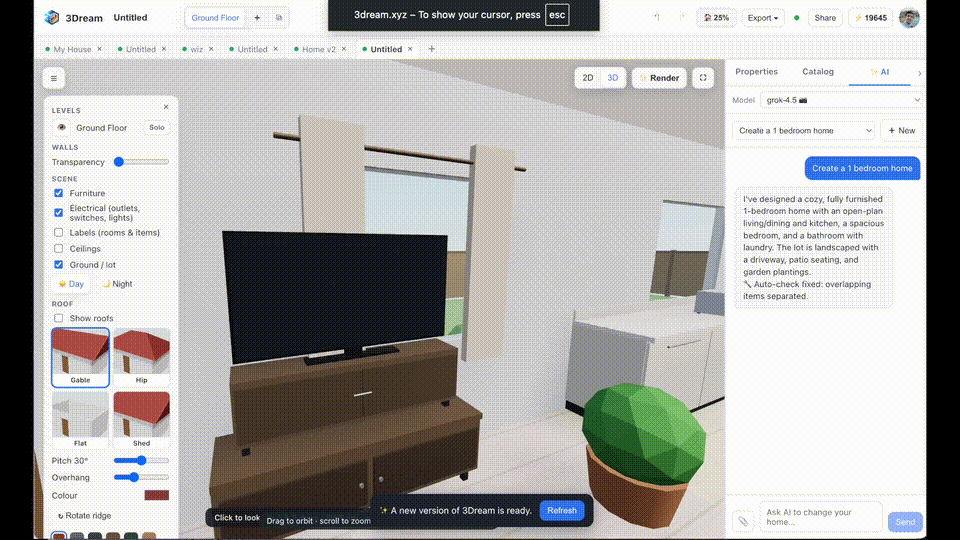
ある例では、Grok 4.5がMinecraft風のシーンを生成しています。別の例では、洗練されたSaaSのランディングページを単一のHTMLファイルで作成しています。また、2Dおよび3Dデザイン作業、アプリのレイアウト生成、簡単なゲーム構築のワークフローの例もあります。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
結果は一様に完璧というわけではありません。この記事では、Grok 4.5が特定のビジュアルまたはクリエイティブコーディングのテストでOpus 4.7に及ばなかったと感じた一部の開発者からの批判も取り上げています。中には、パフォーマンスが低かった溶岩ランプ風の生成タスクも含まれています。
その批判は有益です。評価を現実的に保ちます。モデルはエージェント型コーディングに優れていても、美的感覚、物理シミュレーション、視覚的詳細に関するタスクでは失敗する可能性があります。
Grok 4.5におけるCursorの役割は、今回のリリースで最も重要な部分の一つです。
Cursorのブログでは、Grok 4.5をxAIと共同でトレーニングされ、ソフトウェアエンジニアリング以上のことを目的として設計されたモデルとして説明しています。トレーニングには、Cursorのデータが数兆トークン含まれており、開発者がコードベース、ツール、AIエージェントとどのようにやり取りするかを捉えています。
これは静的なコードとは異なる種類のシグナルです。静的なコードはモデルに最終結果を教えます。開発者とエージェントのインタラクションデータは、プロセスを教えます。
エージェントは失敗した試行の後に回復します。
7. 最終的な変更がどのように検証されるか。
コーディングエージェントにとって、このワークフローシグナルは生のコーディング知識と同じくらい重要かもしれません。
このリリースは、AIコーディングモデルが3つの実用的な目標に向かって進んでいることを示唆しています。
モデルは、短いプロンプトと応答のやり取りだけでなく、多くのステップを要するタスクを処理できる必要があります。これには、計画、検索、編集、テスト、エラー修正が含まれます。
チームは、モデルのトークンあたりの価格だけでなく、タスクを解決する最終的なコストを重視します。モデルが解決策に達するまでに使用するトークンが大幅に少なければ、見かけ上の価格が同じように見えても、より低コストになる可能性があります。
現代のコーディングエージェントはツール環境の中で動作します。ターミナル、エディタ、ブラウザ、課題トラッカー、ファイルツリー、ビルドシステムを理解する必要があります。実際の開発者とエージェントのインタラクションデータでトレーニングされたモデルは、ここで優位性を持つ可能性があります。
xAIの公式リリースによると、Grok 4.5はGrok Build、Cursor、およびxAI APIコンソールから利用可能です。公式ページでは、シンプルなAPIの例も提供されています。
curl -s https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.5",
    "input": "バグを見つけて修正し、説明してください: function median(a){a.sort();return a[a.length/2]}"
  }'
元のリリースノートには、Grok 4.5は発売時点ではEUでは利用できず、後日EUでの利用が可能になる予定であることも記載されています。APIや製品で使用する予定がある場合は、その前に必ず現在のxAIのドキュメントと価格ページを確認してください。
記事と公式リリースの枠組みに基づくと、Grok 4.5は特に以下の分野で関連性が高いと考えられます。
すべてのユースケースに最適な選択とは限りません。リスクの高い本番環境の変更、法的なアウトプット、財務アドバイス、または機密性の高い顧客業務については、チームは依然としてレビュー、検証、人間による承認を必要とします。
自分のワークフローでGrok 4.5をテストしたい場合は、公開デモだけに依存しないでください。
自チームの実際のタスクを使用し、現在のモデル設定と比較してください。実用的な評価には以下を含める必要があります。
最適なモデルは
常に最高のベンチマークスコアを誇るモデル。多くのチームにとって、最良のモデルとは、最も低い信頼性コストで承認された作業を実現できるものです。
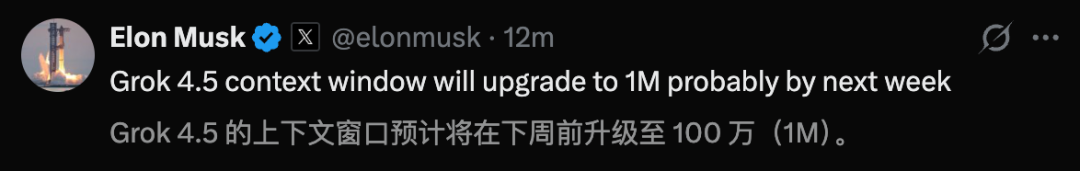
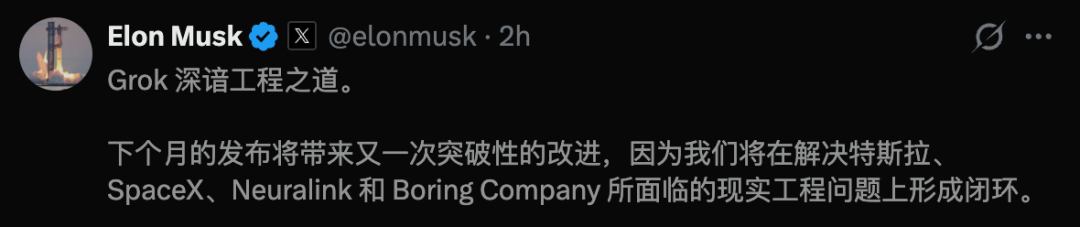
記事の最後では、マスク氏が来月、また別の飛躍的な改良を示唆したと述べています。
そのメッセージは、Grok 4.5が最終的な「テーブルをひっくり返す」モデルではないかもしれないということです。これは強力な中間的な一手かもしれません。絶対的に最強のモデルではなく、フロンティアレベルのエンジニアリングインテリジェンスをより安く、より速く利用可能にするモデルなのです。
これだけで競争は変わるかもしれません。知能が電気のように計測される時代になれば、勝者は最高のピークスコアを持つモデルだけではありません。実際のワークフローにおいて、強力な推論を安価に、迅速に、そして繰り返し提供できるモデルこそが勝者となるでしょう。
Grok 4.5は、コーディング、エージェントタスク、ナレッジワーク向けのxAIの旗艦モデルです。同社のこれまでで最強のモデルとして発表され、Cursorとの協力のもとでトレーニングされました。
あらゆる指標においてそうとは限りません。元の記事によると、Grok 4.5はいくつかのエンジニアリングベンチマークでGPT-5.5やOpus 4.8に迫っていますが、Claude Fableは依然としていくつかのトップ評価でリードしています。Grok 4.5の主な利点は、速度、コスト、トークン効率の組み合わせにあります。
公式リリースでは、Grok 4.5は入力トークン100万個あたり2ドル、出力トークン100万個あたり6ドルとされています。より高速なプレミアムバリアントも言及されており、入力トークン100万個あたり4ドル、出力トークン100万個あたり18ドルです。本番環境で使用する前に、必ず現在のxAIの価格ページを確認してください。
コーディング、ソフトウェアエンジニアリング、エージェントタスク、ナレッジワーク向けに設計されています。記事では、SWE Bench Pro、Terminal Bench 2.1、DeepSWEでのベンチマークパフォーマンスと、フロントエンド生成、Three.jsデモ、ゲームのようなプロトタイプの例が強調されています。
CursorはGrok 4.5でxAIと協力し、トレーニングには大量のCursorインタラクションデータが含まれています。このデータは、開発者がコードベース、ツール、エージェントとどのように連携するかを反映しており、実際のソフトウェアエンジニアリングワークフローでのモデルのパフォーマンス向上に役立つ可能性があります。
記事によると、Grok 4.5はSWE Bench Proタスクで平均15,954個の出力トークンを使用したのに対し、Opus 4.8は67,020個の出力トークンを使用しました。これは、Grok 4.5が同様のタスクをはるかに少ない生成トークンで解決し、コストとレイテンシを削減したことを意味します。
はい。xAIの公式リリースによると、Grok 4.5はxAI APIコンソールから利用可能です。リリースでは、responsesエンドポイントとgrok-4.5モデル名を使用したサンプルのcurlコマンドも提供されています。
はい。Cursorの公式発表によると、Grok 4.5はCursorのデスクトップ、Web、iOS、CLI、SDKで利用可能です。また、Cursorは個人・チームプランにおいて、本モデルをファーストパーティモデルプールの一部として含めていると述べています。
Grok 4.5は、コーディング、エージェント型ワークフロー、ナレッジワーク向けの高速でコスト効率の高いモデルとして紹介されています。エンジニアリングベンチマークで優れた性能を発揮し、Cursorとの連携データを活用しており、SWE Bench Proのタスクにおいて一部の主要モデルよりもはるかに少ない出力トークンを使用します。
その最大の価値は、あらゆるモデルに勝っていることではありません。より重要なのは、競争力のあるインテリジェンスを、より低いトークン使用量、より高速な推論、そして攻めの価格設定で提供する点にあります。
AIコーディングエージェントを構築するチームにとって、この組み合わせは重要です。承認されたタスクあたりのコスト、レビューの負担、ツールの使用、障害からの回復は、単一のリーダーボードスコアよりも重要かもしれません。
Grok 4.5の本当のメッセージはシンプルです。次のモデル競争は、誰が最も賢いかだけでなく、誰がより速く、より安価に有用なインテリジェンスを提供できるかが問われるということです。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



