For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/h-jepa-explained-hierarchical-jepa-world-f7e48311.md.
Yann LeCun氏が立ち上げた世界モデル企業、Advanced Machine Intelligence(AMI)が、主要な研究成果の一つを公開しました。H-JEPAは、複数の行動条件付きJEPAを組み合わせた階層型世界モデルで、Visual AntMazeにおいて3層モデル...
Yann LeCun氏が立ち上げた世界モデル企業、**Advanced Machine Intelligence(AMI)**が、主要な研究成果の一つを公開しました。
論文 H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning では、AMI、ニューヨーク大学、INRIA Paris、ブラウン大学の研究者が、複数の行動条件付きJEPAから構成される階層型世界モデルを提案しています。
中核となる考え方は明快です。即時の運動制御と長期計画の両方を一つの潜在表現で処理するのではなく、H-JEPAでは階層の各レベルに異なる時間スケールと異なる表現空間を割り当てます。
上位レベルはより遠い未来を見通し、より粗い粒度で計画します。そこで予測された中間状態が下位レベルのサブゴールとなり、システムが実行可能なアクションに到達するまで、段階的に具体化されます。
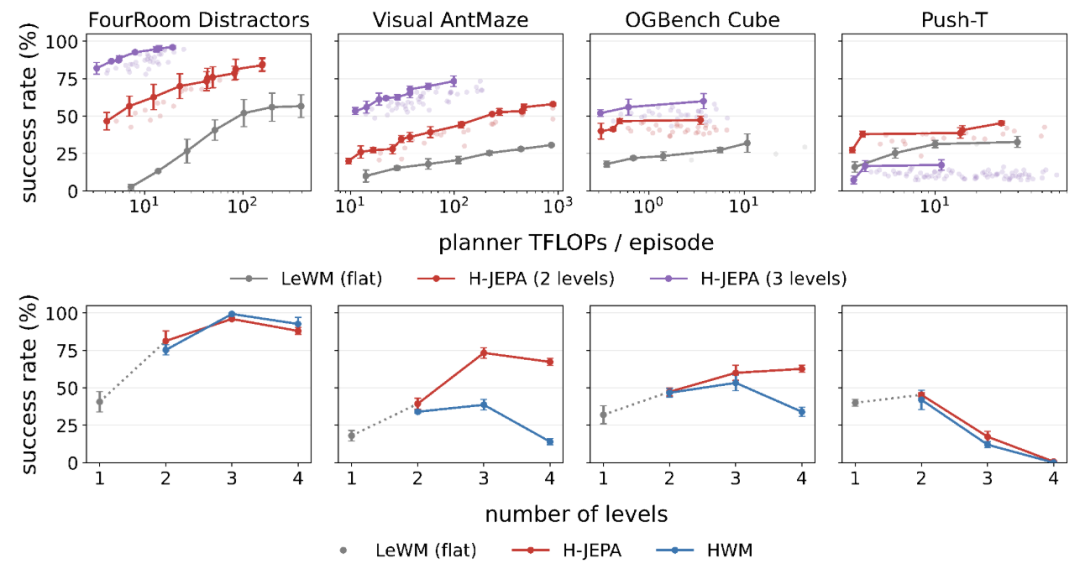
Visual AntMazeでは、3層構成のH-JEPAが約73.3%の計画成功率を達成しました。これは、フラットなLeWorldModelベースラインの**18.0%**を大きく上回ります。また、成功率と計算量のトレードオフでも、より優れたフロンティアを示しています。
このプロジェクトは、AMIが設立以来重視してきたオープンリサーチの方向性に沿ったものです。著者らは、学習・評価コード、事前学習済みチェックポイント、関連データセットを公開しています。
公式GitHubリポジトリはMITライセンスで提供されています。Hugging Faceで公開されたH-JEPAのチェックポイントリポジトリもMITライセンスと明記されており、付属するデータセットリポジトリはCC BY 4.0で公開されています。
LeCun氏は、長年にわたって階層型計画の重要性を主張してきました。
その基本的な直感は、人間が現実世界の複雑なタスクを計画する方法と似ています。
ニューヨーク大学のオフィスに座り、パリへ移動することを決めたとします。
最上位のレベルで重要なのは、目的地、フライト、スケジュールです。それが決まると、次のレベルでは、オフィスを出る、階下へ移動する、空港へ向かう、搭乗するといった、より具体的な計画になります。
最下位のレベルでは、再び注目すべき情報が変わります。階段を下りるには、床面、次の段、身体の動きに関する情報が必要です。大西洋を横断するフライトを選ぶ際には重要でなかった細部が、突然、決定的に重要になります。
同じ問題はロボット工学にも現れます。
高レベルのプランナーは、タスクの目的、空間的な関係、移動の長期的な方向を理解する必要があります。一方、低レベルのコントローラーには、直近の動きと身体の構成に関する正確な情報が必要です。
一つの表現にすべての時間スケールの細部を保持させると、計画は必要以上に難しくなります。
例えば、四足歩行ロボットがすでに正しい位置にいる一方で、脚の姿勢だけが目標画像と異なる場合があります。脚のように高速で変化する細部を過度に重視する表現では、タスク上重要な位置がすでに正しいにもかかわらず、ロボットが目標から遠く離れていると誤って判断する可能性があります。
H-JEPAの論文は、より具体的な問いによってこの問題に取り組んでいます。
各レベルが自身の時間スケールで重要な情報を学習しながら、高レベルの計画を低レベルのアクションへ変換できるのか?
H-JEPAでは、階層の各レベルに次の3つの主要コンポーネントを割り当てます。
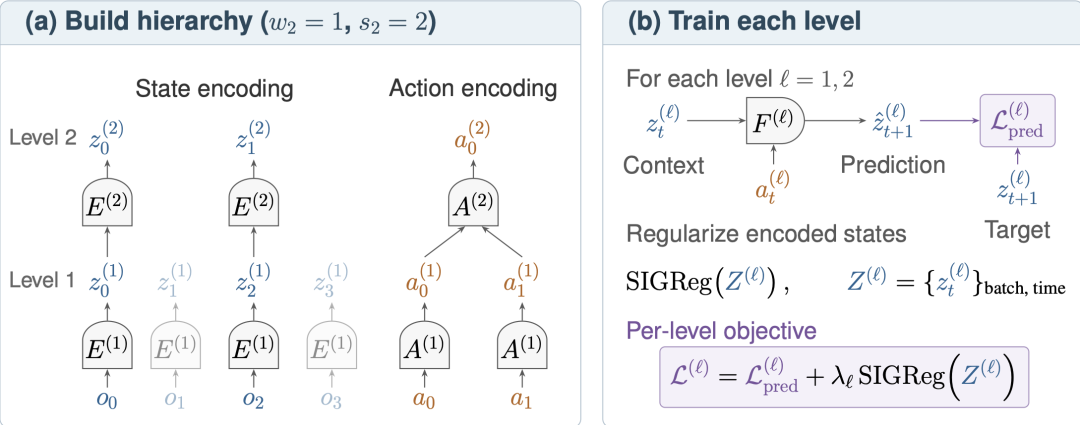
状態エンコーダーは、環境の潜在表現を抽出します。
最下位レベルでは、エンコーダーが視覚観測を直接処理します。上位レベルは下位レベルの表現を受け取り、状態をより抽象化した表現へと段階的に学習します。
これにより、上位レベルは、高速に変化する情報、長い時間軸で予測しにくい情報、長期計画に関係しない情報を捨てられるようになります。
Visual AntMazeの実験では、上位レベルになるほど、アリの脚の姿勢に関する情報を抑制しながら、アリの位置と迷路のレイアウトに関する情報を保持します。
これは、まさに階層が学習すべき抽象化です。
アクションエンコーダーは、各時間スケールにおけるアクションの効果を表現します。
最下位レベルでは、アクションは比較的具体的な制御変化に対応します。上位レベルでは、複数の下位アクションが、より長い期間にわたる状態変化の粗い表現へと圧縮されます。
これにより、各層が異なる時間解像度を持つことになります。
報告された設定では、上位レベルの1回の予測ステップが、下位レベルよりも多くの環境ステップをまたぎます。
予測器は、現在の潜在状態とエンコードされたアクションを組み合わせ、将来の潜在状態を推定します。
したがって、各レベルが独自の行動条件付き世界モデルを学習します。
フラットな世界モデルとの重要な違いは、H-JEPAがすべてのレベルに一つの共有潜在空間内で予測することを求めない点です。
代わりに、各レベルが自らの予測期間に適した表現を構築できます。
推論時には、計画が階層の最上位から下位へと進みます。
最上位レベルがまず、最終目標に向かう粗い経路を探索します。
予測された中間状態が、その下のレベルに対するサブゴールになります。下位レベルは割り当てられたサブゴールに到達するための、より細かな計画を探索します。この処理を繰り返し、最下位レベルが基本アクションを生成します。
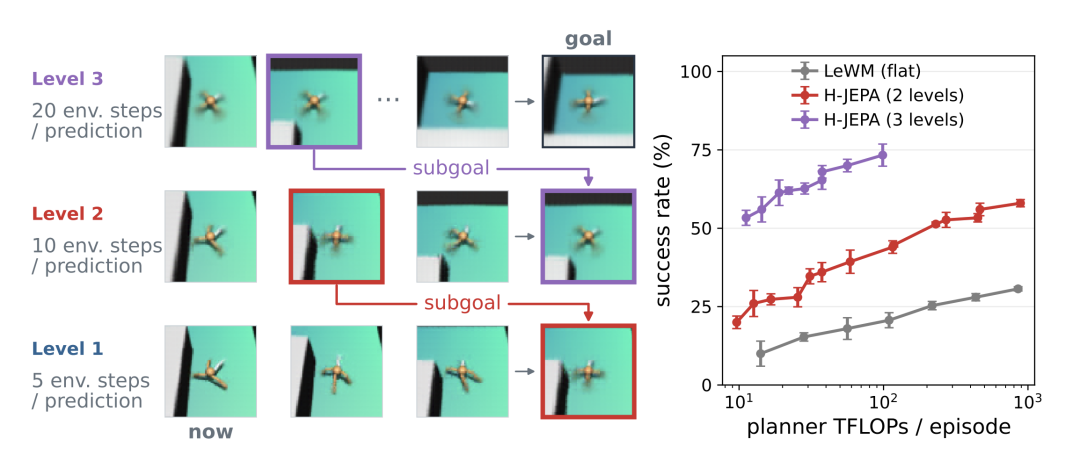
この処理により、粗い計画から細かな計画へ進むプロセスが形成されます。
アクションの一部を実行した後、システムは新しい状態を観測し、再び計画を立てます。
この反復的な再計画によって、階層は一つの長いオープンループ計画に固定されるのではなく、実際の環境に対応できます。
この階層はエンドツーエンドで学習されます。
つまり、各レベルを独立したモジュールとして学習するのではありません。上位レベルの目的が下位レベルのエンコーダーに影響を与えることで、全体の表現階層が共同で発達します。
ただし、世界モデルの学習には、表現崩壊という古典的な失敗モードがあります。
エンコーダーがすべての入力状態を同じ潜在ベクトルに写像すると、予測器はその同じベクトルを出力するだけで、環境について何も有用なことを学ばずに低い予測誤差を達成できます。
H-JEPAは、Randall Balestriero氏とYann LeCun氏による初期のLeJEPA研究で導入されたSIGReg、すなわちSketched Isotropic Gaussian Regularizationを使ってこの問題に対処します。
SIGRegは潜在分布に制約を加え、異なる観測が同じ表現へと崩壊することを防ぎます。
初期のLeWorldModelは、ピクセルからエンドツーエンドで世界モデルを学習する際に、この形式の正則化を適用しました。H-JEPAはLeWorldModelを最下位レベルの基盤として利用し、その上に追加のJEPAレベルを組み合わせています。
これにより、基本的なJEPAの原則、つまり未来のすべてのピクセルを再構成するのではなく、未来の有用な表現を予測するという考え方が維持されます。
この論文では、4つのシミュレーション環境でH-JEPAを評価しています。
さらに、DROIDデータセットに含まれる実ロボットの軌跡を使い、オフライン計画も評価しています。
Visual AntMazeでは、階層型モデルの優位性が最も明確に現れます。
公式リポジトリによると、3層H-JEPAは73.3%の計画成功率を達成し、フラットなLeWorldModelベースラインの**18.0%**を上回りました。
また、階層構造によって成功率とプランナーの計算量のトレードオフも改善されています。
これは重要な点です。階層型プランナーは、追加されたレベルによって計画コストが過度に増大しない場合にのみ有用だからです。
他のシミュレーション環境でも、階層型モデルはフラットなベースラインを上回ります。ただし、深ければ常に良いとは限りません。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
原記事では、Push-Tを重要な反例として取り上げています。2層モデルはフラットなベースラインを上回る一方、3層または4層を追加すると性能が低下する場合があります。
論文では、その理由の一つとしてタスクの長さを挙げています。軌跡が短い場合、長い時間軸で動作する非常に高いレベルにとって、意味のあるサンプルが少なくなります。
これは重要な制約を示しています。
階層構造が有効なのは、タスクに複数の時間スケールにまたがる本質的な構造がある場合です。レベルを機械的に追加しても、性能向上が保証されるわけではありません。
実ロボットのデータでは、別の表現上の問題が生じます。
多様な動画では、純粋な予測目的を使うと、背景が予測しやすいため、安定した背景情報に大きく注目する可能性があります。制御上実際に重要な動くロボットには、表現容量が十分に割り当てられないことがあります。
この問題に対処するため、研究者らはDROIDの実験に逆動力学の教師信号を追加しています。
モデルは未来の潜在状態を予測するだけでなく、連続する潜在状態をつなぐアクションを推定するように学習されます。
これにより、ロボットの動きと制御可能な状態に関する情報を表現に保持するよう促します。
H-JEPAのプロジェクトページによると、学習された第2レベルは、フラットなベースラインを上回るオフライン計画の忠実度を実現しながら、プランナーの計算量を削減しています。
DROIDの評価はオフラインで行われています。論文は、閉ループの実ロボットタスク成功を主張するのではなく、予測されたエンドエフェクターの経路を専門家の軌跡と比較しています。
結果を解釈する際には、この違いが重要です。
著者らは、H-JEPAの実装をGitHubで公開しています。
公式リポジトリには、次のタスク向けの学習コードと計画コードが含まれています。
また、論文に掲載された一部の図と表を再現するためのスクリプトも提供されています。
Hugging Faceのチェックポイントリポジトリには現在、シミュレーションタスク向けに、フラットなLeWorldModel、2層・3層・4層のH-JEPA、共有空間HWMベースラインの事前学習済みモデルが含まれています。DROIDのチェックポイントも提供されています。
付属するH-JEPAデータセットリポジトリには、シミュレーションデータ、計画評価タスク、プロービング用データセット、リリースに必要なDROID関連データが含まれています。
この公開によって、H-JEPAは論文だけのデモンストレーションにとどまりません。研究者は実装を確認し、学習済みモデルを読み込み、報告された計画結果の再現を試みることができます。
H-JEPAは、LeCun氏が長年推進してきた、より広い研究方向に沿ったものです。
JEPAはJoint-Embedding Predictive Architectureの略称です。
標準的な言語モデルは、未来のトークンを予測することで学習します。一方、視覚JEPAは観測の表現を学習し、潜在空間内でターゲット表現を予測します。
H-JEPAのような世界モデルでは、アクションを処理に加えることで、アクションを実行した後に世界の内部表現がどのように変化するかを予測できるようにします。
その後、プランナーは異なるアクションの予測結果を比較し、目標に向かう経路を探索できます。
これは、知能には言語生成以上のものが必要だというLeCun氏の長年の見解を反映しています。彼の研究構想では、システムは世界を理解し、アクションの結果を予測し、関連する状態を記憶し、時間をまたいで計画する必要があります。
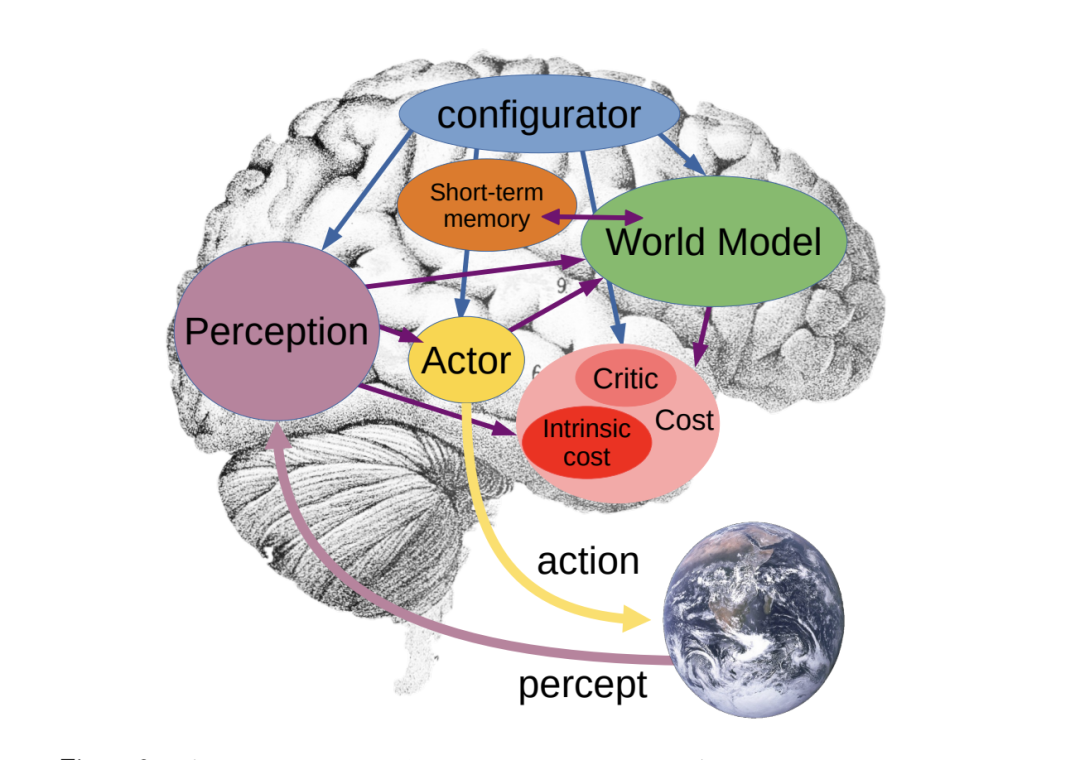
原記事では、LLMだけをスケールさせれば必ず人間レベルの知能に到達するという考えに対する、LeCun氏の繰り返しの批判にも触れています。同時に、LLMを基盤とするツールが実用上非常に有用であることも認めています。
したがって、H-JEPAは、現在すべての言語モデルを置き換えようとする試みではなく、LeCun氏が提唱してきた別のアーキテクチャを具体的に検証する実験として理解するのが適切です。
この研究方向は、現在AMIの事業戦略の一部になっています。
Reutersおよび同時期のその他の報道によると、AMIは2026年3月、10億3,000万ドルを調達し、プレマネー評価額35億ドルとなりました。
同社は、次のメンバーを含むチームによって率いられています。
Michael Rabbat氏はH-JEPA論文の著者の一人でもあります。
AMIは、世界を理解し、永続的な記憶を維持し、推論と計画を行い、制御可能で安全なシステムを構築することを目標として掲げています。
BAAIの原記事が公開された時点で、同社は広く利用可能な一般向け製品よりも、主に研究、チーム、人材採用を通じて自社を示していました。
そのためH-JEPAは、スタートアップの世界モデル構想から生まれた具体的な技術成果を示すものとしても重要です。
原記事は、別の著名な世界モデル企業である、Fei-Fei Li氏のWorld LabsとAMIを比較して締めくくっています。
2026年9月28日、AMDはWorld Labsを買収する正式契約を締結したと発表しました。
AMDのSEC提出書類によると、全株式交換による取引額は通常の調整を前提として、およそ82億ドルと評価されています。
両社は異なる組織的な道を進んでいますが、どちらも、世界モデル、空間知能、ロボティクス、シミュレーション、フィジカルAIの重要性が高まっていることを示しています。
AMIは階層型予測モデルを軸に独自の研究プログラムを続けています。一方、World Labsは大手AIコンピューティング企業との統合へ進んでいます。
H-JEPAにとって直近の問いは、企業戦略よりも技術的なものです。潜在空間における階層型計画を、シミュレーション制御やオフラインのロボット動画から、より豊かで閉ループな現実世界のシステムへ、どこまでスケールできるのでしょうか。
それが、このアーキテクチャにとって次の試験になります。
H-JEPAは、視覚計画のためのエンドツーエンド型階層世界モデルです。複数の行動条件付きJEPAを積み重ねることで、上位レベルがより遠い未来を予測し、潜在的なサブゴールを下位レベルへ渡します。
フラットな世界モデルは、一つの表現と一つの計画時間スケールを使用します。H-JEPAは複数の時間スケールに対応する独立した潜在空間を学習し、高レベルでは遅い変化をするタスク関連の構造に集中し、低レベルでは制御に必要な細部を保持できます。
公式GitHubリポジトリによると、3層H-JEPAは約73.3%の計画成功率を達成しました。これは、フラットなLeWorldModelベースラインの**18.0%**を上回ります。また、階層型モデルは成功率とプランナー計算量のトレードオフでも優れています。
SIGRegはSketched Isotropic Gaussian Regularizationの略称です。LeJEPAで導入された手法で、潜在分布に制約を加え、エンコーダーが異なる多数の状態をほぼ同じ埋め込みへ写像する表現崩壊を防ぎます。
はい。公式GitHubのコードリリースはMITライセンスで提供されており、事前学習済みチェックポイントはHugging Faceで利用できます。関連するH-JEPAデータセットリポジトリはCC BY 4.0で公開されています。
論文では、逆動力学の教師信号を使い、DROIDの多様な実ロボット動画へ手法を拡張しています。ただし、これらの実験で評価されているのはオフライン計画の忠実度であり、完全な閉ループ型ロボットタスクの成功ではありません。そのため、自律的な現実世界への展開結果として過大に解釈すべきではありません。
いいえ。論文では、タスクに複数の時間スケールにまたがる意味のある構造がある場合には、より深い階層が有効だと示されています。一方、Push-Tのような短いタスクでは、高位レベルが有用な学習信号を十分に受け取れず、非常に深い階層が性能を低下させることがあります。
H-JEPAは、LeCun氏のJEPAおよび世界モデルに関する構想に沿っています。つまり、世界のコンパクトな表現を学習し、すべてのピクセルではなく未来の潜在状態を予測し、その予測を計画に利用するという考え方です。H-JEPAは、異なるレベルが異なる時間スケールと抽象度で動作できるよう、明示的な階層構造を追加しています。
H-JEPAは、JEPAによる世界モデルの考え方を、明示的な計画階層へと発展させています。上位レベルはより長い時間軸と抽象度の高い表現で動作し、下位レベルはその計画を、より具体的なサブゴールとアクションへ変換します。
最も強い結果はVisual AntMazeで見られます。3層H-JEPAは、フラットなLeWorldModelベースラインの18%に対し、約73%の計画成功率を達成しながら、計画効率も改善しました。また、この研究は、階層構造が自動的に有効になるわけではないことも示しています。追加レベルが役立つかどうかは、タスクの時間スケールと利用可能なデータによって決まります。
このプロジェクトは、新しい研究リリースとしては再現性が高く、コード、チェックポイント、データセットがすでに公開されています。
H-JEPAの主な貢献は、単に迷路のスコアを改善したことではありません。異なる計画期間に対して異なる表現を学習することで、世界モデルが恩恵を受けられることを具体的に示した点にあります。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



