For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/harness2-explained-recursive-agent-harnes-65188473.md.
Harness²(Harness2とも表記)は、固定された言語モデルの周辺ソフトウェアを変更する、実践的な再帰的改善の形態を探ります。編集可能な実行環境には、プロンプト、ガードレール、メモリ、スキル、ツール利用ガイダンス、スクリプト、サブエージェント、ミドルウェアが含まれます。
Harness²(Harness2とも表記)は、固定された言語モデルの周辺ソフトウェアを変更する、実践的な再帰的改善の形態を探ります。編集可能な実行環境には、プロンプト、ガードレール、メモリ、スキル、ツール利用ガイダンス、スクリプト、サブエージェント、ミドルウェアが含まれます。
この研究は、Google Cloud AI ResearchとNorthwestern Universityによるものです。失敗するたびに新しいモデルを学習させるのではなく、システムはエージェントの実行を分析し、ハーネスへの変更を検証し、どの変更が役立ったかについての証拠を保持します。
著者らは、OpenCode環境において、1回の改善ステップでGLM-5のWorkBuddy-Bench平均スコアが64.2から75.7に上昇したと報告しています。これは特定の評価における11.5ポイントの向上であり、あらゆるモデルやアプリケーションで保証される改善ではありません。
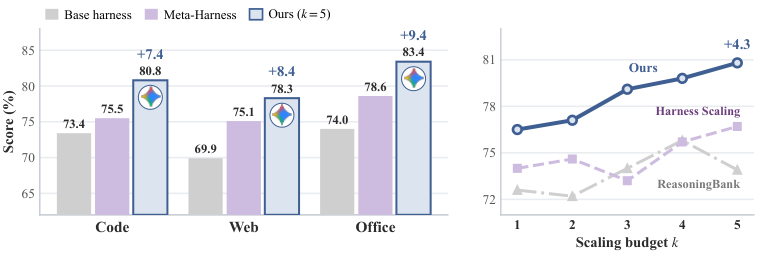
研究チームの図。QbitAI/BAAIのレポートから転載。
この研究の背景には、2つの問題があります。
Harness2は、現在の実行ハーネスと、それを改善するプロセスを分離します。後続のタスクは共通のベースハーネスから開始しますが、改善器は過去のルールをすべて盲目的に引き継ぐのではなく、以前の証拠から必要なものだけを選択的に参照します。
システムはまず、初期ハーネスを使った基準実行を記録します。その後、その実行トレースを使って弱点を特定し、考えられる修正を検証します。
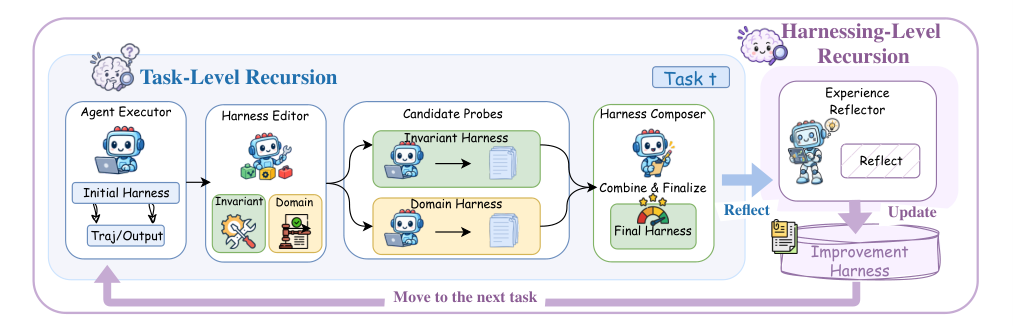
改善ステップには、次の3段階があります。
動作比較は、適応中に正解データからのフィードバックが得られない場合の代替手段です。ただし、最終成果物の正しさを完全に判定できるわけではありません。手法が機能するかを測定する際には、外部ベンチマークによる評価も依然として重要です。
この手法は、並列再帰によってより広範囲を探索したり、逐次再帰によって連続的な修正を行ったりできます。並列予算がkの場合、k個の汎用候補とk個のドメイン候補を検証し、その後k個の合成結果を生成します。候補を増やすほど、必要な計算量も増加します。
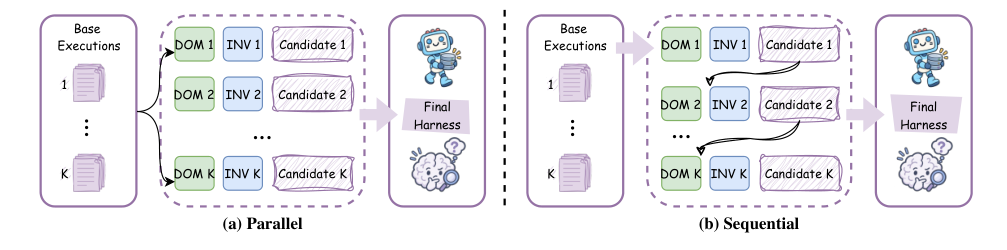
タスク完了後、経験リフレクターは基準トレース、提案された編集、検証結果、合成時の判断を調べます。そして、EXPERIENCE.mdへの記録を含め、再利用可能なコンポーネントと教訓を保存します。
次のタスクにはベース実行ハーネスが渡されますが、編集プロセスは過去の教訓を取得できます。保持されるのは、ある修正がいつ役立つかに関する知識であり、前のタスクの完全な設定を恒久的に採用すべきだという前提ではありません。
モデルパラメータは固定されたままです。これはファイルと実行証拠を利用したランタイム適応であり、自律的なモデル重みの学習を示すものではありません。
この研究では、WorkBuddy-Benchのコード、ウェブ、オフィス成果物、JobBenchの専門業務タスク、HarveyのLegal Agent Benchmarkを評価しています。実行ハーネスとして、OpenCodeおよびCodexとともにGLM-5とGemini 3.5 Flashを使用します。
デフォルトの編集モデルは、OpenCode環境のClaude Opus 4.8です。したがって、主要な結果は実行モデル単体の無料の能力向上ではなく、実行モデルを取り巻く改善システムによる結果として説明すべきです。
| 実行モデル | 初期ハーネス | WorkBuddyベース平均 | Harness2を1ステップ適用 | 向上幅 |
|---|---|---|---|---|
| GLM-5 | OpenCode | 64.2 | 75.7 | 11.5ポイント |
| GLM-5 | Codex | 64.4 | 75.3 | 10.9ポイント |
| Gemini 3.5 Flash | OpenCode | 72.4 | 77.5 | 5.1ポイント |
| Gemini 3.5 Flash | Codex | 74.5 | 77.5 | 3.0ポイント |
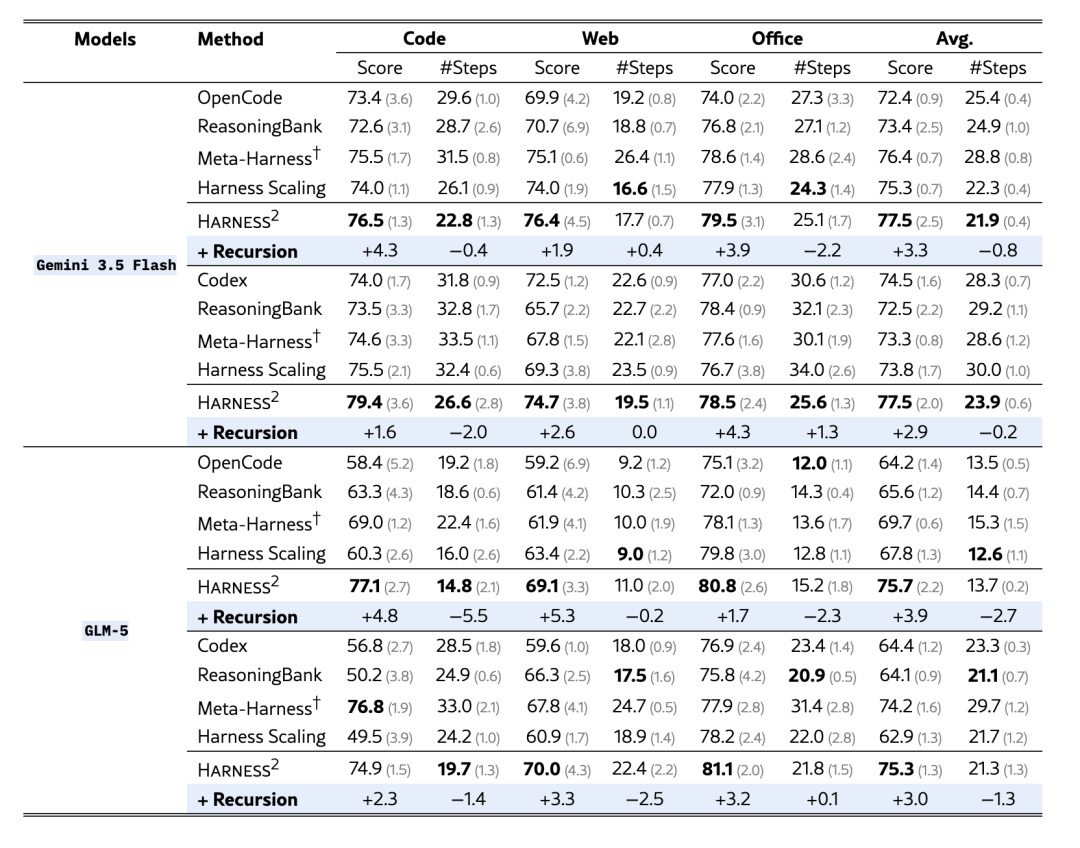
この比較では、改良されたハーネスを使用したGLM-5が、変更を加えていない対応するGeminiベースラインを上回っています。これはランタイム設計がモデルの順位に影響し得ることを示しますが、GLM-5があらゆるタスクでより強いことを示すものではありません。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
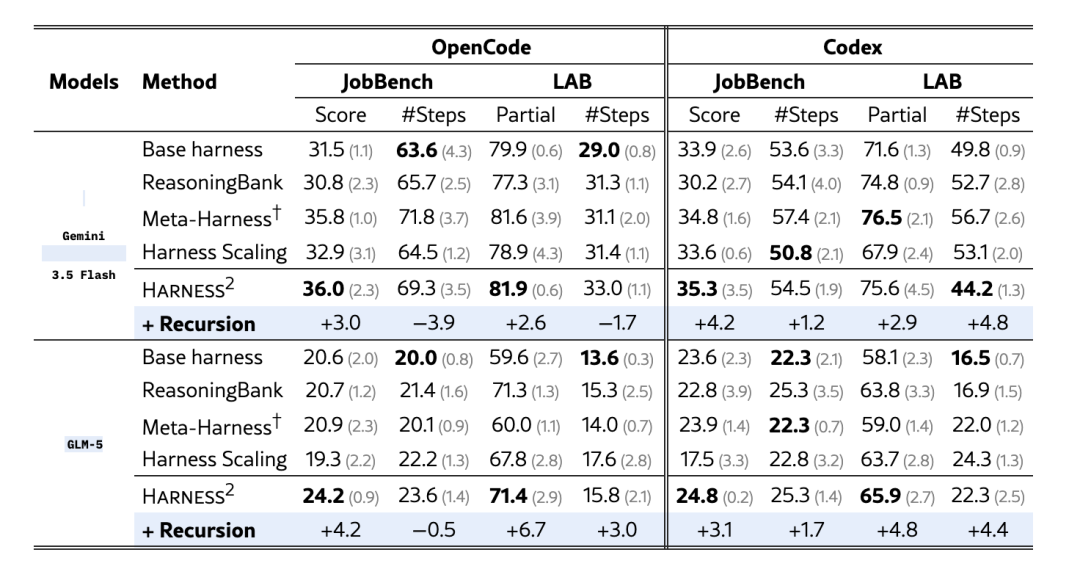
論文では、JobBenchで最大4.5ポイント、LAB Partialで最大11.8パーセントポイントの1ステップ改善が報告されています。Partialは基準ごとの合格率であり、すべての基準を満たすタスクの割合とは異なります。
並列予算をk=5に増やすと、1ステップの場合と比べて、WorkBuddyで最大3.9ポイント、JobBenchで4.2ポイント、LAB Partialで6.7パーセントポイントが追加されます。主要な表では、タスク順をシャッフルした3回の実行から得た平均値と標準偏差が報告されています。
転移実験も有用です。JobBenchで蓄積したライブラリを使うと、その比較における追加の検証なしで、WorkBuddyの1ステップ改善がコードで0.6ポイント、ウェブで0.5ポイント、オフィスで2.9ポイント向上しました。
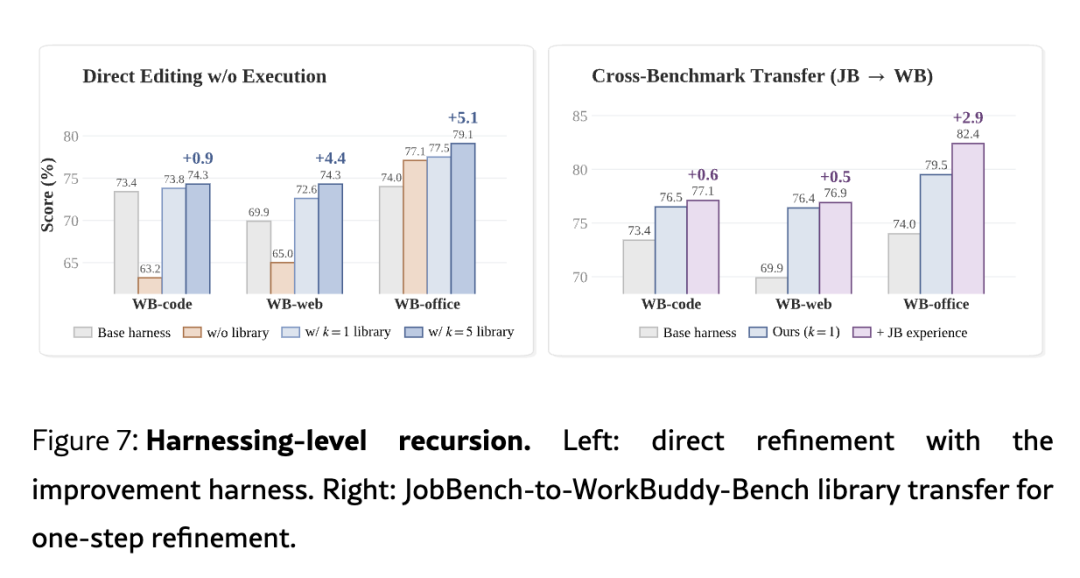
これらの結果は、改善経験を選択的に再利用することを支持しています。ただし、蓄積されたすべてのルールが転移することを示すものではなく、採用したハーネスを実際のタスク分布で検証する必要性をなくすものでもありません。
論文には、Ruiyao Xu、Yanfei Chen、Zhongying CuiZhu、Bhavana Dalvi Mishra、Yifei Ming、Han Yu、Rujun Han、Chen-Yu Lee、Tomas Pfisterの9人の著者が記載されています。出典では、XuをNorthwesternの博士課程学生、ChenとCuiZhuをGoogle Cloudの研究者として紹介しています。
公開リポジトリは、2種類の実行ハーネスと2種類の再帰モードの両方をサポートしています。Linux、Python 3.12、uvが指定されており、モデルを利用するベンチマークには追加の依存関係とAPI費用が発生します。WorkBuddyにはDockerが必要で、LABではPandocやPopplerなどのツールが必要です。
READMEでは、実行モデルのネットワークアクセスが制限されておらず、この構成ではCodexの実行サンドボックスが無効になっていることにも注意を促しています。ベンチマーク利用者は、結果を評価する前に、解答や採点基準へアクセスできないよう制限を設定する必要があります。論文で示されたランタイム改善は、こうした実行条件と評価条件と併せて検討すべきです。
言語モデルの周辺にあるランタイムを変更します。対象には、プロンプト、ツール、メモリ、スキルなどが含まれます。基盤となるモデルの重みは固定されたままです。
タスクレベルの再帰は、現在のタスク向けの修正を検証して合成します。ハーネスレベルの再帰は、後続の編集判断を改善するために、証拠と再利用可能な教訓を保持します。
その適応手法は、正解データによる検証器ではなく、実行トレース間の差異を利用します。これにより、ラベルがない場合でも証拠を利用できますが、生成された成果物が正しいことを保証するものではありません。
いいえ。これは研究で報告された、GLM-5とOpenCodeを組み合わせたWorkBuddy平均の改善幅です。モデル、ハーネス、ベンチマークの組み合わせが異なれば、向上幅も異なります。
候補の実行と改善作業が追加されるため、コストが増加します。論文では、実行トークンと改善トークンを含む総計算量とともに、性能を分析しています。
リポジトリでは、WorkBuddy-BenchにDockerが必要と記載されています。ローカルの決定論的デモやその他のベンチマークでは要件が異なるため、選択したワークフローの手順に従ってください。
Harness2は、タスク固有の実験と、エージェントのランタイムを改善するための教訓ライブラリを組み合わせます。報告された成果は、モデルの重みが固定されたままでも、プロンプト、ツール処理、実行構造によって結果が大きく変わり得ることを示しています。
この証拠は、計算量、検証、転移に関する限界を明示したうえで、検証済みの条件下におけるより優れたハーネス設計を支持しています。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



