For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/houmo-m50-open-source-software-for-local-1781bd08.md.
AIワークロードをローカルデバイスへ移すには、高性能なアクセラレータだけでは不十分です。開発者には、モデルを準備し、効率的に実行し、複数のコンポーネントを接続し、完成した製品を保守する手段が必要です。
AIワークロードをローカルデバイスへ移すには、高性能なアクセラレータだけでは不十分です。開発者には、モデルを準備し、効率的に実行し、複数のコンポーネントを接続し、完成した製品を保守する手段が必要です。
Houmoの最新のエコシステム発表は、このソフトウェア層に対応するものです。提供されたレポートによると、同社はAIソフトウェアスタックを段階的に公開する計画で、2027年1月までに15プロジェクトが公開予定です。モデルのサンプル、量子化ツール、広く使われる推論フレームワークの適応版など、すでに複数のリポジトリが公開されています。
ロードマップと現在利用可能なコードを区別することは重要です。スタック全体をオープン化する計画があるからといって、すべてのコンポーネントがすでに公開済みであることや、あらゆるランタイム依存関係が解消されていることを意味するわけではありません。
レポートでは、スタックを次の4層に分類しています。
| 層 | デプロイメントにおける役割 |
|---|---|
| モデル準備 | 量子化、コンパイル、精度チェック、および対応形式への変換 |
| 推論フレームワーク、演算子、ランタイム | Houmoハードウェア上での実行とスケジューリング |
| ドメインキット、パイプライン、ミドルウェア | モデルとアプリケーションコンポーネント間の連携 |
| デプロイメントと運用 | 導入済みデバイス全体でのアップデート、監視、管理 |
会議アシスタントは、これらの層が一体で必要になる理由を示す例です。音声認識は言語モデルにデータを渡し、言語モデルは有用な記録を生成し、アプリケーションはその結果を保存または表示する必要があります。各段階には、それぞれ固有のメモリ、レイテンシ、互換性に関する要件があります。
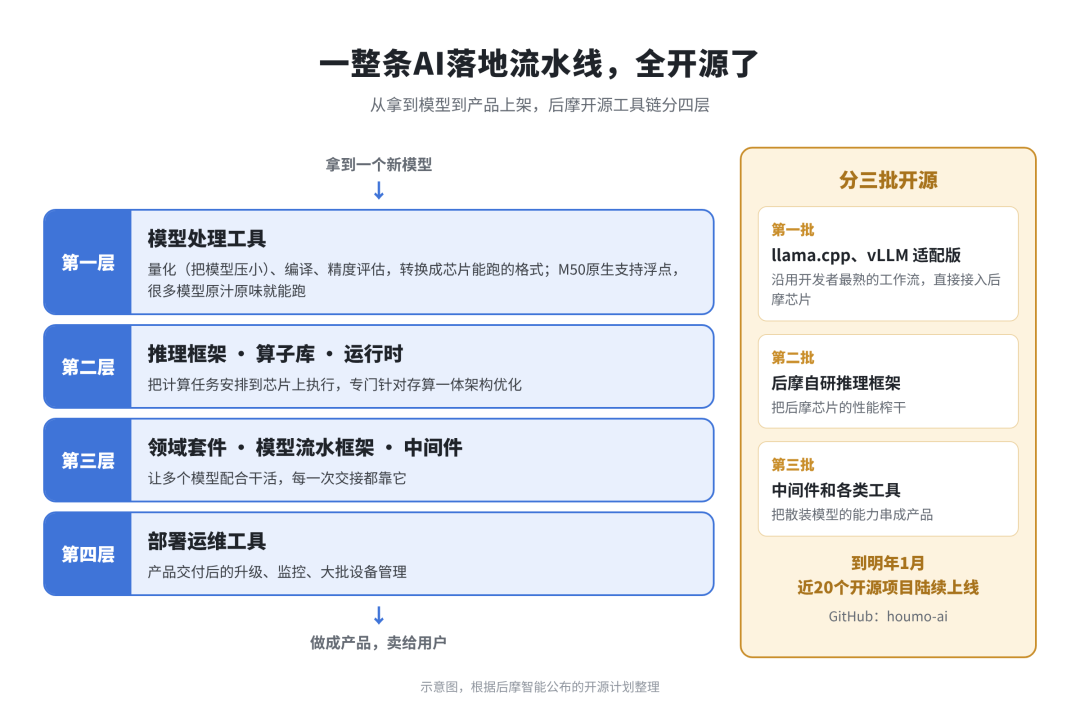
Xinzhiyuan/BAAIレポートのソフトウェアスタック図。元のラベルは中国語です。
報告された公開順序は、llama.cppとvLLMの適応版から始まり、次にHoumo独自の推論フレームワーク、その後にミドルウェアやその他のツールが続きます。より広範なロードマップには、アクセラレータおよびクラスター管理向けのインフラストラクチャも含まれています。
公開されているpostmo-modelzooリポジトリでは、量子化、コンパイル、精度評価、性能測定、アプリケーションデプロイメントを対象としたサンプルが説明されています。モデルのカテゴリには、音声認識、音声生成、言語モデル、視覚言語モデル、埋め込み、OCR、セグメンテーション、画像生成が含まれます。
公開されているその他のリポジトリには、postmo-quantflow、postmo-gptqmodel、vllm-postmo、およびHoumoによるllama.cppとvLLMのフォークがあります。開発者は、インストール手順やサポート水準がすべて同一であると想定せず、各リポジトリのREADMEと現在のブランチを確認する必要があります。
モデルサンプルのREADMEには、次のような具体的な制約が記載されています。
houmo-tcim-runtimeおよびhoumo-drvのライブラリに依存します。これらの要件は、計画立案において重要です。オープンなサンプルリポジトリは調査可能な統合コードを提供しますが、ハードウェアに依存しない実行環境ではありません。
情報源によれば、100社を超える顧客と、150を超える計画中の端末製品がM50に関連付けられています。これらの数値は、監査済みの出荷台数ではなく、報告されたエコシステムのパイプラインを示すものです。
レポートでは、LenovoのP7を、最大システム消費電力30 W、約300グラムのAIコンピューターとして紹介しています。また、128Kコンテキストをサポートし、1,220億パラメータのモデルをローカルで毎秒50トークンで動作させたと報告しています。
こうした数値は、欠けているテスト条件とともに扱うべきです。記事には、モデルアーキテクチャ、精度、ワークロード、測定構成に関する十分な詳細が示されていないため、一般的な性能保証として扱うことはできません。特に、パラメータ数だけでは、導入に必要なメモリ量は分かりません。
M50自体については、INT8で160 TOPSの性能、標準的な消費電力10 W、最大48 GBのLPDDR5/5Xメモリ対応が記述されています。アクセラレータの消費電力、システム全体の消費電力、理論スループット、生成トークン速度は、それぞれ異なる指標です。
このほか、DeepshardのTruffle 1のM50版、UgreenのHomeAgent HA100 Pro、ClawHouse X1が報告されています。これらの例では、ローカルメモリ、家庭内メディア処理、パーソナルエージェントのインターフェースが中心となっています。メールなどの接続サービスは、モデルがローカルで動作していても、認証とネットワークアクセスに依存します。
レポートでは、Kylin V11を実行するGreat Wall N90 ProノートPCが、350億パラメータモデルをオフラインで毎秒30トークンで動作させたと説明しています。また、知覚と記憶にローカル処理を用いるコンパニオンロボット、および4基のM50チップを統合するLM5040アクセラレータカードを各台に搭載した教育用アプライアンスについても取り上げています。
教育システムについて報告された演算性能とメモリの数値は、M50単体ではなく、組み立てられたシステム全体に適用されるものです。製品を比較する際は、実際のカード数、メモリトポロジー、精度、測定されたワークロードを確認する必要があります。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
アーキテクチャに関する説明では、Mixture-of-Experts(MoE)モデルと密なモデルが区別されています。MoEモデルは、あるトークンに対して専門家のサブセットを活性化できますが、その広範なパラメータセットを保存しておく必要があります。密なモデルでは通常、各ステップでより多くのパラメータが使用されるため、メモリトラフィックが重要な考慮事項になります。
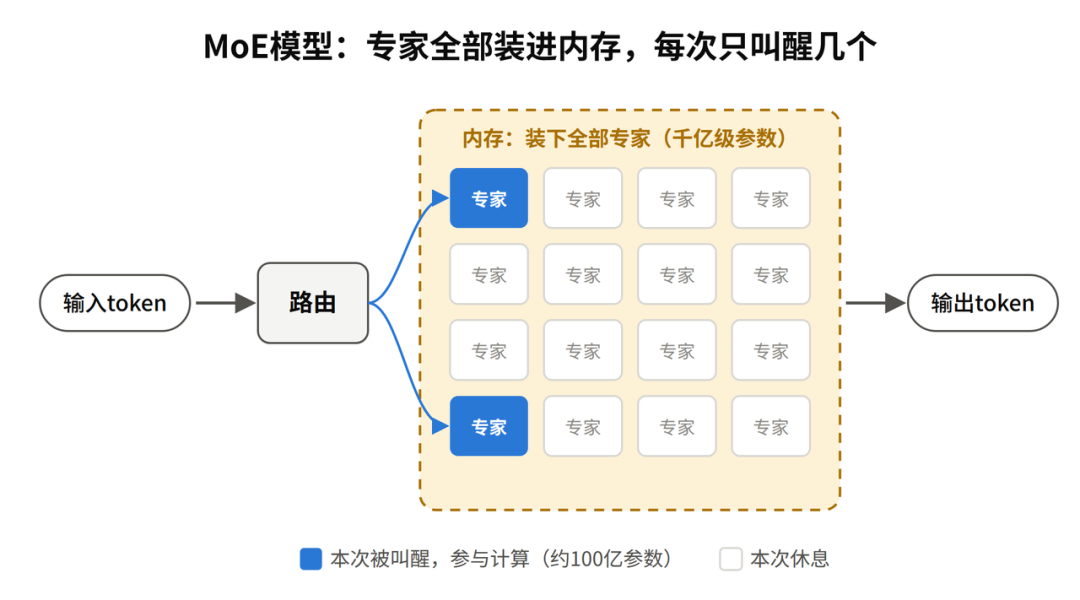
情報源レポートのMoE図解。元のラベルでは、保存されるエキスパートと活性化されるエキスパートを説明しています。
Houmoは、2つの開発経路を提示しています。1つは外部メモリを用い、容量と演算を重視する2Dコンピュート・イン・メモリです。もう1つは積層設計により帯域幅を重視する3Dコンピュート・イン・メモリです。レポートでは、後者を特徴付ける要素として、ロジック層におけるSRAMベースの演算を説明しています。
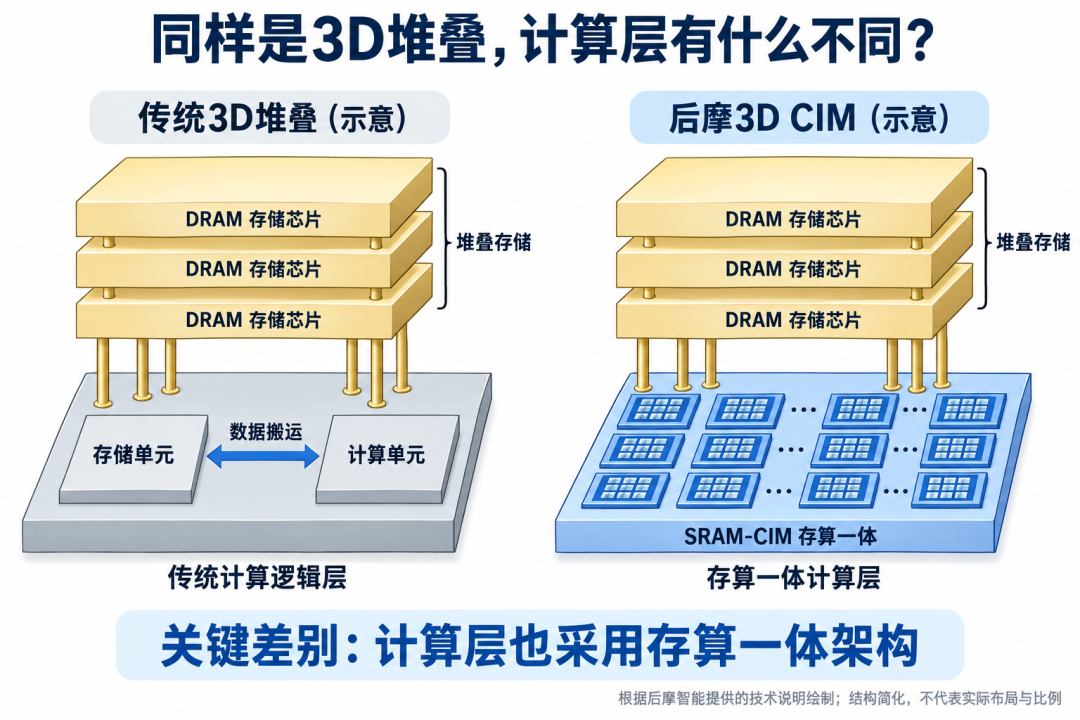
Xinzhiyuan/BAAIレポートに掲載されたアーキテクチャ比較であり、独立ベンチマークではありません。
同社の面積および消費電力の比較は、何と比較するかに依存します。測定条件が公開されていない限り、すべてのチップやモデルに適用すべきではありません。FlashやRRAMへの将来的な言及も、現在の製品提供を保証するものではなく、開発の方向性を示すものです。
情報源は、この発表を、創業者兼CEOであるQiang Wu氏のGPGPUおよびOpenCLに関する過去の取り組みと結び付けています。より実務的には、ツールを公開することで、開発者は統合の挙動を調査し、サンプルを適応させ、修正に貢献できます。
こうしたアクセスにより、デバイスメーカー間での重複作業を減らせる可能性があります。しかし、最終製品における品質、熱特性、メモリ使用量、ライセンス、オフライン動作、復旧動作をテストする必要性がなくなるわけではありません。見出しにあるパラメータ数よりも、想定ハードウェア上で再現可能なサンプルの方が、より良い出発点です。
M50は、レポートで説明されているローカルデバイスAIシナリオで使用されるエッジAIアクセラレータです。例として、エージェントコンピューター、ノートPC、ホームシステム、ロボット、エッジ推論アプライアンスが挙げられます。
レポートでは、2027年1月まで続く段階的な公開計画が説明されています。すでに複数のリポジトリが公開されていますが、開発者は各コンポーネントの実際の公開状況とライセンスを確認する必要があります。
このリポジトリには、プラットフォーム要件が異なる準備・評価ツールが含まれています。推論サンプルには対応するHoumoハードウェアとランタイムライブラリが必要であり、大規模モデルの量子化にはGPUも必要です。
必要なアセットがインストールされていれば、ローカル推論はクラウドモデルサービスなしで動作できます。ライブのメール、メッセージング、その他のオンラインサービスを伴うタスクには、引き続き接続性と認可が必要です。
いいえ。TOPSは特定の精度における演算スループットの指標であり、トークン速度はモデルアーキテクチャ、メモリトラフィック、精度、ソフトウェアの挙動に左右されます。同一モデル・同一ワークロードで測定された結果を比較してください。
いいえ。READMEには、ほとんどのサードパーティ製データセットは別途取得し、それぞれの利用規約に従って使用する必要があると記載されています。リポジトリのライセンスは、参照されているすべてのデータやモデルアセットに対する商用権利を付与するものではありません。
Houmoの発表は、モデル準備から稼働するエッジ製品に至るまでのプロセスを、より再利用しやすくすることを目指しています。公開リポジトリはすでに有用なサンプルを提供していますが、より広範なスタックは依然として段階的な公開計画の途上にあります。
報告されたM50搭載デバイスは、複数の導入形式を示していますが、実際の判断は、正確なモデル、ハードウェア、ランタイム要件に依存します。対応するサンプルから始め、製品ワークロード全体を測定してください。
ひとことから始めて、数分で完全なサイトを手に入れましょう。
