For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/how-to-cut-claude-code-token.md.
Anthropicは、すべてのClaude Codeセッションからより多くの価値を引き出したい開発者向けの実践的なガイドを公開しました。中心となるメッセージはシンプルです。同じコーディングタスクでも、コストを
Anthropicは、すべてのClaude Codeセッションから最大の価値を引き出したい開発者向けに、実践的なガイドを公開しました。
中心となるメッセージはシンプルです。同じコーディングタスクでも、セッションの管理方法によってコストは大きく異なります。
Claude Codeは、タスクごとに固定費がかかる従来のエディタとは異なります。すべてのモデルリクエストには推論コストがかかり、長い会話ではファイル、ツール結果、コマンド出力、システム指示、以前のメッセージが繰り返し引き継がれます。このコンテキストが適切に管理されていない場合、単純なバグ修正でも必要以上に多くのトークンを消費してしまう可能性があります。
元の記事では、アドバイスを6つの実践的な習慣にまとめています:
/clearを実行する。@を使用してファイルを直接参照し、Claudeに検索させない。/compactを実行する。Anthropic自身のTL;DRでも、新しいセッションで/contextを実行して、CLAUDE.mdやMCPツール定義など、すでに読み込まれているものを確認することを推奨しています。
これらの提案は、Claude Codeセッション内でトークンに何が起こるかを理解すると、より理にかなったものになります。
Claude Codeは、有料のClaudeプランまたは従量課金のAPI使用を通じて利用できます。個人ユーザーの場合、Claude Proは現在月額20ドル(月払い)、Claude Maxは月額100ドルからで、より高容量のティアも用意されています。APIの使用量は、モデルとトークン量に応じて別途請求されます。
AnthropicのClaude Codeコストドキュメントによると、エンタープライズ展開全体での平均使用量は、開発者1人あたりアクティブ日数で約13ドル、開発者1人あたり月額約150〜250ドルですが、実際のコストはモデル、コードベース、ワークフロー、自動化のレベルによって大きく異なります。
Claudeが不要なファイルを検索したり、冗長なコマンドを実行したり、無関係なコンテキストを繰り返し引き継いだりすると、同じタスクでも数倍のコストがかかる可能性があります。
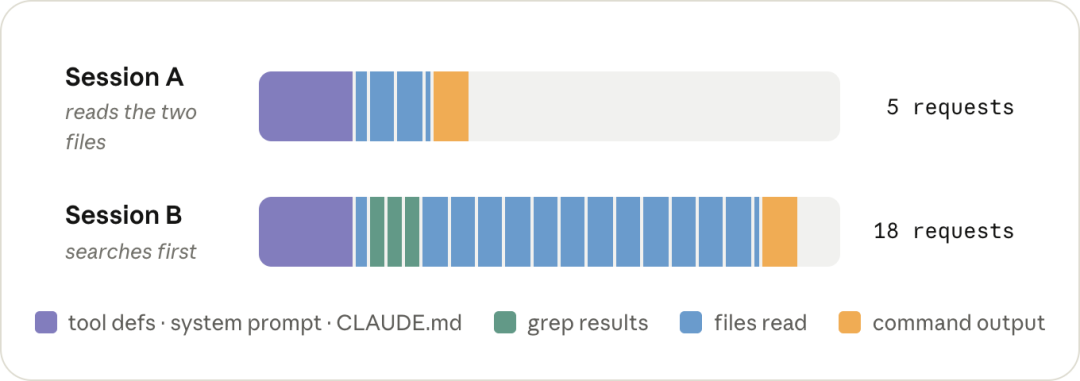
その理由を理解するには、次のように分けて考えると役立ちます。
各リクエストを2つのフェーズに分けます。
プリフィルでは、モデルはリクエストとそのコンテキストを1回のパスで読み取ります。
その入力には以下が含まれます:
CLAUDE.mdこれらはすべて入力トークンとしてカウントされます。
デコードでは、モデルはトークンごとに応答を生成します。
これには、推論トークン、ツール呼び出し、そして最終的に表示されるテキストが含まれます。プリフィルとは異なり、デコードは逐次的です。200トークンの応答には、モデルが200トークンを1つずつ生成する必要があります。
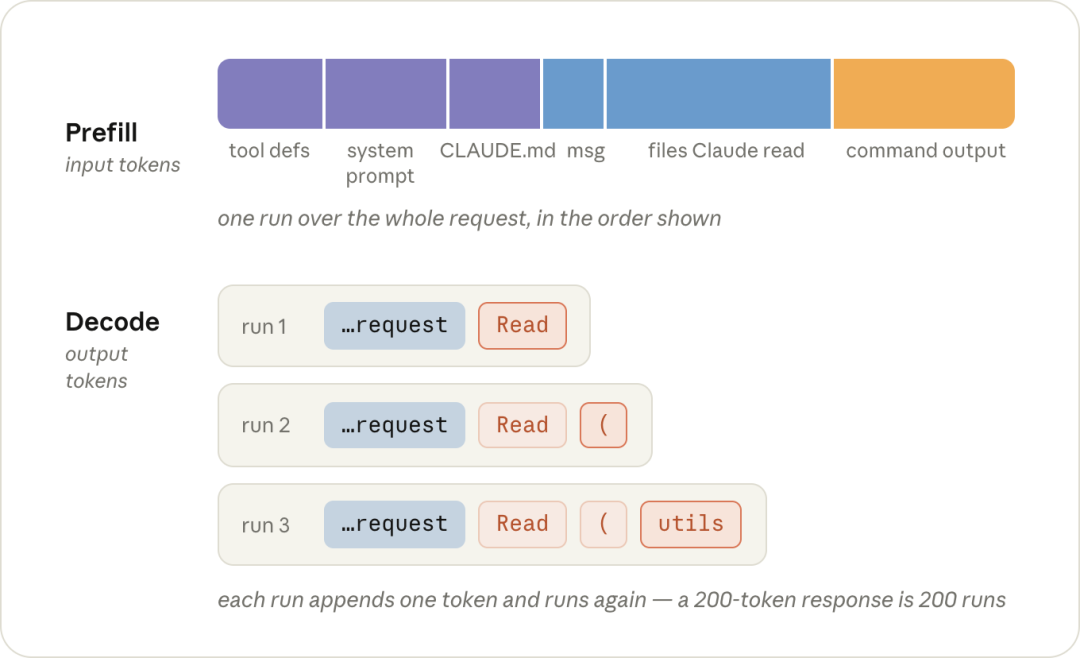
このため、出力トークンは通常、入力トークンよりもはるかに高コストです。ここで説明する現在のClaudeモデルでは、出力価格は基本入力価格の5倍です。
現在の標準API価格は以下のとおりです:
| モデル | 入力 | 出力 |
|---|---|---|
| Claude Opus 5 | $5 / MTok | $25 / MTok |
| Claude Sonnet 5 | $2 / MTok | $10 / MTok |
| Claude Haiku 4.5 | $1 / MTok | $5 / MTok |
MTokは100万トークンを意味します。
もう1つの主要な変数は努力レベルです。エージェント型コーディングセッションで生成される出力の多くは推論です。努力レベルを高くすると、モデルは難しい問題についてより多くのトークンを使って思考できます。一方、努力レベルを低くすると、日常的な作業に適している場合があります。
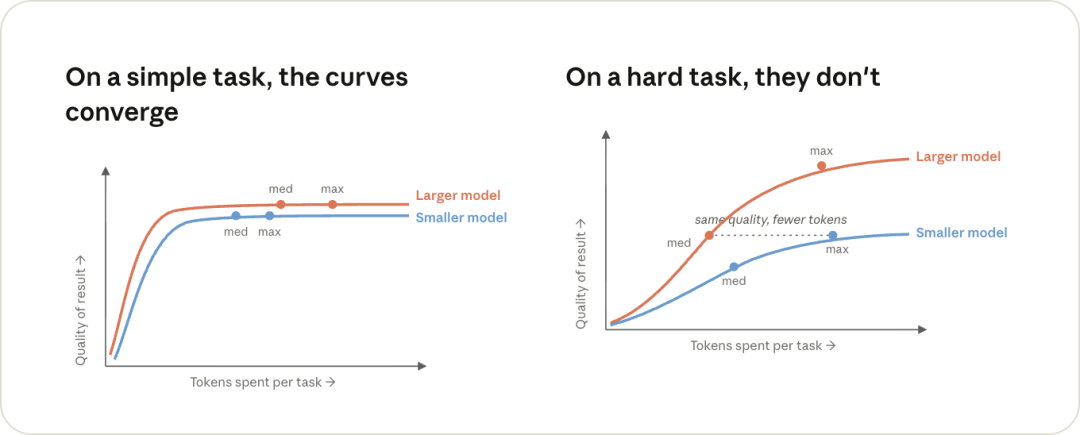
実際的なルールは明確です。問題が本当に困難または曖昧な場合にのみ、より強力なモデルと高い努力レベルを使用し、すべての小さなタスクに自動的に適用するべきではありません。
プロンプトキャッシュは、Claude Codeのコストモデルの中で最も重要な部分の1つです。
すべてのClaude Codeリクエストは、ツール定義、システムプロンプト、CLAUDE.md、およびこれまでに蓄積された会話履歴など、大量の繰り返し素材から始まります。
新しいリクエストの先頭が直前のリクエストと完全に一致する場合、サーバーは共有プレフィックス全体を再度処理する代わりに、以前に計算した状態を再利用できます。
キャッシュ読み取りのコストは、通常の入力トークン価格の0.1倍にすぎません。
キャッシュ書き込みは、サーバーが計算済み状態を保存する必要があるため、通常の入力よりも高コストです。標準の5分間キャッシュ書き込みは基本入力価格の1.25倍、1時間キャッシュ書き込みは2倍です。重要な点は、書き込みは1回だけ発生し、その後のキャッシュヒットでは通常の入力コストの10分の1でプレフィックスを繰り返し再利用できることです。
会話にすでに50,000トークンの履歴が含まれていると想像してください。キャッシュヒットがない場合、モデルは次のリクエストでその履歴全体を通常の入力レートでプリフィルする必要があります。有効なキャッシュがある場合、共有プレフィックスは基本レートの0.1倍で読み取られ、新しく追加された部分だけが
追記された素材は、全額の入力価格で処理されなければならない。
長いエージェントループを経ると、その差は大きくなる可能性がある。
キャッシュは、リクエストの開始から継続的に一致している必要がある。そのプレフィックスの先頭付近で何かが変わると——あるいはキャッシュキーの一部が変わると——残りの履歴は同じ方法で再利用できなくなる。
元の記事では、6つの一般的なケースが挙げられている。
/model でモデルを変更する/effort で推論の努力量を変更する/compact を実行するこれは、モデルや努力量を変更したり、会話をコンパクト化したりしてはいけないという意味ではない。それは、よりコストが安いタイミングがあるということだ:長くて高価なコンテキストの途中ではなく、セッションの開始時または /clear の直後だ。
また、opusplan モードにはあまり明らかでないケースもある。Anthropic は、プランモードに入るまたは出るとモデルが切り替わる可能性があるため、各移行で関連するモデルキャッシュが無効になる可能性があると指摘している。
/compact がより安い理由/compact は現在の会話をはるかに短いバージョンに要約する。
その要約を生成するには既存のコンテキストを読む必要があるため、会話がまだプロンプトキャッシュを通じて利用可能な間にコンパクト化する方が安い。長時間の休憩後まで待ってキャッシュが失効した場合、Claude は要約する前に通常の入力コストで全会話を読む必要があるかもしれない。
そのため Anthropic は、キーボードから長時間離れる前にコンパクト化することを推奨している。
プロンプトキャッシュは繰り返しのコンテキストを安くするが、コンテキスト自体が成長するのを止めるものではない。
Claude がファイルを読むたびに、そのファイルの内容が会話に追加される。コマンドを実行するたびに、その出力も追加される可能性がある。その時点以降、後のターンはその素材を運び続ける。
ターン 40 は単なる最新のリクエストではない。ターン 1 から 39 で起こったことの多くも運んでいる。
そのため、長いセッションは開発者が予想するよりもはるかに速くコストが蓄積される可能性がある。古い履歴が
キャッシュされている場合でも、無関係なコンテキストを繰り返し送信するのはコストがかかりますし、コンテキストウィンドウのスペースも消費します。
Claude Codeには、非常に大きなBash出力に対するガードレールがあります。Anthropicの現在のドキュメントによると、コマンド出力が30,000文字を超える場合、Claude Codeは出力をファイルに書き込み、会話には短いプレビューとパスのみを保持します。
厄介なケースは、出力がノイジーでありながらもその閾値未満の場合です。
数百行の成功したテスト行を出力するテストスイートは、30,000文字未満に収まる場合があります。その場合、それらの行は会話に残り、後続のターンでも送信され続けます。
そのため、Anthropicは作業コンテキストを積極的にスリムに保つことを推奨しています。
@でファイルを参照するClaudeが必要とするファイルが分かっている場合は、直接参照してください。
Claudeにファイルを名前で探させる代わりに、@メンションを使用して、最初からファイルをメッセージに添付します。

これらのプロンプトを概念的に比較してみましょう:
The tests are failing.
Claudeは、実際の問題に到達するまでに、リポジトリを検索し、複数のファイルを検査し、複数のツール結果を収集する必要があるかもしれません。
より具体的なリクエストは、その探索の一部を省きます:
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
Fix the failing test in utils.test.ts.
そして、@参照は、個別のRead呼び出しを回避できます:
Fix the failing test in @utils.test.ts.
いずれの場合もファイルはコンテキストを占有します。節約になるのは、不要な検索やReadのターンを避けることです。
また、1つの会話で同じファイルを繰り返し添付することも避けてください。ファイルが一度コンテキストに入ると、再度言及すると別のコピーが追加される可能性があります。
繰り返されるコマンド出力は、セッションを静かに支配してしまうことがあります。
頻繁に実行するコマンドについては、CLAUDE.mdに簡潔なバージョンを記載して、Claudeが最初からノイズの少ない呼び出し方を知っているようにしましょう。
例えば:
run a single test file with npx vitest run --reporter=dot
ドットレポーターは、数百行の詳細な出力の代わりに、コンパクトな結果のみを返すことがあります。
これは小さな設定変更ですが、多くのターンにわたって、繰り返し送信される大量のコンテキストを節約できます。
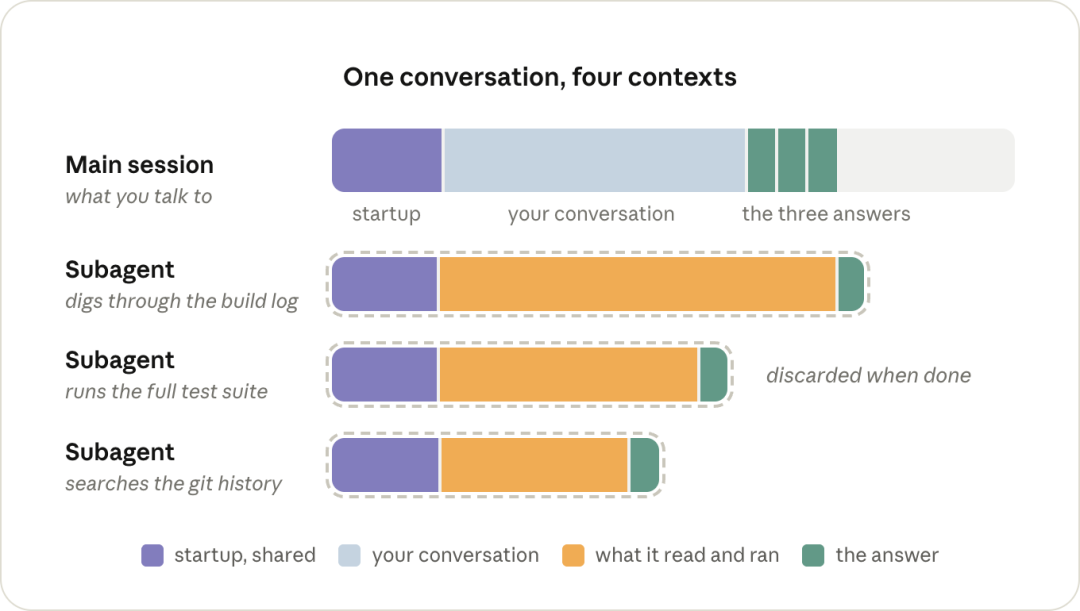
サブエージェントは、独自のコンテキストウィンドウを取得します。
独自のシステムプロンプト、ツール、CLAUDE.mdを持ちますが、メインの会話全体は継承しません。ログの検査、コマンドの実行、履歴の検索、大きなファイルの読み取りなどを行い、親セッションには結果のみを返すことができます。
これは、次のようなタスクに役立ちます:
「このビルドログを調べて、何が問題か教えてください。」
「この大きなファイルを検索して、関連するセクションを報告してください。」
「完全なテストスイートを実行し、重要な失敗を報告してください。」
「Git履歴を調査し、この動作を導入した変更を要約してください。」
中間ファイルの読み込みやコマンド出力は、サブエージェントが終了すると消えてしまいます。メインセッションに入るのは、返された回答だけです。
トレードオフがあります:サブエージェントは親の会話を引き継がないため、メインセッションがすでに知っている資料を再読する必要があるかもしれません。小さな作業では、そのオーバーヘッドによりサブエージェントの効率が低下することがあります。ただし、隔離されたタスクがノイズが多く、そのプロセスをメインコンテキストに残したくない場合には、そのコストに見合う価値があります。
/clear を使用するこれは最もシンプルで価値のある習慣の一つです。
バグ修正を終えて別のタスクを始める際には、次のコマンドを実行してください:
/clear
前のタスクのファイル読み込み、コマンド出力、失敗したアプローチ、一時的なコンテキストは、その後の各ターンに引き継ぐ必要はありません。
Anthropic自身の比較によると、3つの別々のタスクを1つの連続セッションに保持すると、タスク間でクリアする場合よりも大幅に多くのトークンが送信される可能性があります。
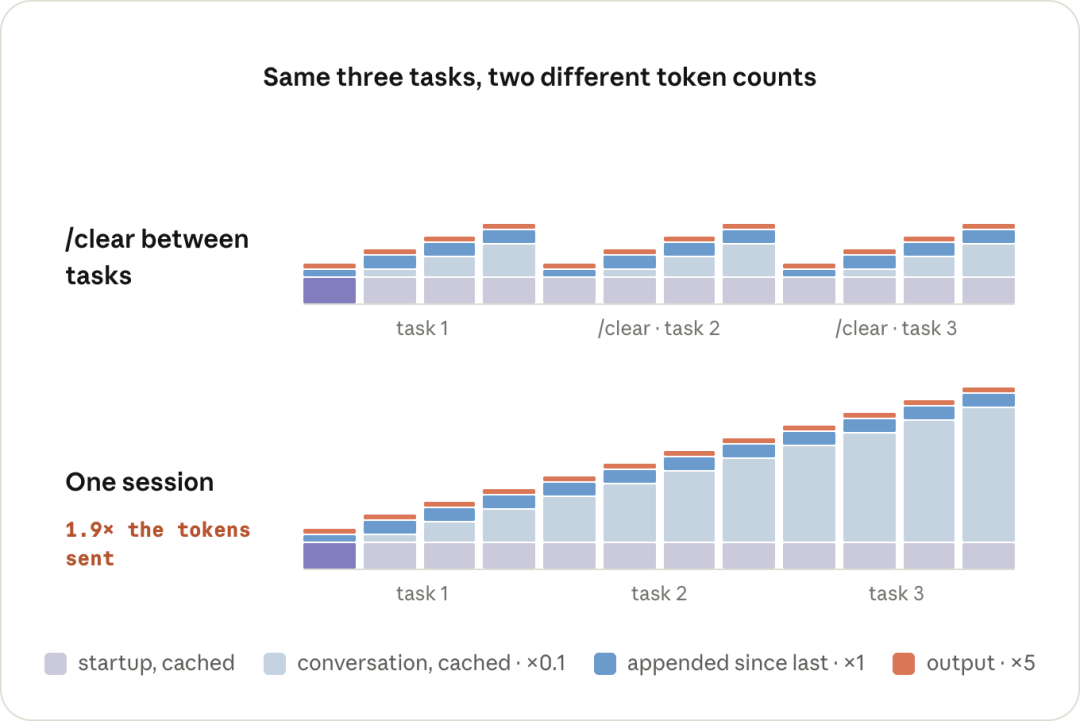
後で古いセッションを保存しておく必要がある場合は、Anthropicは /clear の前に /rename を使用することを推奨しています。
同じタスクを続けていて、会話の古い部分だけを圧縮する必要がある場合は、/compact がより良いツールです。
/rewind を使用する見落としがちなもう一つの便利なオプションがあります:
/rewind
セッションが最後の数ターンだけで脱線した場合、巻き戻すことで以前の会話全体を書き直すことなく、そのターンを削除できます。
これはキャッシュにとって重要です。Anthropicによると、巻き戻しポイントより前の部分はキャッシュされたままになる可能性がありますが、/compact は会話を書き直すため、独自のコストが発生します。
つまり、3つのコマンドはそれぞれ異なる目的を持っています:
| コマンド | 最適な使用場面 |
|---|---|
/clear | 本当に新しいタスクを開始する場合 |
/compact | 同じタスクを続けつつ、より短いコンテキストが必要な場合 |
/rewind | 最新のターンだけが間違っている、または不要になった場合 |
これらの仕組みが明確になると、より広いパターンが見えてきます。
効率的なAI支援コーディングには、現在では新しい種類の運用判断が必要です。開発者はコードの書き方やデバッグ方法だけでなく、以下も知っておく必要があります:
1年前、これらの判断は日常のソフトウェア開発にはほとんど存在しませんでした。現在では、2人の開発者が実質的に同じ作業を完了するために、大きく異なる金額を支払うかどうかを左右する可能性があります。
Anthropic自身が、この重要性を大規模に示しています。
同社は2026年に、Anthropicのコードベースにマージされたコードの80%以上がClaudeによって作成されたと報告し、典型的なエンジニアが
2024年と比較して、1日あたり約8倍のコードをマージしていました。別の内部最適化ベンチマークでは、Claudeベースのシステムは2025年の約3倍の高速化から、2026年4月までに約52倍にまで進歩しました。
そのレベルのAI利用において、推論効率は小さな会計上の詳細ではありません。
したがって、Anthropicのガイドから得られるより深い教訓は、単に「トークンを減らす」ことではありません。トークンがどこに使われているかを理解し、それらが古い履歴や回避可能な出力ではなく、有用な推論、コード変更、ツール作業に費やされていることを確認することです。
新しいターンごとに関連する会話履歴(メッセージ、ファイル、ツール呼び出し、コマンド出力を含む)が引き継がれます。プロンプトキャッシュにより繰り返されるプレフィックスのコストは大幅に削減されますが、増大するコンテキストは依然としてトークンとコンテキストウィンドウの容量を消費します。
プロンプトキャッシュヒットは通常のベース入力トークン価格の0.1倍で請求されるため、キャッシュされた入力部分で90%の削減になります。キャッシュ書き込みは通常の入力よりもコストがかかりますが、繰り返しのキャッシュ読み取りにより、初期の書き込みコストをすぐに相殺できます。
/clearと/compactのどちらを使うべきですか?別のタスクに移行し、現在のコンテキストが不要になった場合は/clearを使用します。同じタスクを続けながら、古い会話履歴をより小さな作業コンテキストに要約したい場合は/compactを使用します。
/rewindは何をしますか?/rewindを使用すると、以前のメッセージに戻り、その後のターンをアクティブなコンテキストから削除できます。会話の最新部分だけが間違った方向に進み、セッション全体を圧縮またはクリアする必要がない場合に役立ちます。
増加する可能性があります。各モデルは別個のプロンプトキャッシュを使用するため、長い会話の途中でモデルを切り替えると、既存の履歴が新しいモデルに対して全額の入力価格で再処理される可能性があります。
@を使うべきなのはなぜですか?@ファイル参照はファイルをメッセージに直接添付するため、Claudeがファイルを検索したり、追加のRead呼び出しを行ったりする手間を省けます。ファイルの内容は依然としてコンテキストを消費するため、その利点は不要な探索ステップを回避することであり、ファイル自体を無料にすることではありません。
メインの会話では不要な中間出力を大量に生成する作業(ログの検査や広範囲の検索など)にはサブエージェントを使用してください。サブエージェントは別のコンテキストで作業し、最終的な回答のみをメインセッションに返します。
新しいClaude Codeセッションで/contextを実行してください。Anthropicは、CLAUDE.mdやMCPツール定義などの起動時コンテキストを検査し、不要な指示や統合を削除できるようにすることを推奨しています。
Claude Codeを含むClaudeプランに適用されるポイントです。
--reporter=dotを使用してノイズの多いテスト出力を削減する際に使用されるJavaScriptテストフレームワークです。Claude Codeのコストは、モデル価格だけによって決まるわけではありません。コンテキスト長、推論努力、コマンド出力、セッション長、キャッシュヒット、ファイル検出、サブエージェントの使用はすべて、タスクが消費するトークン数を変え得る要因です。
最も価値の高い習慣はシンプルです。タスクが変わったらコンテキストをクリアする、セッション途中での不要なモデルや努力レベルの切り替えを避ける、ノイズの多い出力を短く保つ、既知のファイルを直接参照する、長い休憩前に圧縮する、サブエージェントの方が適切な場合は高出力の作業を分離する——これらです。
これらの実践は、何が何でもトークン使用量を最小化することを目的としていません。支払ったトークンが、無関係な履歴を繰り返し運ぶのではなく、タスクに貢献していることを確実にすることを目的としています。
効率的なClaude Codeの使用は、ますますコンテキストエンジニアリングの一形態になりつつあります。コンテキストを関連性のあるものに保ち、役立つ場合はキャッシュを維持し、実際に結果を向上させるところに推論を費やしましょう。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



