For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/infinihand-streaming-3d-hand-motion-from-53c55163.md.
頭部装着カメラは、人が物体をどのように操作するかを捉えられます。しかし、その記録を有用な3Dモーションに変換することは困難です。手もカメラも動き、指は物体の陰に隠れ、両手が互いを遮ることもあります。
頭部装着カメラは、人が物体をどのように操作するかを捉えられます。しかし、その記録を有用な3Dモーションに変換することは困難です。手もカメラも動き、指は物体の陰に隠れ、両手が互いを遮ることもあります。
InfiniHand は、手の位置特定、詳細な手の復元、カメラモーション推定を、ストリーミングフレームワークに統合しています。その目的は、連続する手のポーズを共通のワールド座標系に配置し、大規模なアノテーションや将来的な身体性学習ワークフローにより役立つモーションにすることです。
この研究は、Shanghai Artificial Intelligence Laboratory、Shanghai Jiao Tong University、および複数の大学に所属する研究者によるものです。プロジェクトページでは、同期された視覚比較と3Dモーションビューアーを提供しています。
切り出した手の画像は、指の関節動作を識別するのに役立ちますが、周囲のシーン内で手がどこにあるかについて得られる情報は限られます。同様に、画像内での移動は、手の動き、頭部の回転、またはその両方によって生じる可能性があります。
従来のパイプラインでは、手の検出器、ポーズ推定器、カメラトラッキングシステム、位置合わせの工程を組み合わせることが一般的です。一つの段階の誤差が次の段階へ伝播する場合があります。たとえば、手を見逃すと復元結果が変わり、不正確なカメラ経路は見かけ上のグローバルモーションを変化させます。
InfiniHand は、これらのタスク間で幾何学的コンテキストを共有します。事前学習済みの LingBot-Map バックボーンがフルフレーム特徴を抽出し、左右の手の位置特定を支援します。手の復元コンポーネントは、これらの特徴と手を中心とした外観情報を組み合わせ、より細かな関節動作を復元します。
手の表現には、ポーズ、形状、向きのための MANO パラメータを用います。補助的な2Dランドマーク教師あり学習により、予測された3Dハンドが画像へ再投影される方法を制約します。その後、カメラ推定を用いることで、復元された手を時間をまたいで同一のワールド座標系で表現できます。
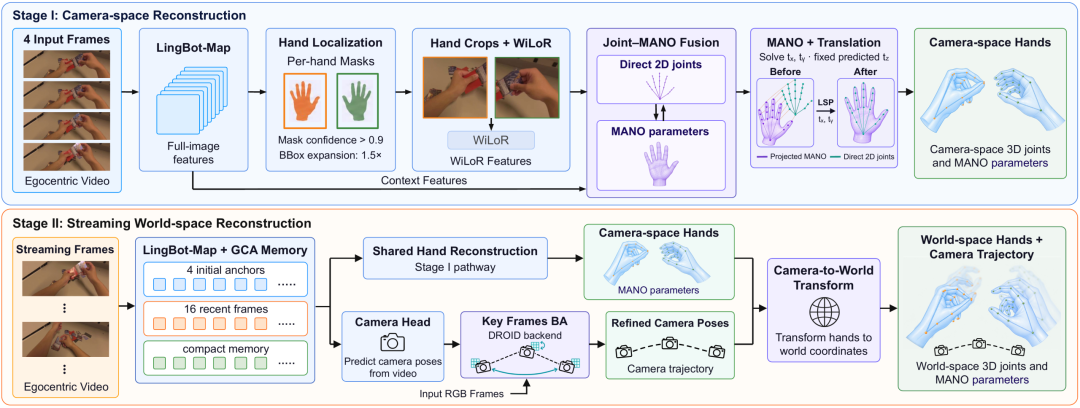
QbitAI/BAAIレポートに再掲されたInfiniHandの手法図。
研究チームは、ARCTIC、HOT3D、EgoDexを含む9つのデータセットから、約5,000時間の公開エゴセントリック動画を収集しました。これらのソースを統合するには、単にファイルを連結するだけでは不十分です。手の順序、座標の規約、アノテーションの種類が異なる場合があるためです。
前処理パイプラインは、利用可能な画像、手のパラメータ、関節、マスク、バウンディングボックスを標準化します。可能な場合には、3D関節から欠落したMANOパラメータをフィッティングします。カメラ軌跡を含むシーケンスは、ワールド空間の教師あり学習も提供できます。
アノテーション品質は別の課題です。チームは Sapiens 2 を用いて2D手ランドマークを予測し、それらを画像上に投影した元のアノテーションと比較します。継続的な不一致は、誤った対応付け、不適切な投影、または妥当性の低いポーズを示す可能性があります。
論文によると、このプロセスは候補となる学習データの約 30~40% を除外し、不確実なケースは手動確認に回されます。この図は候補データのクリーニングプロセスを説明するものであり、著者がここで提示していない正確な保持時間数を推測するために使うべきではありません。
学習は次の2段階で進められます。
この構成により、アノテーションの網羅性が異なるデータセットであっても、それぞれが教師あり学習できるモデル部分に貢献できます。
InfiniHand は、幾何学的メモリを保持しながら、入力動画をウィンドウ単位で処理します。そのコンテキストには、初期の参照情報、直近の詳細特徴、古い観測情報を圧縮した情報が含まれます。
実装では、二つの予測タスクを重ねて実行します。一方のワーカーが次のウィンドウをバックボーンに通して処理する間、もう一方のワーカーが前のウィンドウの手とカメラの予測をデコードします。特徴の再利用とアイドル時間の削減により、より高いスループットを支援します。
論文では、HaWoR の5.48 FPSと比較して、11.19 FPSの予測スループットを報告しており、報告された比較条件下で2.04倍の改善です。これは、あらゆる環境で30 FPSのリアルタイム動作を実現するという主張でも、任意のハードウェアにおける速度保証でもありません。
より長いシーケンスでは、別のワーカーがスパースバンドル調整を実行し、カメラ軌跡を洗練します。バイナリキーフレームプールは、直近の観測に加えて、選択された過去フレームを保持します。このバックグラウンド最適化には、報告された予測スループットとは別に追加の計算コストがかかります。
カメラ空間での評価は、34のARCTICシーン、10のHOT3Dシーン、166のHOI4Dシーン、100のEgoDexシーンを対象としています。研究者らは複数の既存復元手法と比較しています。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
レポートでは、ポーズ誤差と検出漏れに対するペナルティを組み込んだ指標である PA-p を強調しています。報告された比較では、値が低いほど良好です。
| データセットと指標 | 比較手法 | InfiniHand | 報告された削減率 |
|---|---|---|---|
| ARCTIC PA-p | ViDiHand:9.82 mm | 7.72 mm | 21.4% |
| EgoDex PA-p | ViDiHand:17.22 mm | 7.29 mm | 57.7% |
| EgoDexワールド空間 W-MPJPE | Dyn-HaMR:78.41 mm | 28.77 mm | 63.3% |
これらの行は異なるデータセットおよび指標に関するものであり、単一の精度主張に平均化すべきではありません。InfiniHand は、ARCTIC、HOT3D、EgoDexで比較された手法の中でも、最も低いW-MPJPEを報告しています。
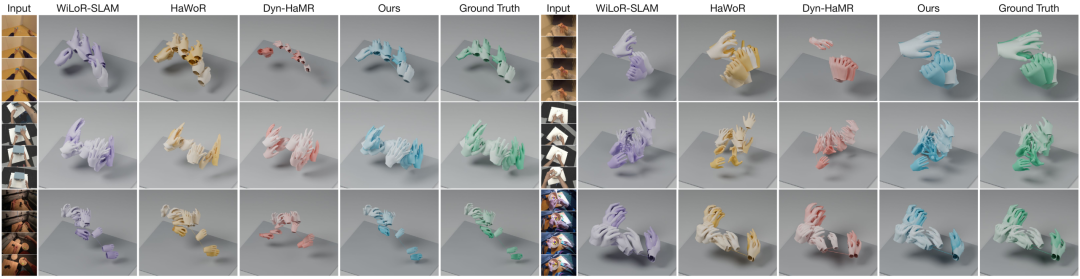
位置合わせ済みの定性的比較。青はInfiniHand、緑は参照値を示します。位置合わせは可視化の一部であり、見かけ上の一致を解釈する際には考慮する必要があります。
ソースでは、遮蔽や物体操作を伴う自然環境のEgo4D事例についても説明しています。図示されたオフライン比較の一つでは、InfiniHandに外部の手の位置特定を用いています。読者は、この設定を統合モデルの位置特定に関する主張とは区別すべきです。インタラクティブなプロジェクトデモが、関連する視覚的コンテキストを提供しています。
人の3Dデモンストレーションを復元することは、器用な物体操作、モーション転写、模倣学習の研究用データを準備するうえで役立つ可能性があります。復元された手のモーションをロボット学習データへ変換するには、依然として品質確認とロボットの物理構造への適応が必要です。
著者らは複数の限界を指摘しています。LingBot-Mapは本質的にメートル単位のスケールを復元しないため、補助的な位置合わせモデルが必要であり、これが誤差を導入する可能性があります。適切な学習データが限られているため、急激な視点変化、深刻な遮蔽、断続的な手の可視性は依然として困難です。
単眼の教師あり学習では、時間とともに変動するスケールドリフトが学習に持ち込まれることもあります。スパースな洗練処理は役立ちますが、復元されるすべての軌跡を正確な物理計測値にするものではありません。
エゴセントリック動画から、手の位置、MANOハンドパラメータ、カメラ軌跡を推定します。これらの推定結果により、共通のワールド座標系で手のモーションを表現できます。
カメラ空間における手のモーションは、カメラの動きに応じて変化します。共通のワールド座標系を使うことで、移動する視点を考慮しながら、フレーム間で手の軌跡を比較しやすくなります。
提案フレームワークには、独自の位置特定コンポーネントが含まれています。ただし、ソースには外部の手の位置特定を用いるオフラインの定性的事例があるため、表示される各比較の設定を確認する必要があります。
いいえ。これは著者らが報告した評価条件における予測スループットです。バックグラウンドでのスパースバンドル調整には追加処理が必要であり、性能は実行構成に依存します。
研究者らは、投影されたアノテーションを画像ベースの2D手ランドマーク予測と比較し、継続的な不整合があるシーケンスを除外します。候補データの約30~40%を除外し、曖昧なケースは手動確認用に確保したと報告しています。
この論文は、検証済みのロボット直接制御システムではなく、復元およびアノテーション研究を提示しています。ロボットでの利用には、リターゲティング、物理的制約、タスク固有の検証が必要です。
InfiniHandは、シーン幾何、詳細な手の外観、カメラ推定を組み合わせ、第一人称動画から手のモーションを復元します。そのストリーミング設計とデータクリーニングパイプラインは、大規模な動画コレクションにアノテーションを付与するという実務的な課題を対象としています。
報告されている精度およびスループットの改善は有望な研究結果ですが、スケール復元とバックグラウンドでの洗練処理には重要な条件があります。出力は有用な復元推定値であり、下流の物理タスクに使用する前には依然として検証が必要です。
ひとことから始めて、数分で完全なサイトを手に入れましょう。
