For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/meta-muse-wonder-and-full-benchmarks-memo-741b367d.md.
Metaは2026年10月12日、**Muse Wonder**と**Muse Wonder Full**を発表しました。このリリースは、役立つコンテキストを記憶し、障害を乗り越え、1回の回答だけでは完結しないプロジェクトを完了することが期待される、個人向けおよび業務向けエージェ...
Metaは2026年10月12日、Muse WonderとMuse Wonder Fullを発表しました。このリリースは、役立つコンテキストを記憶し、障害を乗り越え、1回の回答だけでは完結しないプロジェクトを完了することが期待される、個人向けおよび業務向けエージェントを対象としています。
公式発表では、WonderがMeta Model APIおよびMuse Codeを通じて利用でき、FullはMuse Codeの購読者に提供されることが確認されています。Metaは、まず購読者からWonderをMuseアシスタントにも導入する計画です。
モデルカードには、100万トークンの推論コンテキストと、テキスト、画像、動画、音声にまたがる入力が記載されています。記載されている出力モダリティはテキストです。したがって、マルチモーダル理解を、モデル自体があらゆる入力メディアを生成するという約束と混同すべきではありません。
Metaによると、これらのモデルは、同社のAIスタック全体の再構築に続き、ギガワット規模のPrometheusデータセンターでトレーニングされました。トレーニングインフラはこのリリースの背景を説明するものですが、すべてのアプリケーションがベンチマークのデモと同等に機能することを裏付けるものではありません。
提供されたレポートでは、Wonder FullはArtificial Analysis Intelligence Indexで56を記録し、Wonderの52、Muse Spark 1.3の48を上回ったとされています。Artificial Analysisによる独自評価も、最大推論努力時のこれらの数値を裏付けています。これらは恒久的な順位ではなく、報告された評価時点のスナップショットを示すものです。
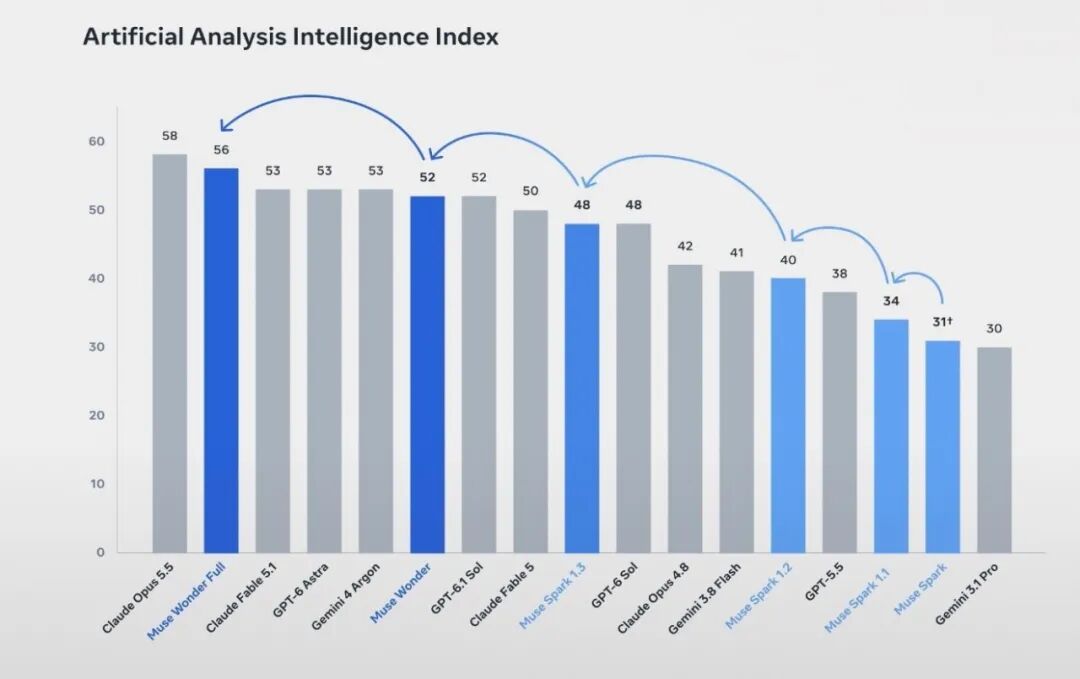
BAAIのXinzhiyuanレポートに掲載されたグラフ。評価は同レポートでArtificial Analysisに帰属しています。
継続的なソフトウェア作業について、情報源は次の結果を報告しています。
| 評価 | Wonder Full | Wonder | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| SWE-Marathon | 57.5% | 53.1% | 46.3% | 42.5% |
| DeepSWE v1.1 | 79.0% | 78.8% | 74.2% | 74.1% |
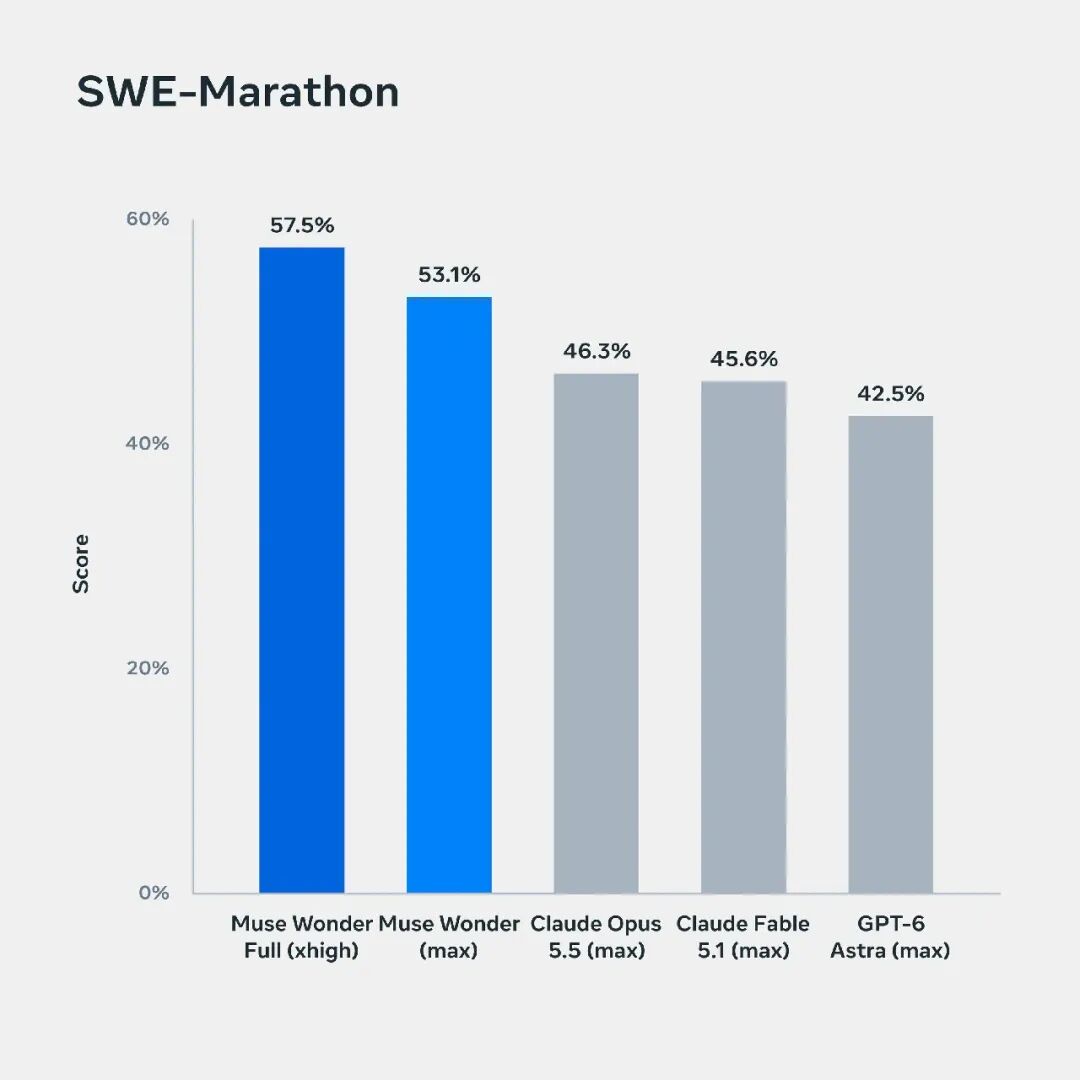
情報源に転載されたMetaのベンチマーク図。
モデルカードには有用な留保があります。SWE-Marathonは、共通のハーネスを使用した統制比較ではありません。競合結果の一部ではCodexまたはClaude Codeが使われており、Wonder Fullの報告結果ではxhighの推論努力が使われています。DeepSWEも、指定されたサードパーティー結果とプロバイダー報告結果を組み合わせているため、読者は各ベンチマークの方法論を確認すべきです。
全体像は、完全な一人勝ちというよりも複合的です。この記事では、FullはProgramBenchでGPT-6 Astraを上回る一方、Opus 5.5には及ばず、記載されたターミナルコーディング比較では両方を下回ると報告されています。モデル選定は依然として、実際の作業内容、ツール環境、予算、許容可能な失敗率に左右されます。
Metaは、会話間で重要なコンテキストを保持し、必要なときに関連する詳細を取得する機能をActive Memoryと呼んでいます。また、別のアプローチを試し、新情報に適応し、障害を越えて作業を続ける持続的な取り組みをActive Focusと呼んでいます。
これらの能力は異なる問題に対応します。要件を記憶しているだけでは、エージェントが難しい実装を完了できるとは限りません。また、エージェントが重要な制約を見失っていれば、持続性も役に立ちません。
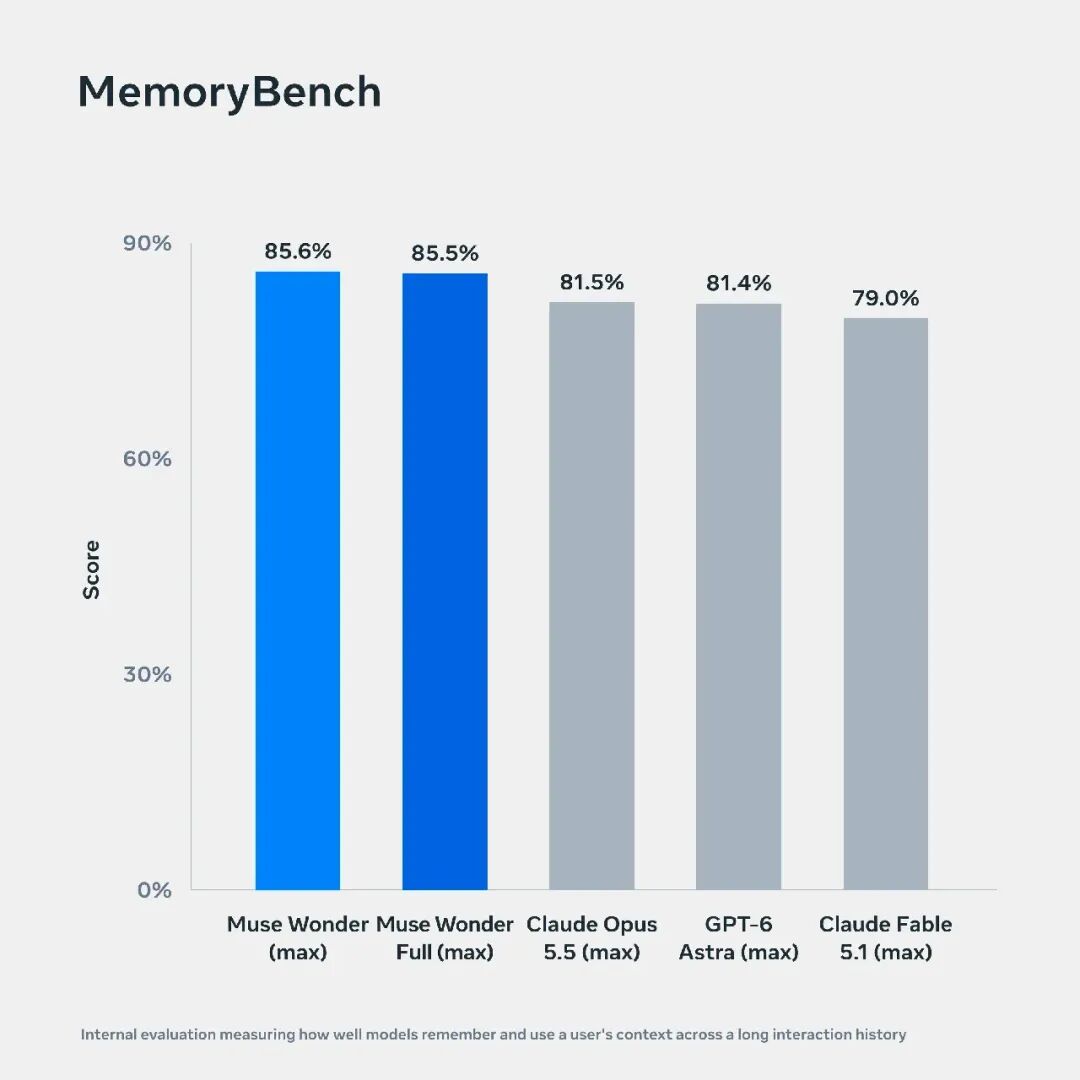
情報源レポートを通じて転載されたMetaの評価図。
モデルカードによると、MemoryBenchは、注意をそらす情報や矛盾する情報を含む64,000〜100,000トークンの会話を用いた社内評価です。FocusBenchも社内評価です。これらは何がテストされたかを理解するうえで有用ですが、導入済みサービスにおける完全無欠の想起や中断のない自律性を保証するものではありません。
Metaは、コーディングに加え、法律、金融、医療、専門文書に関するタスクでモデルを評価しています。これらのテストは、特定の成果物と採点ルールに関するものであり、スコアを専門資格とみなすべきではありません。
この日本語以外の情報源レポートでは、選択的に回答することと、より多くを知っていることの違いも強調されています。そこでは、比較対象のOpusおよびAstraモデルより低い知識指数と並んで、Fullのハルシネーション指標がより低かったと報告されています。この議論におけるハルシネーションの割合は、知識テストで誤答または未回答だった項目を条件とするものであり、現実世界のすべての応答のうち誤っている割合ではありません。
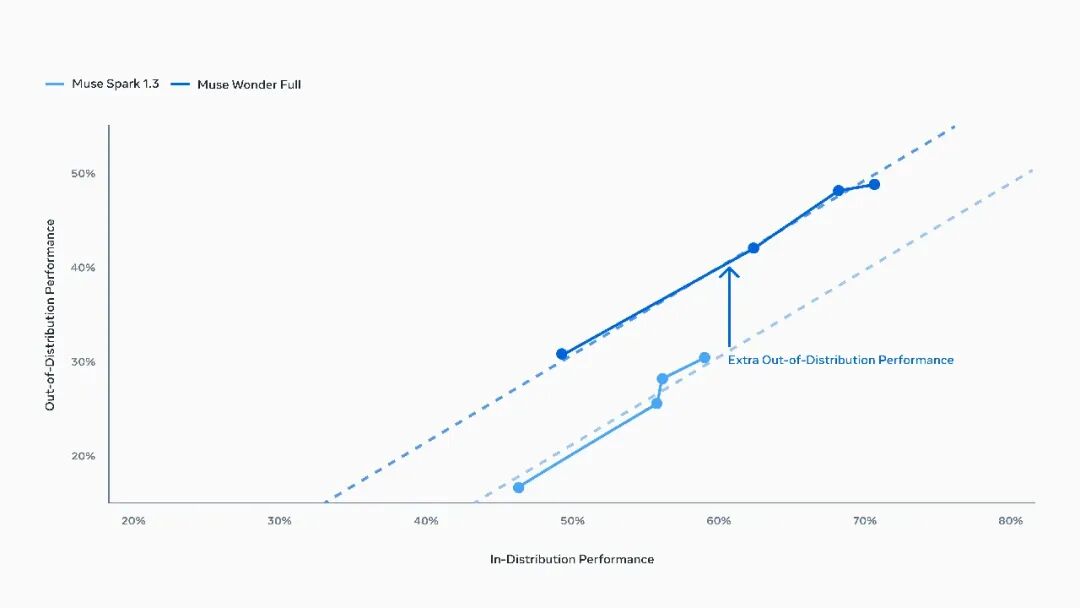
未知のタスクについて、Metaは、同等のインディストリビューション性能において、Fullが以前のSparkモデルより優れた一般化を示す証拠を提示しています。この結論は測定された評価設定に関するものであり、無制限の自己改善の証明ではありません。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
情報源に転載されたMetaの一般化グラフ。
情報源は、レポート作成時点の価格として以下を挙げています。
| 製品 | 報告価格 | 報告された利用方法 |
|---|---|---|
| Wonder API入力 | 100万トークンあたり4ドル | 従量課金API |
| Wonder API出力 | 100万トークンあたり20ドル | 従量課金API |
| Wonder APIキャッシュ入力 | 100万トークンあたり0.20ドル | キャッシュ入力 |
| Full:Power Usage | 月額50ドル | Muse Codeサブスクリプション |
| Full:Maximum Usage | 月額200ドル | Muse Codeサブスクリプション |
このレポートでは、2つのFullサブスクリプションは、それぞれベースライン利用量の20倍および80倍を提供すると説明されています。これらの倍率は無制限利用を意味するものではなく、情報源は月あたりのタスク数について普遍的な数値を示していません。
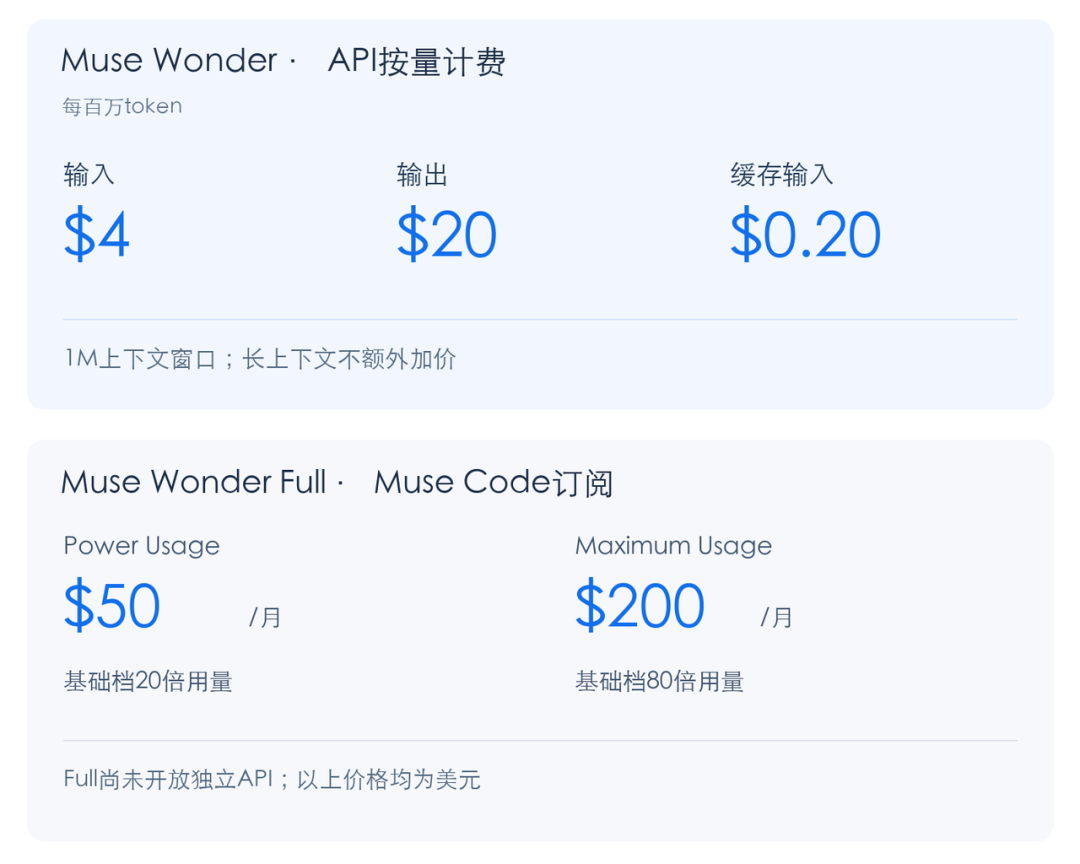
情報源レポートに帰属する価格図。現行の請求条件には独自にアクセスできませんでした。
発表時点で、Fullは別途発表されたパブリックAPIではなく、Muse Codeサブスクリプションを通じて提供されていました。いずれかの製品を検討するチームは、ワークロードを確定する前に、自身のアカウントでの現在のアクセス状況と価格を確認すべきです。
Muse Wonderは、個人向けおよび業務向けのエージェントタスクを対象として、Metaが2026年10月12日にリリースしたモデルです。Metaは、メモリ、継続的なタスク実行、コーディング、領域特化型の作業における強みを説明しています。
Fullは、報告された評価の多くでより高い性能を示したバリアントです。公式発表では、WonderはAPIおよびMuse Code経由で提供され、FullはMuse Codeの購読者に提供されています。
Metaのモデルカードには、推論時に100万トークンと記載されています。コンテキスト容量は、信頼できる想起、出力上限、特定のアプリケーションが提供できる有用な素材の量とは別のものです。
モデルカードには、テキスト、画像、動画、音声の入力が記載されています。出力はテキストと記載されているため、マルチモーダル入力のサポートをネイティブな音声または動画生成と解釈すべきではありません。
いいえ。報告されたスコアは、特定のタスク、エージェント設定、推論設定に適用されるものです。Metaは、SWE-Marathonの結果が、比較されるすべてのシステムに共通する統制済みハーネスを使っていないことを明示しています。
Active Memoryは、会話をまたいで関連コンテキストを保持・取得することに関わります。Active Focusは、必要に応じて明確化や確認を行いながら、障害を乗り越えてタスク中に適応し続けることに関わります。
10月12日の発表では、FullはMuse Codeの購読者に提供されると説明されています。個別のパブリックFull APIは発表されておらず、利用可否はその後の公式発表を確認すべきです。
Muse WonderとFullは、100万トークンのコンテキスト、マルチモーダル入力、メモリ、継続的なコーディング能力を備え、Metaのエージェント製品群を拡張します。発表では、異なるAPIおよびサブスクリプションのアクセス経路が確認されており、情報源はMuse Spark 1.3からの大幅な改善を報告しています。
最も有用な比較では、ベンチマークスコアだけでなく、そのハーネス、アカウントのアクセス状況、自社タスクを完了するためのコストも併せて検討します。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



