For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/meta-s-muse-wonder-bet-zuckerberg-and-wan-276b832c.md.
Metaは、その投資を正当化すると見込むモデルを確認する前に、巨額のAIインフラ支出を約束しました。10月13日に公開された[Cheeky Pintのインタビュー](https://cheekypint.substack.com/p/muse-wonder-zuckerberg-...

Metaは、その投資を正当化すると見込むモデルを確認する前に、巨額のAIインフラ支出を約束しました。10月13日に公開されたCheeky Pintのインタビューで、マーク・ザッカーバーグとアレクサンダー・ワンは、この決断に伴う不確実性と、その後に続く製品上の構想を説明しています。
この対談は、MetaがMuse Wonderをどのように捉えているかを理解する助けになります。Muse Wonderは、高性能なモデルであると同時に、コンテキストを記憶し、判断を行い、最終的にはコマースにも関与するアシスタントの基盤として位置付けられています。また、期待外れのモデルが出れば自動的に会社が破綻する、といった主張よりも、財務上の賭け金を明確に示しています。
ザッカーバーグは、チームが賭けていたモデルをまだ確認していなかった前年後半に、1,000億ドルから2,000億ドル規模の小切手を検討していたことを振り返っています。彼は、この投資判断を支持できるほど研究の方向性に確信があるかどうかをワンに尋ねたと説明しています。
これらの数字は、投資に関する議論の規模を示すものです。Muse Wonderの公表済み学習費用、単一実験の価格、または範囲が明確に定められた最終購入額として扱うべきではありません。このインタビューでは、インフラ容量、建設支出、運用コストが行き来しており、これらは関連しつつも異なる財務カテゴリーです。
ワンは、ハワイでの経営幹部の集まりで、CFOのスーザン・リーが失敗すれば財務的に非常に悪い結果になると繰り返し強調していたことを回想しています。これは深刻なプレッシャーと大きな下振れリスクを示します。しかし、破綻や、1つのモデルの失敗によって会社が倒産するという会社予測を裏付けるものではありません。
その後の対話は追加の文脈も示しています。ザッカーバーグは、成功までに数回の反復が必要になっても対応可能だったと述べ、ワンはMetaを回復力のある企業として説明しています。インタビューを解釈する際には、これらの発言を財務上の警告とあわせて考慮すべきです。
両氏は、Meta Superintelligence Labsの中にある、比較的小規模で優秀な人材が密集した研究組織について説明しています。彼らの説明では、この研究グループは200人未満で、100人に近い規模です。インフラや製品に関わるすべての従業員が、1つのモデル学習チームに属しているという描き方ではありません。
この区別は重要です。小規模な研究ラボであっても、コンピューティング、データセンター運用、安全性対応、配信、製品統合については、非常に大きな組織に依存する場合があります。研究部門の人員数は、その取り組みに投入される総リソースと同じ指標ではありません。
この議論は、事前学習と事後学習を最終的なユーザー体験に結び付けています。目標は、孤立したベンチマーク問題を解くモデルだけではありません。リクエストに複数の手順が必要な場合や、過去のやり取りの情報が関係する場合にも、行動が有用であり続けるシステムです。
Metaの10月12日の発表では、Muse Wonderを、ギガワット規模のPrometheusインフラを用いて学習された大規模モデルとして説明しています。この発表はMuse Sparkと並ぶモデルとして位置付けており、両者を交換可能な製品として説明しているわけではありません。
Metaによると、WonderはMeta model APIおよびMuse Codeを通じて利用可能で、Wonder FullはMuse Codeのサブスクライバー向けに提供されています。また、アシスタントの展開はサブスクライバーから始まります。これらは異なるアクセス経路であるため、1つのモデルやサブスクリプション体験の利用可能性を、すべてのMetaユーザーまたは開発者アカウントへ一般化すべきではありません。
独立評価は、モデルの位置付けについて別の視点を提供します。Artificial AnalysisのMuse Wonder評価は、評価時の最大設定において、WonderのIntelligence Indexスコアを52、Wonder Fullを56と報告しています。これらの結果は、特定の評価構成とベンチマークバージョンに属するものであり、あらゆるワークロードにおける恒久的な順位を意味するものではありません。
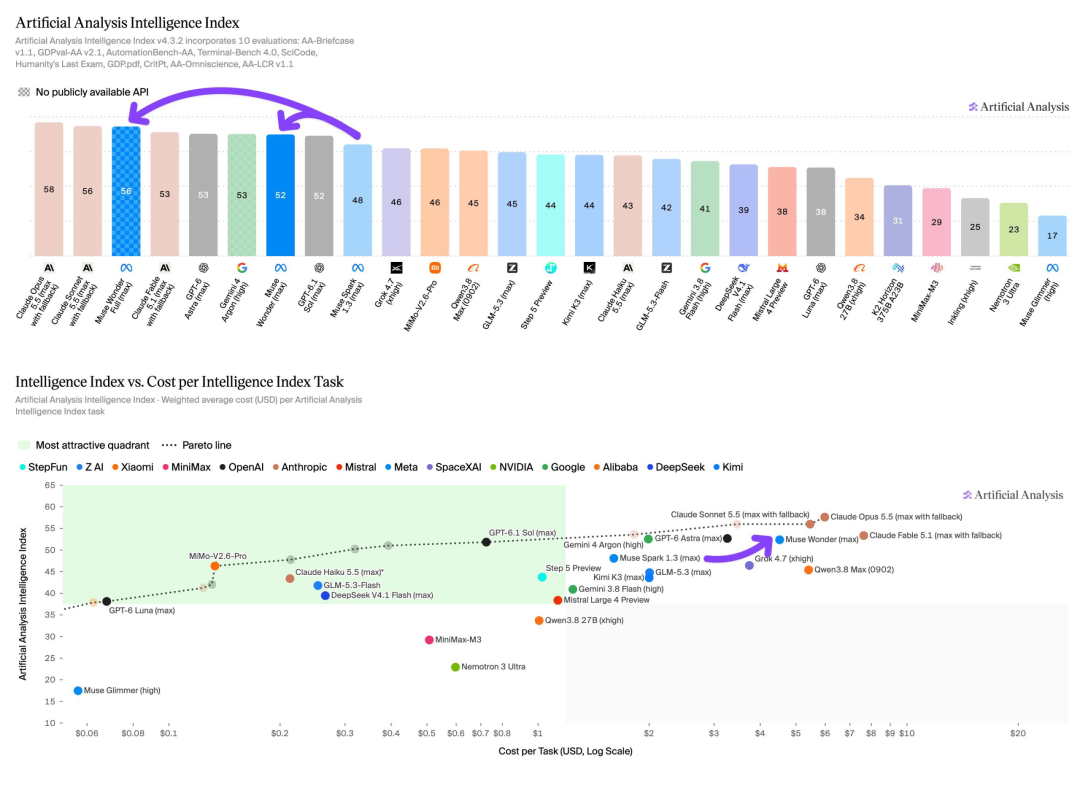
出典:BAAI Hubに掲載されたXinzhiyuanのレポートで再掲・注釈されたArtificial Analysisの図。この図は表示時点のベンチマーク性能とタスクコストを比較したものであり、Metaの財務的リターンを測定するものではありません。
あるモデルがベンチマークで高い順位にあっても、特定のタスクには適さないことがあります。ソースレポートにおける視覚デモへの賛否両論は、生成された成果物を、リーダーボードの順位だけで判断せず、機能性や一貫性を含めて直接検証すべき理由を示しています。
ザッカーバーグの中心的な論点の1つは、モデルの振る舞いそのものが製品上の意思決定であるということです。アシスタントは正しく回答するだけでは足りません。どのコンテキストが重要か、いつ質問すべきか、ユーザーのために行動する際にどの程度の情報を共有すべきかを判断する必要があります。
Metaの発表では、関連する2つの能力が示されています。
これらはMetaによるシステムの説明であり、すべての行動が常に適切であるという独立した保証ではありません。それでも、単一のプロンプトと回答の対話から、より重大な判断を下す持続的なアシスタントへの移行を示しています。
インタビューでは、裁量の説明にレストラン予約の例を用いています。アシスタントは、プライバシーに関わる詳細を不必要にレストランへ開示することなく、ある人の健康上またはアレルギー上のニーズに適した店を見つける必要があるかもしれません。正しい事実を記憶することと、何を開示するかを決めることは、別々の責務です。
この例は、メモリーを実用的な信頼の問題として捉えさせます。保持されるコンテキストが増えるほど有用性は向上し得ますが、支援を成功させるには、関連情報を選択し、タスクの境界を尊重することも必要です。
対話は、エージェントがユーザーに代わって商品やサービスを購入する話題へ移ります。ザッカーバーグは、すべての消費者向けAI対話が同じ方法で資金化されると想定するのではなく、サブスクリプションと並ぶ収益源の候補としてコマースを論じています。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
何かを選び、購入する支援を行うアシスタントは、買い物に関する質問への回答を超えた価値を生み出す可能性があります。難しいのは、その行動を信頼できるものにすることです。依頼の解釈、トレードオフの処理、望まない購入の回避は、いずれもユーザーにとって重要です。
このインタビューは、普遍的な取引手数料、完全な仕様を備えた公開済みショッピング機能、またはこの将来モデルからの実証済み収益貢献を示していません。Metaのリーダーが有望と考える方向性を説明しているものです。
開発者や企業にとって、この違いは有益です。モデルへの現在のアクセスは今日評価できますが、提案されたコマースのビジネスモデルには、導入、取引行動、経済性について別個の証拠が必要です。
両氏は、スマートフォンを超える展開についても議論しています。スマートグラスは、役立つコンテキストが慎重に書かれたプロンプトとして届かない日常活動の最中に、アシスタントがそばに存在する方法を提供します。
これは、メモリーと判断力に関する議論に物理的な場面を与えます。現実世界の活動中に支援できるアシスタントは、基礎となる情報を理解するだけでなく、いつ応答すべきか、どの程度主体的に行動すべきかを選ばなければなりません。
インタビューはこれを製品ビジョンとして提示しています。議論されたすべての能力が現在のグラスで提供されていることや、関連する信頼性の課題が解決済みであることを示すものではありません。
ザッカーバーグとワンは、AIが必ずしも勝者総取りの市場にはならないと主張しています。その理由は、異なるユーザーニーズ、製品体験、そして複数の成功する提供者が存在する可能性に結び付いています。
これは彼らの予測であり、最終的な市場構造として観測された事実ではありません。強力なモデルリリース、有利なベンチマーク、大規模なインフラ投資だけで、長期的な商業的成果を確立することはできません。
より限定的で有用な要点は次の通りです。Metaは、研究、インフラ、サブスクリプション製品、潜在的なコマース、ハードウェア配信を組み合わせた戦略を構築しています。この戦略を評価するには、1つのモデルスコアを完全な事業成果と見なすのではなく、それぞれの構成要素を検討する必要があります。
このインタビューは、その主張を裏付けていません。ワンはCFOのスーザン・リーによる深刻な財務上の警告を回想していますが、ザッカーバーグとワンは、同社が後退や追加の反復に対応できる能力についても語っています。
これらの数字は、MetaのAI投資コミットメントの規模に関する議論で登場します。インフラ建設、容量、運用コストは異なるカテゴリーであるため、1つのモデルを学習させるための公表済み請求額として説明すべきではありません。
Metaの発表では、WonderはモデルAPIおよびMuse Codeを通じて利用でき、Wonder FullはMuse Codeのサブスクライバーに提供されると説明されています。サブスクリプション提供とAPIモデルは別々のアクセス形態であるため、最新の製品条件を確認してください。
MetaはActiveMemoryを、会話をまたいで関連コンテキストを保持し、有用なときに取り出す機能として説明しています。これは意図された能力の説明であり、記憶されたすべての事実が常に正しく選択・利用されることを保証するものではありません。
いいえ。ベンチマークは、特定の構成で定義されたタスク集合を測定するものです。ワークフローについて結論を出す前に、出力品質、信頼性、レイテンシー、コストを含め、代表的な業務でモデルを比較してください。
このインタビューでは、サブスクリプションと並ぶ潜在的な収益源としてコマースが論じられています。提案されるエージェント主導のショッピングモデルが、すでに特定の財務成果をもたらした証拠は示されていません。
このインタビューは、Metaが構築を見込んだモデルを確認する前に下した、ハイリスクな投資判断を説明しています。また、Muse Wonderを、持続的なアシスタント、サブスクリプション、コマース、スマートグラスに関するより広い計画へ結び付けています。
財務上のプレッシャーは大きなものでした。しかし、このインタビューが裏付けるのは投資リスクと製品戦略に関する議論であり、倒産シナリオが確認されたということではありません。
ひとことから始めて、数分で完全なサイトを手に入れましょう。