For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/minicpm-v-4-7-35b-moe-on-iphone-les-and-l-9db57311.md.
MiniCPM-V 4.7は、スマートフォンを含むローカルデバイスに350億パラメータのMixture-of-Expertsモデルをもたらします。ModelBestとOpenBMBは、最適化されたデプロイメントスタックにより、iPhone 17 Pro Maxで約3 GBのメモリ...

MiniCPM-V 4.7は、スマートフォンを含むローカルデバイスに350億パラメータのMixture-of-Expertsモデルをもたらします。ModelBestとOpenBMBは、最適化されたデプロイメントスタックにより、iPhone 17 Pro Maxで約3 GBのメモリ使用量かつ毎秒13トークン超の生成速度を報告しています。
この数値には文脈が必要です。350億パラメータの完全なモデルが3 GBのダウンロードに収まること、またはRAMが3 GBのスマートフォンでも公表速度で実行できることを意味するものではありません。このモデルはストレージからエキスパートの重みをストリーミングし、スケジューリング、量子化、推論最適化を利用して、アクティブなワーキングセットを小さく維持します。
このリリースには、主に次の2つのバリアントがあります。
| バリアント | 設計 | 想定用途 |
|---|---|---|
| MiniCPM-V 4.7 35B-A3B | 合計350億パラメータ、トークン当たり約30億パラメータがアクティブなMoE | より強力なローカル画像・文書・複数画像・動画理解 |
| MiniCPM-V 4.7 1B | 小規模なDenseモデル。QbitAIは約13億パラメータと説明 | 低リソース環境の視覚タスク、OCR、文書抽出 |
35B-A3Bモデルは、MiniCPM-Vシリーズ初のMoEです。プロジェクトは2026年10月12日に4.7を発表し、その後10月15日に両バリアント向けのDSpark投機的デコーディングヘッドを公開しました。
リポジトリでは、iOS、Android、HarmonyOS向けのデプロイメント対応が記載されています。また、Intel、AMD、Arm、Rockchip、Houmoプラットフォームのサポートも説明されています。実際の性能はデバイス、モデル形式、推論バックエンド、設定に依存するため、プラットフォーム対応をすべてのハードウェアで同一速度が得られることと解釈すべきではありません。
公式の35B-A3B評価表では、Instructモードにおいて以下の結果が報告されています。
| ベンチマーク | 4×視覚圧縮 | 16×視覚圧縮 |
|---|---|---|
| MMBench | 91.72 | 90.87 |
| MMStar | 80.67 | 80.13 |
| MMMU | 80.22 | 80.00 |
| MathVista | 88.00 | 87.30 |
| OCRBench | 91.20 | 90.40 |
| OmniDocBench v1.6 | 94.24 | 93.25 |
| Video-MME、字幕なし | 76.40 | 74.70 |
| LongVideoBench | 68.90 | 67.60 |

出典:OpenBMB、MiniCPM-Vリポジトリ。同リポジトリの表は、公開レポートと、Instructモードの公式チェックポイントを使用したチームのローカル評価を組み合わせています。
この表は、より強い視覚圧縮に移行しても、いくつかのタスクで低下が比較的小さいことを示しています。たとえばMMBenchの低下は0.85ポイント、OCRBenchの低下は0.80ポイントです。一方で、より大きく低下するタスクもあるため、開発者は小さい文字、グラフ、視覚的な細部が自身のワークロードで重要かどうかを確認する必要があります。
これらはモデル評価の結果であり、モバイル構成がすべてのスコアを再現すること、またはあらゆるユーザー画像が正確に解釈されることの証明ではありません。検証対象を選ぶための有用な参照点です。
MoEは、トークンごとに選択されたエキスパートだけをアクティブにすることで計算量を削減します。ただし、後続のトークンやレイヤーでは異なるエキスパートが選ばれる可能性があるため、他のエキスパートを保存する必要までなくなるわけではありません。
メモリに制約のあるスマートフォンでは、これらの重みをフラッシュストレージに格納することでモデルを利用可能にできますが、ストレージ待ちが繰り返されるとデコーディングが遅くなる可能性があります。ルーティングを固定されたエキスパートのサブセットに制限すれば読み込み量は減りますが、モデルが使用できるエキスパートが変わります。MiniCPM-V 4.7はその代わりに、ルーターの実際の決定を維持しながら、読み込みと計算を重ね合わせようとします。
Lookahead Expert Scheduling、すなわちLESは、次のレイヤーで必要になる可能性が高いエキスパートを予測し、その重みを事前に読み込みます。実際のルーターがエキスパートを選択すると、エンジンはまずすでに利用可能な選択済みエキスパートを計算し、残りの必要なエキスパートを読み込みます。
この予測は準備と実行の順序を変えるものです。モデルのルーティング決定を置き換えるものではありません。予測で見逃したエキスパートも、選択された場合は引き続き読み込まれ、評価されます。この違いにより、この手法は恒久的にエキスパートプールを縮小することなく、速度を改善できます。
公式ガイドでは、LESと粒度の細かいレイヤー単位の量子化を組み合わせています。より小さなエキスパート重みにより、ストレージとメモリ間の転送量が減少し、最適化されたレイアウトによって読み込み効率も高まります。チームはオンデバイス最適化によって実機のデコーディングが5倍改善したと報告していますが、これはテスト済み構成での結果であり、普遍的な倍率ではありません。
DSparkは、メインモデルが検証するトークンを提案するドラフトモデルを追加します。このリリースは、両サイズ向けの専用ドラフトヘッドを提供します。これも最適化スタックの一部であるため、汎用バックエンドで標準チェックポイントを実行した場合に同じ速度が出るとは限りません。
視覚処理では、モデルはLLaVA-UHD v4に基づき、Vision Encoder内で早期圧縮を使用します。視覚トークンを早期に統合することで、後段のEncoderレイヤーでの処理量を削減します。選択可能な4×および16×設定は、視覚的な細部と推論コストのトレードオフを示します。
公式モバイルアプリのドキュメントでは、完全なデプロイメントについてさらに明確な情報が示されています。
| モバイルデプロイメント項目 | 文書化された要件またはサイズ |
|---|---|
| 検証済みの35B-A3B用スマートフォン | RAM 12 GBのiPhone 17 Pro Max |
| 35B-A3Bデモで推奨されるデバイスRAM | 最低12 GB |
| 35B-A3Bのモデル合計ダウンロードサイズ | 約16.6 GB |
| 推奨空きストレージ容量 | モデルファイル用に約17 GB |
| エキスパートストレージ | 40個のシャードとマニフェストを含む独立したexperts/ディレクトリ |
| デフォルトのデモ用コンテキストウィンドウ | 4Kトークン |
分割されたモバイルパッケージは、標準的な全モデルGGUFとは異なります。メインの-lesファイルは対応するエキスパートディレクトリに依存し、アプリはファイル間の整合性を確認します。より大きいコンテキストウィンドウではKVキャッシュのメモリが増え、低RAMデバイスでエキスパートキャッシュを小さくすると、生成速度が大幅に遅くなる可能性があります。
小さいワーキングメモリ使用量は、大容量かつ高速なローカルストレージの必要性をなくすものではありません。
QbitAIの記事は、ローカルのスマートフォンおよびタブレットの例を示した後、別途APIテストを紹介しています。この区別は重要です。APIの結果は、同じタスクが端末上でオフライン実行された証拠ではありません。
冒頭のiPhoneデモでは、モデルがナポレオンのロシア遠征を示すミナールのグラフを分析します。最低気温とその日付を尋ねられると、1812年12月6日の−30°レオミュールを特定し、°C = °Ré × 1.25を用いて−37.5°Cに換算します。
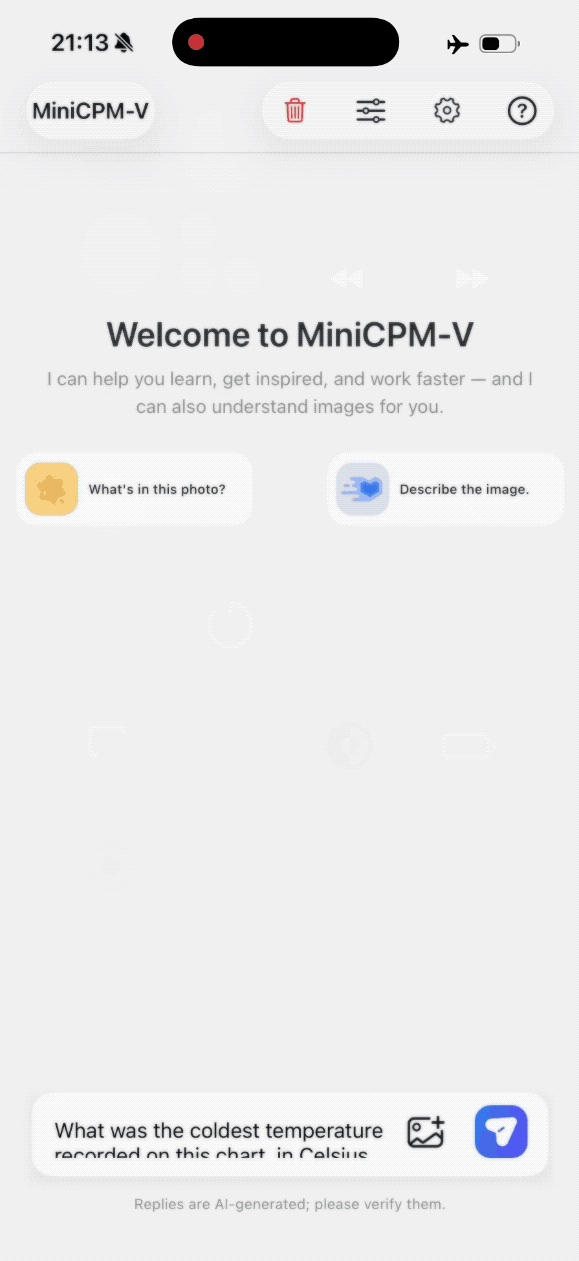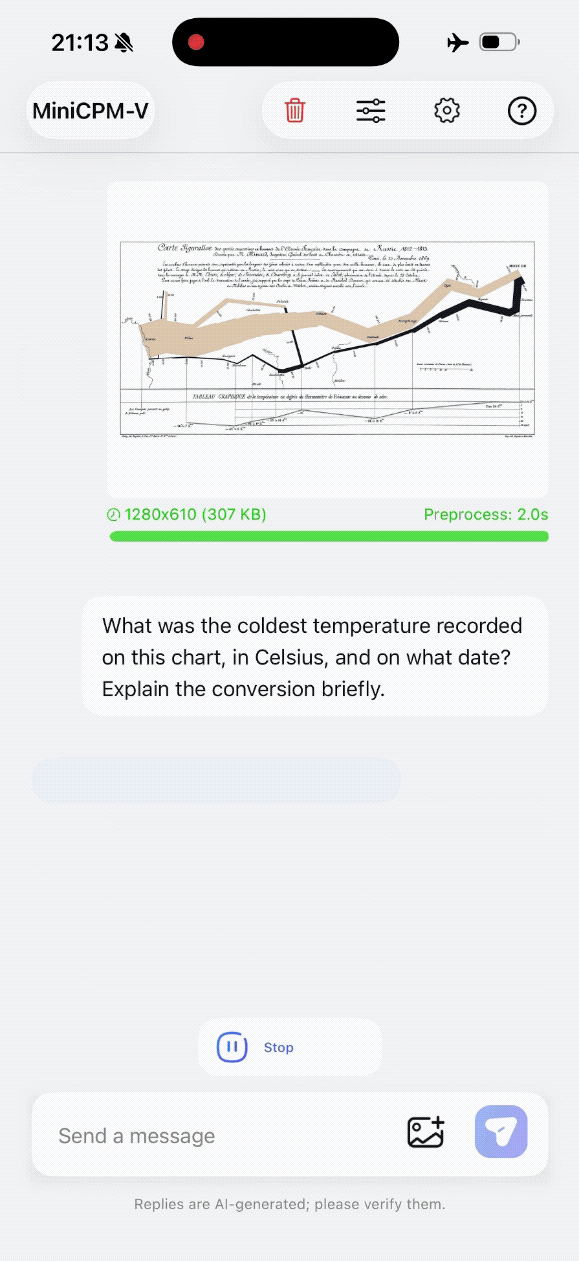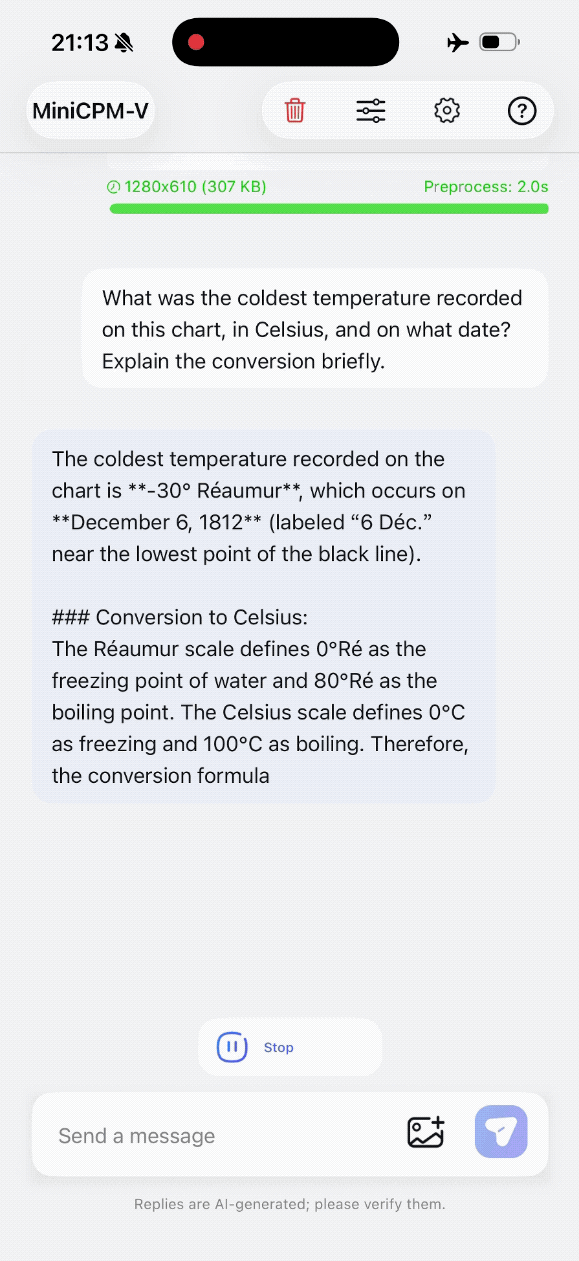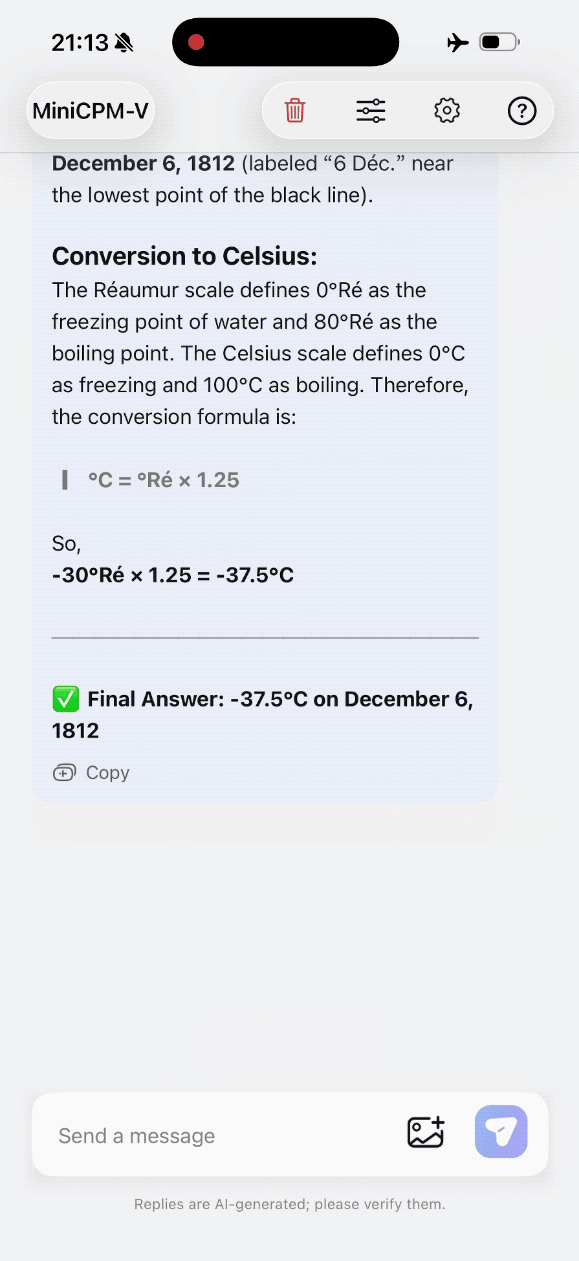
出典:BAAI経由のQbitAI。アニメーション化されたスマートフォン画面録画。出典は、M4 iPadでも同じ回答が得られたと報告しています。
この例は、単なる文字認識以上を検証しています。モデルはグラフを読み、該当点と日付を関連付け、温度スケールを認識し、換算を適用する必要があります。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
別の例では、家電のワット数と使用時間を、420 kWh・料金¥126の月間請求書と組み合わせています。報告された出力では、列挙された家電の消費量を213.63 kWh、すなわち請求量の約50.9%と見積もり、提示された3つの節約プランのうち、エアコンの使用を減らす案が最善であると特定しています。
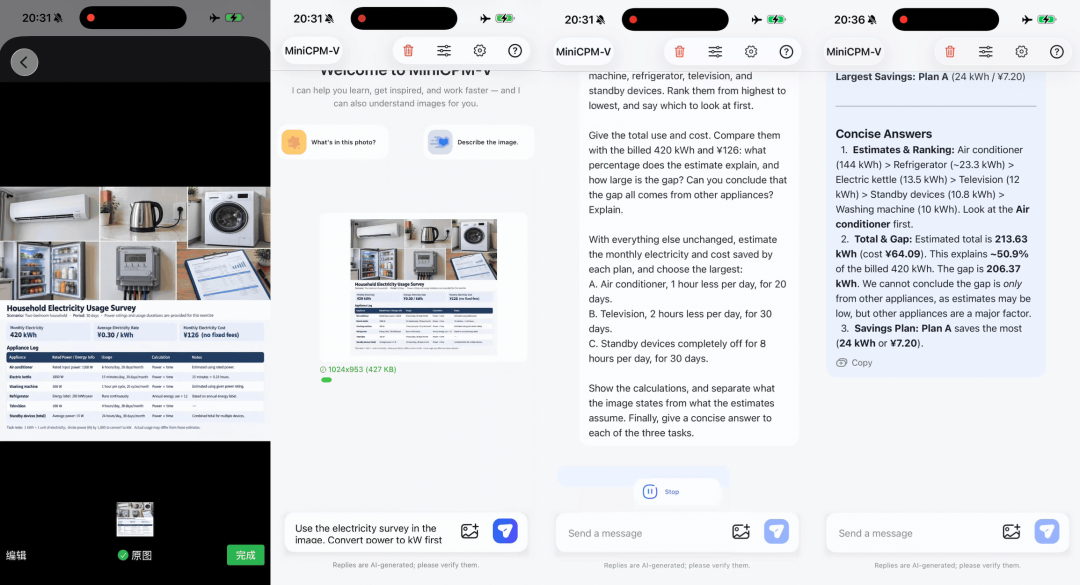
出典:BAAI経由のQbitAI。画面に表示された回答は、説明できない消費電力を他の家電に自動的に割り当てるのではなく、不確実なものとして扱っています。
この留保は有用です。推定使用時間、実際の消費電力、記載されていないデバイスはいずれも請求額比較に影響する可能性があります。算術的な合計が正しいだけでは、残りの消費がなぜ発生したのかを確定できません。
小さいモデルは、論文のページを、見出し、表、数式表記を含むMarkdownへ変換する例で示されています。QbitAIは、このデモに要した時間は30秒未満だったと報告しています。
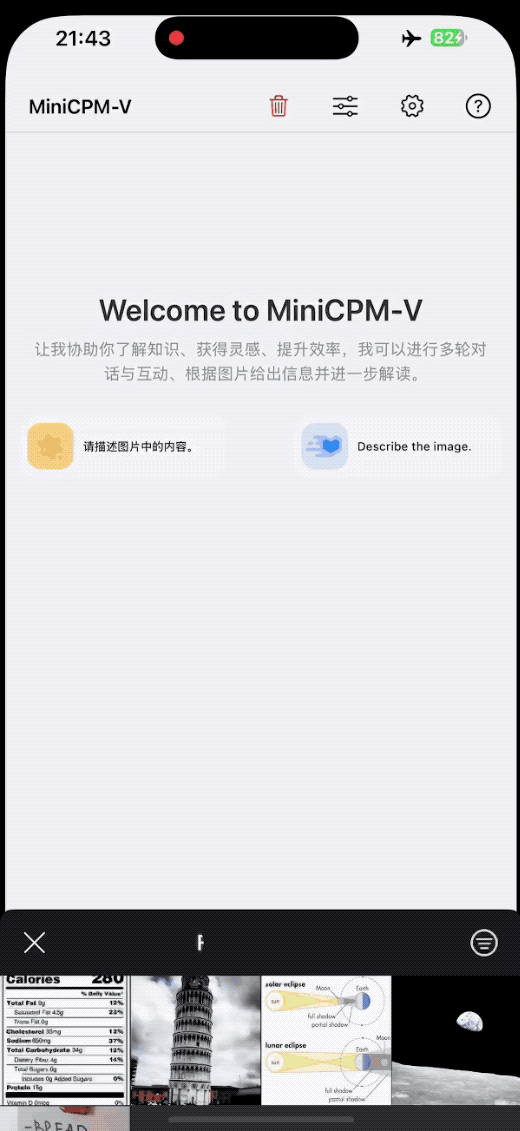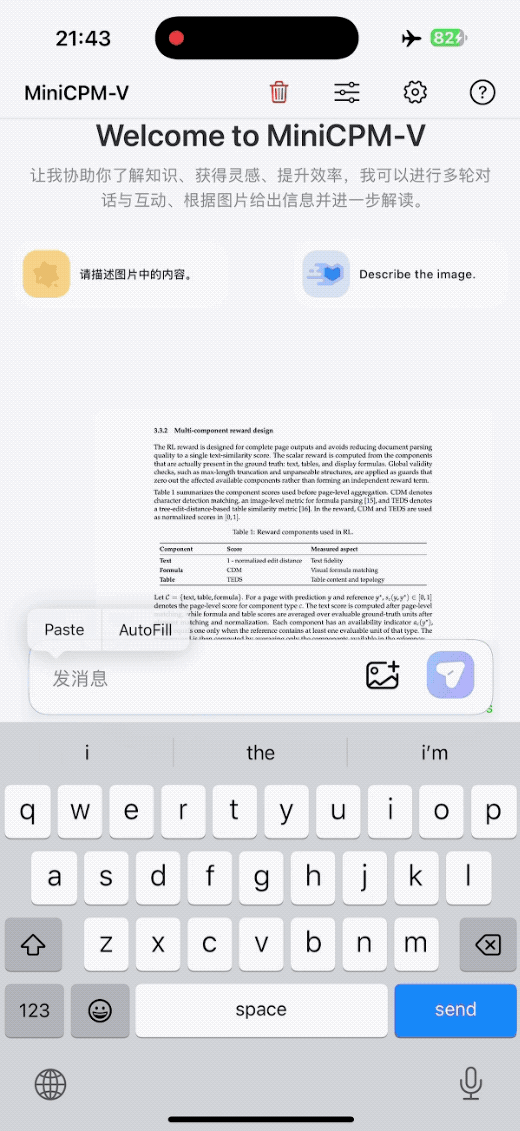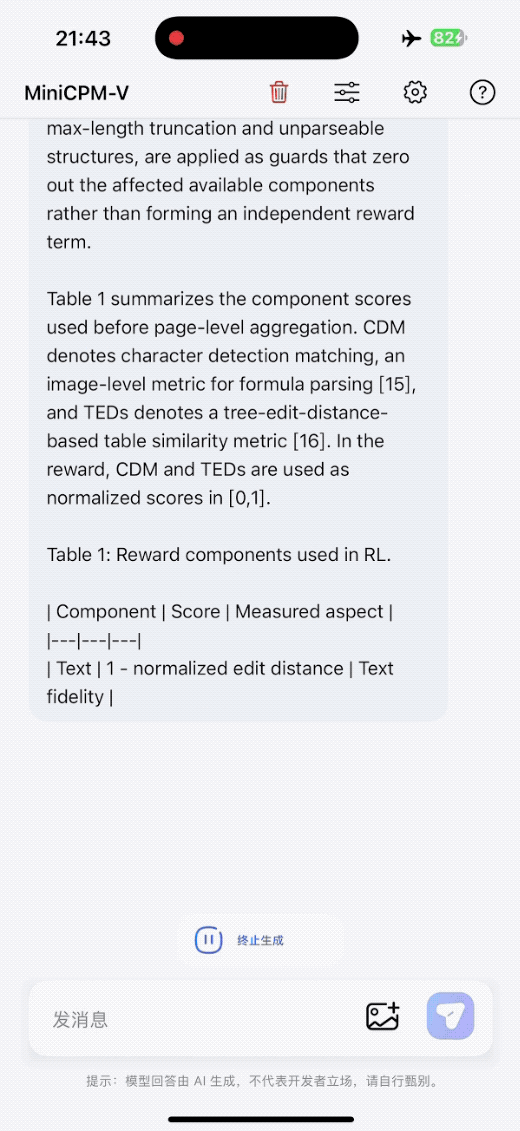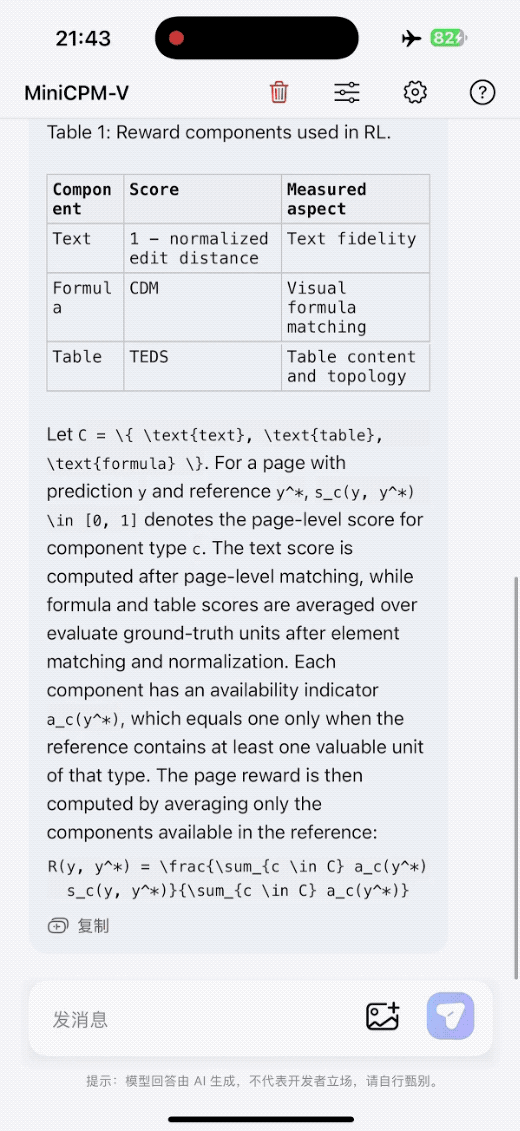
出典:BAAI経由のQbitAI。アニメーション化されたローカル文書デモ。
別途行われたAPIテストでは、記事は¥86.40から¥8の割引を差し引き、¥78.40の支払いと一致するレシート計算を報告しています。また、清掃規制、2時間の時間制限、居住者免除、再入場条件に照らして90分の駐車を確認する駐車規則タスクについても説明しています。これらは例示的なテストであり、体系的な精度研究ではありません。
関連リリースでは、カスタマイズ時の忘却に対処しています。Self-Replay Fine-Tuningは、元のモデルから汎用ドメインの応答を生成し、品質に基づいてフィルタリングし、保持された例を新しいタスクデータと混合して、標準的な教師ありファインチューニング中に使用します。
この手法は、モデルアーキテクチャや損失関数ではなく、学習データを変更します。リプレイ例は学習前に生成して再利用できるため、各実行で新しいオンラインロールアウトを行う必要性を減らせます。
OpenBMBの投稿は、以前のMiniCPMモデルや他のモデルファミリーを対象としたテストを含め、カウントおよび文書OCR実験で有望な保持結果を報告しています。これらの結果を、すべての4.7ファインチューニングに対する包括的な保証として提示すべきではありません。プロンプトのカバレッジ、フィルタリング品質、タスクデータとリプレイデータの比率は、依然として実験的な選択事項です。
モバイルアプリのリポジトリは、iOS、Android、HarmonyOS向けのデモを提供しています。スマートフォン向けMoEパスでは、アプリ内モデルマネージャーが対応するメインファイル、Visual Projector、エキスパートシャードをダウンロードします。リポジトリは、通常の未分割デスクトップGGUFファイルは、このモバイルパッケージと互換的に交換できないと警告しています。
その他のデプロイメントについて、4.7ガイドはSGLang、vLLM、llama.cpp、Ollamaに加え、ファインチューニング用のSWIFTとLLaMA-Factoryを列挙しています。また、GGUF、BNB、AWQ、GPTQ、FP8を含む量子化オプションにもリンクしています。すべてのサポート形式をそのまま使えるモバイルモデルとして扱うのではなく、意図するランタイムに適した成果物を選択してください。
オフライン推論は、必要なアプリとモデルファイルがローカルに存在した後に開始できます。これにより、各推論リクエストをクラウドモデルへ送信する必要がなくなりますが、アプリ権限、ローカルデータの取り扱い、ストレージ、ハードウェア性能は、実務上のデプロイメント課題として残ります。
ModelBestとOpenBMBによるマルチモーダルモデルリリースで、35B-A3B MoEおよび小型の1Bバリアントを含みます。画像、文書、複数画像、動画に関わるタスクをサポートします。
プロジェクトは、iPhone 17 Pro Max上で最適化された35B-A3Bデプロイメントを実演しています。350億の全パラメータを一度にRAMへ読み込むのではなく、ローカルストレージからエキスパートをストリーミングしつつ、より小さなワーキングセットをメモリに保持します。
いいえ。公式モバイルデモでは、35B-A3Bパッケージの合計ダウンロードサイズは約16.6 GBと記載され、約17 GBの空きストレージが推奨されています。検証済みiPhoneには12 GBのデバイスRAMがあります。
いいえ。LESは事前読み込みするエキスパートを予測し、すでに利用可能なものを先にスケジュールします。モデルの実際のルーターは、予測で見逃したものを含め、計算するエキスパートを引き続き選択します。
はい。必要なファイルをダウンロードまたはインストールすれば、ローカルデモはデバイス上で推論を実行します。出典にあるAPI例は別のテストであり、オフライン動作と混同すべきではありません。
いいえ。このデモには、-lesメインファイル、Visual Projector、エキスパートシャードから成る対応した分割パッケージが必要です。アプリのドキュメントは、標準的な全モデルGGUFファイルが同じスマートフォン向けデプロイメント動作を提供できない理由を説明しています。
MiniCPM-V 4.7は、スパース計算、エキスパートストリーミング、先読みスケジューリング、量子化、視覚圧縮を組み合わせ、より大きなマルチモーダルモデルを特定のローカルデバイスで実用的にします。デモはグラフ解釈、文書変換、日常的な計算を扱い、公開ベンチマークは評価を始めるための基準点を提供します。
主要なデプロイメント上の制約は、ワーキングメモリ、デバイス総RAM、保存される重みの違いです。このスマートフォンでの結果は、350億パラメータの完全なモデルが3 GBに収まることや、すべてのデバイスで同程度に動作することを約束するものではなく、特定の最適化済み構成として妥当な結果です。
ひとことから始めて、数分で完全なサイトを手に入れましょう。