For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/muse-wonder-benchmarks-coding-results-lim-2cf7d1eb.md.
MetaによるMuse Wonderの発表では、強力なベンチマーク結果と、開発者による実演で時にそれほど説得力を持たなかった出力という、2種類の大きく異なる証拠が示されました。BAAI Hubに転載された新智元のレポートは、この隔たりをベンチマーク重視の最適化に対する強い批判へと...
MetaによるMuse Wonderの発表では、強力なベンチマーク結果と、開発者による実演で時にそれほど説得力を持たなかった出力という、2種類の大きく異なる証拠が示されました。BAAI Hubに転載された新智元のレポートは、この隔たりをベンチマーク重視の最適化に対する強い批判へと結び付けています。
この見解の相違は精査に値しますが、実演の出来が悪いことだけで不正を立証することはできません。公正に判断するには、正確なモデルバリアント、テスト対象タスク、モデルを取り巻くエージェントソフトウェア、そして各結果の出所を確認する必要があります。
情報源は、開発者がブラウザゲームまたは3Dゲームの出力を比較し、競合モデルと比べてWonderに失望した事例を説明しています。こうした実演は確認しやすいものです。閲覧者は、移動が機能するか、カメラが適切に動作するか、シーンが要求された結果に似ているかを直接確認できます。
情報源はまた、MetaのAlexandr Wangが、チームは3Dデモゲーム向けに明示的な訓練をしていなかったと述べ、開発者に実際のコーディング作業を試すよう促したと引用しています。この回答は新智元による報道であり、すべての失敗したコーディングタスクを包括的に説明するものとして扱うべきではありません。
ゲームの実演は、依然として重要な証拠です。コード生成、視覚的判断、インタラクション、デバッグという現実的な組み合わせを検証するためです。その一方で、適用範囲には限界があります。1つのプロンプトと1回の実行だけで、リポジトリ保守、ターミナル作業、あるいは長期にわたるソフトウェアプロジェクト全体での性能を確立することはできません。
Metaの一次発表では、個人向けおよびプロフェッショナル向けエージェントのためのモデルとしてMuse WonderとMuse Wonder Fullが紹介されています。WonderはMeta Model APIおよびMuse Codeを通じて提供され、FullはMuse Codeのサブスクライバーに提供されます。
発表では、Active Memoryを、会話をまたいで重要な文脈を保持し、関連する場面でそれを取得する機能として定義しています。Active Focusは、代替案の試行、新情報への適応、確認の質問、重要なアクション前のチェックを含め、目標に向けて持続的に進捗することを説明しています。
これらの説明は、Metaが何を改善しようとしているかを理解する助けになります。ただし、これは製品および評価に関する主張であり、エージェントが割り当てられたすべてのタスクを完了するという保証ではありません。
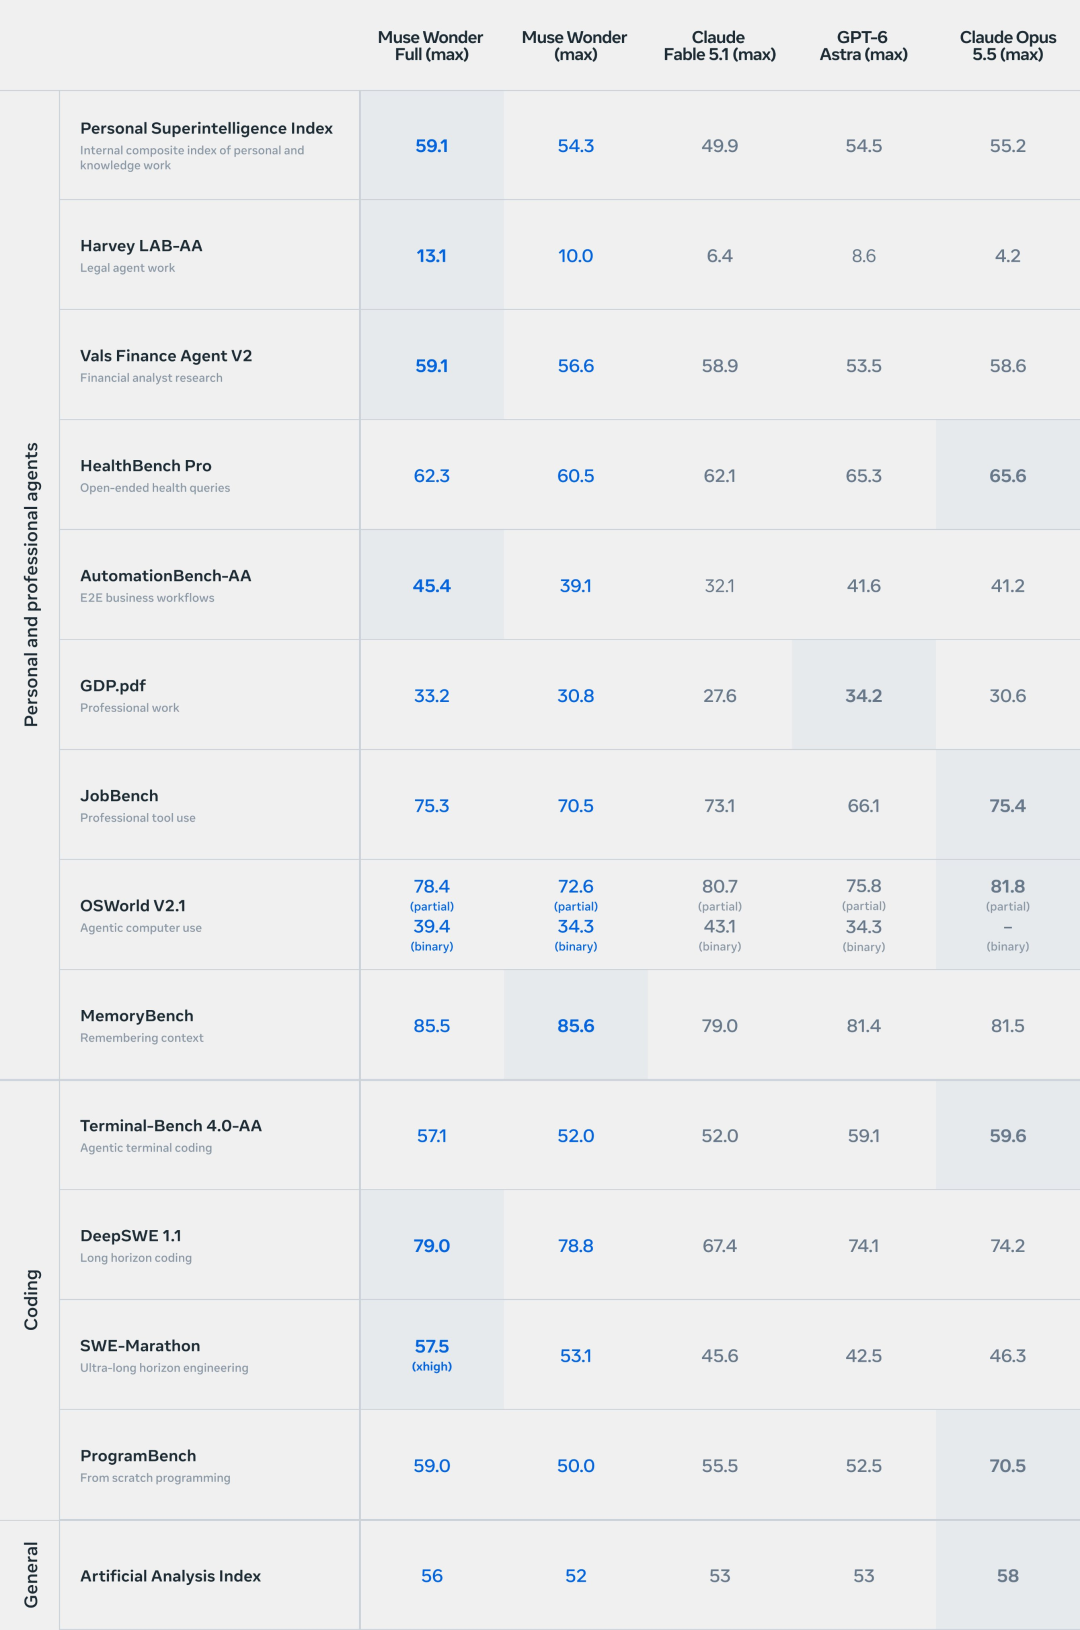
Metaが公開し、新智元がBAAI Hub上で再掲した比較表。数値は発表資料に示された構成および評価条件に対応するものです。
この表は、万能の勝者を示しているわけではありません。コーディング結果は、タスクによって大きく異なります。
| 評価 | Muse Wonder Full | Claude Opus 5.5 | 比較の方向性 |
|---|---|---|---|
| DeepSWE 1.1 | 79.0 | 74.2 | Fullのスコアが高い |
| SWE-Marathon | 57.5 | 46.3 | 報告された設定ではFullのスコアが高い |
| Terminal-Bench 4.0-AA | 57.1 | 59.6 | Opusのスコアが高い |
| ProgramBench | 59.0 | 70.5 | Opusのスコアが高い |
Metaの付随資料では、メモリおよびエージェントワークフローにおける強みと、他のモデルが優位な領域の両方も報告されています。長時間に及ぶソフトウェア作業で強い結果が得られたとしても、ゼロからアプリケーションを生成する能力が最も高いことを意味するわけではありません。
SWE-Marathonでは、評価条件が特に重要です。Metaのモデルカードによれば、競合モデルはCodexおよびClaude Codeを通じて実行される一方、Wonder Fullで強調された結果にはxhigh構成が使用されています。これらは意味のある製品レベルの結果ですが、すべてのモデルに同一のエージェントハーネスを用いた単一の統制実験ではありません。
Metaの発表ブログは、既知のベンチマークと未知のタスクの間にあるギャップを明示的に取り上げています。その分析では、テスト時コンピュートの増加に伴う分布内および分布外の性能を比較し、Wonder Fullのより強力なベースモデルが、ポストトレーニングによる改善を他のタスクへ移転する能力を高めると主張しています。
これはMetaの立場を支える関連性の高い技術的証拠です。しかし、モデル開発者自身が選定・提示した評価であり、開発者の出力に対するすべての不満を解決するものではありません。
同様に、期待外れのゲームデモに関する報告は、ベンチマーク汚染や結果の捏造を立証するものではありません。そのような主張を確立するには、情報源の記事が提供している以上に、データ、手法、または操作された結果についての直接的な証拠が必要です。
Artificial Analysisによる独立した報道では、最大推論強度におけるIntelligence Index v4.3のスコアは、Wonder Fullが56、Wonderが52とされています。したがって、通常のWonderをAPIでテストするユーザーは、複数のチャートで注目されているFullモデルとは異なる発表時の提供形態を評価していることになります。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
Artificial Analysisは、両バリアントに100万トークンのコンテキストウィンドウがあると記載しています。Wonderについては、入力100万トークン当たり4ドル、キャッシュ済み入力100万トークン当たり0.20ドル、出力100万トークン当たり20ドルと報告しています。同サイトによるIntelligence Indexタスク当たり4.52ドルという推定値は、評価に固有のコストであり、あらゆるユーザーリクエストに適用される固定価格ではありません。
情報源は、公開されたオープンウェイト版がないことも批判しています。確認した発表内容およびアクセス説明のいずれにも、ダウンロード可能なWonderの重みの公開は記載されていないため、開発者はローカルでのセルフホスティングが可能だと想定すべきではありません。
Metaによれば、Wonderはギガワット規模のPrometheusデータセンターでトレーニングされました。BAAIの記事は、この発表を、AIインフラ投資の規模や、商取引におけるパーソナルエージェントの役割に関するMark Zuckerberg氏とWang氏の発言と結び付けています。
これらの発言は、より広範な戦略を説明するものです。特定のこのモデルについて検証済みのトレーニングコストの数値に置き換えるべきではありません。同様に、エージェントがサービスを交渉または購入する例は、製品の振る舞いに関するビジョンであり、そうしたすべてのワークフローが導入済みである証拠ではありません。
次に有用なのは、再現可能なテストです。要件を固定し、バリアントと推論設定を特定し、環境を記録し、完了した作業を測定します。これにより、単一の見出しスコアや印象的な1件の失敗よりも、強みと弱みの両方を信頼性高く明らかにできます。
いいえ。実演されたタスクでの性能が低かったことは示せますが、ベンチマーク不正を証明するには、評価手法、データ、または操作された結果に関する別個の証拠が必要です。
両者はモデルファミリー内の別個の提供形態であり、発表時のアクセス経路も異なります。Artificial Analysisは、Intelligence Index v4.3における最大推論強度で、Wonderを52、Fullを56と報告しています。
引用した表は、コーディング評価ごとに異なる答えを示しています。FullはDeepSWE 1.1および報告されたSWE-Marathon設定で優位である一方、OpusはTerminal-Bench 4.0-AAおよびProgramBenchで優位です。
設定に関する留保を付ける場合に限られます。Metaのモデルカードでは、競合モデルがそれぞれのコーディング製品を使用していると説明されているため、基礎モデルに加えて、エージェントの振る舞いやツールの違いも結果に影響する可能性があります。
Artificial Analysisの発表時レポートでは、入力100万トークン当たり4ドル、キャッシュ済み入力100万トークン当たり0.20ドル、出力100万トークン当たり20ドルとされています。本番利用を決定する前に、最新のプロバイダー課金条件を確認してください。
確認した発表資料からは、公開された重みのダウンロードは確認できませんでした。文書化されたアクセス経路は、WonderについてはAPIおよびMuse Code、FullについてはMuse Codeのサブスクリプションアクセスです。
Muse Wonderの発表結果は、強力なエージェントおよびソフトウェアエンジニアリングのスコア、コーディングカテゴリごとのばらつき、そして通常版とFull版で異なるアクセス経路を持つモデルファミリーを示しています。
有用な結論はタスクごとに異なります。万能の勝利という主張も不正という非難も受け入れる前に、正確なモデルを確認し、完了した作業をテストしてください。
ひとことから始めて、数分で完全なサイトを手に入れましょう。