For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/nvidia-aspire-v1-0-robot-debugging-skills-a8a0a489.md.
NVIDIAは、実行時の失敗を次の試行に活用するロボティクスフレームワーク、ASPIRE V1.0を公開しました。コーディングエージェントがロボット制御プログラムを作成・実行し、実行結果を調べてコードを修正します。修正が成功すれば、スキルライブラリに再利用可能な項目として保存でき...
NVIDIAは、実行時の失敗を次の試行に活用するロボティクスフレームワーク、ASPIRE V1.0を公開しました。コーディングエージェントがロボット制御プログラムを作成・実行し、何が起きたかを調べてコードを修正します。修正が成功すれば、スキルライブラリに再利用可能な項目として保存できます。
ASPIREは Agentic Skill Programming through Iterative Robot Exploration(反復的なロボット探索によるエージェント型スキルプログラミング) の略です。中心となる考え方は、改善のたびに新たに訓練したモデルの重みに知識を埋め込むのではなく、経験を検索可能な運用知識として蓄積できるというものです。
このリリースでは、基盤となる推論モデルがどれほど重要かも取り上げています。QbitAIによると、チームがGPT-6 Astraを接続した後、大幅な改善が見られました。NVIDIAの最新資料では、複数の最先端モデルで優れた結果が示されています。一方、実行エンジンとスキルの仕組みは維持されています。
把持に失敗しただけでは、原因は分かりません。物体の位置を誤って特定したのかもしれません。把持候補が適切でなかった可能性もあれば、アームが目標に届かなかった、あるいは計画した動作が周囲の環境に衝突した可能性もあります。
ASPIREの実行エンジンは、認識、計画、把持、制御の呼び出しに関する証拠を記録します。記録には観測、入力、出力のほか、利用可能な場合は視覚的な証拠も含まれます。エージェントは、最終的な失敗だけをフィードバックとして扱うのではなく、このマルチモーダルな実行トレースの該当部分を調べられます。
基本的なループは次のとおりです。
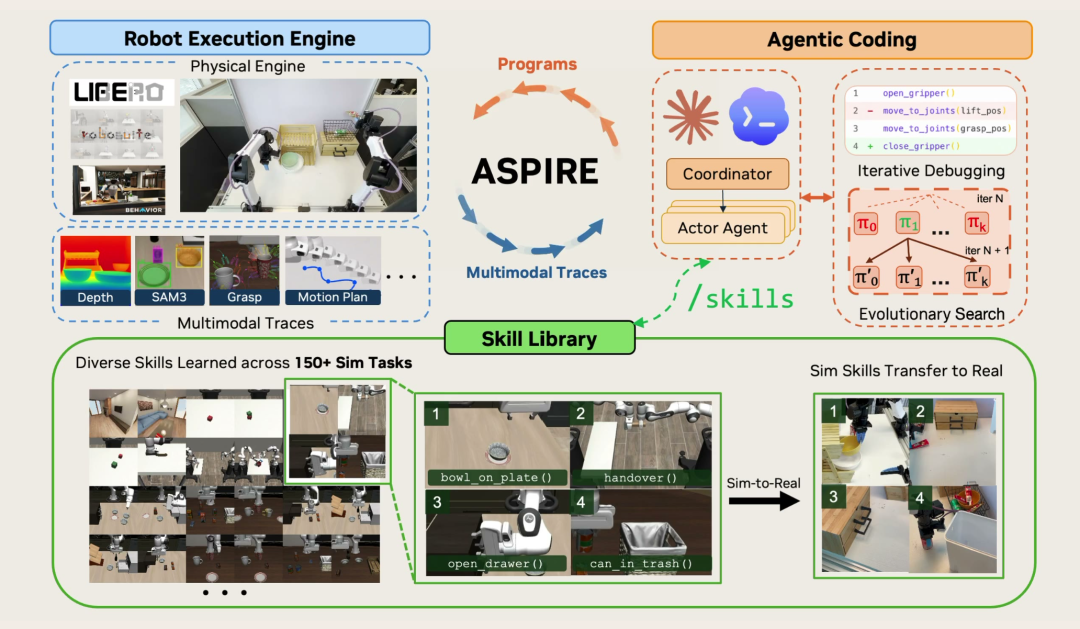
ASPIREの手法を示す図。研究チーム提供。出典記事から再掲載。
このフレームワークでは、進化的探索による代替プログラムの検討も行います。失敗するアプローチを何度も少しずつ調整するのではなく、エージェントが異なる手順、プランナー、把持戦略を調べ、実行チェックを通過したアプローチを保持できます。
たとえば、低い位置にある物体を扱うには、ロボットの位置を変えたり、別のアームに切り替えたり、異なるモーションプランナーを試したりする必要があるかもしれません。有用な成果は、修正済みのプログラムだけではありません。その修正がどのような場合に適用できるかという説明も含まれます。
一度限りの修正は一つのタスクに役立ちます。検索可能なスキルなら、同じ根本的な難しさを持つ後続のタスクにも役立つ可能性があります。
ASPIREは、検証済みの修正をテキストベースのロボット知識にまとめます。新しいタスクでは、エージェントが関連する項目を検索し、新たなプログラムを作成する際のコンテキスト内ガイダンスとして利用します。これは、固定された座標で古い軌道をそのまま再生することとは異なります。
出典では、18カテゴリーにわたり150以上のタスクを扱う、90件超のスキルを掲載したライブラリが紹介されています。カテゴリーには、認識、把持、ナビゲーション、物体探索、両腕操作、リカバリーが含まれます。NVIDIAは、公開されているエクスプローラーの内容を代表的なサンプルであり、網羅的な一覧ではないと説明しています。
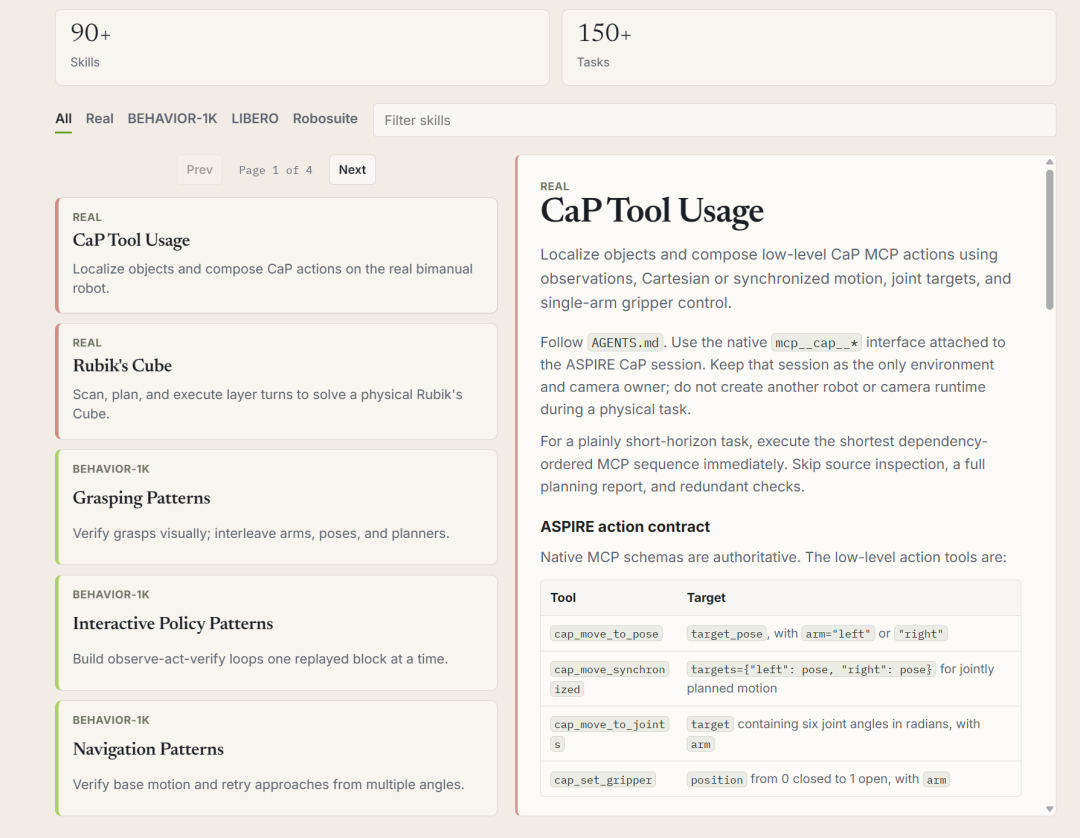
出典記事に掲載されたスキルライブラリのインターフェース。
プロジェクトは、**代表的な未見の長期タスクでゼロショット成功率31%**を報告しています。これは、テスト時に相当量の推論と再試行を用いた従来手法の4%と比べた結果です。この数値は特定の評価設定における結果であり、新しい家庭内タスク全般に適用できる成功率ではありません。
研究者らは、シミュレーションから実ロボットへの初期的な異なる身体構造間の転移についても報告しています。シミュレーションで発見された適用可能なスキルを検索すると、実ロボットで最初に成功するプログラムに到達するまでに必要なトークン数が減り、そのプログラムのホールドアウト成功率も向上しました。ただし、すべてのシミュレーション上のスキルが、あらゆるロボットやAPIにそのまま転移することを示すものではありません。
初期の報告では、チームが従来のClaude Opus 4.6バックエンドをGPT-6 Astraに置き換えたところ、シミュレーション結果が大幅に向上したと説明されています。Jim Fanの発表では、Claude Opus 5.5がAstraをわずかに上回り、Sonnet 5.5はコストと性能のバランスが良好だったとも述べられています。この比較では、1タスクあたり約12ドルでした。
現在の公式プロジェクトページでは、Claude Opus 5.5を用いた次の主要な結果が報告されています。
| 評価 | プロジェクトが報告した結果 | 対象範囲 |
|---|---|---|
| LIBERO-Pro | 平均成功率99% | テストした全80タスク |
| Robosuite | 代表的なタスクで成功率100% | 一部のタスク。スイート全体ではない |
| BEHAVIOR-1K | 代表的なタスクで成功率100% | 一部のタスク。1,000件すべてのアクティビティではない |
出典では、代表的なRobosuiteタスクを7件、代表的なBEHAVIOR-1Kタスクを2件特定しています。これらの分母は重要です。この結果を、BEHAVIOR-1K全体を解決したものとして説明すべきではありません。
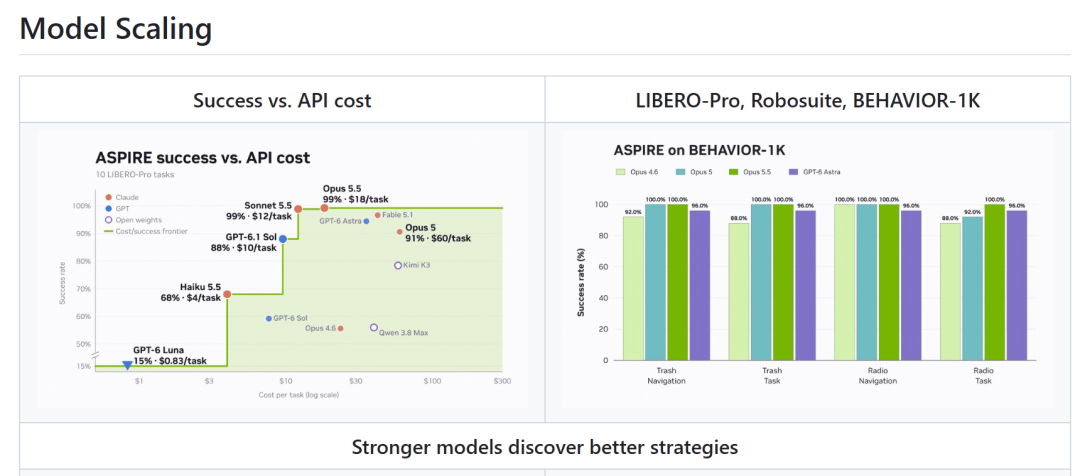
報告書に掲載されたASPIREプロジェクトのモデルスケーリング比較。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
リポジトリ内の別のモデルスケーリング実験では、LIBERO-Proの10タスクを評価し、モデル間で成功率が15%から99%に及ぶと報告しています。この実験を、80タスク全体での結果と混同してはいけません。
実務上の要点は、モデルが変わっても、認識ツール、制御インターフェース、蓄積されたスキルを引き続き活用できることです。プロジェクトはこれを、より強力な汎用推論によって既存のエージェントシステムの性能が高まるという、より広い傾向のロボティクス版として説明しています。
公開リポジトリには、コード、設定、エージェントスキル、再現手順書が含まれています。NVIDIAが所有するプロジェクト資料および提供された資料はApache 2.0ライセンスで利用でき、サードパーティーのコンポーネントにはそれぞれの利用条件が適用されます。
リポジトリでは、シミュレーション実験と実ロボットの運用を区別しています。シミュレーション環境のセットアップには、CUDA、uv、アクセス制限のあるSAM3の重みへのアクセスなど、ホスト環境の準備が必要です。実験を再現するには、汎用コマンド一つで公開済みの結果すべてを再現できると考えるのではなく、評価スイート、タスクセット、シードのスケジュール、出力先も選ぶ必要があります。
重要: READMEによると、生成されたPythonコードはすべてのインポートへのアクセスを持ち、試行プロセスやウォッチドッグはセキュリティサンドボックスではありません。公式ガイダンスでは、隔離されたホストを使用し、物理ハードウェアには別途、認可と制御を設けるよう求めています。シミュレーターで実行に成功したからといって、監督者なしで実環境を運用する準備が整ったことにはなりません。
プロジェクトは、解決されていない制約も列挙しています。安定した成功判定、安全なリセット、安全監視、キャリブレーション、固定されたプリミティブAPI、コストの高い探索、長期的なスキル記憶管理の未完成などです。ライブラリが拡大すると、項目が古くなったり、特定の状況に過度に特化したりする可能性もあります。
報告書の最後では、World Labsによる別の動向が取り上げられています。同社の公式投稿では、Atlasベータ版へのアクセス提供が順次始まっていることが確認されており、デモではカメラ経路を精密に制御する機能に焦点が当てられています。
QbitAIはさらに、1分間の1440p出力、画像やスマートフォン動画からの再構成、点群およびガウシアンスプラット出力、ロボティクス向けのRGB/深度シミュレーションを報告しています。これらの詳細な仕様は、この記事で参照できた短い公式投稿では独立して確認できませんでした。
環境の生成とロボットスキルの学習は、互いに補完し合う研究の方向性になり得ます。ここで確認した情報源はASPIREとAtlasの統合を発表していません。そのため、この組み合わせは公開済みのワークフローではなく、報告書が示唆する可能性にとどまります。
ASPIREは、コーディングエージェントを使ってロボット制御プログラムを作成、実行、デバッグするロボティクスフレームワークです。検証済みの知見を、後続タスクで再利用できるスキルとして保存します。
このプロジェクトでは、基盤モデルの重みに勾配更新を行うのではなく、スキルの改善と運用知識の蓄積を重視しています。固定された最先端モデルでも、スキルを検索し、新しいプログラムの作成時に利用できます。
いいえ。報告された成功率100%は、代表的なBEHAVIOR-1Kタスクの一部を対象としており、全アクティビティを対象にしたものではありません。LIBERO-Proの99%という数値は対象範囲が異なり、テストした80タスクに関するものです。
このプロジェクトでは複数の最先端モデルを評価し、フレームワークは特定のコーディングエージェントに依存しないと説明しています。それでも、成功率とコストはモデル、タスク、実験設定によって異なります。互換性があるからといって、結果が同等になるとは限りません。
研究者らは、シミュレーションで発見された一部のスキルが、異なる身体構造やAPIを用いる実ロボットのデバッグ作業を軽減するという初期的な証拠を報告しています。物理環境での運用には、引き続きキャリブレーション、監視、安全なリセット、結果の検証が必要です。
公式プロジェクトは、現時点では完全自律型の実環境学習システムではないと明言しています。READMEでも、シミュレーションの利用と実機に必要なオペレーター制御を区別しています。
ASPIREは、ロボットの実行トレースをコーディングとデバッグのループにつなぎ、検証済みの修正を再利用可能な知識として保存します。このリリースでは、コード、手順書、スキルエクスプローラーを通じて、そのワークフローを確認できます。
結果からは、モデルのスケーリングと初期のスキル転移に有望な可能性が示されていますが、ベンチマークの対象範囲と物理環境での運用には重要な制約があります。中心的な貢献は、スキルを再利用するループです。一部のベンチマークでほぼ完全な結果が得られても、実環境での管理された評価が不要になるわけではありません。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



