For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/nvidia-vera-rubin-at-ocp-2026-mgx-1-2-dsx-6b3d7f12.md.
AIファクトリーがメガワット規模からギガワット規模のインフラへ拡大するにつれ、課題はより高速なアクセラレータをデータセンターに導入することだけではなくなっています。電力供給、液冷、ネットワーキング、保守性、電力系統での挙動、相互運用可能なラック設計のすべてを同時にスケールさせる必...
AIファクトリーがメガワット規模からギガワット規模のインフラへ拡大するにつれ、課題はより高速なアクセラレータをデータセンターに導入することだけではなくなっています。電力供給、液冷、ネットワーキング、保守性、電力系統での挙動、相互運用可能なラック設計のすべてを同時にスケールさせる必要があります。
サンノゼで開催された2026 Open Compute Project Global Summitにおいて、NVIDIAは、次世代AIインフラのより共通的な基盤を構築するために設計された、パートナーシップ、オープン仕様、ソフトウェア提供の一連の取り組みを発表しました。
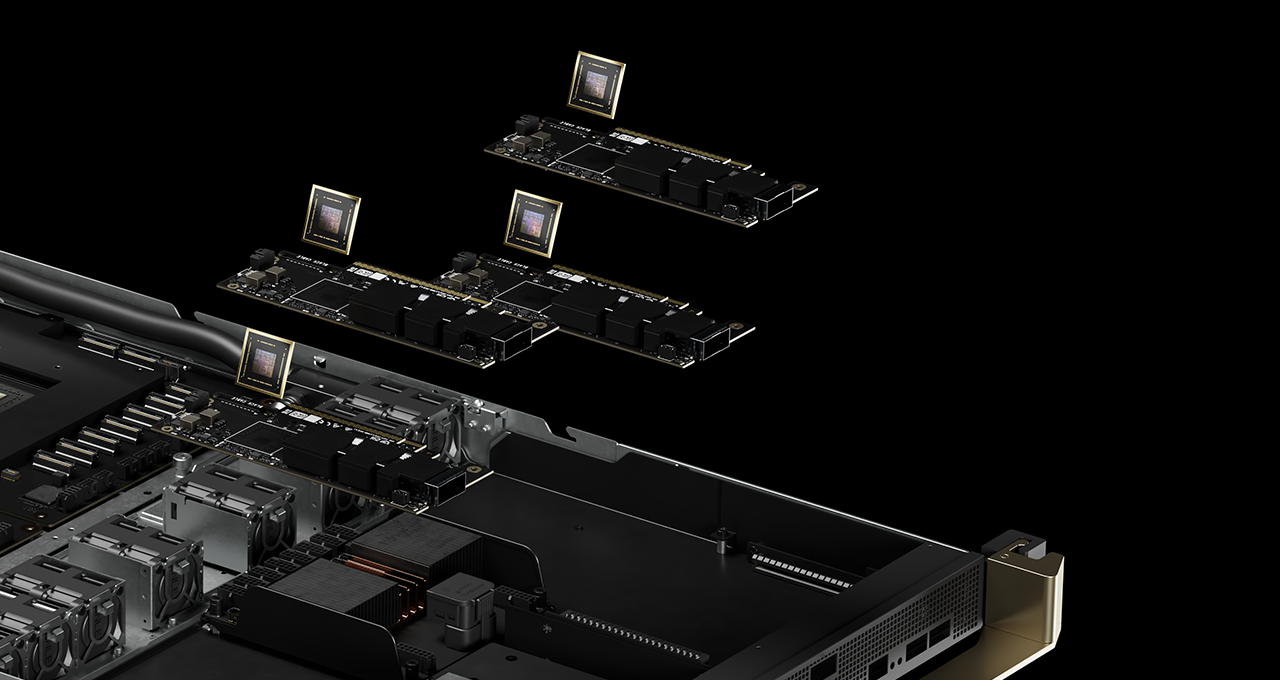
中核となるのはNVIDIA Vera Rubinです。NVIDIAは、オープンなNVIDIA MGXアーキテクチャを通じ、Vera Rubinの主要なラックおよびコンピュートトレイ設計をOCPに提供しました。これにより、システムビルダーとインフラパートナーは、各レイヤーを個別に構築するのではなく、共通のリファレンス設計を基に取り組めます。
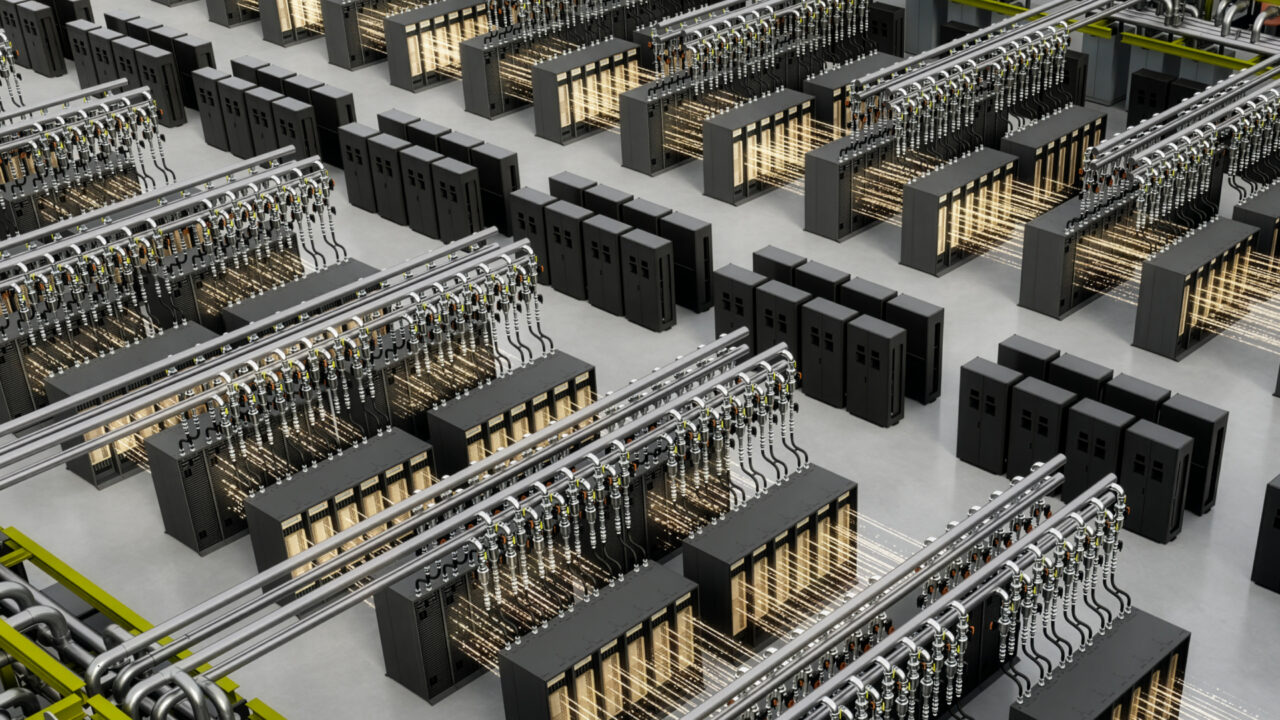
この発表は、AIファクトリーの相互に接続された3つのレイヤーを対象としています。
その結果、パートナーが世界規模で製造、導入、保守できる、よりオープンで再現可能なインフラに向けた取り組みが広がっています。
OCP Global Summit 2026において、NVIDIAとそのエコシステムパートナーは、Vera Rubinを軸に複数のインフラ施策を発表しました。
主な発表内容は次のとおりです。
イベントでNVIDIAのハイパースケールおよびハイパフォーマンスコンピューティング担当バイスプレジデントであるIan Buckは、オープンインフラが世界中のAIファクトリーをスケールさせるうえで、ますます重要な要素になっていると説明しました。
これらの発表を貫く共通テーマは協調設計です。コンピュート、ネットワーキング、電力、冷却、ソフトウェアは、孤立したレイヤーではなく、単一のシステムを構成する要素として扱われています。
NVIDIAは他の業界参加者とともに、OCPのOpen DC Initiativeを通じて、第3世代のMGX AIデータセンターリファレンス設計に貢献しました。
更新されたMGX 1.2仕様は、より高電力で液冷対応のAIファクトリーへとアーキテクチャを拡張します。
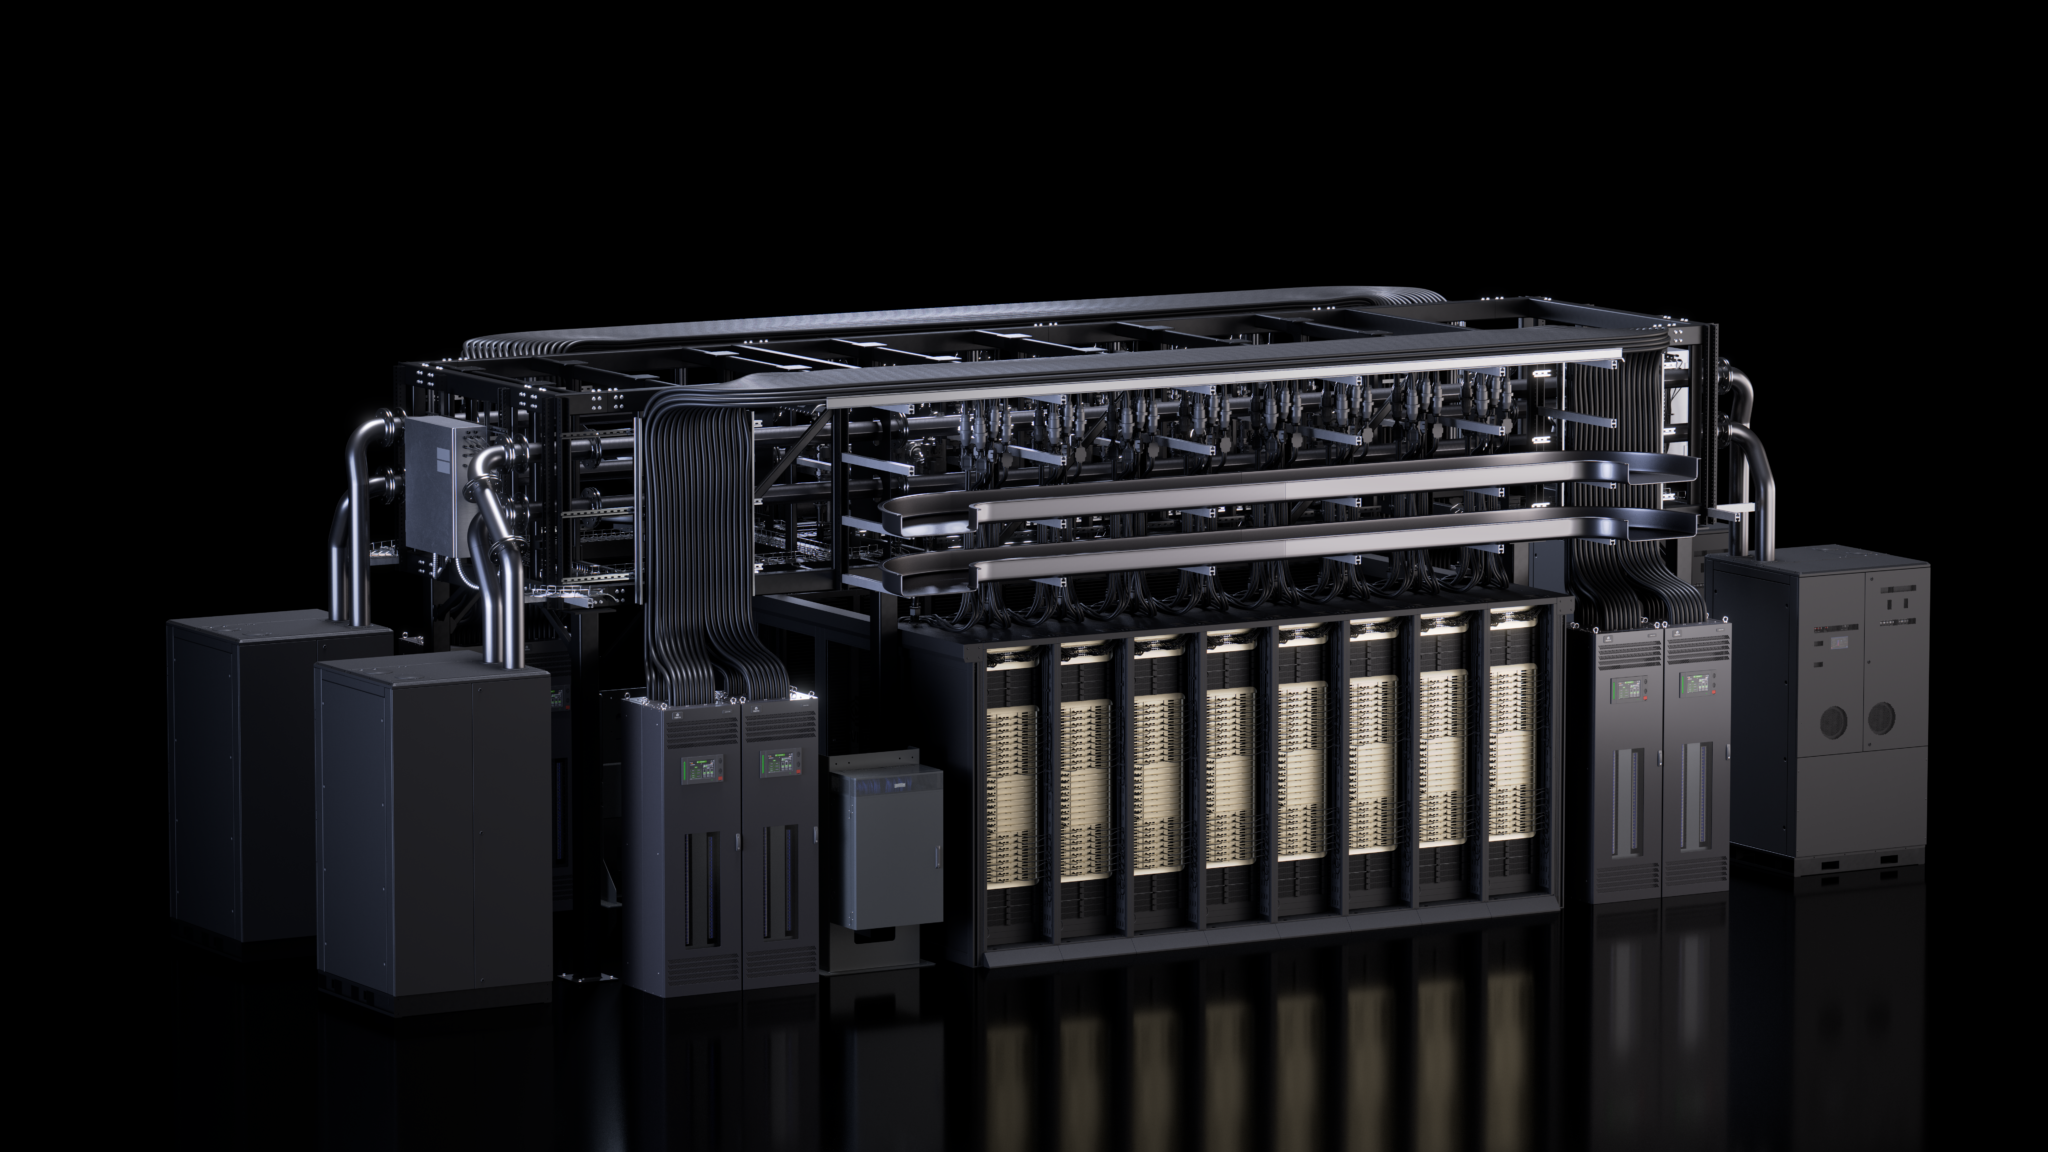
主な追加機能には、以下が含まれます。
NVIDIAによれば、このアーキテクチャは最大250kWのラック導入をサポートし、保守性とインフラの再利用性を向上させます。
MGXは、単一の固定サーバー設計ではなく、モジュール型のリファレンスアーキテクチャです。
これにより、OEM、ODM、インフラパートナーは、CPU、GPU、ネットワーキング、ストレージの組み合わせを柔軟に選択しながらも、共通の機械、電気、冷却の基盤を利用できます。
Vera Rubinにとっては、パートナーがその都度独自プラットフォームから始めるのではなく、既知のラック規模設計を基盤にシステムを構築できることを意味します。
Vera Rubin NVL72プラットフォームは、以下を組み合わせています。
さらに、NVIDIA Quantum-X800 InfiniBandまたはSpectrum-X Ethernetを通じてスケールアウトできます。
NVIDIAは、同じMGX設計原則を専用のVera CPUラックにも拡張しています。
Vera Rubin NVL72が大規模なトレーニングおよび推論向けに設計されている一方、Vera CPUラックは、以下のようなCPU負荷の高いエージェントワークロードを対象としています。
より広い考え方としては、AIワークロードの各部分で異なるコンピューティングリソースが必要であっても、物理インフラの一貫性を維持することにあります。
NVIDIAのDSX AI Factoryプラットフォームは、コンピュート、ネットワーキング、電力、冷却、設備、ソフトウェアを、一つの最適化されたシステムとして連携させるために設計されています。
このソフトウェアレイヤーの中心にあるのがDSX OSであり、NVIDIAはこれを、再現可能なAIファクトリー運用のためのオープンなオペレーティングレイヤーと説明しています。
OCPにおいて、NVIDIAはDSX OSを4つのオープンソースコンポーネントで拡張しました。
NVIDIA Config Managerは、スイッチ設定を大規模に自動化します。
その目的は、オペレーターが最小限の手動設定で、一貫性のあるネットワークファブリックを導入、検証、維持できるようにすることです。
NVIDIA Cluster Readiness Engineは、本番トレーニング開始前に、ワークロードシミュレーションを用いてGPUクラスターへストレステストを実施します。
目的は、高額なトレーニングジョブの失敗を招きうるハードウェアまたはインフラの問題を、早期に検出することです。
NVIDIA Rack Management Serviceは、ラックレベルのハードウェア抽象化および運用レイヤーを提供します。
このソフトウェアは各サーバーを独立して扱うのではなく、ファームウェア管理および大規模インフラ制御における主要な運用単位としてラックを扱います。
NVIDIA Infrastructure Controller向けCluster API Providerは、ベアメタルのプロビジョニングおよびテナントのオンボーディングを高速化するために設計されています。
NVIDIAによれば、その目標は、生のAIハードウェアを数日ではなく数時間で本番対応クラスターへ変換することです。
これらのコンポーネントは、NVIDIAがDGX Cloudを運用してきた経験を基に開発され、AIファクトリーの機能をマルチテナントクラウドプラットフォームへ容易に統合できるようにすることを目的としています。
大規模AI設備には、共通のラック設計だけでは十分ではありません。設備、冷却システム、電力アーキテクチャ、電力系統での挙動にも、共通の要件が必要です。
OCPにおいて、NVIDIAはAMD、Google、Metaと共同で、次世代AIインフラ向けの更新版オープンデータセンター仕様を公開しました。
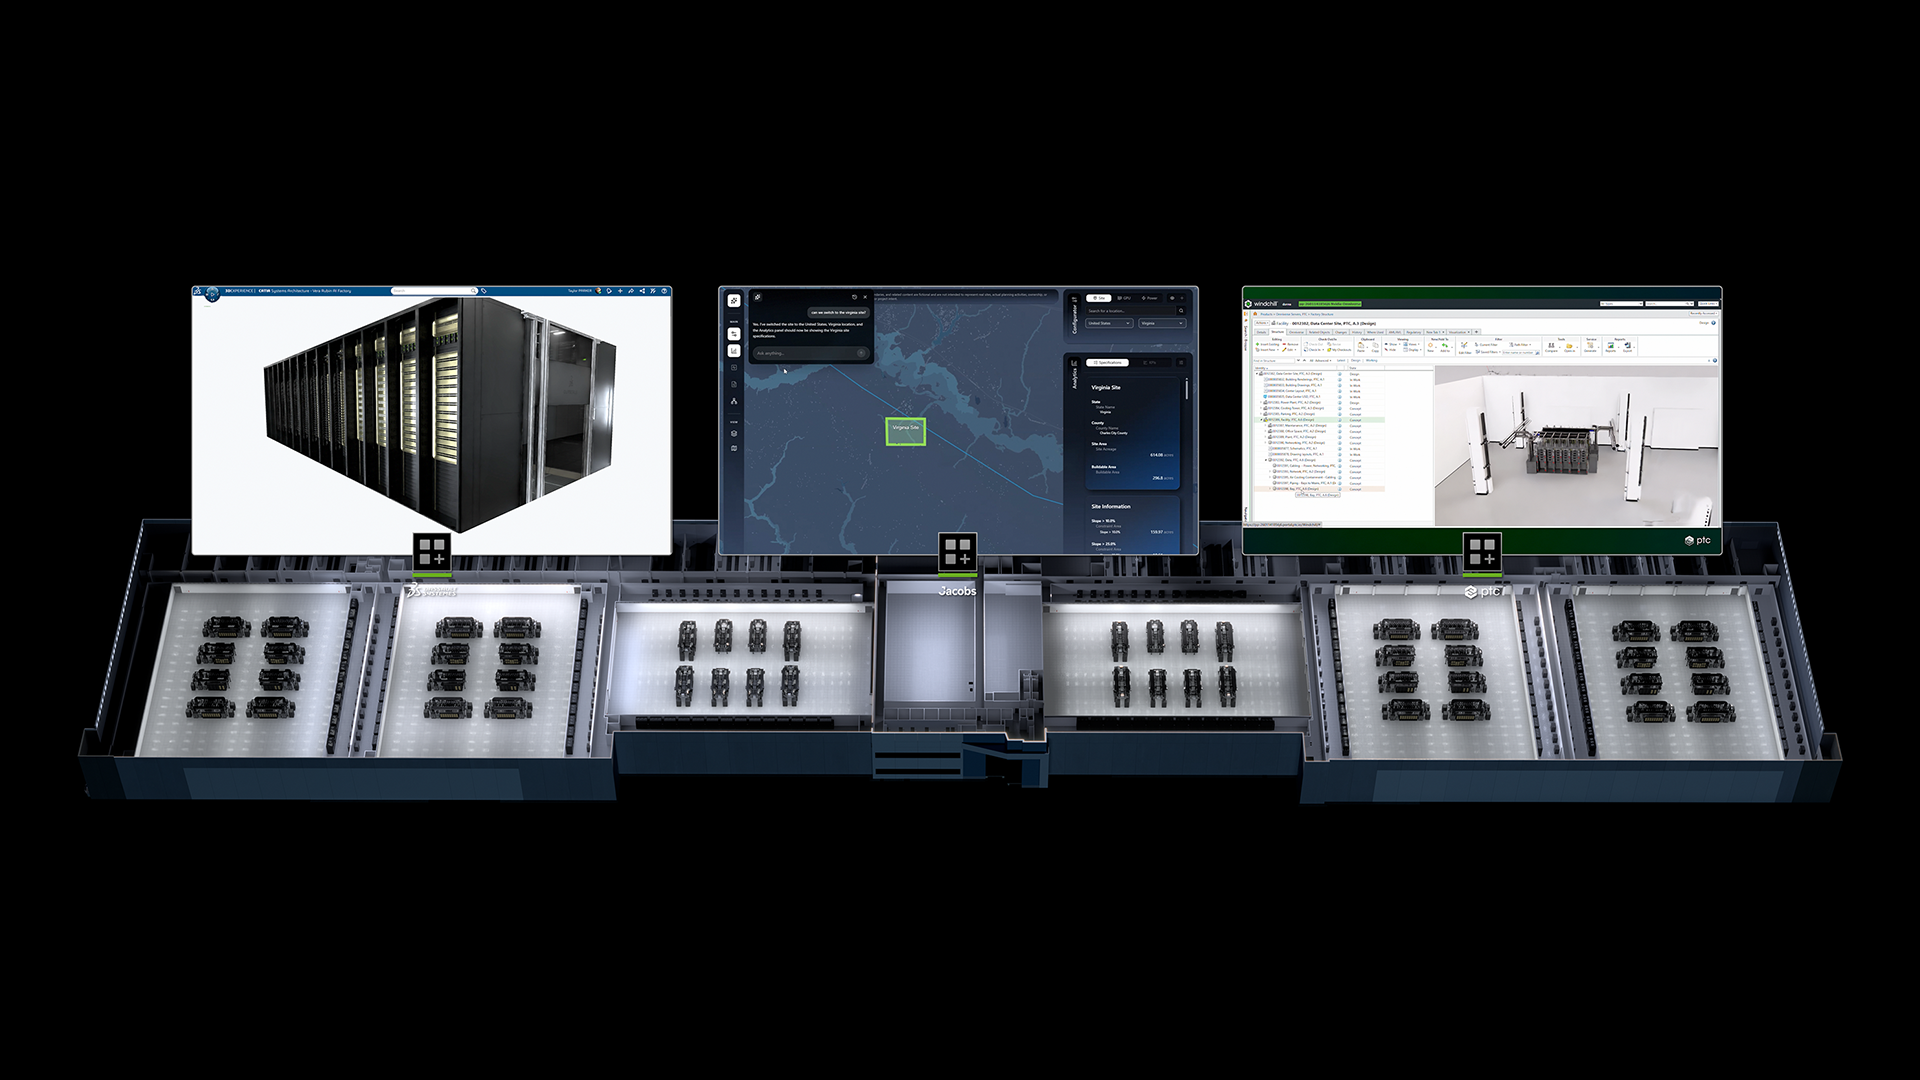
Open Data Center Specification v0.7は、AIファクトリーの設備設計に向けた共通の設計図を定義します。
対象領域には、以下が含まれます。
目的は、製造事業者、コロケーションプロバイダー、オペレーターに共通の目標を提供し、顧客ごとの個別の独自仕様を待たなくても済むようにすることです。
Google、Meta、Microsoft、NVIDIAは、OCP Grid Resilience Specificationも公開しました。
この仕様は、非常に大規模なAIインフラが電力系統の異常時にどのように振る舞うべきかを定義します。
設計目標は、AI設備が以下を実現することです。
AI設備が、急激な消費電力の変化によって周辺の電力系統に影響を及ぼしうる規模へ拡大するなか、これはますます重要になっています。
NVIDIAによれば、同社のDSXリファレンス設計は、これらのオープン標準を実際のAIファクトリーインフラへ展開するための実装経路を提供します。
電力密度は、AIファクトリー設計における最大の制約の一つになりつつあります。
トレーニング、推論、リーズニングクラスターが拡大するにつれ、従来の低電圧配電では、より多くの銅、ケーブル、変換装置が必要になります。
OCPにおいて、Visionbay.aiは、800 VDCアーキテクチャを基盤とし、将来のVera Rubin導入を念頭に置いたAIファクトリープラットフォーム、K-1の計画を発表しました。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
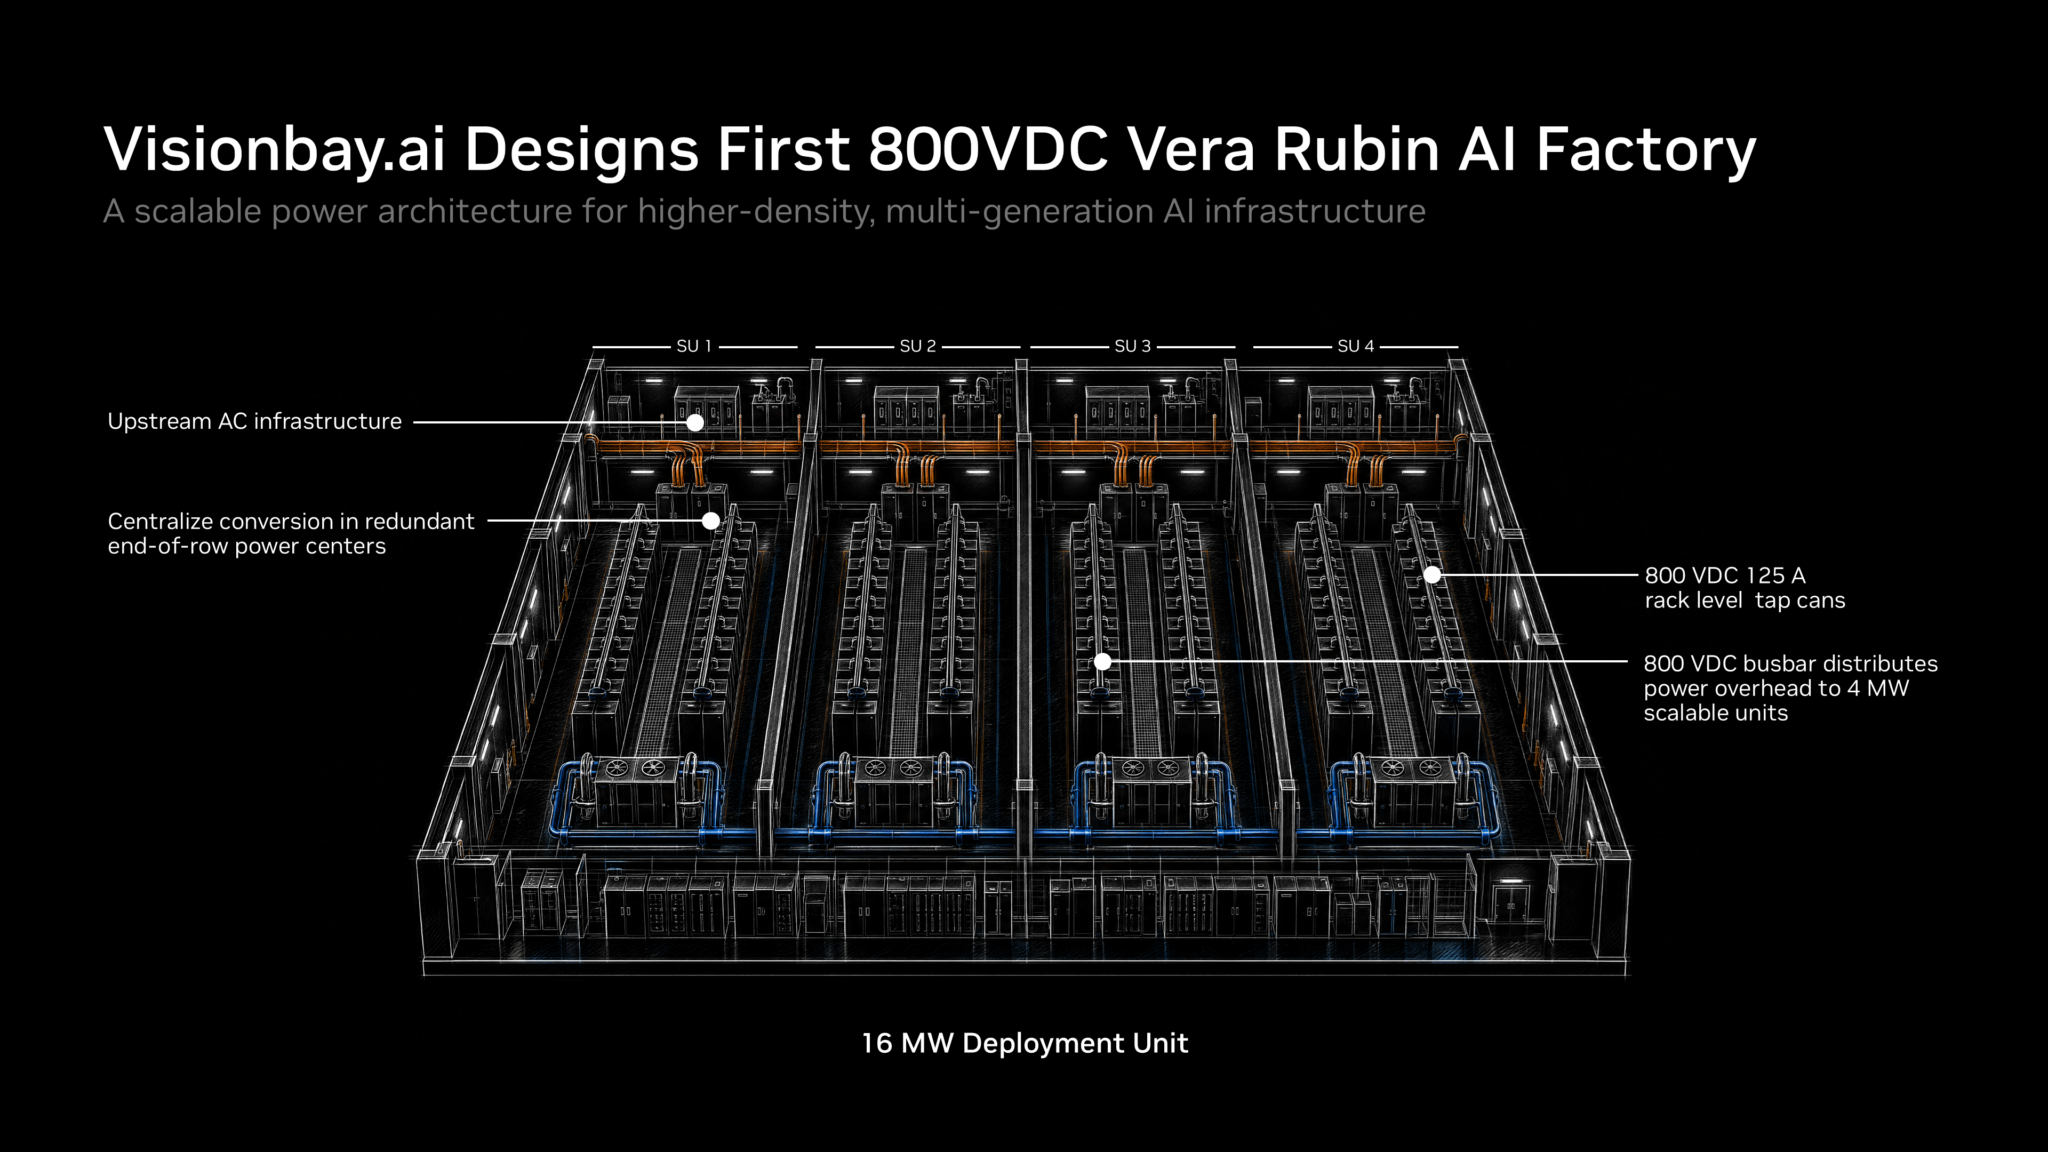
この設計は、NVIDIAの800 VDCリファレンスアーキテクチャと、Vertivの電力・熱管理技術を組み合わせています。
このアーキテクチャは、高電圧DC配電をコンピュートレイヤーにより近づけることを目的としています。
K-1では、大量の銅を使って低電圧電力を繰り返し変換・配電する代わりに、クラスター単位の電力センターでAC-DC変換を集約し、そこからラックの近くまで800 VDCを配電します。
NVIDIAによれば、このアプローチは以下を可能にします。
このプラットフォームは、施設全体を一度に800 VDCへ移行する必要がない、段階的な導入も想定して設計されています。
これにより、オペレーターは既存インフラとの互換性を保ちながら、最も価値を発揮する領域から高電圧DCを導入できます。
OCPにおいて、MetaとNVIDIAはネットワーキング協業の次の段階を発表しました。
Metaは、オープンネットワーキングインフラ上で稼働する、より大規模なVera Rubin AIファクトリーに向けて、NVIDIA Spectrum-6 102.4Tb/s Ethernetスイッチを採用します。
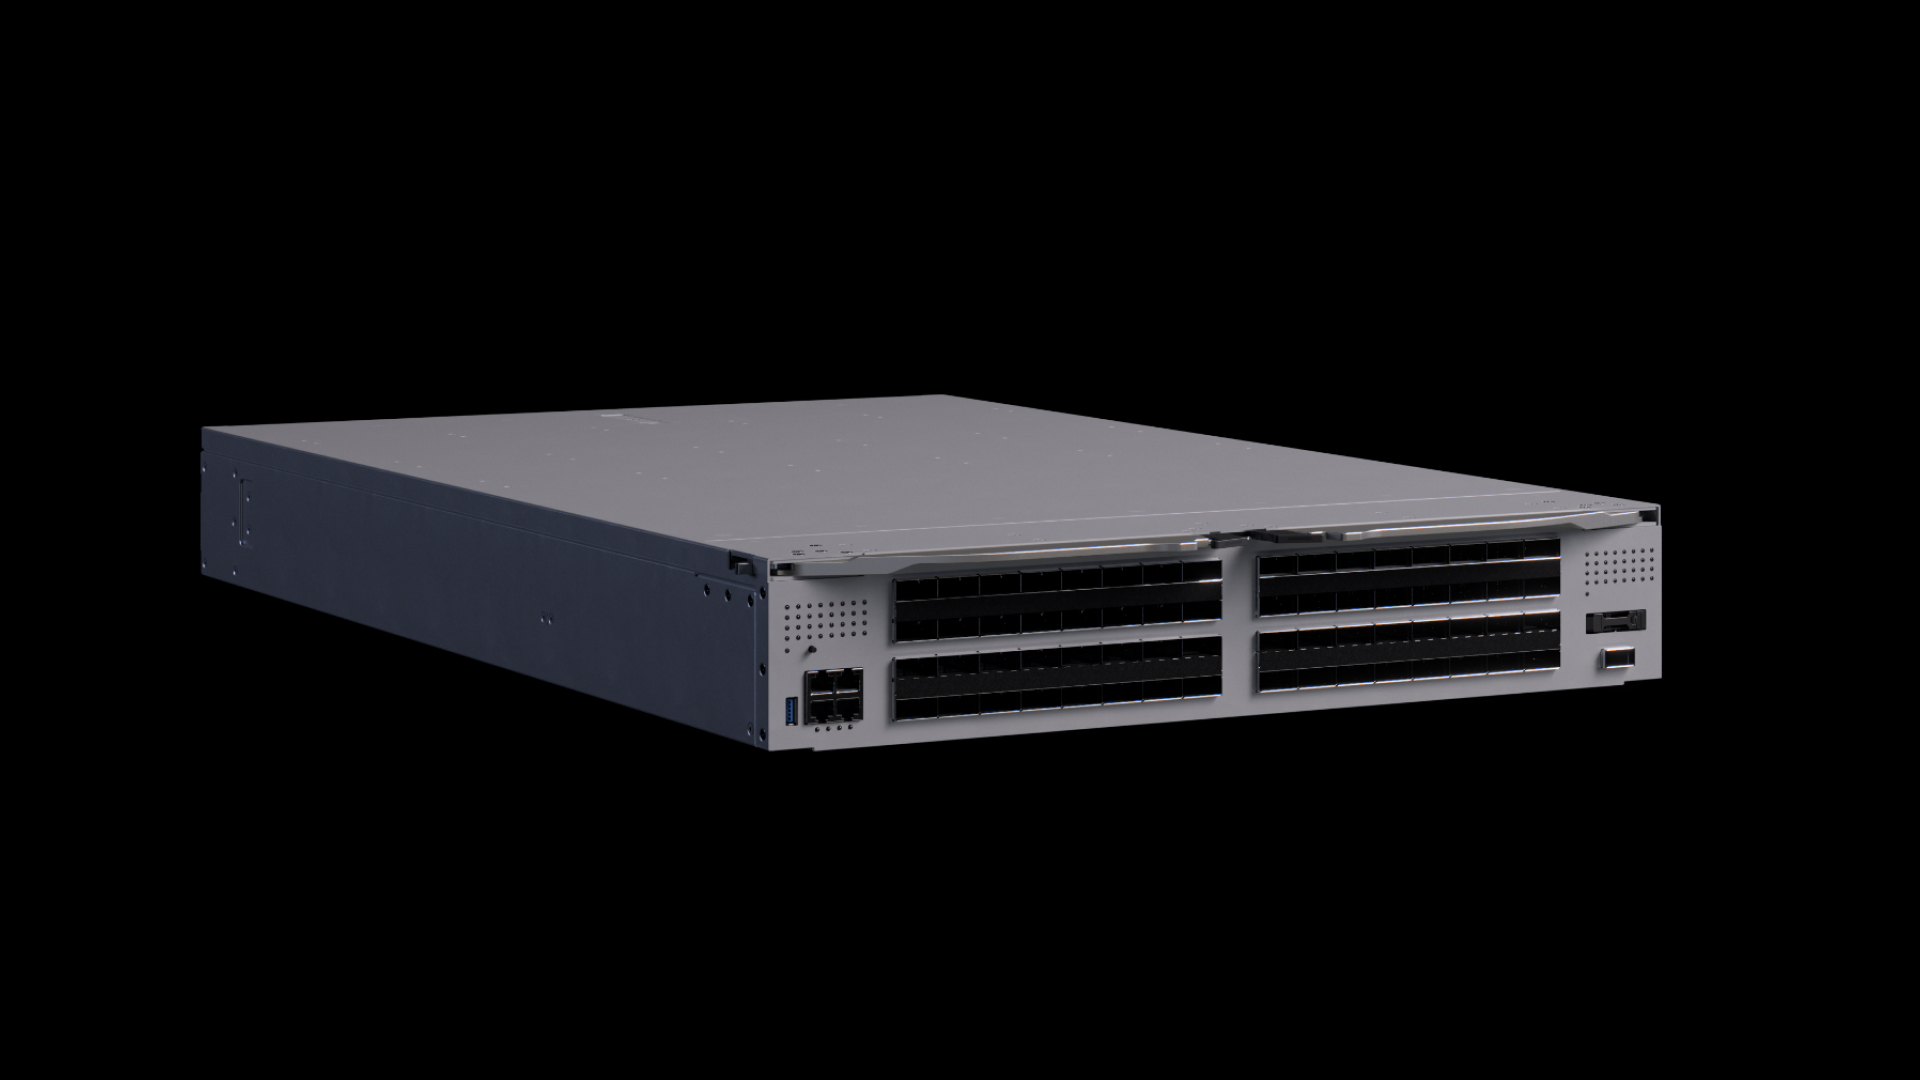
Spectrum-6は、以下を提供します。
MetaのSpectrum-6ベーススイッチは、N-IceCubeと呼ばれます。
これは、Metaの100T液冷ネットワークラックであるIcePackに収まるよう設計されています。
N-IceCubeは、MetaのオープンソースネットワークオペレーティングシステムであるFBOSSを実行します。
FBOSSは、スイッチハードウェア制御のベンダー非依存インターフェースを提供するOCP標準、**Switch Abstraction Interface(SAI)**を使用します。
これによりMetaは、Spectrum-6のスイッチングシリコンを採用しつつ、使い慣れたソフトウェア制御プレーンを利用できます。
この協業の主要部分が、Spectrum-X Multiplane技術です。
Spectrum-6スイッチとConnectX-9 SuperNICを使用するMultiplaneは、GPUトラフィックをハードウェアで最大8つの独立したネットワークプレーンに分散します。
この設計は、必要となるスイッチ階層数を減らしながら、100,000基以上のGPUを備えるAIファクトリーをサポートすることを目的としています。
複数の経路はレジリエンスも向上させます。
ネットワークコンポーネントの一つに障害が発生しても、トラフィックは残りのプレーンに切り替えられます。ファブリック全体を失うのではなく、ワークロードは帯域幅が低下した状態でも継続できる可能性があります。
その結果、非常に高い拡張性を持ち、実運用条件下でより容易に運用できることを意図したネットワーキングアーキテクチャとなっています。
AIクラスターが大規模化するにつれ、物理的な光接続自体が制約要因になります。
NVIDIAとCiscoは、次世代AIネットワーキング向けに設計された新しいプラガブル光トランシーバーモジュール、**Ultra-Dense Small Form Factor Pluggable(USFP)**の計画を発表しました。
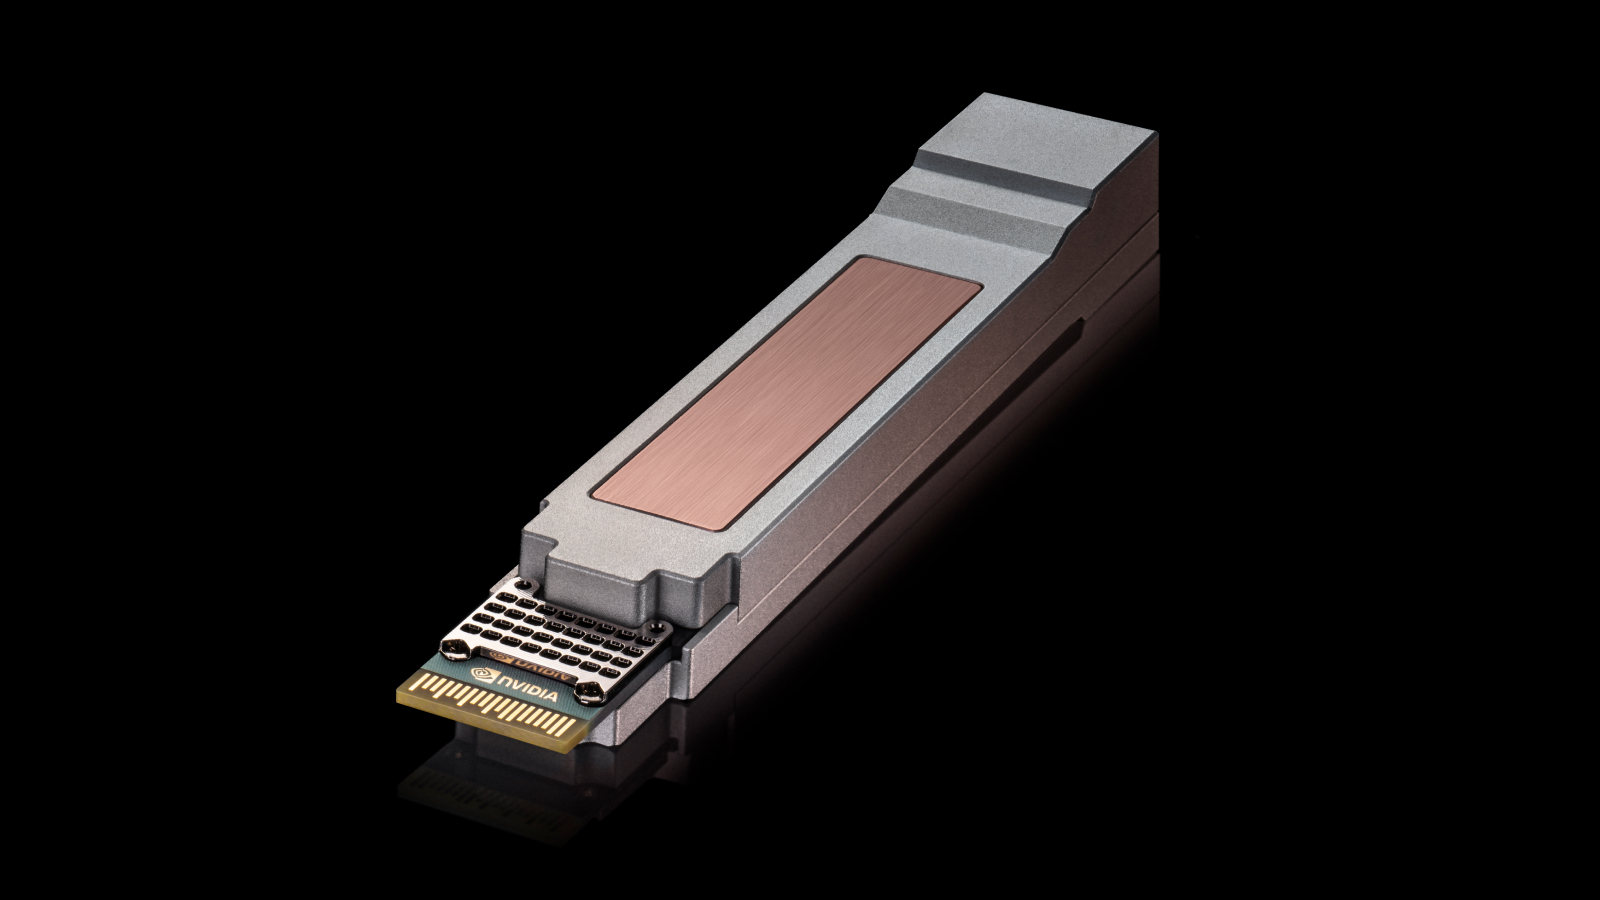
USFPは、広く使用されている200Gb/s/レーンのOSFPフォームファクターとおおむね同等の設置面積を維持しながら、400Gb/s/レーンネットワーキングへの道筋を提供するよう設計されています。
計画中の設計には、以下が含まれます。
目標は、レイテンシー、消費電力、運用上の複雑さを増加させる追加のネットワーク階層を加えることなく、より多くのコンピューティングリソースを接続することです。
NVIDIAとCiscoは、ケージ、コネクター、モジュールでTE ConnectivityおよびAmphenolと協業しており、コミュニティ主導のマルチソースの取り組みを通じてUSFPを推進する予定です。
これは、単一ベンダーの光学エコシステムではなく、より広範なOCPのテーマである相互運用性と設計を整合させるものです。
NVIDIAとGoogleは、将来のNVIDIA ConnectX-10 SuperNICおよびBlueField DPUでFalcon Transportがサポートされることも発表しました。
Falconは、特に輻輳環境下において、Ethernetネットワーク上で信頼性が高く高性能な通信を実現するために設計されたトランスポートプロトコルです。
以下の機能を含みます。
この協業は、NVIDIAのハードウェアアクセラレーションとDOCAソフトウェアを組み合わせ、アプリケーションが標準的なRDMAプログラミングインターフェースを引き続き使用できる状態を保ちながら、Falconを実装します。
これは、ソフトウェアが使い慣れたRDMA APIを継続利用できる一方で、NVIDIAおよびGoogleのネットワーキングハードウェアに共通のトランスポートレイヤーを提供するため重要です。
大規模AIファブリックでは、Falconは、アプリケーションがこうした詳細を直接管理しなくても、トラフィックを複数の経路へ分散し、輻輳に適応し、パケット損失から回復できます。
NVIDIAは、オープンなMGXアーキテクチャを通じて、Vera Rubinの主要なラックおよびコンピュートトレイ設計をOCPに提供し、新たな設備、電力系統、ネットワーキング標準にも参加しました。また、4つの新しいオープンソースDSX OSインフラコンポーネントを公開しました。
MGX 1.2は、高密度アクセラレーテッドコンピューティング向けに更新されたラック規模リファレンスアーキテクチャです。ブラインドメイト液冷、5,000Aバスバー、ネイティブ19インチサポート、構成可能なI/Oベイ、最大250kWのラック対応を追加しています。
新たに紹介されたコンポーネントは、NVIDIA Config Manager、Cluster Readiness Engine、Rack Management Service、NVIDIA Infrastructure Controller向けCluster API Providerです。これらは、ネットワーク構成、クラスター健全性テスト、ラックレベルの運用、ベアメタルプロビジョニングを対象としています。
ラック電力が上昇するなか、高電圧DC配電は、必要な銅、ケーブル、変換装置の量を削減できます。NVIDIAの設計は、既存設備での段階的導入を可能にしながら、将来のメガワット級AIラックをサポートすることを目的としています。
Spectrum-6は、AIファクトリー向けのNVIDIA製102.4Tb/s Ethernetスイッチプラットフォームです。200Gb/s/レーンのネットワーキングを提供し、MetaはN-IceCubeおよびSpectrum-X Multiplaneアーキテクチャの一部として採用しています。
USFPは、400Gb/s/レーンネットワーキング向けにNVIDIAとCiscoが開発している、新しいプラガブル光モジュールフォームファクターです。プラガブル光学の保守性を維持しながら、帯域密度と電力効率を向上させるよう設計されています。
Falconは、Googleの高性能Ethernetトランスポートプロトコルです。将来のConnectX-10 SuperNICおよびBlueField DPUは、RDMAプログラミングインターフェースを維持しながら、NVIDIAのハードウェアアクセラレーションとDOCAソフトウェアを通じてこれをサポートする予定です。
はい。NVIDIAは2026年5月、Vera Rubinが量産を拡大中であり、グローバルなシステムおよびサプライチェーンパートナーがシステムを大規模に製造していると発表しました。
OCP Global Summit 2026において、NVIDIAはVera Rubinをコンピュートプラットフォームから、よりオープンなインフラ設計図へと拡張しました。MGX 1.2はラック、冷却、電力設計のより多くの部分を標準化し、DSX OSは大規模AIクラスターの構成、検証、運用のためのオープンソースツールを追加します。
周辺のエコシステムも同じ方向へ進んでいます。新たなOCP設備・電力系統仕様は、大規模AIファクトリーの構築方法と電力異常時の振る舞いを定義します。Visionbayの800 VDC設計は上昇するラック密度に対応し、Meta、Cisco、GoogleはSpectrum-6、USFP、Falcon Transportを通じてネットワークスタックを拡張しています。
中心的なテーマは相互運用性です。Vera Rubinは単なるGPUプラットフォームではなく、コンピュート、ネットワーキング、電力、冷却、運用にまたがる共通のリファレンスアーキテクチャになりつつあります。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



