2026年8月のある週末、最先端AIがベンチマーク数学を超えて積極的な研究領域に進出していることを示す、これまでで最も明確な兆候の一つが生まれた。8月1日、OpenAIは10件の数学的進展を発表した。
2026年8月のある週末、フロンティアAIがベンチマーク数学を超えて能動的な研究領域に踏み込んでいることを示す、これまでで最も明確な兆候の一つが生まれました。
8月1日、OpenAIは『数学と理論計算機科学における10件の進展』を発表しました。これらの成果は、OpenAIが次世代の主要モデルと位置づけるAstraの内部バージョンによって生成されました。
この成果パッケージには以下が含まれます:
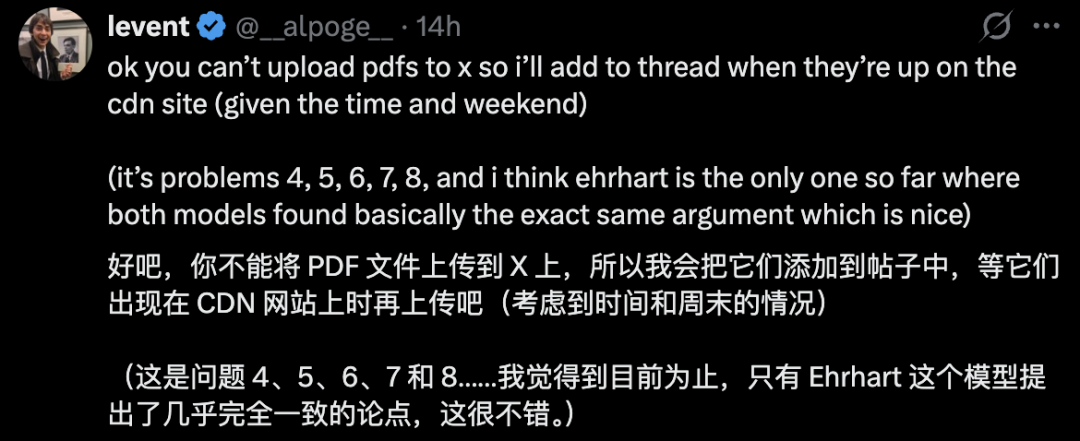
24時間も経たないうちに、Anthropicの研究員Levent Alpöge氏は、公開されているモデルClaude Fable 5が10件の成果のうち5件を再現したと述べました。
彼は、再現された5件が第4問から第8問であることを確認しました:
Alpöge氏によれば、これらの実行は自律的であり、汎用的なプロンプトを使用し、インターネットアクセスはなく、OpenAIの解答がコンテキストに漏れ込むのを防ぐための対策が取られたとのことです。
もしこれらの5つの証明が全面的な公開審査を生き残れば、この出来事は、あるフロンティアモデルによって生み出された研究成果が、時にほぼ即座に別のモデルによって独立に再発見され得ることを示すことになります。
しかしながら、証拠は対称的ではありません。OpenAIは原稿、プロセス詳細、そして機械検証可能な証明書を公開しました。一方、Fableの主張は現時点では主に公開声明によって支えられており、完全な証明パッケージによるものではありません。
したがって、有用な結論は単にどちらかのモデルが勝ったということではありません。
AIは現在、検証、解説、帰属、査読が証明の生産自体よりも拡張が難しくなるほどの速さで研究レベルの数学を生成できるようになっている。
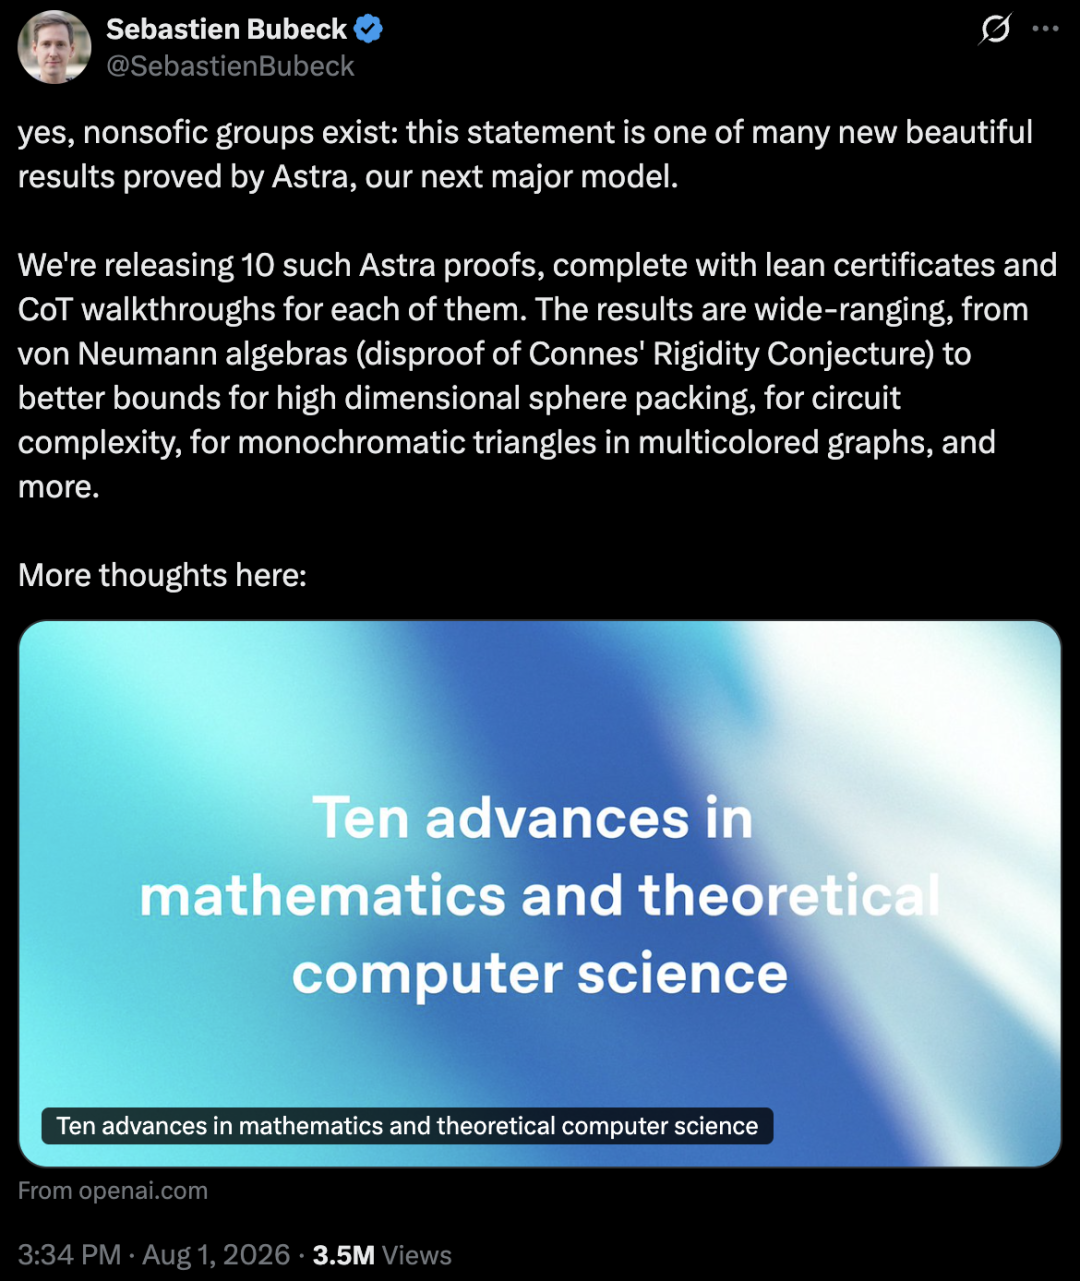
OpenAIはこれらの取り組みを、長年にわたって未解決だった問題を解決するか、または重要な進展をもたらす10件の成果として説明しています。
これらのテーマは、高次元幾何学、符号理論、群論、作用素環、算術回路計算量、量子複雑性、格子問題、凸幾何学、Ramsey理論、極値グラフ理論を網羅しています。
OpenAIによれば、これらの数学的議論は内部モデルAstraによって生成されました。その後、人間が同じモデルの支援を受けてこれらの議論を原稿にまとめ、その後モデルがLeanで各成果を形式化しました。
より正確なワークフローは以下の通りです:
Astraが数学的議論を探索
→ 成功した議論を選択
→ 人間とモデルが可読な原稿を作成
→ モデルが形式化

Leanでの結果
→ 正式な証明書とソースコードが公開
→ 外部の数学者が正確性、新規性、重要性を検証
モデルの貢献が中核ですが、最終的な研究成果には依然として人間による準備、形式化インフラ、ソフトウェアライブラリ、専門家による査読が含まれています。
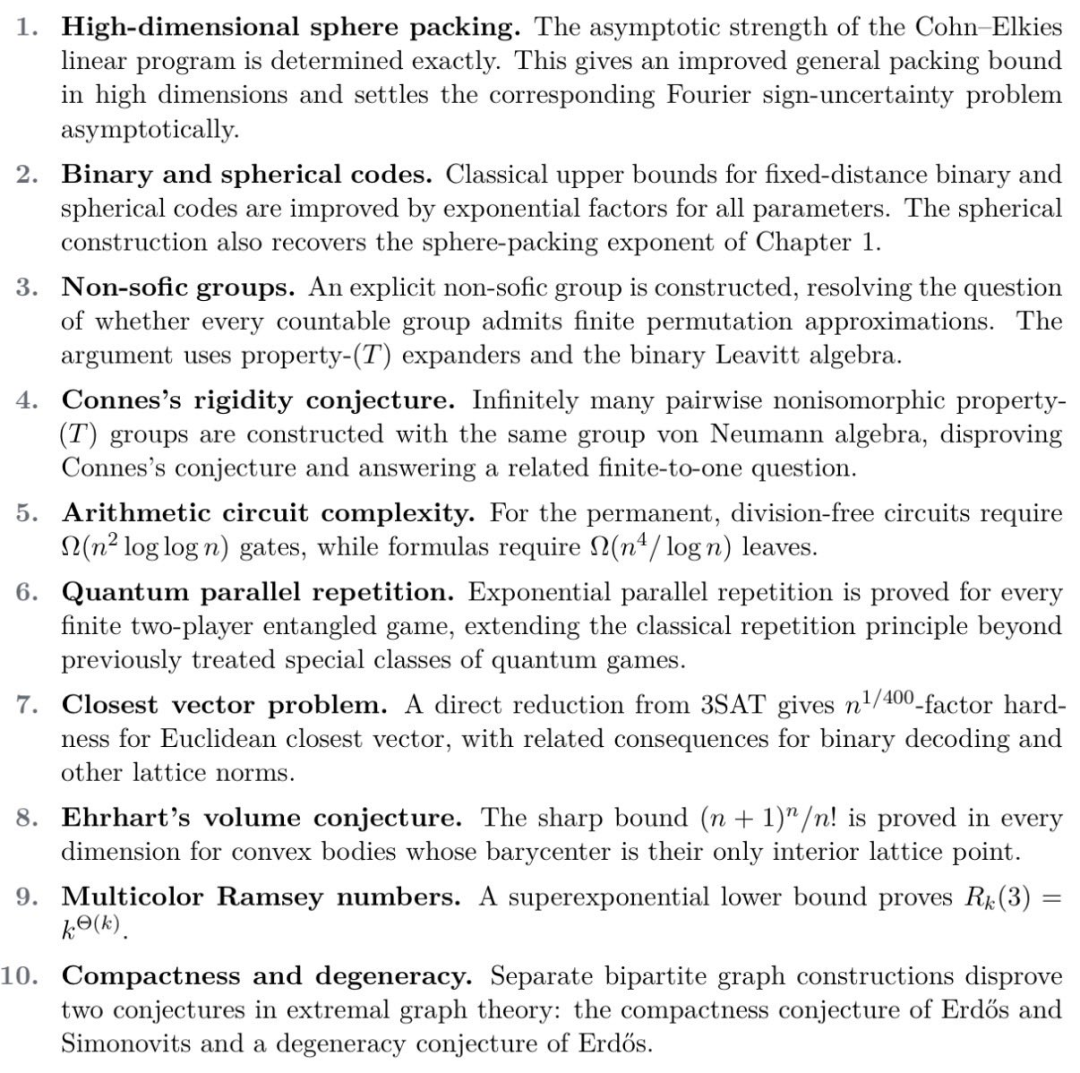
| 番号 | 分野 | OpenAIが発表した結果 |
|---|---|---|
| 1 | 高次元球充填 | Cohn–Elkies線形計画法の漸近的強さを決定し、一般的な高次元充填界を改善 |
| 2 | 二元符号および球符号 | 古典的な固定距離符号界を指数因子で改善 |
| 3 | 非sofic群 | 明示的な非sofic群を構成し、すべての可算群が有限置換近似を許容するかという問題を解決 |
| 4 | Connes剛性予想 | 同じ群von Neumann代数を持つが同型ではない性質(T)群を構成し、当該予想を反証 |
| 5 | 算術回路計算量 | パーマネントを計算するための新しい下界を確立。次数(n^4/\log n)の算術公式下界を含む |
| 6 | 量子並列反復 | 一般的な有限二人絡み合いゲームに対する指数級並列反復特性を証明 |
| 7 | 最近ベクトル問題 | ユークリッドCVPおよび関連する格子問題に対する多項式因子近似困難性を与えた |
| 8 | Ehrhart体積予想 | 各次元において、指定された凸体クラスの最適な最大体積界を証明 |
| 9 | 多色Ramsey数 | 多色三角形Ramsey数の超指数下界を証明し、Erdős問題183を解決 |
| 10 | 極値グラフ理論 | Erdős問題146および180に関連する緊密性と退化性の予想を反証する例を構成 |
これらは通常のオリンピック級の問題ではありません。そのうちのいくつかは何年も未解決だった問題であり、評価には深い専門知識が必要です。
OpenAIはまた、『アイデアはどのように形成されたか:数学的発見の記録』と題する62ページの文書も公開しました。
証明が答えようとするのは:
なぜこの定理は成り立つのか?
発見の記録が答えようとするのは:
システムはどのようにしてこの議論を見つけたのか?
これは2つの異なる問いです。
ステップごとの解説は、研究者がモデルが既知のアイデアを再結合したのか、何らかの類推を特定したのか、広範な探索を行ったのか、新しい構成を見つけたのか、あるいは既知の定理を予想外の方法で使用したのかを判断するのに役立ちます。
これらの内容は依然として慎重に扱う必要があります。モデルによって生成された叙述は、必ずしも内部の計算プロセス毎回の完全な因果記録であるとは限りません。
公式の openai/ten-proofs リポジトリには、各結果に対応する1つのLeanモジュールが含まれています。
このプロジェクトは以下を使用します:
Lean 4.32.0
mathlib
Lake
elan をインストールした後、公式READMEはユーザーに以下のコマンドで10件すべての形式化証明を構築するよう指示しています:
lake exe cache get
lake build All
個別のモジュールを構築することも可能です:
lake build SpherePacking
このリポジトリには以下が含まれています:
SpherePacking.lean
MetricCodes.lean
NonSoficGroup.lean
ConnesRigidity.lean
Permanent.lean
QuantumParallelRepetition.lean

lean
GapCVP.lean
EhrhartVolumeInequality.lean
MulticolorTriangleRamsey.lean
CompactnessAndDegeneracy.lean
コードはApache 2.0ライセンスで公開され、独立した検証リソースを含んでいます。
Leanは、依存型理論に基づく対話型定理証明器です。
Leanカーネルによって検証された証明は、形式化された定理が定義、仮定、インポートされた公理やライブラリ、および形式化された証明項から導出されることを確立します。
これにより、非形式的な議論で発生し得る多くのエラーが排除されます:
証明書は、著者の主張が説得力があるように聞こえるからという理由ではなく、機械的に検査することができます。
形式検証によって、すべてのレビュー上の問題が排除されるわけではありません。
定理証明器が検査するのは、エンコードされたステートメントです。人間は、それが数学的問題を正確に捉えているかどうかを判断する必要があります。
Leanが検証するのは、形式化された定義からの帰結です。それらの定義が確立された概念を反映しているかどうか、あるいはタイトルの結果を弱める隠れた仮定が存在するかどうかを決定することはできません。
形式上の正しさは、斬新さと同義ではありません。文献レビューと専門家の知識が依然として必要です。
機械は定理が成立することを検証できます。しかし、結果が分野を変えるものであるか、価値あるアイデアを導入するものであるかを判断することはできません。
形式上有効な2つの証明は、説明上の価値において大きく異なる場合があります。一方は再利用可能な原理を明らかにするかもしれません。もう一方は、人間が内面化するのが難しいかもしれません。
形式チェックが解決するのは、正確性の問題です。数学的理解は依然として独立した課題です。
OpenAIの発表から1日も経たないうちに、Alpögeは「Fableでその半分を完了した」と書きました。
彼は設定を次のように説明しています:

Alpögeは後に、これら5つが第4項から第8項であることを確認しました。
| OpenAIプロジェクト | テーマ | Fableの主張の公開状況 |
|---|---|---|
| 4 | Connes刚性予想 | 再現済みと主張 |
| 5 | 算術回路複雑性 | 再現済みと主張 |
| 6 | 量子並列反復 | 再現済みと主張 |
| 7 | 最近ベクトル問題 | 再現済みと主張 |
| 8 | Ehrhart体積予想 | 再現済みと主張 |
Alpögeは、Ehrhartの結果がAstraとFableが本質的に同一の議論を使用したと思われる唯一のものであると述べています。
正確であれば、他の4つはOpenAIの経路の再構築ではなく、代替証明である可能性があります。
OpenAIの10件の結果について、公開パッケージには定理のステートメント、完全な原稿、推論プロセス、Leanソースコード、ビルド手順、および独立した検証リソースが含まれています。
Fableの5件について、私が検証できるのは、Alpögeのステートメント、言及された問題番号、彼が述べた実験条件、およびEhrhartの議論に関する彼の観察です。
私が検証できないのは、以下を含む公開パッケージです:
厳密な記述は次のとおりです:
Anthropicの研究者が、Fable 5が制御された条件下で10の問題のうち5つを独立に完了したと公に報告したが、検証の時点では、完全な独立評価に必要な詳細な証拠は公開されていない。
これは主張が偽であることを証明するものではありません。主張が、OpenAIが公表したパッケージと同じ証拠段階にまだ達していないことを意味します。
上記の留保点があったとしても、タイミングは注目に値します。
伝統的な数学では、重要な新しい結果を独立に再構築するには数か月から数年かかる場合があります。
研究者はまず、背景知識を学び、原稿を読み、技術的詳細を調べ、議論を再構築し、代替案を試し、問題を議論し、レビューや続報を発表する必要があります。
能力の高いモデルは、このプロセスの一部を圧縮することができます。
あるモデルの結果が別のモデルによって1日で独立に到達できる場合、AI生成の発見における優先権の窓は大幅に短縮される可能性があります。
最初のチームは、問題を選択し、最初の公開議論を提示し、原稿を準備し、結果を形式化し、他の人が参照できる記録を作成したことで、依然として称賛に値します。
しかし、他の研究者が類似の問題を即座に最先端システムに割り当てることができる場合、先発の利点は数年ではなく数日しか続かない可能性があります。
ほとんどのモデルベンチマークは、既知の回答を持つ問題でシステムを比較します。
ベンチマークが問うのは:
同じテストセットが与えられたとき、どのモデルがより高いスコアを獲得するか?
今回のセットは異なる質問を投げかけています:
2つのシステムが独立に同じ新しい最前線の結果に到達できるか?
これは科学の再現に似ています。
独立した再現は、ある結果が単一のモデルのエラー、脆弱なプロンプト、情報漏洩、または異常な証明経路に依存しているかどうかを明らかにすることができます。
2つの独立した議論は、特に異なる思考経路を取る場合、信頼性を高めることができます。
しかし、それらは依然としてレビューを必要とします。
2つのモデルは、類似した訓練ソース、数学的誤解、最適化バイアス、または暗黙の仮定を共有している可能性があります。
モデルの独立性は、自動的に認知の独立性を意味するわけではありません。
信頼できる再現パッケージは、他の人が実験を繰り返すのに十分な情報を開示する必要があります。
ネットワークと検索アクセス。
コンテキストに含まれるソースドキュメント。
モデルスナップショットの時刻。
コピーされた言語や構造を検出するために用いられる手法。
これらの情報がなければ、「独立した再現」は有望な初期報告と区別がつかないままである。
Anthropic は2026年6月に Claude Fable 5 をリリースした。
Anthropic はこれを、一般向け利用と安全性を備えた Mythos 級モデルと説明している。
同社は、このモデルが長期的な自律作業、ソフトウェアエンジニアリング、知識作業、視覚、科学研究、長いコンテキストを要するタスクにおいて特に優れていると述べている。
公式 API モデル識別子は以下の通り:
claude-fable-5
Anthropic が公表した価格は以下の通り:
入力トークン100万個あたり10ドル
出力トークン100万個あたり50ドル
Fable の公開リリースは数学のストーリーと深く結びついている。
Astra は依然として OpenAI 内部で未公開のモデルである。
Fable は、サポートされている Anthropic の製品および API を通じて、研究者や開発者がアクセスできる。
これにより、外部のチームが独自の研究課題を試しやすくなるが、モデルへのアクセスが、良い問題を選択したり出力を検証したりするために必要な専門知識を保証するわけではない。
OpenAI は、Sol API 価格でそれらの10個の解を見つけるために必要な総トークン数は約 2000ドル に相当すると述べている。
この数字は驚異的だが、正確なラベルが必要である。
これは最も適切には、解をうまく見つけるためのトークンコストの見積もりと理解されるべきである。
これはその研究プロジェクトの総経済コストではない。
より大きなコストの積み重ねには、以下が含まれる可能性がある:
OpenAI は、他の主要な問題も試みたが成功せず、ミレニアム懸賞問題はいずれも解決していないと述べている。
したがって、この2000ドルの見積もりが答えているのは:
公開 API レートで、成功した検索のトークンコストはいくらか?
ということである。
それは次の問いには答えない:
モデルを作成し、研究結果を生成・検証・公開するためのコストはいくらか?
どちらの数字も有用だが、それらは異なるものを測定している。
間接コストを考慮に入れても、再び真剣に試みるための低い限界コストは、研究の実施方法を変える可能性がある。
人間の数学者は、特定の道筋を探求する価値があるかどうかを決定するために数週間を費やすかもしれない。
一方、AI システムは多くの道筋を並行して探索するよう要求できる。
研究者はモデルを以下のために使用するかもしれない:
この効果は、他の科学におけるハイスループット実験に類似しているかもしれない。
別の仮説をテストするコストが下がれば、テストされる仮説の数は増える。
希少なリソースは、有望な問題を選択し、それに伴う候補の殺到を評価することに向けられる。
成功したものだけを数える原価計算は、誤解を招く図を示す可能性がある。
システムが100の未解決問題を与えられ、そのうち10を解決したと仮定する。
完全な探索プロジェクトの経済性を測定することが目的なら、各成功した解決策のコストには、90の失敗に費やされたリソースが含まれるべきである。
完全な会計は以下を報告するべきだ:
総推論コスト
÷
検証済み結果の数
それは、成功した最終実行、失敗した完全実行、部分的な進展、人間による再起動、並列候補、および検証コストを区別するべきである。
この分母がなければ、低い数字は発見プロセス全体の経済性ではなく、選び出された成功例のみを説明している可能性がある。
再現作業に対する批判の一つは率直である:
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
なぜAstraの結果をFableに再現させるのか、新しい未解決問題を割り当てるのではなく?
再現と発見は異なる目的を果たす。
再現は信頼性をテストする。
新しい問題を解決することは最先端の能力をテストする。
Fable はまた、新しい数学的結果にも関連付けられている。
2026年7月、Alpöge はヤコビ予想の3次元の場合における反例を報告し、発見プロセスにおけるFableの役割をクレジットした。
その反例は形式化されて検証され、数学者によって議論され、その後、後続の研究が続いた。7月末にarXivに掲載された論文は、自己矛盾のない完全な説明を与え、そのメカニズムをより高次元に一般化した。
この出来事は繰り返し現れるパターンを明らかにする:
最終段階こそが、永続的な数学的価値の大部分が存在する場所かもしれない。
明確な反例は、時として迅速に検証できる。
ある予想が特定の性質を持つ対象は存在しないと主張するなら、有効な対象が一つあればそれを覆すのに十分である。
査読者は以下を検証できる:
一方、長大な一般定理は、何百もの相互に関連する補題と、文献に対する広範な理解を必要とするかもしれない。
この違いは、AIが生成した反例が急速に広まる理由を部分的に説明する。
ヤコビの例は十分にコンパクトであり、研究者は迅速に確認して形式化することができた。
Astra の10の成果のいくつかはより長い理論の連鎖を含み、コミュニティが消化するのにより多くの時間を必要とするかもしれない。
中心的な問題は:
AI が最先端の証明を迅速に生成できるなら、数学コミュニティはそれらを十分な速さで検証できるか?
研究成果は複数の形式の承認を得る必要がある。
証明は実際に仮定から導かれるか?
Lean はここで役立つことができる。
形式化されたステートメントは、著者が主張する意味と一致しているか?
専門家がこの変換をチェックする必要がある。
その問題は確かに未解決であり、結果は新規性があるか?
これには文献知識が必要である。
証明は新しいアイデアを明らかにするか、それとも単に事実を確認するだけか?
これには数学的判断が必要である。
その作業はレビューされ、議論され、修正され、適切な文脈に置かれたか?
これには時間と制度的プロセスが必要である。
AI が証明生成を加速する速度は、大学やジャーナルが高度に専門化された作業をレビューできる専門家のプールを拡大する速度をはるかに上回っている。
強力なプログラミングモデルは、アプリケーションの構築を要求することでテストできる。
強力な画像モデルは視覚で判断できる。
しかし、最先端の数学は異なる。
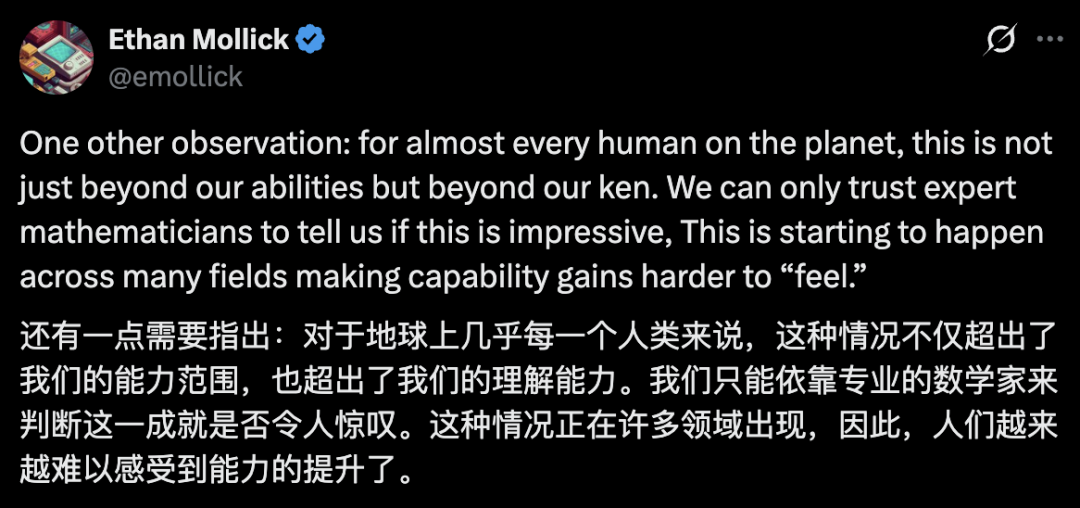
ほとんどの読者は、非sofic群の存在、Connes の剛性予想の反例、絡み合いゲームの並列反復定理、または格子に関する困難性を自分自身で評価することはできない。
彼らは信頼の連鎖に依存している:
モデル出力
→ 形式化証明書
→ 証明アシスタントとそのライブラリ
→ 領域専門家
→ 独立した査読者
→ ジャーナルと研究コミュニティ
これにより、透明性は重要性を増すどころか減ることはない。
一般の人々が能力を直接検証できない場合、信頼は証拠と制度から来なければならない。
この出来事を、AIが孤立して数学を置き換えたと説明するのは誤解を招く。
これらのモデルは以下に依存している:
AstraのLean証明書が可能になったのは、大規模なコミュニティが長年にわたって数学の基礎を形式化し、再利用可能なライブラリを構築してきたからである。
モデルの成果は本物である。
それを支える人間のインフラストラクチャも同様に本物である。
より誠実な説明は次のとおりである:
最先端モデルは、人間が構築し維持する数学知識システムにおける強力な参加者になりつつある。
証明は正しくても、啓発的であるとは限らない。
数学者は、結果が新しい不変量、構成、再利用可能な方法、分野間の関連、より簡潔な説明、またはより良い問題を導入するときに、その結果を重視することが多い。
AIが長大な証明を生成したとき、審査者は次のように問うかもしれない:
これが、定理を検証することと、それを人間の数学に統合することの違いである。
正しい結果の数は重要である。
それらの結果を理解に変える能力は、さらに重要かもしれない。
証明探索がより安価になれば、問題選択が研究上の優位性のより大きな部分を占めるようになるかもしれない。
最も困難な決定は以下の可能性がある:
これらは数学的センスの問題である。
モデルは問題の生成に役立つかもしれないが、現在の研究エコシステムは、どの問題が有意義であるかを判断するために依然として専門家に大きく依存している。
従来のピアレビューは、投稿数が比較的少ないことを前提としている。
AIは、既存のジャーナルが処理できるよりも多くの候補結果を生み出す可能性がある。
レビュープロセスには新しい層が必要になるかもしれない。
形式化に適したすべての結果には、機械で検証可能な証明書が添付されるべきである。
プロンプト、モデルバージョン、ツールへのアクセス、実行条件はすべてアーカイブされるべきである。
システムは新しい主張を論文および定理データベースと照合すべきである。
独立モデルによる再現
異なるモデルまたは研究チームは、提案された証明を見ずに同じ問題を解決しようと試みることができる。
専門家は、どの結果が深い審査に値するかを特定する。
正しい証明は、人間が学習できる形式に変換される。
オープンなリポジトリにより、誤り、簡略化、代替の議論が継続的に記録されることを可能にする。
これはジャーナルや専門家を置き換えるものではなく、より大規模な作業量を処理するためのより良いツールを提供するものである。
ライデンAIと数学宣言は、数学研究におけるAIの責任ある使用を求めるものである。
その関心事は以下を含む:
OpenAIの発表は、これらの問題のいくつかに異常なほどの直接性をもって対応した。
それは数学的議論をモデルの功績とし、原稿準備における人間の役割を説明し、形式化証明書を公開し、コミュニティによるレビューを招いた。
依然として残る問題:
これらの問題はもはや仮想的な政策課題ではない。
それらは現在、実際の研究成果に適用される。
以下を区別する:
隠れた仮定、循環論法、説明のない遷移、誤った引用、範囲の変化、曖昧な記号を探す。
Leanの定理が意図された数学的内容を忠実に表現していることを確認する。
OpenAIのリポジトリの場合:
git clone https://github.com/openai/ten-proofs.git
cd ten-proofs
lake exe cache get
lake build All
インポートされたモジュール、公理、プレースホルダー、安全でない宣言、カスタム定義、信頼される外部コードを確認する。
形式化証明は、原稿とは異なる経路で定理を確立する可能性がある。
定理のステートメント(ただし提案された証明は提供しない)を別のモデルまたは研究チームに渡す。
新規性を確認し、重複する作業を特定する。
正しい結果の後には、概念的な質問が続くべきである:
施工が機能するのか?
AlpögeまたはAnthropicが以下を公開すれば、その主張は大幅に強化される:
最も興味深い結果は、必ずしもまったく同じ5つの証明ではない。
4つの真に異なる議論の方がより価値があるかもしれない。なぜなら、それらは同じ結果の背後にある代替構造を明らかにする可能性があるからである。
OpenAIは公開で以下を提供している:
これはピアレビューの代替にはならない。
しかし、それは真剣で検証可能な研究パッケージを作成する。
責任は「証拠を見せよ」から「大量の証拠を評価せよ」へと移行した。
寓話が報告した応答は、最先端の研究能力がモデルのリリースよりも速く広がる可能性があることを示している。
企業はモデルを非公開に保つことができる。
しかし、そのモデルによって生成された数学的結果が、発表後も長期間独占的であり続けると想定することはできない。
定理のステートメントが公開されると、他の有能なシステムは直ちにそれに取り組むことができる。
したがって、組織は完全な証拠を迅速に公開し、発表前に形式化し、独立した再現を招き、公開前に分野の専門家と調整することを選択するかもしれない。
優先権は依然として重要である。
優先権の主張をめぐる証拠パッケージも同様に重要かもしれない。
OpenAIは、球充填、符号理論、非ソフィック群、Connes剛性予想、算術回路、量子並列反復、格子困難性、Ehrhart体積予想、Ramsey数、極値グラフ理論に関する研究を含む、数学および理論計算機科学の分野における10件の成果を発表しました。OpenAIはこれらを、長年にわたり未解決だった公開問題を解決または大幅に前進させた結果であると説明しています。
いいえ。OpenAIはAstraを次期主要モデルの内部バージョンとして説明しています。論文、推論のステップごとの解説、Lean証明書は公開されていますが、論証の生成に使用されたAstraモデル自体は公開されていません。
Anthropicの研究者Levent Alpögeは、Fableが自律的かつオフラインの条件下で24時間以内に問題4〜8を完了したと公に述べています。検証プロセスにおいて、これら5回の実行の完全な原稿、ログ、プロンプト、Lean証明書は公開された形では見つかっていないため、より完全な証拠が公開されるまでは、この主張は暫定的なものと見なすべきです。
Alpögeは、Connes剛性予想、算術回路複雑性、量子並列反復、最近ベクトル問題、およびEhrhart体積予想を確認しました。彼は、Ehrhartの結果は本質的にAstraと同じ論証を使用しているように見える一方、他の4つの結果は異なる可能性があると述べています。
OpenAIは、10件すべての結果に対するLean 4形式証明を、ビルド手順と独立した検証リソースとともに公開しました。コンパイルが通ったLean証明書は形式定理を検証できますが、エンコードされたステートメントが意図された数学的主張を忠実に一致させているかどうかは、専門家による確認が依然として必要です。
OpenAIは、Sol APIの料金レートで、成功した解決策を見つけるために必要なトークンに約2,000ドルかかったと述べています。この見積もりには、モデルのトレーニング、失敗した研究試行、人手による原稿作成作業、インフラストラクチャ、形式検証、外部の数学レビューは含まれていません。
Lean証明書により、小型の信頼済みカーネルが、形式定理がその仮定と依存関係から導出されていることを機械的に検証できます。これらは隠れた論理的欠陥のリスクを低減しますが、新規性、重要性、または非形式的な数学的変換の忠実性を確証するものではありません。
現在の証拠が示すのは、単純な取って代わられるという主張ではなく、数学の仕事のやり方の変化です。モデルは探索、証明生成、反例発見、形式化を加速できますが、問題選択、解釈、文献の文脈、レビュー、そして証明を理解へと変換する作業においては、人間が依然として不可欠です。
OpenAIは、Astraによって生成された10件の進歩を含む異常に完全な研究パッケージを公開しました:249ページの原稿、発見プロセスの詳細な説明、および外部の研究者が再構築できる10件のLean形式証明です。
Claude Fable 5は、24時間以内にこれら5つの問題を完了したと報告されており、これは新しいタイプのモデル支援による再現を表す可能性があります。この主張は重要ですが、その公開された証拠は現時点ではOpenAIが提供する原稿や形式証明書ほど完全ではないため、検証待ちの結論として明確にラベル付けされるべきです。
2,000ドルという見積もりは、研究プロジェクト全体の総コストではなく、Sol APIの料金レートでの解の探索を成功させるためのトークンコストとして理解するのが最も適切です。トレーニング、失敗した試行、人手による準備、形式化、インフラストラクチャ、レビューは依然として実際の経済コストの一部です。
より大きな変革は、「証明の希少性」から「レビューの希少性」への移行です。モデルは、専門家が検証し、解釈し、文脈に位置づける速度を超えて、数学的主張を生成する可能性があります。
証明が安価で容易に入手できるようになるとき、最も価値のある仕事は、どの証明が正しく、有意義で、新規であり、理解する価値があるかを判断することにあるかもしれません。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



