For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/qiqcbench-17-ai-agents-tested-on-49-quant-cd2ff2ac.md.
AIエージェントは、チャット画面やコードエディターを越えて、科学ワークフローへと進出し始めています。
2026年、この傾向は量子コンピューティングの分野で特に明確になりました。研究グループや企業は、量子ソフトウェアの作成、実験装置の調整、測定実験の反復を支援できるAIシステムを示し始めています。
そこで、より難しい問いが浮かび上がります。
AIエージェントが物理学を理解していたとしても、科学的なワークフローを最初から最後まで、信頼性をもって実行できるのでしょうか。
シンガポール国立大学、南洋理工大学、ジョージア工科大学、シカゴ大学、ボストン・カレッジ、Unitary Foundation、GaugeForgeなどの機関に所属する研究者チームは、この問題を中心に据えたベンチマークを構築しました。
論文 「Evaluating Verified Autonomy in Quantum Engineering」 では、次の要素が紹介されています。
この論文では、検証済み自律量子工学のテストベッドとしてQuantum-HarborとQIQCBenchが紹介されています。
研究者たちは 17の最先端エージェントシステム を評価しました。
合否スコアの最高値は 78% でした。一方、最も低いシステムはわずか 3% にとどまりました。
しかし、主な発見はランキングではありません。
重要なのは、何をすべきかを知っていること と、最終的な結論を実際に裏付ける証拠を伴って、実験ワークフローを確実に完了すること の間にある隔たりです。
重要な制限事項: 論文におけるすべてのベンチマーク評価はシミュレーション上で実施されました。この研究は、これらのエージェントがすでに実際の量子実験室を無人で安全かつ信頼性高く運用できることを示すものではありません。
AIエージェントに量子実験室の制御を任せ、一晩そのままにしておく場面を想像してみてください。
翌朝、エージェントは次のように報告します。
キャリブレーションが収束しました。
性能が42%向上しました。
タスク完了。
一見すると、良い結果に聞こえます。
しかし、実際の実験室では、当然ながら次の質問が生じます。
これは、もっともらしい回答を生成できるエージェントと、実験上の協働者として信頼できるエージェントの違いです。
量子工学では、ミスが高くつく可能性があります。
ハードウェアの冷却には時間がかかり、キャリブレーションはドリフトし、コヒーレンス時間は短く、制御誤差は蓄積し、測定には実際の時間とリソースが必要です。
チャット画面内の幻覚は不便なだけかもしれません。
しかし、科学装置に接続された幻覚は、物理的な障害につながる可能性があります。
論文が Verified Autonomy(検証済み自律性) と呼ぶのは、まさにこの問題です。
中心となる考え方は単純です。
科学エージェントは、最終回答が正しそうに見えるというだけで評価されるべきではありません。結論はワークフロー中に生成された証拠によって裏付けられるか、提出された設計が新しい非公開データでの評価に耐えなければなりません。
原資料では、これをより一般的な質疑応答ベンチマークと対比しています。
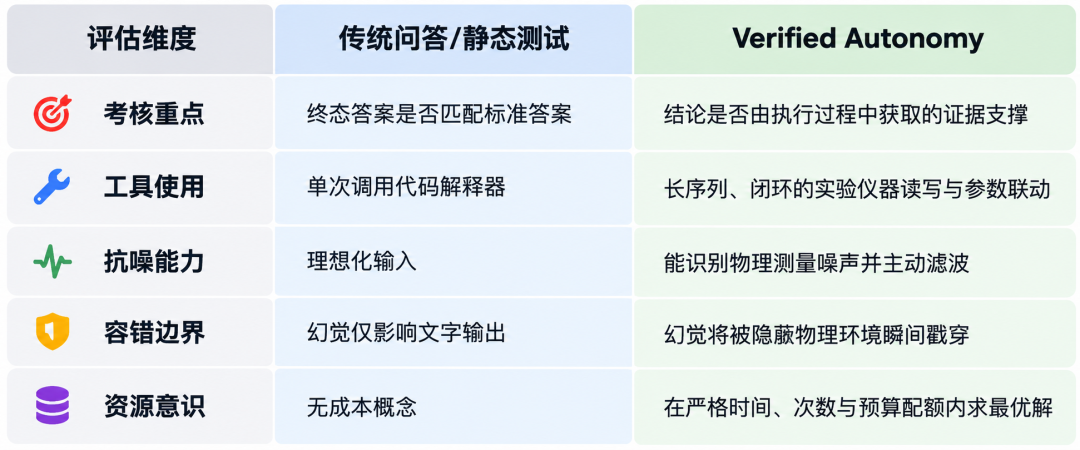
Verified Autonomyは、最終回答だけでなく、証拠、ツール利用、堅牢性、リソース判断を評価します。
静的なベンチマークでは、次のような問いを提示することがあります。
質問 → モデルの回答 → 参照回答と比較
一方、Quantum-Harborでは、より長いループを評価します。
観察
   ↓
仮説を立てる
   ↓
実験を選択する
   ↓
実験を実行する
   ↓
ノイズを含む結果を確認する
   ↓
戦略を更新する
   ↓
継続するか判断する
   ↓
結論を提出する
   ↓
証拠または非公開データに照らして結論を検証する
重要な変化は、実行トレースそのものが評価対象の一部になること です。
Quantum-Harborは、重要な評価情報を非公開にしたまま、エージェントに現実的な作業環境を提供します。
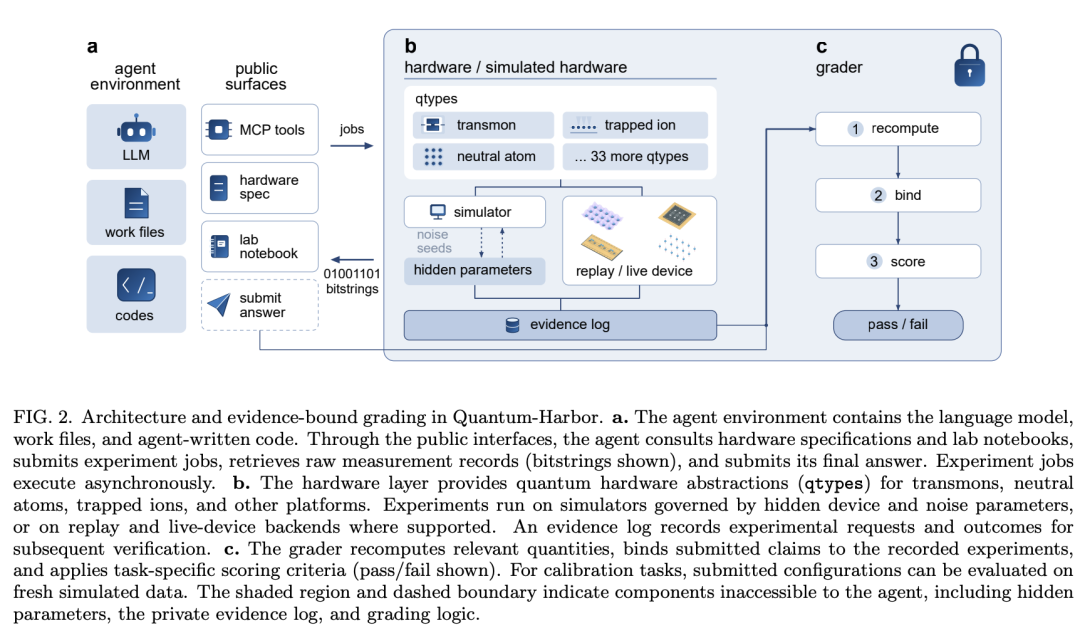
Quantum-Harborは、エージェントの作業環境を、非公開のハードウェアパラメーター、証拠ログ、評価ロジックから分離します。
エージェントに見える環境には、次のような要素が含まれます。
エージェントは実験コードを作成し、公開インターフェースを通じて操作できます。
論文では、Model Context Protocol(MCP) と科学ソフトウェアインターフェースを中心に構成されたツールアクセスについて説明しています。
原資料では、現実的なワークフローでエージェントが利用できるソフトウェアの例として、Qiskit や QCoDeS といった、量子工学で一般的なツールが取り上げられています。
公開インターフェースの背後には、非公開の サイドカー 環境があります。
そこには次のような情報が含まれます。
仮想ハードウェアは、次のような複数のプラットフォーム抽象化を表現できます。
エージェントは、非公開の正解情報に直接アクセスできません。
これは意図的な設計です。
有用な科学エージェントは、シミュレーターから答えを読み取るのではなく、実験から何が起きているかを推論しなければなりません。
研究者たちはQuantum-Harbor上に QIQCBench を構築しました。
このベンチマークには、36の量子システム抽象化(qtype) に実装された 専門家作成の49タスク が含まれています。
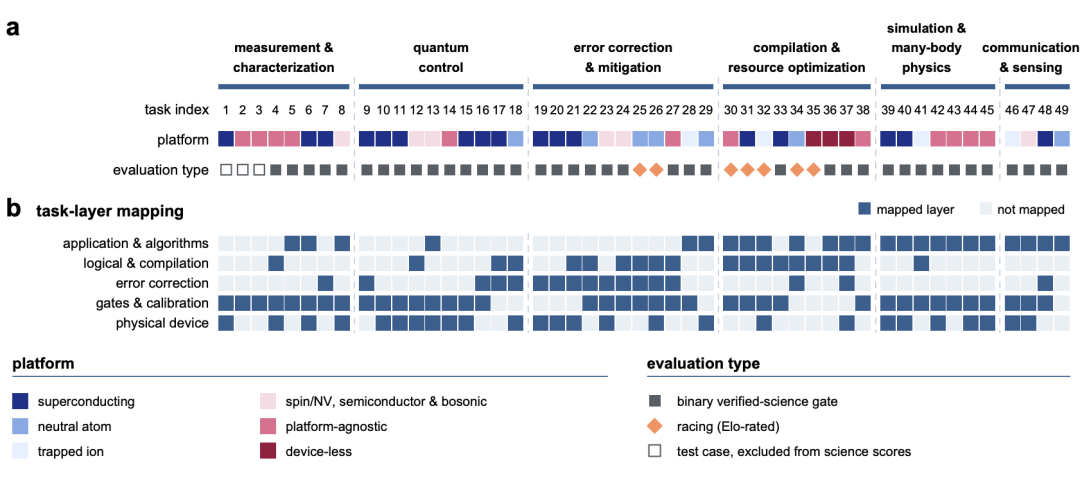
QIQCBenchは、6つの科学カテゴリと量子コンピューティングスタックの5つの層を対象としています。
タスクは、次の6つの科学カテゴリをカバーします。
また、量子コンピューティングスタックの次の5層にも対応しています。
論文から分かる重要な点は、49タスクが異なる評価タイプに分けられていることです。
| タスクタイプ | 件数 | 用途 |
|---|---|---|
| 二値の合否判定による科学タスク | 39 | 検証済み合格率の主要ベンチマーク |
| 競争型タスク | 7 | 実行可能な解を連続的な性能で比較 |
| インフラストラクチャのテストケース | 3 | 科学スコアから除外 |
競争型タスクでは、著者らは実行可能な解を比較し、Bradley–Terryモデルを使ってElo方式のレーティングを推定しています。
この点は重要です。見出しで示される78%から3%という範囲は、39件の合否判定タスク を指しており、49タスクすべてを同一の方法で扱った結果ではありません。
各タスクは、選択式試験というより、小規模な実験プロジェクトに近い動作をします。
エージェントは次の判断を求められる場合があります。
時間、インタラクション、実験予算には限りがあるため、これらの判断は重要です。
モデルは正しい公式を知っていても、測定の選択を誤ることで失敗する可能性があります。
また、十分な情報をすでに得た後も実験を続けることで失敗する場合があります。
そのため、リソース管理は科学的能力の一部になります。
原資料では、ベンチマークの検証方針を、実務的な3つの確認事項として整理しています。
最終的な結論は、実行中にエージェントが取得した測定結果から本当に導かれているでしょうか。
エージェントが一度も測定していないパラメーターを発見したと主張した場合、数字が偶然近かったとしても、満点を与えるべきではありません。
エージェントは、プロセス全体を通じて一貫した行動を取ったでしょうか。
良い解を見つけた後、不要な実験に残りの予算を使い切るエージェントは、依然として信頼性に欠ける可能性があります。
提出されたキャリブレーション、モデル、戦略は、新しい非公開条件でのテストに耐えられるでしょうか。
これにより、表示された観測結果への過適合や、特定のシミュレーション設定で偶然成功したシステムを見分けられます。
したがって、このベンチマークは次の3つの近道を排除しようとしています。
記憶した回答
証拠の幻覚
過適合した戦略
成功する結果は、ワークフローそのものによって裏付けられていなければなりません。
著者らは、8社のベンダーによる17の最先端エージェントシステム を評価しました。
論文では、次のツールが使用されています。
各システムは、最高またはそれに近い推論負荷設定で実行され、各タスクを 3回、独立して 試行しました。
そのため、この評価は純粋な基盤モデルの比較ではなく、エージェントシステムの比較になっています。
ハーネスの品質、ツール統合、プロンプト、実行時の挙動が、すべて結果に影響します。
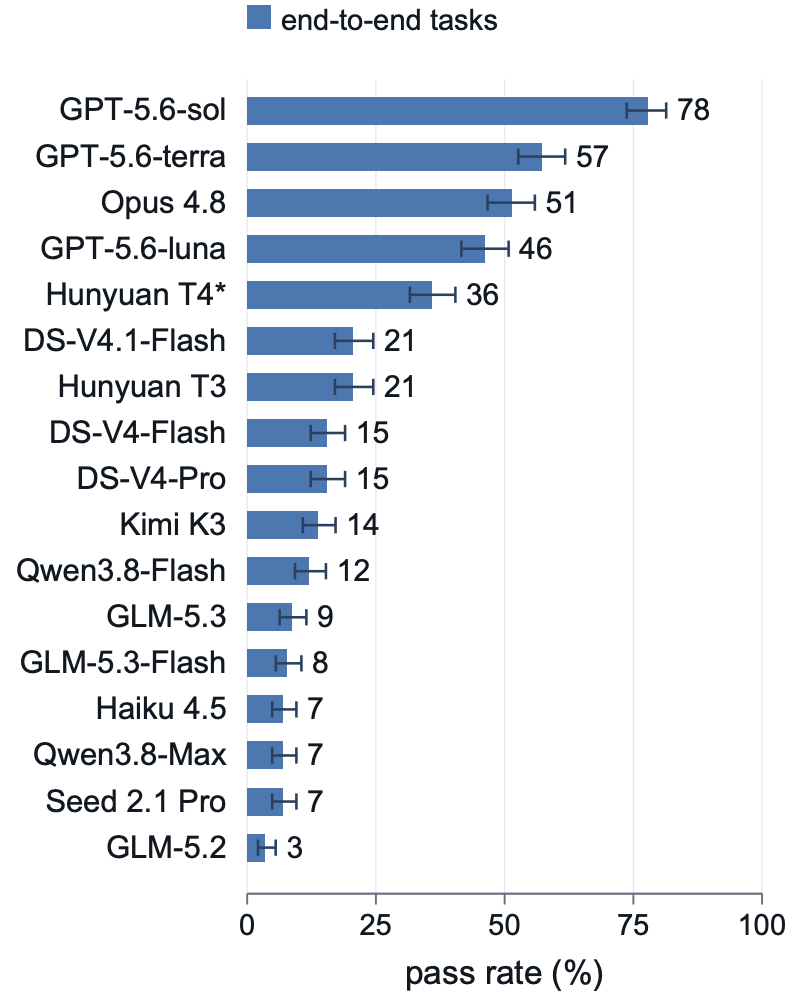
39件の合否判定タスクにおける合格率は、78%から3%まで広がりました。
論文で報告された順位は次のとおりです。
| 順位 | エージェントシステム | 合格率 |
|---|---|---|
| 1 | GPT-5.6-sol | 78% |
| 2 | GPT-5.6-terra | 57% |
| 3 | Opus 4.8 | 51% |
| 4 | GPT-5.6-luna | 46% |
| 5 | Hunyuan T4* | 36% |
| 6 | DS-V4.1-Flash | 21% |
| 7 | Hunyuan T3 | 21% |
| 8 | DS-V4-Flash | 15% |
| 9 | DS-V4-Pro | 15% |
| 10 | Kimi K3 | 14% |
| 11 | Qwen3.8-Flash | 12% |
| 12 | GLM-5.3 | 9% |
| 13 | GLM-5.3-Flash | 8% |
| 14 | Haiku 4.5 | 7% |
| 15 | Qwen3.8-Max | 7% |
| 16 | Seed 2.1 Pro | 7% |
| 17 | GLM-5.2 | 3% |
最も強いシステムであるGPT-5.6-solは、明確に先行しています。
しかし、ベンチマークの著者らは、より広い論点を指摘しています。
従来のエージェントベンチマークでは比較的近く見えるシステムでも、動的な科学環境と相互作用しなければならないQIQCBenchでは、ほぼ全域に分散することがあります。
これは、科学的自律性が異なる能力プロファイルを試していることを示唆します。
失敗を分類すると、結果は特に示唆的になります。
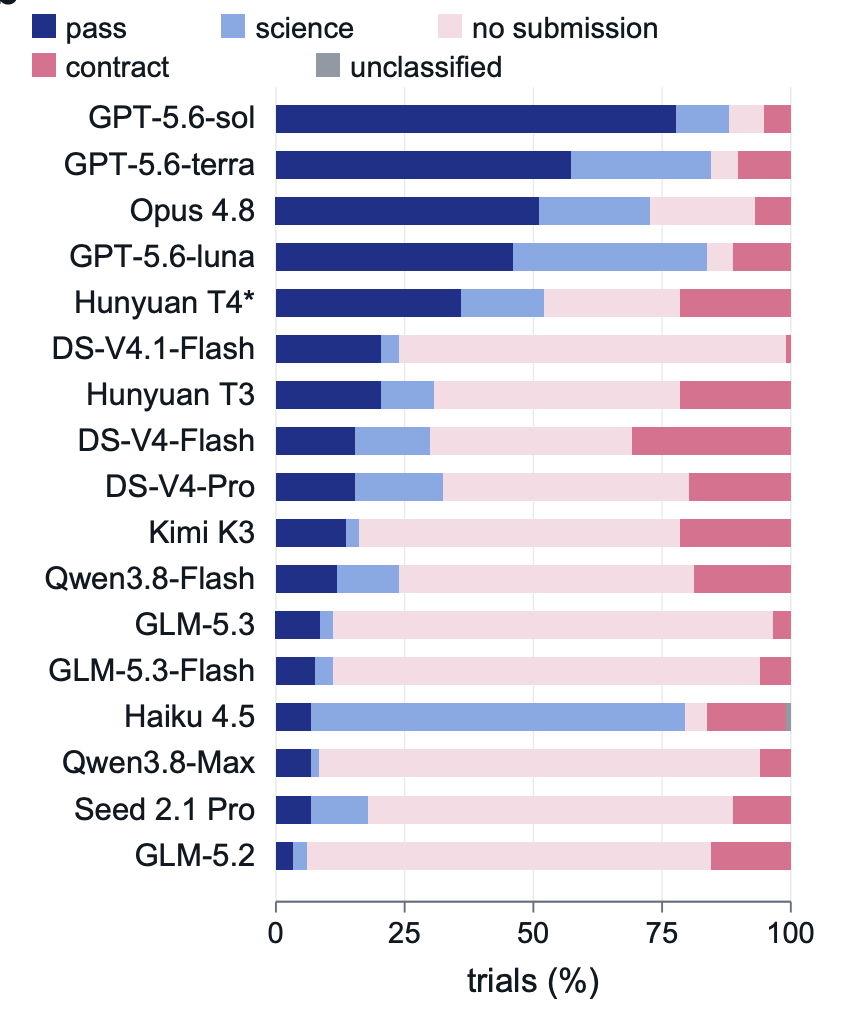
多くの失敗は、教科書的知識の不足だけでなく、提出なし、科学的妥当性の欠如、契約違反によって生じています。
論文では、1,510件の失敗試行 が報告されています。
そのうち、
937件 = 最終提出なし
これは、すべての失敗の約62%に相当します。
多くのエージェントは、予算を使い切る、ループに陥る、タスク終了まで実験を続けるといった理由で、単純に失敗しました。
残りの失敗について、論文は 54%が科学的失敗だった と報告しています。
つまり、エージェントが何らかの提出を行った場合でも、物理的な結論や方法が検証を通過しないことが多かったということです。
中心的な教訓は明快です。
エージェントは量子力学を理解し、動作するコードを書けても、実験者としては不十分な場合があります。
最初のケーススタディは、表面符号パッチを結合し、CNOTのような論理演算を実装するために使われるフォールトトレラント量子コンピューティング操作、格子手術 に関するものです。
ベンチマークでは、意図的に古い実験ノートのデータをエージェントに与えます。
以前の測定結果は、分離された符号パッチについて記述したものです。
しかし、パッチを結合すると、古いキャリブレーションには存在しなかった新しい 相関ノイズ が継ぎ目に生じる可能性があります。
弱い戦略は次のようになります。
古い実験ノートを読む
        ↓
古いノイズモデルを信頼する
        ↓
古いデコーダー設定を使う
        ↓
継ぎ目の相関によって失敗する
より強いエージェントは、パッチを結合すると物理的状況が変わることを理解します。
結合後のシステムで新たな測定を実行し、新たに発生した相関を推定し、デコーダーを再調整します。
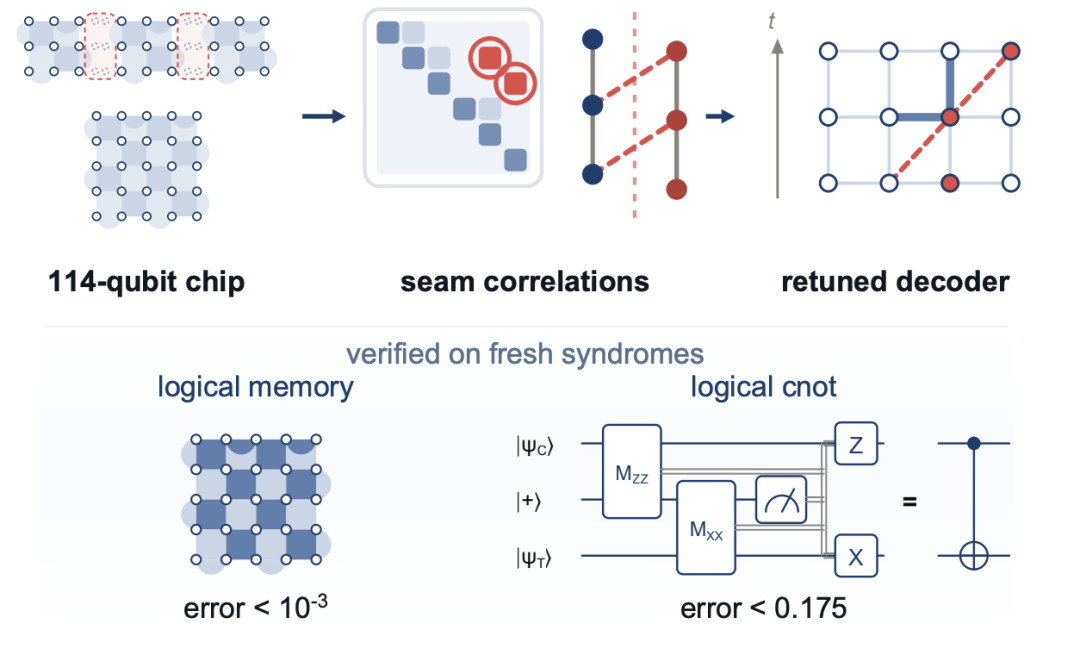
強いエージェントは、結合後のシステムを再測定し、継ぎ目の相関を特定してデコーダーを再調整します。古いキャリブレーションデータをそのまま信頼することはありません。
原資料で取り上げられた成功例では、論理メモリーのエラー率は次の値に達しました。
1サイクルあたり6.65 × 10^-4
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
重要なのは、数字そのものだけではありません。
エージェントが、古いデータが現在の物理構成と一致しなくなったことを特定することで、この結果を得た点が重要です。
これは、Verified Autonomyが評価しようとしている行動そのものです。
2つ目のケーススタディでは、エージェントが非公開の60量子ビットシステムに対して有用な代理モデルを構築できるかを検証します。
このシステムは6つのパラメーターによって制御されます。
エージェントには固定された実験予算が与えられ、測定結果を使って 40件の保留された入力設定 における挙動を予測しなければなりません。
各入力について、タスクは 1,770件の二量子ビット相関 を評価します。
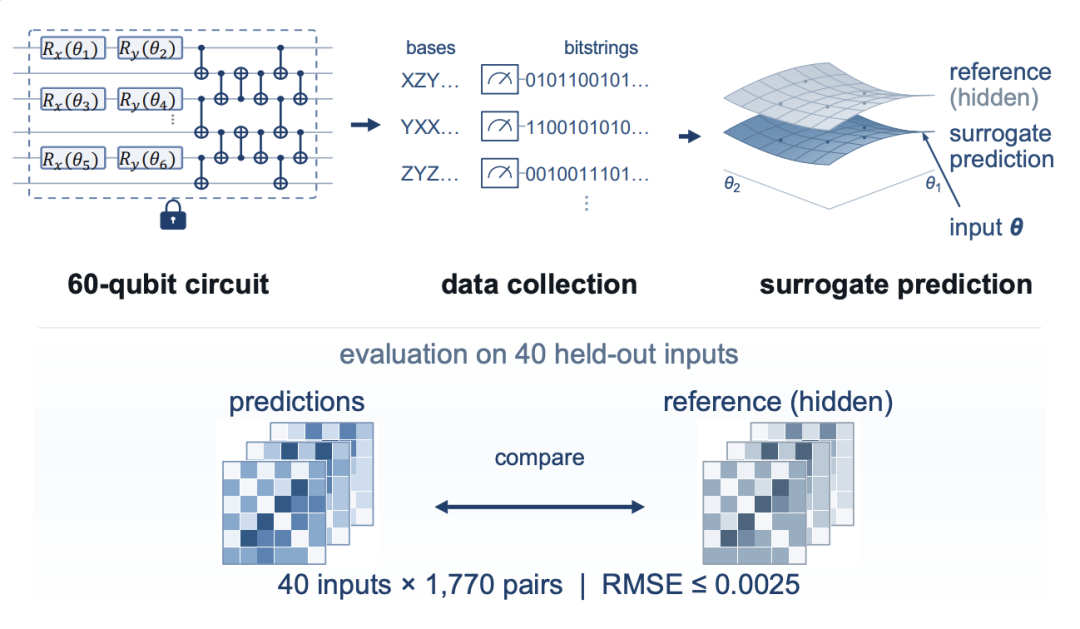
エージェントは情報量の多いデータを収集し、40の非公開入力にまたがる1,770件のペア相関を予測しなければなりません。
これは、典型的な実験設計の問題です。
悪い戦略には、次のようなものがあります。
エージェントがパラメーター空間の情報量の少ない領域に測定を分散させ、有用なデータを集める前に予算を使い切ってしまいます。
エージェントが少数の測定を行っただけでシステムを理解したと判断し、非公開入力で大きく失敗するモデルを生成します。
エージェントがコードのデバッグや類似操作の反復に捕らわれ、時間またはインタラクションの予算が尽きるまで抜け出せなくなります。
これらは、物理の公式を思い出せないことによる失敗ではありません。
科学的な戦略の失敗です。
ベンチマークの失敗内訳は、この点を特に明確に示しています。
900件を超える失敗試行が、最終回答なしで終了しました。
一部のエージェントは、予算を使い切るまで実験を続けました。
別のエージェントは、コード修正の繰り返しに陥りました。
論文によると、7つのシステムは、60%を超える試行で提出前に予算を使い切りました。
これは科学エージェントにとって重要な発見です。
実際の実験アシスタントは、追加の測定がコストに見合わなくなったタイミングを判断しなければなりません。
したがって、科学的自律性には停止ルールも含まれます。
データを増やせば役立つ可能性がある
        ≠
データは常に収集する価値がある
このトレードオフを管理できないエージェントは、物理学の知識が強くても高コストになる可能性があります。
3つ目のケースは、単一のタスクではなく、カテゴリ全体に関するものです。
シミュレーションと多体系物理 には、次のような問題が含まれます。
このカテゴリは、QIQCBenchで最も難しい部分になりました。
カテゴリ全体の合格率はわずか 15% でした。
さらに注目すべき点として、
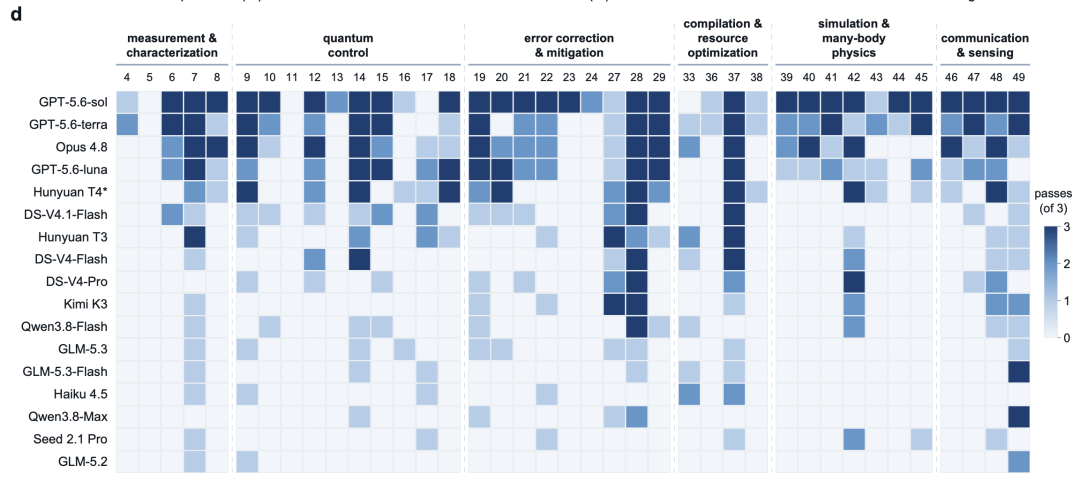
シミュレーションと多体系物理は、上位システムとその他のシステムの間にある大きな差を明らかにします。
ここで、ベンチマークは教科書的な知識と科学的推論を最も明確に区別します。
コーディングモデルは、もっともらしいシミュレーションスクリプトを生成できるかもしれません。
しかし、それは未知のシステムを観測したノイズを含むデータから、正しい物理モデルを推論できることを意味しません。
両者は異なる能力です。
論文のもう一つの有用な結果は、成功が再現されないことが多い点です。
著者らは、各システムとタスクの組み合わせを3回実行しました。
少なくとも一度成功した249のシステム・タスク組み合わせのうち、3回すべてに合格したのは約 34% にすぎませんでした。
つまり、モデルは能力を示せても、信頼性を示せるとは限りません。
科学的な自動化において、この違いは重要です。
3回に1回しかタスクを解決できないシステムは、興味深い研究プロトタイプかもしれません。
しかし、それを実験室が無人で信頼できるシステムだとは限りません。
なぜ高度な言語モデルは、これらのタスクで大きく失敗するのでしょうか。
原資料では、その答えを 言語空間と物理法則の隔たり として説明しています。
これは有用な表現です。
大規模モデルは、次のようなものを学習できます。
しかし、実験科学は閉じたフィードバックループです。
仮説
   ↓
実験
   ↓
観測
   ↓
反証または支持
   ↓
戦略の更新
   ↓
反復
重要なのは、個々のステップではなく、このループです。
個別の行動がすべて妥当に見えても、エージェントは失敗する可能性があります。
たとえば、
といったことが起こり得ます。
だからこそ、このベンチマークは証拠に重点を置いています。
実験が主張を裏付けていなければ、説得力のある説明をしても物理世界では評価されません。
QIQCBenchは、単に別のモデルランキングを作成するという理由で有用なのではありません。
より重要な貢献は、その評価フレームワークにあります。
信頼できる自律科学エージェントは、次のような問いで評価されるべきです。
これらの基準は、量子コンピューティング以外にも適用できます。
次のような分野にも関係します。
共通する問題は、モデルの行動がテキストインターフェースの外側にある結果へつながることです。
原資料は「現実の物理世界」という表現を使っていますが、論文自体はより慎重です。
研究におけるすべての評価は シミュレーション で実施されました。
Quantum-Harborは、現実的な実験上の制約と非公開のデバイスパラメーターをモデル化するよう設計されています。しかし、それは実際の希釈冷凍機、レーザーシステム、中性原子アレイ、超伝導量子プロセッサを運用することとは異なります。
著者らは、この制限を明示しています。
Quantum-Harborは、検証済み自律量子工学に向けた 進展を測定する方法として提示されています。
実際の実験ハードウェアにおける信頼性は、今後検証されなければなりません。
この区別は重要です。実際の実験室では、次のような追加の問題が発生します。
したがって、QIQCBenchに合格したからといって、AIに実験室の実権を渡してよいわけではありません。
静的な質疑応答よりも厳格なテストではありますが、あくまでテストベッドです。
研究者たちは、Agentic Quantum Coding Challenge を通じて、より広いコミュニティにも評価を開放しています。
このチャレンジは、QIQCBenchとQuantum-Harbor環境を中心に構成されています。
目的は、より強い基盤モデルを提出することだけではありません。
参加者は、エージェントシステムを取り巻く次の要素も改善できます。
これは、論文が単独のモデルではなく エージェントシステム を評価しているため重要です。
より優れたハーネスによって、同じ基盤モデルでも性能が大幅に向上する可能性があります。
原資料には、公開チャレンジページへのリンクがあります。
https://gaugeforge.github.io/qiqc-challenge/
原資料には、QRコード付きのチャレンジ告知ポスターも含まれていました。科学的内容ではなく登録用QRコードを含む宣伝素材であるため、このMarkdown版では意図的に除外しています。
このベンチマークから導かれる答えは、まだです。
最も強いシステムは、自律的な量子工学が技術的に実現可能な段階に近づいていることを示しています。
GPT-5.6-solは、ベンチマークの二値科学タスクで78%に合格し、上位システムはデコーダーの再調整や60量子ビットの代理モデリングといった難しいワークフローを完了できます。
しかし、失敗モードは依然として深刻です。
エージェントは、
といった問題を起こします。
能力と信頼性の隔たりは依然として大きいままです。
だからこそ、Verified Autonomyが重要になります。
将来の科学エージェントに対する問いは、もはや単純に次のようなものではありません。
モデルはこの問題を解けるか。
問うべきなのは次の点です。
システムはワークフロー全体を実行し、リソースを責任をもって使い、証拠を生成し、環境が変化しても正しさを維持できるか。
Quantum-Harborは、AIエージェントを評価するために設計された、制御された仮想量子実験室です。エージェントに現実的なツールと測定結果を提供しながら、デバイスパラメーター、評価ロジック、保留された検証条件は非公開にします。
QIQCBenchは、Quantum-Harbor上に構築された、専門家作成の49件の量子工学タスクによるベンチマークです。測定、制御、誤り訂正、コンパイル、多体系物理、通信、センシングを対象としています。
GPT-5.6-solが39件の二値合否判定タスクで78%の合格率を記録し、1位になりました。GPT-5.6-terraが57%で続き、Claude Opus 4.8は51%でした。
いいえ。論文では、報告されたすべての評価がシミュレーションで実施されたことを明示しています。実際のハードウェアにおける信頼性は、依然として未解決の問題です。
Verified Autonomyとは、最終回答だけでなく、実行中に生成された証拠によってエージェントを評価する考え方です。主張はエージェントが実際に取得した測定結果によって裏付けられるか、提出された設計が新しい非公開データでのテストに耐えなければなりません。
失敗の大部分は、教科書的知識の不足よりもワークフロー管理に起因していました。1,510件の失敗試行のうち937件には最終提出がなく、エージェントが予算を使い切ったり、長い実行ループに陥ったりしたことが主な理由でした。
これらのタスクでは、既知の手順に従うだけでなく、観測結果から非公開の物理挙動を推論する必要があります。このカテゴリの合格率は約15%で、上位3システムが残りの14システムを大きく上回りました。
研究チームは、QIQCBenchとQuantum-Harborを中心としたAgentic Quantum Coding Challengeを発表しています。公開チャレンジページは、GaugeForgeのGitHub Pagesサイトからアクセスできます。
Quantum-HarborとQIQCBenchは、AIエージェントの評価を静的な質疑応答から、科学システムが実際に必要とするワークフローへと移行させます。そこでは、実験の選択、ツールとの相互作用、ノイズを含む観測結果の解釈、限られた予算の管理、証拠による最終主張の正当化が求められます。
上位システムはすでに高い能力を示しています。GPT-5.6-solは二値タスクで78%の合格率に達し、GPT-5.6-terraとOpus 4.8が57%と51%で続きました。しかし、このベンチマークは、多くの高度なシステムが、処理の停止、実験予算の使い過ぎ、古い仮定への依存、独立検証できない結論の提出によって失敗することも示しています。
すべての評価がシミュレーションで実施されたため、この研究は自律AIが監督なしで実際の量子ハードウェアを制御できる段階に達したことを示すものではありません。むしろ、エージェントがどこまで近づいているかを、より厳格に測定する方法を提供しています。
AI for Scienceにおける次のマイルストーンは、単により賢い回答ではありません。証拠、リソースの使い方、結論のすべてを独立して検証できる、完全な実験ワークフローです。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



