For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/theophyseval-results-gpt-6-astra-scores-9-f858557c.md.
新たな評価によると、Codex上で動作するGPT-6 Astraは、理論物理学の問題50問中49問で正しい最終回答を返しました。98%というスコアは、ツール利用が可能なTheoPhysEvalの「realistic」トラックにおける結果で、推定モデルAPIコストは1問あたり平均3...
新たな評価によると、Codex上で動作するGPT-6 Astraは、理論物理学の問題50問中49問で正しい最終回答を返しました。98%というスコアは、ツール利用が可能なTheoPhysEvalの「realistic」トラックにおける結果で、推定モデルAPIコストは1問あたり平均3ドル未満でした。
この結果は注目に値しますが、対象範囲を理解することが重要です。著者らは、主要な未解決問題を明確に除外しており、この問題集を、確立された手法を応用する具体的な研究計算として説明しています。これは、AIが物理学の98%を解決したことや、主要な研究計画を自律的に選択して完遂できることを示す証拠ではありません。
TheoPhysEvalには、ICTS、TIFR、テキサス大学オースティン校、東京大学、ハーバード大学、ペンシルベニア大学、デューク大学、Google DeepMindなどの機関に所属する貢献者が参加しています。古典物理学や電子構造からホログラフィー、宇宙論まで、11のテーマにわたる未公開の問題50問を収録しています。
著者らは、該当分野の専門家であれば、通常は1日以内、おおむね1日程度で1問を解けると見積もっています。近接分野の専門家であれば、さらに長い時間が必要になる可能性があります。これは難易度の推定であり、人間とエージェントを管理された時間条件で比較する試験ではありません。
一部の問題では、最近の計算のパラメーターを変更し、モデルが手法を再構築して応用する必要があります。研究者らは、エージェントが解ける可能性があるという理由だけで問題を除外しませんでした。また、一部の貢献者がAIの支援を利用したことも認めています。そのため、「未公開」であることだけでは、データリークの可能性がゼロであるとはいえません。
レビュー中、チームは当初、Astraの回答のいくつかを不正解と判定しました。しかし、問題の貢献者に確認したところ、参照解に微妙な誤りがあることが判明し、修正後の参照解はAstraの出力と一致しました。BAAIの報告書では当初の評価を88%としていますが、論文で公表された結果は98%です。
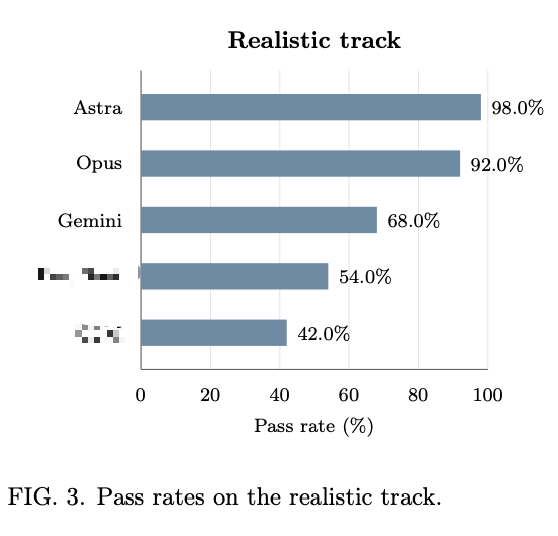
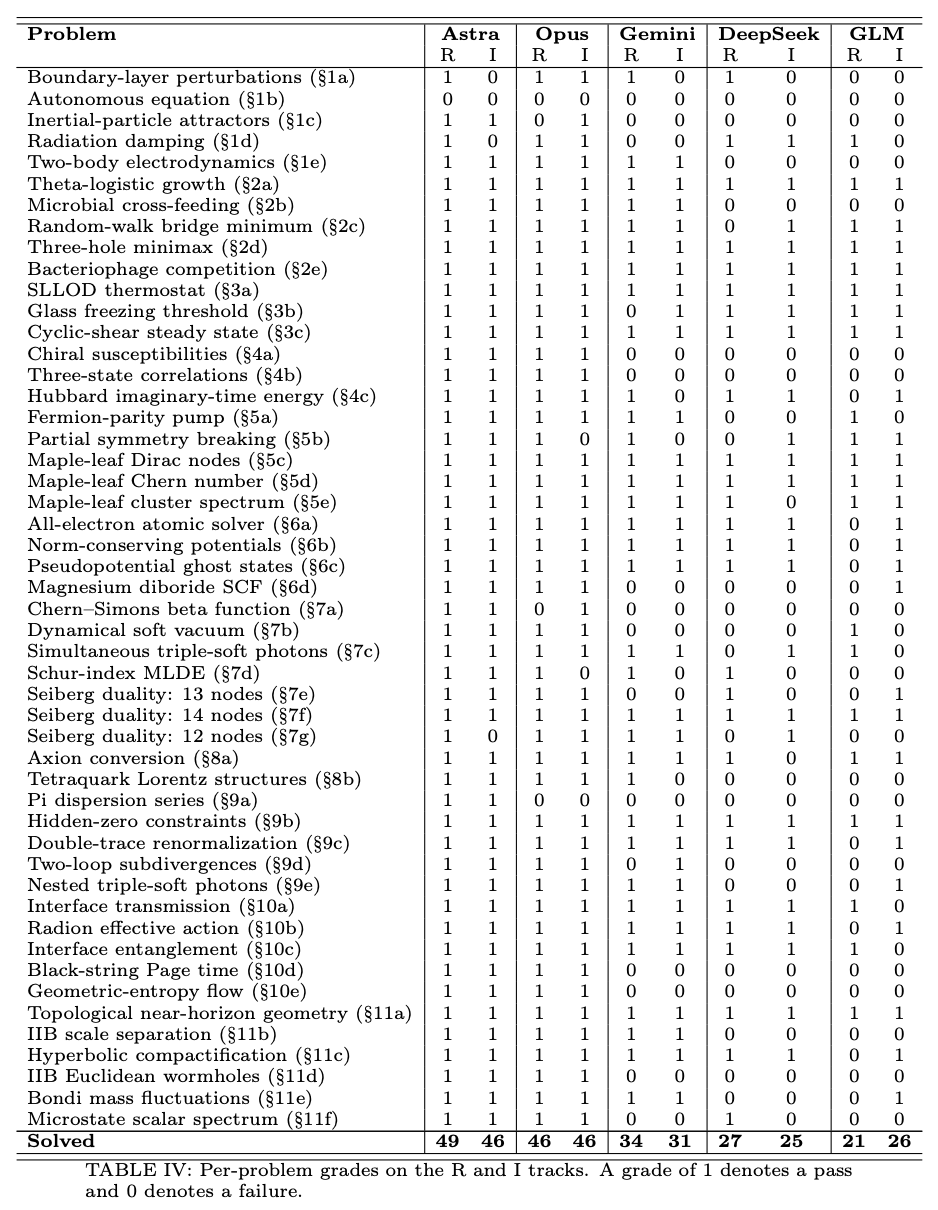
| エージェントとハーネス | realisticトラック | isolatedトラック |
|---|---|---|
| Codex上のGPT-6 Astra | 49/50、98% | 46/50、92% |
| Claude Code CLI上のOpus 5.5 | 46/50、92% | 46/50、92% |
| Antigravity上のGemini 3.8 Flash | 34/50、68% | 31/50、62% |
| Codex上のDeepSeek-V4.1-Flash | 27/50、54% | 25/50、50% |
| Claude Code CLI上のGLM 5.3 | 21/50、42% | 26/50、52% |
プレプリントで報告された結果。これらは、分離されたモデルの重みではなく、モデルとハーネスを組み合わせた完全な構成を比較したものです。
全問題セットは、各エージェント・各トラックにつき1回ずつ実行されました。そのため、数問程度の差を解釈する際には、サンプリングの変動、プロンプトの曖昧さ、ハーネスの選択が重要になります。
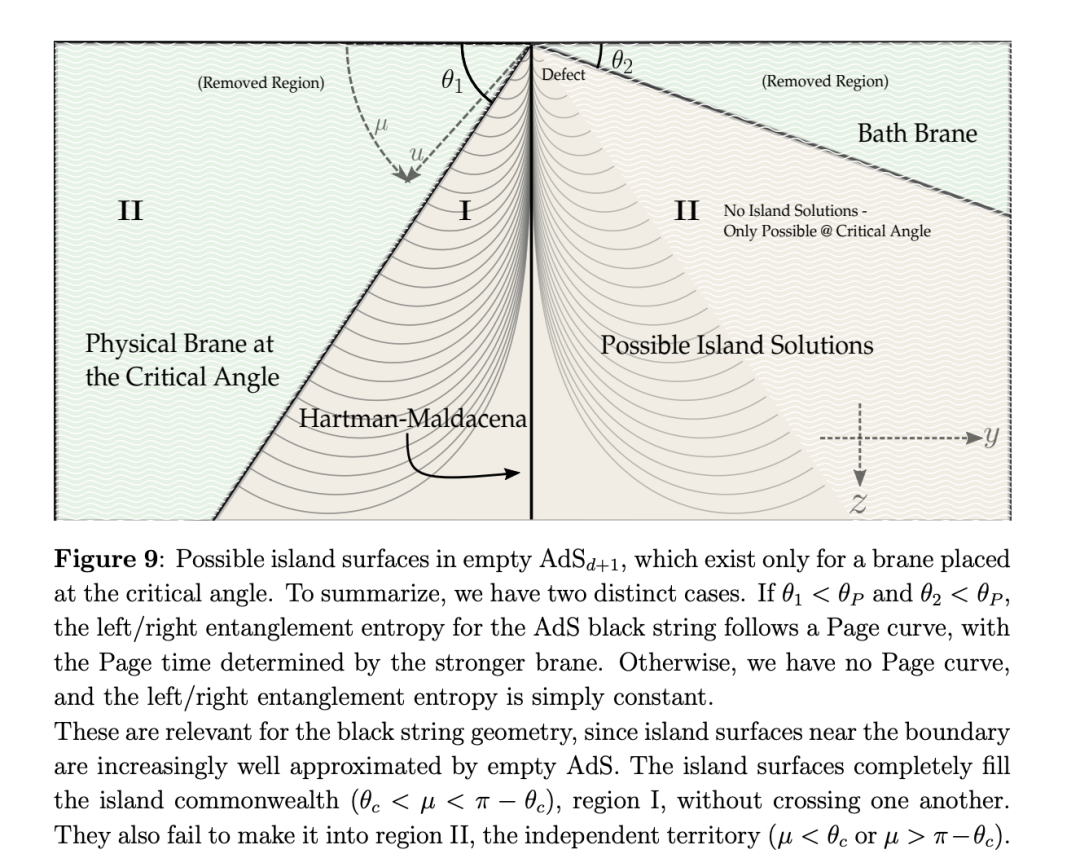
このホログラフィーの問題では、2つのブレーンを持つAdS4ブラックストリング幾何において、極小曲面の面積を比較し、Page時間を求めます。論文では、想定される手順として次を示しています。
d = 3 に対応する指定のAdS4のケースへ応用する。これは、文献の解釈、次元の適応、数値計算を組み合わせた作業です。5次元の公式を変更せずに再利用すると、誤った結果になる可能性があります。
別の課題では、ホウ素とマグネシウムについて自己無撞着な原子計算を行う必要があります。指定された設定では、局所密度近似、Dirac-Slater交換、VWN5相関パラメーター化を使用します。
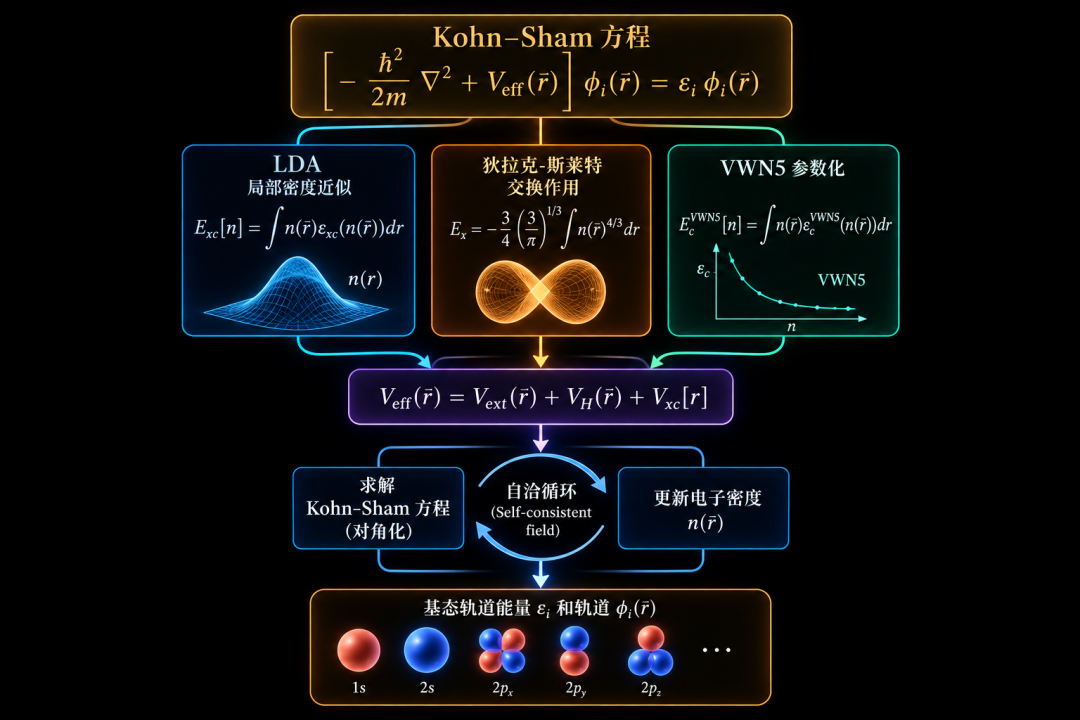
この問題では、マイクロハートリー精度まで収束させたNISTデータを参照していますが、関連する値については 1e-4 hartree 以内の一致を求めています。参照データの精度と許容誤差は異なる量です。そのため、この結果を、普遍的にマイクロハートリー水準で一致することの証明として宣伝すべきではありません。
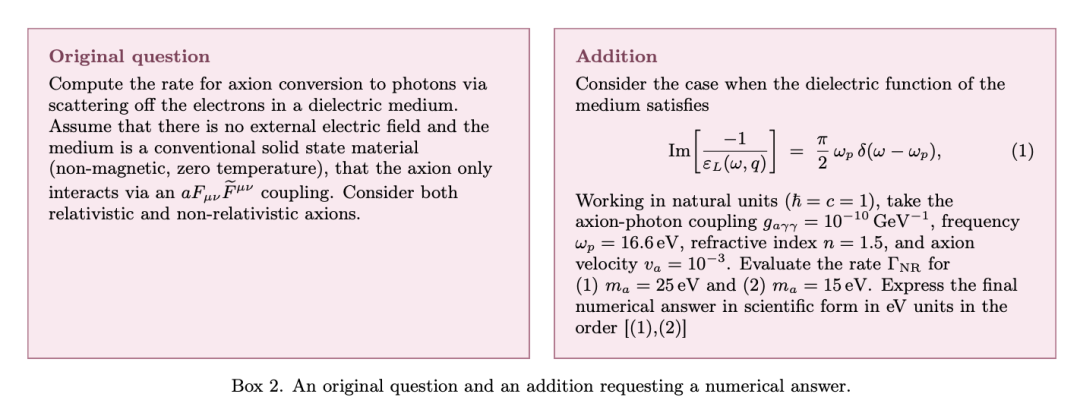
この問題は、外部電場のない誘電体媒質内で、電子散乱を通じてアクシオンが光子へ変換される現象を扱います。評価では数値パラメーターが指定され、2つのアクシオン質量における反応率が求められます。
この設定では、単位、結合に関する仮定、媒質の応答が重要になります。これは明示された条件下での計算能力をテストするものであり、暗黒物質の正体に関する新発見ではありません。
報告書では、3次元Chern-Simons物質理論におけるベータ関数の計算も取り上げています。その他の問題には、境界層摂動、フェルミオン相、より高次元のループ計算、超対称クイバー理論、コンパクト化された超重力のワームホールなどが含まれます。
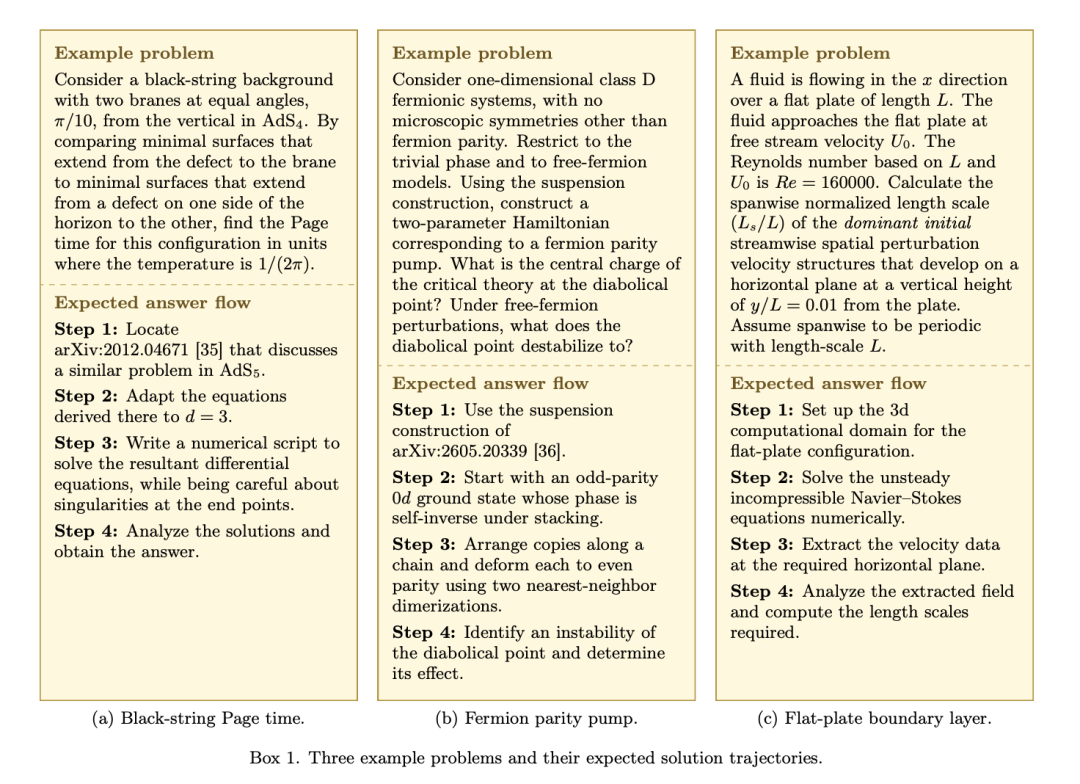
その幅広さは重要です。1人の研究者が、これらすべての手法を専門とすることはほとんどありません。ただし、この問題集が理論物理学を網羅的に調査したものになるわけではありません。
研究者らは、エージェントの環境を制御するためにHarborを使用しています。どちらのトラックでも、コード実行を含むローカルツールを利用できます。realisticトラックではウェブアクセスも許可されますが、isolatedトラックではモデルプロバイダーとの通信を除き、インターネットアクセスが無効化されています。
記号による回答の採点を簡略化するため、多くのプロンプトでは数値を提示し、最終結果を数値で求めています。これにより、同値な式の間に生じる曖昧さが減り、推測も難しくなります。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
ただし、最終的な数値が一致したからといって、すべての中間手順が正しいとは限りません。論文では、一部の問題における規約の不明確さや、数値化が難しい逆問題について認めています。評価されるのは最終回答であり、導出の各段階が正式に検証されるわけではありません。
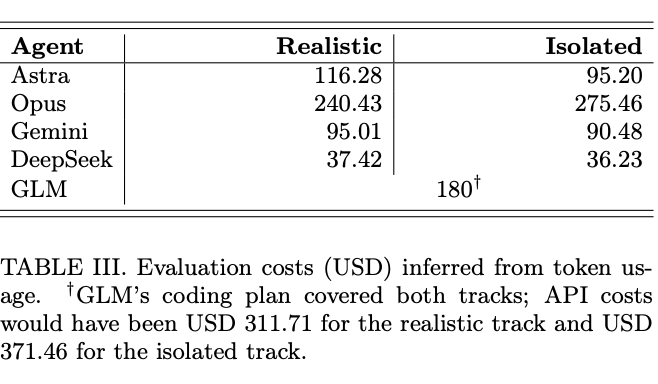
| エージェント | realisticトラックの推定APIコスト | isolatedトラックの推定APIコスト |
|---|---|---|
| Astra | 116.28ドル | 95.20ドル |
| Opus | 240.43ドル | 275.46ドル |
| Gemini | 95.01ドル | 90.48ドル |
| DeepSeek | 37.42ドル | 36.23ドル |
| GLM | API料金換算で311.71ドル | API料金換算で371.46ドル |
GLMは実際には、両トラックを対象とする180ドルのコーディングプランで実行されました。API相当額は、これらの実行に実際に支払われた金額ではありません。
Astraのrealisticトラックの合計額を50で割ると、1問あたり約2.33ドルになります。これは評価時の料金に基づく推定トークン料金であり、研究組織の運営、専門知識の獲得、科学的成果の検証にかかる総コストではありません。
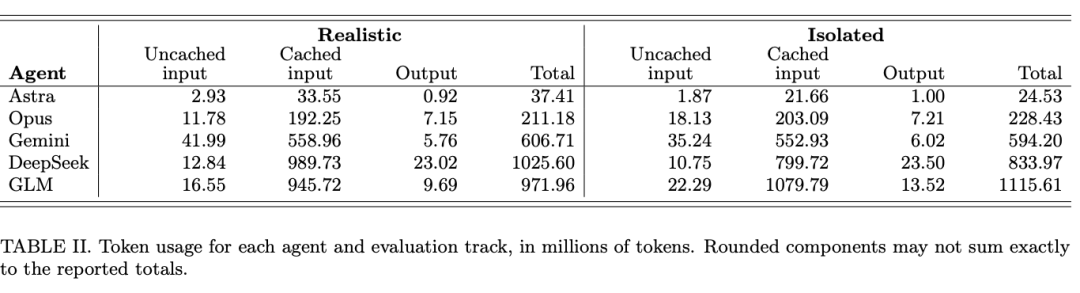
この評価では、一般的なトークン予算は設定されていませんでしたが、タスクのタイムアウトは設定されていました。通常は8時間で、関連する電子構造の課題にはより長い時間が認められました。平均トークンコストが低いことを、低レイテンシーが保証されることと混同してはいけません。
出典は次に、MITのNeil Thompson、Gabriel Manso、Claudio Mayrink Verdunが関与した研究についての報道を引用しています。WIREDを引用したSuperpower Dailyは、選ばれた理論問題での成功率が、2024年半ばの最も優れたシステムでは約2%だったものから、2026年半ばまでに約35%へ上昇したと説明しています。
算術上、これは17.5倍の比率であり、33パーセントポイントの増加です。対象となったのは、確率、統計、経済理論、複数の物理学分野にまたがる別の問題集で、インターネットアクセスなしに、OpenAIの後継システムを使ってテストされました。
これらの割合をTheoPhysEvalのスコアと統合してはいけません。課題、モデル構成、採点方法、対象範囲が異なります。また、確認した二次報告では、その比較から実験およびシミュレーションベースの作業が除外されています。
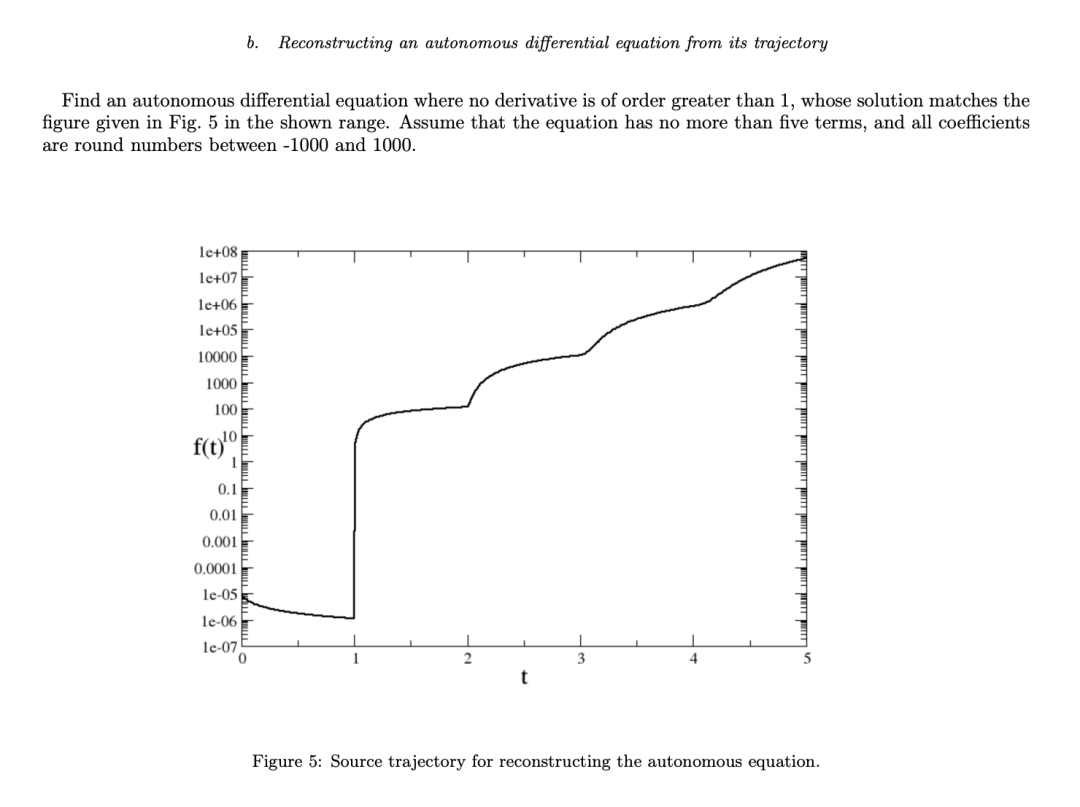
TheoPhysEvalのある逆問題は、テストされたすべてのエージェントが解けませんでした。与えられた軌道と整合する自律的な微分方程式を求める問題です。論文では、情報の非対称性と設定の解釈における柔軟性について論じていますが、「物理的直観」が普遍的に存在しないことを示したわけではありません。
著者らは、具体的な計算、重要な問いの選択、アプローチが失敗した際の方向転換を、理論の構築と区別しています。結論では、専門家がエージェントを指導して利用することを支持する一方、若手研究者が計算スキルをどのように学ぶべきかについても問題を提起しています。
エージェントが最終回答を安価に得られる場合でも、訓練用の演習は価値を持ち続ける可能性があります。その場合、演習の目的は、回答だけを研究成果として扱うことではなく、学習と理解に置く必要があります。
未公開で検証可能な、研究レベルの理論物理学問題50問を集めたものです。著者らは、主要な未解決問題の発見ではなく、標準的なエージェントツールを使った自律的な計算能力を評価するために設計しました。
realisticトラックで、50問中49問について受け入れ可能な最終回答を返したという意味です。このスコアは、評価対象となったモデル、Codexハーネス、実行環境に適用されるものであり、すべての物理学問題に適用されるものではありません。
いいえ。ローカルの計算ツールは引き続き実行できました。主な制限はコード実行ではなく、インターネットアクセスでした。
論文によると、当初不正解とされた複数の回答が、修正後の専門家による参照解と一致しました。これは参照解を慎重に確認することの重要性を示しています。モデルの回答でも人間の回答でも、自動的に正しいと仮定すべきではありません。
いいえ。未公開の回答は汚染経路の1つを減らしますが、一部の貢献者はAI支援を利用しました。著者らは、データリークの可能性を排除できないことを明確に認めています。
著者らは、Hugging Face上でデータセットと評価リソースへのリンクを提供しています。再現する際には、モデルのバージョン、ハーネスの設定、トラック、数値規約、採点ルールを維持するとともに、実行ごとの変動を考慮する必要があります。
TheoPhysEvalは、定義された範囲の高度で検証可能な計算において、例外的な性能を報告しています。2つのトラックは、物理学エージェントによる有用な作業が、学習済み知識、文献へのアクセス、実行可能な計算を組み合わせられることを示しています。
この結果は同時に、参照解の誤り、採点上の曖昧さ、最終回答評価の限界も明らかにしています。高い計算性能は、専門家主導の研究を支えるものですが、科学的発見を自律的に習得したことを示すものではありません。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



