For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/typesafe-jev-vs-openai-decisions-api-fast-7c48d620.md.
ある新しいAI企業が、エッセイやコード、親しみやすいチャット返信の作成を目指さないモデルを公開してから、わずか数週間で**8億7,000万ドル**を調達しました。
ある新しいAI企業が、エッセイやコード、親しみやすいチャット返信の作成を目指さないモデルを公開してから、わずか数週間で8億7,000万ドルを調達しました。
その企業はTypeSafe AIです。
モデルの名称はJevです。
TypeSafeは2026年10月9日、評価額75億ドルでシリーズAの調達を発表しました。Andreessen Horowitzが主導し、Sequoia Capital、既存投資家のDCVC、その他の投資家が参加しました。
同社の創業チームも注目を集めました。
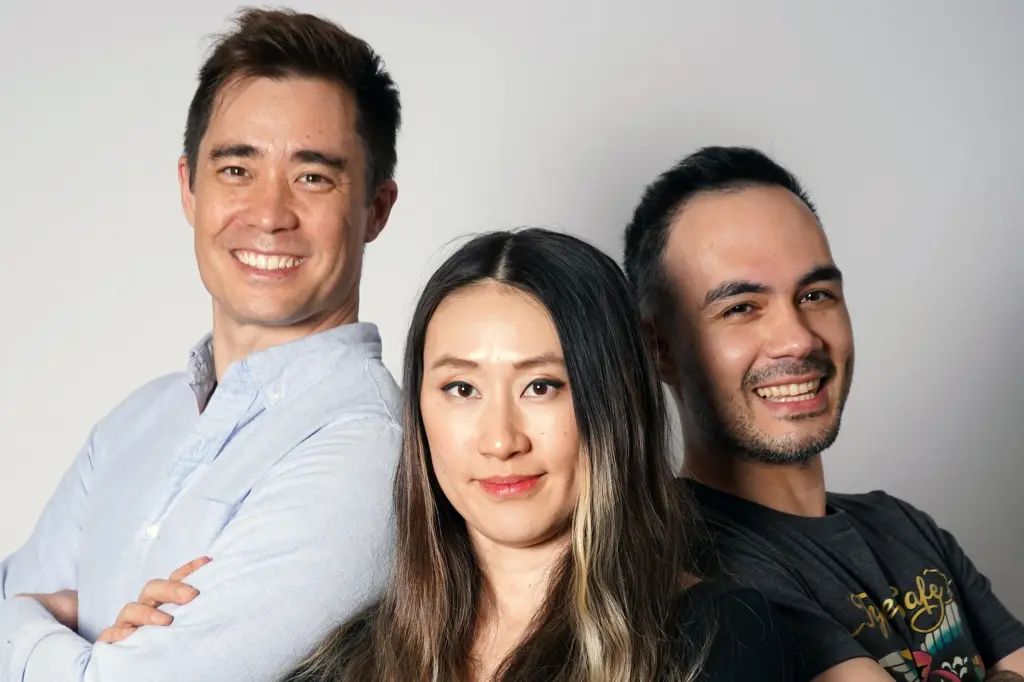
TypeSafeはErik Gafni、Sasha Sheng、Diogo Almeidaによって設立されました。Almeidaは以前OpenAIに勤務し、ChatGPT時代の指示追従システムの基盤となる研究の開発に携わっていました。Shengは以前Meta/FAIRに勤務し、Gafniはエンジニアリングとスタートアップ分野の経験を持っています。
Jevは9月15日に一般公開されました。
そのわずか2週間後、OpenAIは、長い生成テキストではなく、確率、選択肢、スコアを返す高速APIという、非常によく似た製品の方向性を限定プレビューとして発表しました。OpenAIはその製品であるDecisions APIを10月6日にパブリックベータへ移行しました。
OpenAIのAPIプロダクトリードであるNikunj Handaは後に、Jevがこの製品カテゴリーの着想になったと公に認めました。
そのため、Jevには2つの観点から興味深い意味があります。
第一に、ソフトウェア内でAIを利用する方法を変える提案であることです。
第二に、フロンティアラボに異例の速さで対応を迫ったことです。
Jevは、ユーザーが会話するAIを目指していません。
ユーザーが回答を見ることなく、ソフトウェアが数千回、数百万回呼び出せるAIを目指しています。
メールの受信トレイを開くと、何百もの小さな判断が待っています。
このメッセージは重要か。
まもなく期限切れになる請求書が含まれているか。
緊急の返信が必要か。
会議の時間は変更されたか。
アーカイブすべきか、エスカレーションすべきか、それとも無視すべきか。
汎用言語モデルは、すでにこのような質問に答えられます。
問題は、従来のLLMが言語を生成するように設計されていることが多い点です。
1通のメールだけなら、そのオーバーヘッドは問題にならないかもしれません。
しかし、大規模に運用すると問題になります。
アプリケーションが同じ種類の意思決定を1日に数千回、数百万回行う場合、レイテンシーとコストの小さな違いが、大きな運用費用になります。
Jevは、こうした反復的な判断に特化して設計されています。
TypeSafeはJevをSystem One Modelと説明しています。
これは、Daniel Kahnemanによって広く知られるようになった、速く直感的な「System 1」型の認知を指しています。
アプリケーションはJevに段落の生成を依頼するのではなく、状態情報と、あらかじめ定義した質問群を渡します。
Jevは次のような型付きの値を返します。
アプリケーションはその結果を直接利用できます。
簡略化すると、次のようなパターンです。
受信メール
      ↓
Jevが複数の質問を評価
      ↓
urgent_reply = 0.91
billing_related = 0.74
meeting_change = 0.03
      ↓
アプリケーションが独自のルールを適用
      ↓
アラート / アーカイブ / 振り分け / レビュー
重要な違いはインターフェースにあります。
汎用言語モデルでは、開発者はJSONなどの構造化形式での出力を求め、その後に生成された回答を検証することがよくあります。
Jevでは、型付きの意思決定結果そのものが中核的な製品設計になっています。
TypeSafeのAPIは1つのsystemoneエンドポイントを公開し、開発者は同じ共有状態に対して複数の質問を送信できます。
TypeSafeは並列的な意思決定を重視しています。
アプリケーションが同じ入力を複数の独立した基準で評価したい場合、それぞれを別の会話ターンにするのではなく、質問をまとめて送信できます。
これは、次のような質問に答える必要があるソフトウェアに役立ちます。
アプリケーションはその後、通常のコードを使って結果を組み合わせます。
このため、Jevはチャットボットというより、インテリジェントな条件文に近い印象を与えます。
TypeSafeは現在、Jevを次の価格で提供しています。
| 利用区分 | Jevの価格 |
|---|---|
| 入力 | 0.042ドル / 100万トークン |
| 出力 | 無料 |
TypeSafeによると、Jevは長いテキスト列を自己回帰的に生成するわけではないため、出力は計測するほどのコストがかかりません。
この価格が重要なのは、Jevが非常に頻繁に発生する可能性のある意思決定を対象としているからです。
ユーザーアクションごとに1回実行するには高すぎる意思決定でも、コストが一桁下がれば自動化が現実的になる可能性があります。
これにより、導入に関する問いも変わります。
これはAIモデルを呼び出すほど重要か?
ソフトウェアチームは、次のように考え始められます。
この小さなステップもAIに評価させない理由は何か?
これが製品の経済的な主張です。
見出しに使われるトークン価格は、本番環境のコストの一部にすぎません。
チームは次の項目も測定する必要があります。
安価な意思決定でも、誤りが多すぎれば高くつく可能性があります。
この点は、後述する独立したJev評価で重要になります。
Vercelは、Jevの公開直後にAI Gatewayへ追加しました。
初日の反応は異例の強さでした。
Vercelによると、24時間以内にJevは**有料AI Gatewayチームの約13%**で利用されました。
これは、同プラットフォームにおける過去のどのモデル公開時よりも、初日の到達率で2倍以上高い数字でした。
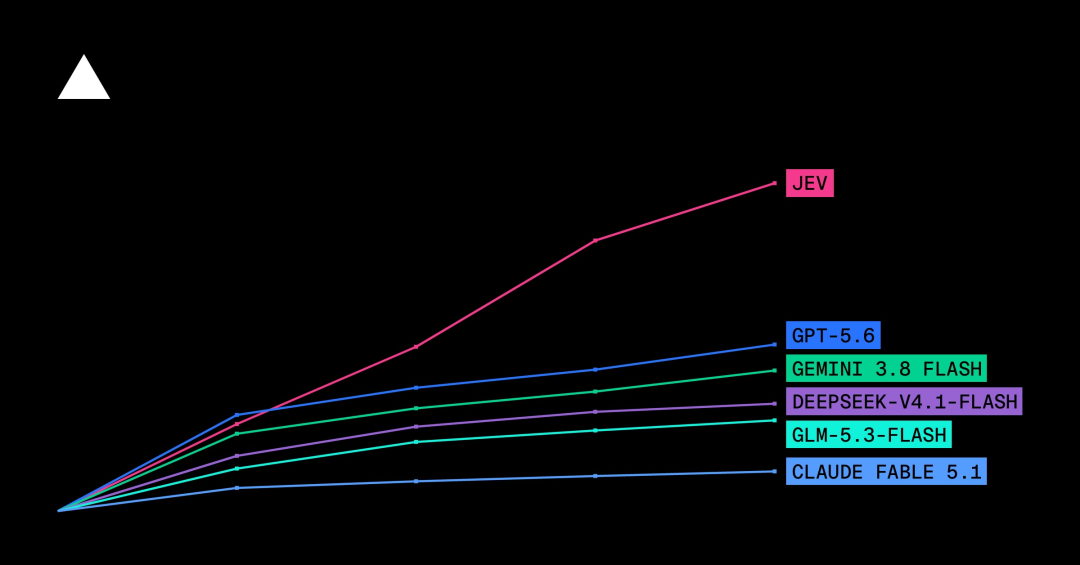
Vercelは後に、JevをAI Gateway史上、最も速く採用されたモデルと呼びました。
初日の急増は、長期的な継続利用を証明するものではありません。
しかし、狭い意思決定モデルが役立つ可能性のあるタスク群を、開発者がすぐに認識したことは示しています。
Vercelは次のような例を挙げています。
これらは華やかなタスクではありません。
しかし、本番ソフトウェアが常に実行しているのは、まさにこの種のタスクです。
Jevのアイデアは、一夜にして現れたものではありません。
Diogo Almeidaは、OpenAIで働いていた際、次の基本的な問いに強い関心を持つようになったと語っています。
AIが経済を変えるなら、将来、誰がモデルを最も多く呼び出すのか。
人間が手作業でチャットウィンドウを開くのか。
それとも、ソフトウェアがバックグラウンドで自動的に知能を呼び出すのか。
彼の答えは後者でした。
これにより、AIインターフェースが最適化すべきものも変わります。
人間向けのモデルは、自然な会話、柔軟な文章、説明、創造性から恩恵を受けます。
ソフトウェア向けのモデルは、次の要素から恩恵を受けます。
Almeidaは、会話能力では優れていても、信頼できるソフトウェア部品として扱いやすいとは限らないモデルとの間にあるギャップへの対応として、Jevを説明しています。
TypeSafeによると、一般公開前におよそ2年間、このシステムを開発していました。
Jevの公開はOpenAI内部でも見過ごされませんでした。
OpenAI DevDayの前後に収録されたLatent Spaceのインタビューで、APIプロダクトリードのNikunj Handaは、Decisions APIの推進にJevが直接影響を与えたと認めました。
同氏は、ユーザーと社内チームが、より高速な分類システムを求めていたと説明しました。
また、そのプロジェクトがわずか数週間前にはロードマップに存在していなかったことも認めています。
OpenAIは、最初のバージョンのためだけにまったく新しい基盤モデルを訓練したわけではありません。
代わりに、GPT-6 Lunaを利用し、その上に専用の意思決定インターフェースと推論経路を構築しました。
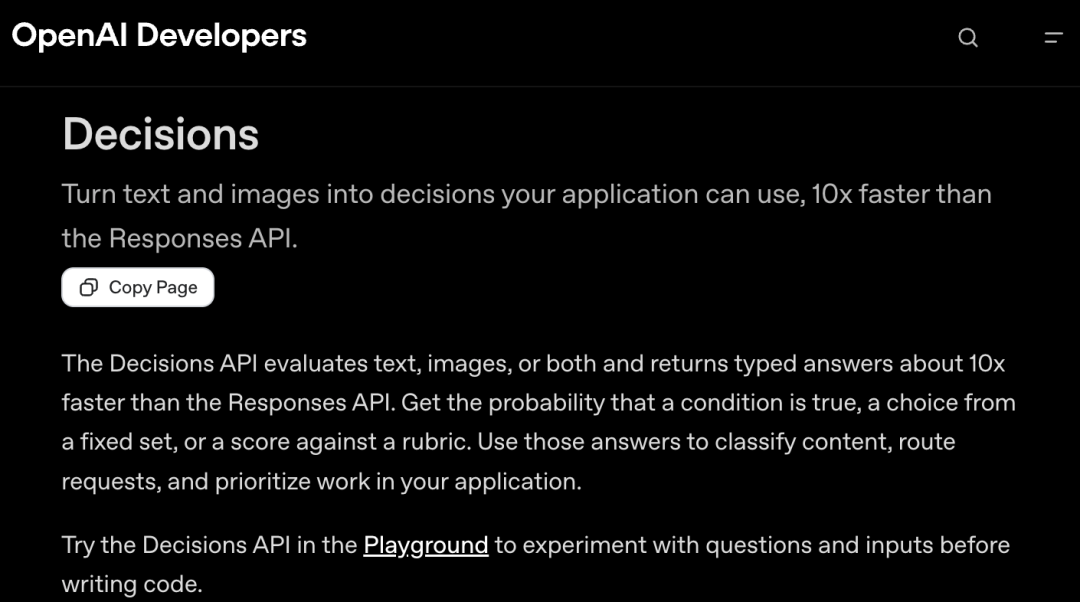
現在、この機能は次のエンドポイントを通じてパブリックベータで利用できます。
POST /v1/decisions
Decisions APIは、共有された根拠情報と1つ以上の質問を受け取り、型付きの回答を返します。
OpenAIは現在、次の3種類の質問をサポートしています。
| 質問タイプ | 結果 |
|---|---|
predicate | 条件が真である確率 |
choice | 選択された1つの選択肢と確率・信頼度 |
score | 順序付けられたレベル上のスコア |
これは、Jevが対象としているユースケースと大きく重なります。
これは、現在公開されている両製品における最大のアーキテクチャ上の違いです。
TypeSafeによると、Jevは専用モデルアーキテクチャと、**Reinforcement Learning for Calibrated Decisions(RLCD)**と呼ぶ学習手法を使用しています。
一方、OpenAIの最初のDecisions APIは、既存のGPT-6 Lunaの重みを使い、専用の意思決定サービングインターフェースを組み合わせています。
概念的には次のようになります。
TypeSafe:
専用の意思決定モデル
→ 型付きの確率的出力

OpenAI:
GPT-6 Luna
→ 専用のDecisions API経路
→ 型付きの確率的出力
つまり、開発者から見ると2つの製品は似ていても、内部では異なるアプローチを採用しています。
実用面での違いの1つは入力モダリティです。
現在のOpenAI Decisions APIは、テキスト、画像、またはその両方を受け付けます。
TypeSafeによるJevの一般公開は、テキストや状態情報の入力を中心としていました。
OpenAIのドキュメントには、製品写真を調べ、ひび、裂け目、へこみなど、目に見える損傷が存在するかを推定する例が含まれています。
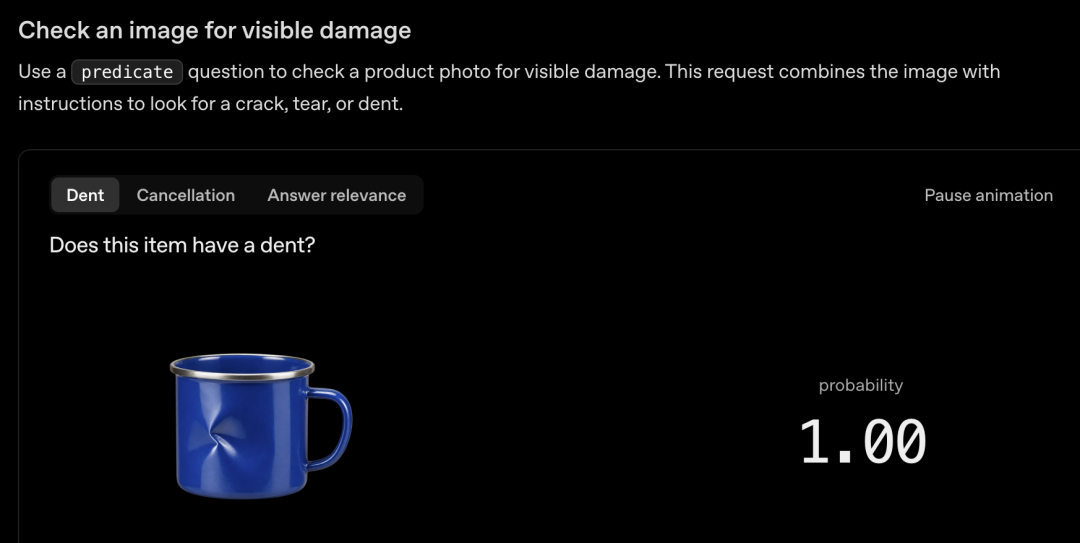
Eコマースアプリケーションでは、このパターンを使って画像を自動的にレビューへ回せます。
例えば、次のようになります。
製品写真
→ Decisions APIが目に見える損傷を確認
→ 確率 = 高い
→ 手動検査へ振り分け
これは、意思決定APIがユーザー向けの回答を生成することなく、通常のソフトウェアの内部に組み込める理由を示す好例です。
ユーザーは、どのモデルが写真を評価したのかを知ることさえないかもしれません。
ユーザーが体験するのは、その結果として生じるワークフローだけです。
現在の公開価格は明快です。
| 製品 | 入力価格 | 出力価格 |
|---|---|---|
| TypeSafe Jev | 0.042ドル / 100万トークン | 無料 |
| GPT-6 Luna搭載OpenAI Decisions API | 0.10ドル / 100万トークン | 無料 |
入力トークンの基本価格では、Jevのほうが安価です。
OpenAIのDecisionsドキュメントによると、APIはResponses API経路よりも約10倍高速に型付きの回答を返します。
この10倍という主張は、OpenAI独自のResponses API経路との比較に限定されています。
Jevに対して公開された、同条件での10倍の速度優位性を示す比較ではありません。
同様に、TypeSafeは独自のワークフロー評価で、より大きな速度向上やコスト削減の倍率を公開しています。しかし、そのテストが独自の方法論に基づくものであり、現実の効果の上限に近い可能性があることも明確に認めています。
本番環境で製品を選ぶ際には、チームが実際のワークロードをベンチマークすべきです。
この製品ストーリーを珍しいものにしているのは、OpenAIが着想元を非常に直接的に認めたことです。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
Latent Spaceのインタビューで、HandaはJevがこのカテゴリーの着想になったこと、そしてOpenAIのユーザーと社内チームが同様の高速分類機能をすぐに求め始めたことを語りました。
同氏は、小規模な社内グループが迅速にプロトタイプを構築し、その後レイテンシーを最適化したと説明しました。
これは、JevとDecisions APIが同一であることを意味しません。
しかし、TypeSafeが現実の製品ギャップを見つけたことは示しています。
競争の焦点は、次の問いから移りました。
最も高性能な汎用モデルを持つのは誰か?
そして、別の問いへと移りつつあります。
ソフトウェア内で繰り返される特定の意思決定に対して、
最も安価で高速なモデル部品はどれか?
これは、従来のチャットボットベンチマークとは異なる市場です。
Jevの低価格は、公開後まもなく有益な独立検証を受けました。
9月29日、ボン大学とLamarr Instituteの研究者は、Jev 1.13.0を評価したプレプリントを提出しました。
この研究は次の内容を対象としました。
Jev APIの総コストは10ドル未満でした。
これは注目すべき数字です。
しかし、論文のより重要な部分は信頼性について述べている点です。
研究者は、Jevの選択肢の確率が選択的予測に役立つ可能性を見いだしました。
平たく言えば、次の通りです。
システムが最も自信のあるケースだけに回答すれば、精度を高められます。
信頼度の低いケースまで受け入れるほど、精度は低下します。
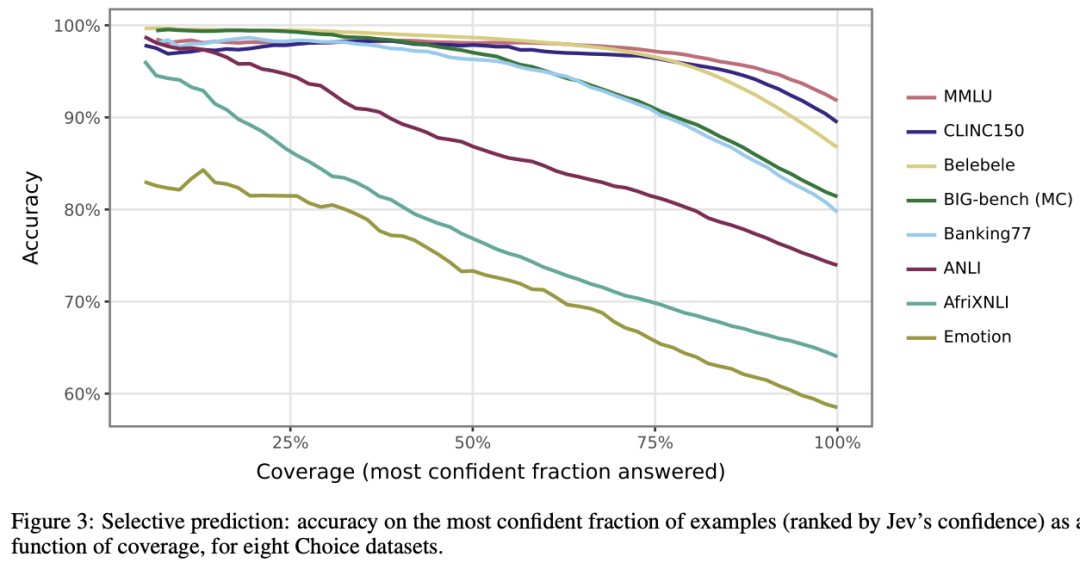
これこそが、自動化において確率が役立つ理由です。
本番ワークフローでは、信頼度の異なる水準に応じて異なる動作を定義できます。
例えば、次のようになります。
confidence >= 0.95
→ 自動化

0.70 <= confidence < 0.95
→ 追加検証を依頼

confidence < 0.70
→ 人によるレビュー
正確な閾値は直感ではなく、評価データに基づいて決めるべきです。
この研究は、二値意思決定に関する重要な注意点を示しました。
Jevの確率は例を適切に順位付けできる一方で、固定された0.5の閾値付近では十分に調整されていない可能性があります。
つまり、次のルールがあらゆるタスクで最適とは限りません。
if probability >= 0.5:
    act
UNFAIR-ToSのある評価では、研究者は学習データ上で閾値を調整することで、マイクロF1を0.50から0.75へ改善できたと報告しています。
一般的な教訓は単純です。
確率は役に立つが、どの確率を行動に十分な高さとみなすかは、アプリケーション側が決める必要がある。
これはJevに限った話ではありません。
確率的分類器を責任を持って導入するには、基本的に必要なことです。
メールの例に戻りましょう。
モデルが宣伝メールを1通、重要なメールと誤って判定したとします。
コストは小さな煩わしさです。
しかし、当日中の返信が必要なメールを見落としたとします。
コストははるかに大きくなる可能性があります。
したがって、適切な閾値は偽陽性と偽陰性の非対称性に左右されます。
実用的なシステムでは、意思決定ごとに異なるルールを使うことがあります。
| 意思決定 | より安全なデフォルト |
|---|---|
| 宣伝メールの検出 | 積極的に自動化する |
| 請求期限の検出 | アラートの閾値を低めに設定する |
| 法務・コンプライアンス分類 | 不確実性をエスカレーションする |
| 高リスクなアカウント操作 | 人による確認を必須にする |
| 価値の低いコンテンツのタグ付け | ほとんどを自動化する |
高性能な意思決定モデルは、プロダクトポリシーを不要にするわけではありません。
プロダクトポリシーをソフトウェアで表現しやすくします。
TypeSafeは、Jevの出力が型安全であることを強調しています。
これは実際のエンジニアリング上の特性です。
開発者が許可された出力の集合を定義すれば、モデルがスキーマ外の任意の文字列を生成する必要はありません。
しかし、正しさには2つの異なる種類があります。
出力が許可された型に一致している。
選択された回答が実際に正しい。
意思決定モデルは、後者よりも前者をはるかに強く保証できます。
独立ベンチマークが明らかにした通り、Jevはレスポンスが型付きの値として完全に有効であっても、間違った回答を選ぶことがあります。
そのため、本番環境で最も安全な解釈は次の通りです。
Jevはフォーマットや解析の失敗を大幅に減らすが、モデルの誤りをなくすわけではない。
元の情報源が正しく指摘している通り、すべての判断をJevに任せるべきではありません。
TypeSafe自身の資料も、特化型System Oneモデルの役割は汎用言語モデルより狭いと認めています。
役割分担は次のように考えられます。
例:
例:
例:
例:
安価なモデルが、後から人が常に修正しなければならない意思決定を生み出せば、新たな費用が発生します。
Jevという名称は、経済学者William Stanley Jevonsに由来します。
Jevonsは、現在ではジェヴォンズのパラドックスと呼ばれる考え方と結び付けられています。
簡略化すると、次のようになります。
資源の効率が上がる
→ 1回あたりのコストが下がる
→ 需要が増える
→ 資源の総消費量が増える可能性がある
TypeSafeはこの論理を機械知能に当てはめています。
AIの呼び出しがすべて大幅に安くなれば、ソフトウェアは同じワークロードへの支出を単に減らすだけではないかもしれません。
開発者は、以前はコストの正当化が難しかったまったく新しいワークロードを作る可能性があります。
これは次のような例ですでに見られます。
結果として、意思決定1回あたりのコストは下がる一方で、意思決定の総数は大幅に増える可能性があります。
これがJevの背景にある、ジェヴォンズのパラドックスへの賭けです。
このトレンドで最も重要な部分は、ユーザーから見えなくなる可能性があります。
現在、人々はAIと明示的にやり取りすることがよくあります。
チャットボットを開く
→ コンテキストを貼り付ける
→ プロンプトを書く
→ 回答を読む
→ 結果を別のツールへコピーして戻す
機械向けに設計された意思決定モデルは、別のパターンを示します。
ユーザーは通常のソフトウェアを使う
→ AIがバックグラウンドで小さな意思決定を評価する
→ ソフトウェアが自動的に振り分け、スコアリング、確認、フィルタリングを行う
→ 人間には重要なケースだけが表示される
受信トレイは緊急メールだけを表示できます。
文章作成ツールはレビューが必要な文だけにフラグを付けられます。
エージェントは次に使うツールを自動的に選択できます。
サポートシステムは担当者が見る前にチケットを振り分けられます。
マーケットプレイスは登録直後に候補者を順位付けできます。
この段階になると、基盤システムがJev、GPT-6 Luna、その他の意思決定モデルのどれを使っているかを、ユーザーは気にしないかもしれません。
ユーザーが気にするのは、ソフトウェアがより速く感じられ、手作業が減ることです。
TypeSafeの資金調達は、この観点から見るとより理解しやすくなります。
同社が賭けているのは、人々が新しいチャットボットのタブを欲しがるということではありません。
ソフトウェア自体が、膨大な数のモデル呼び出しを行うようになるということです。
TypeSafeによると、Fortune 500企業の3分の1がすでにJevを利用しています。ただし、これは同社が報告した導入数字であり、同社はそれらの顧客すべてを公表しているわけではありません。
8億7,000万ドルのシリーズAにより、TypeSafeはこの戦略を拡大するための大きな資金を得ました。
同社の資金調達発表によると、次の取り組みを予定しています。
OpenAIがDecisions APIで迅速に対応したことは、大手ラボも同じ機会を見ていることを示しています。
次の競争上の問いは、単純にどのシステムが最も安いかではありません。
開発者がソフトウェアに自動的に行動させてもよいと感じるほど、信頼できる意思決定をどのシステムが生み出せるかです。
JevはTypeSafe AI初の「System One Model」であり、自由形式のテキスト生成ではなく、高速で機械可読な意思決定のために設計されています。共有状態と型付きの質問を受け取り、ソフトウェアが直接利用できる選択肢、スコア、確率を返します。
TypeSafeは現在、Jevを入力100万トークンあたり0.042ドル、出力無料で提供しています。実際のアプリケーションコストは、リクエスト量、入力サイズ、リトライ、評価オーバーヘッド、大規模モデルや人へエスカレーションされるケース数によって変わります。
TypeSafeはJevを、テキスト生成向けの従来型の大規模言語モデルではなく、トランスフォーマーベースのSystem Oneモデルと説明しています。最大の特徴は、任意の文章を生成せず、型付きの確率的な意思決定を返すことです。
はい。型安全な出力は、特定のフォーマットやスキーマのエラーを防ぎますが、選択された意思決定が意味的に間違う可能性は残ります。独立評価では、多くのデータセットで強い結果が示された一方、タスクに依存するエラーや閾値調整の問題も確認されています。
OpenAI Decisions APIは、GPT-6 Lunaを基盤とするパブリックベータのエンドポイントで、テキストや画像を型付きの述語、選択肢、スコアへ変換します。OpenAIは、同じ種類の処理をResponses API経由で行う場合と比べて、およそ10倍高速だと説明しています。
現在のDecisions APIの価格は、入力100万トークンあたり0.10ドルで、出力トークン料金はかかりません。Jevの公開されている基本入力価格は、入力100万トークンあたり0.042ドルで、こちらも出力は無料です。
確率だけでは、アプリケーションがどの行動を取るべきかは決まりません。チームは、0.5が常に正しい閾値だと仮定するのではなく、ラベル付き評価データと、偽陽性、偽陰性、人によるレビューの実際のコストを使って閾値を決めるべきです。
意思決定モデルは、可能な出力をあらかじめ定義できる、大量の分類、ルーティング、スコアリング、検証、分岐に適しています。オープンエンドな推論、説明、コンテンツ生成、複雑な計画が必要な場合は、汎用モデルを使うべきです。
TypeSafe Jevは、AIに対して意図的に狭いアプローチを取っています。人間向けの言語を生成するのではなく、ソフトウェア向けに型付きの意思決定を生成します。この設計により、大量の分類、ルーティング、スコアリング、検証を、より低コストでコードへ統合しやすくなります。
Jevは、OpenAIがGPT-6 Lunaを基盤とするDecisions APIで同じ製品カテゴリーに迅速に参入するほど、強い初期採用を獲得しました。公開されている基本入力価格ではJevのほうが安価である一方、OpenAIは画像対応と、既存の汎用モデルプラットフォームの規模を加えています。
主なエンジニアリング上の課題は、フォーマットではなく信頼性です。型付き出力によって失敗の一種は取り除けますが、意思決定の精度は、データセット、閾値、誤りのコスト、エスカレーションポリシーに左右されます。独立したJev研究は、この点を特に明確にしています。
より大きな変化は、AIがユーザーが明示的に「話しかける」ものではなくなり、通常のソフトウェア内部で静かに動作する低コストの意思決定レイヤーになる可能性があることです。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



