Lepton AIがNVIDIAの一部となってから1年余り、楊慶氏は再び新たなスタートを切る。彼の新会社Intent Labは、従来のチャットボットやクラウド市場での立ち上げではない。
Lepton AIがNVIDIAの一部となってから1年余り。Yangqing Jia氏が再び動き出した。
彼の新会社Intent Labは、従来型のチャットボットやクラウドマーケットプレイス、開発者向けIDEとともに立ち上がったわけではない。代わりに同社が構築しているのはFleet。これは、高レベルの意図を本番品質のソフトウェアに変換する自律型エンジニアリングチームと説明されている。
Intent Labの最初の公開デモには、非常に異なる3つのシステムが含まれている:
一見すると、これらのプロジェクトは単一の製品カテゴリには見えない。
そこがポイントだ。
Intent Labによれば、実際の製品は背後にあるエンジニアリングシステムそのものだという。Fleetは、曖昧なソフトウェアリクエストと、ベンチマーク可能で検証・運用・進化が可能な本番システムとの間の作業を実行することを目的としている。

この記事の初期パフォーマンス数値は、Intent Lab自身のローンチ資料に基づくものです。これらは有望なデモであり、独立したベンチマーク認定ではありません。同社はまだ、外部チームが同一条件下ですべての結果を確認できるほどの再現性の詳細を公開していません。
Yangqing Jia氏のキャリアは、繰り返しインフラに立ち返ってきた。
彼はカリフォルニア大学バークレー校在籍時にCaffeを開発したことで最もよく知られており、その後はPyTorchやONNXなど、主要なAIインフラプロジェクトに携わってきた。
2023年にアリババを退社後、Jia氏はLepton AIを共同設立。GPUコンピューティングとモデルデプロイを開発者にとってより簡単にすることを重視した企業である。
Leptonの当初の提案は、Pythonネイティブの開発者体験と、複数のGPUプロバイダーにわたってAIワークロードを実行できるインフラを組み合わせたものだった。
同社は2025年にNVIDIAによって買収され、当時は数億ドル規模と公に報じられた。その後の業界レポートでは約7億ドルとされたが、NVIDIAは最終的な買収価格を公開していない。
Leptonの技術はNVIDIA DGX Cloud Leptonの一部となった。

NVIDIAは現在、DGX Cloud Leptonを、開発・トレーニング・推論のためにクラウドプロバイダーと顧客所有インフラストラクチャーにわたってGPUコンピューティングを統合するアクティブなプラットフォームとして説明しています。
この現在の状況は明確にしておく価値があります。というのも、Jia氏の退社後のコメントでは、当初のスタートアップ型Lepton製品とそのオープンソースへの野心は、買収後も形を変えずに生き残ったわけではないと主張されていたからです。
公開されている証拠は、より慎重な説明を裏付けています:
lep CLIは引き続き利用可能です。Jia氏はその後、NVIDIAのシステムソフトウェア担当副社長を務め、2026年に同社を退社しました。
2026年7月、HyperbolicはJia氏がGPUインフラストラクチャー企業のアドバイザーとして加わったことを発表しました。
Hyperbolicは、Caffe、ONNX、PyTorch、Lepton AI、NVIDIA、Google、Facebook、Alibaba Cloudでの彼の経歴が、GPUアクセスとインフラストラクチャーに関する自社の取り組みに特に関連性が高いと説明しました。
しかし、その役割は彼の次の本格的な動きではありませんでした。
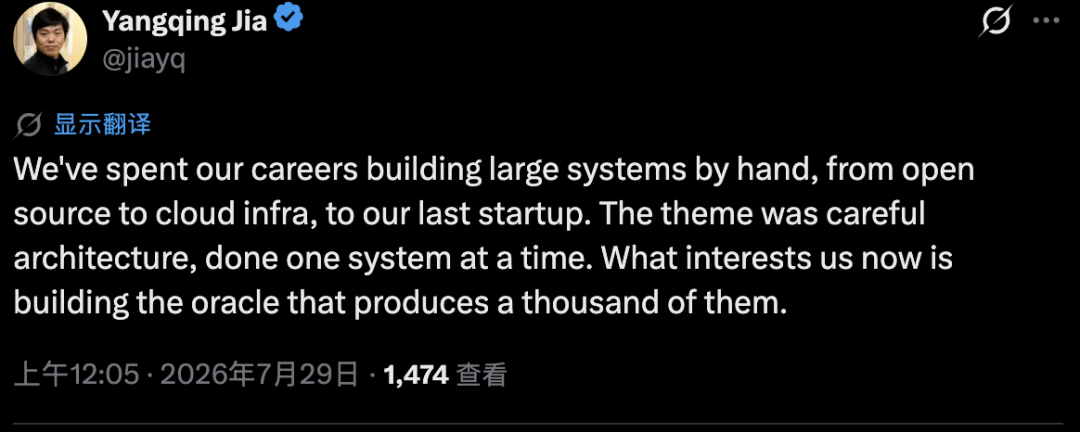
7月29日、Jia氏はIntent Labを公に紹介しました。
彼の位置づけはLepton AIとは異なるものでした。
Leptonは開発者にコンピューティングへのより簡単なアクセスを提供することに焦点を当てていました。
Intent Labは、自律型エンジニアリングシステムに、そのコンピューティング上で動作するソフトウェアを作成・維持する能力を与えることに焦点を当てています。
Jia氏はこの転換について、自身のチームはキャリアを通じて大規模なシステムを一つずつ注意深く構築してきたと総括しました。彼らが今関心を持っているのは、そのようなシステムを多数生み出すことができるシステムだということです。
Intent Labはその自律型エンジニアリングシステムをFleetと呼んでいます。
同社はそれを単一のコーディングエージェントではなく、チームとして説明しています。
この区別は重要です。
典型的なコーディングエージェントは、ファイルの編集、コマンドの実行、テストの修正、リポジトリの検索、機能の実装ができます。
Fleetは、より長いエンジニアリングプロセスを調整できるシステムとして提示されています。
Intent Labの表明された目標は、高レベルのリクエストから測定可能な本番システムへの移行に必要な作業をカバーすることです。
動作、検証、そして継続的改善への道筋。
最初の3つのデモンストレーションは、非常に異なる工学分野にわたってその主張を検証するために選ばれた。
技術的に最も注目すべき発表結果は、GLM-5.2推論エンジンである。
最初の指示は、基本的に1つの工学的目標であった:
TensorRT-LLMを再設計し、GLM-5.2がGrace Blackwellノード上で効率的に動作するようにする。
最適化の機会を特定し、実装し、自律的に検証する。
TensorRT-LLMは、すでにNVIDIAの大規模言語モデル向け本番環境向け推論スタックである。
NVIDIAは、マルチGPUおよびマルチノードサービス、インフライトバッチ処理、ページングKVキャッシュ、量子化、最適化カーネル、PythonおよびC++ランタイムなどの機能を文書化している。
したがって、そのスタック上でパフォーマンスを向上させることは、最適化されていないリファレンス実装を最適化するよりも困難な目標である。
Intent Labによると、Fleetは標準TensorRT-LLMで開始し、おおよそ以下の速度であった:
102トークン/秒
最適化されたランタイムは、以下に達した:
161トークン/秒
同社の最適化された投機的デコーディングパスを追加した後、システムは以下に達したと報告されている:
647トークン/秒
これは元の出力速度のおよそ6.3倍である。
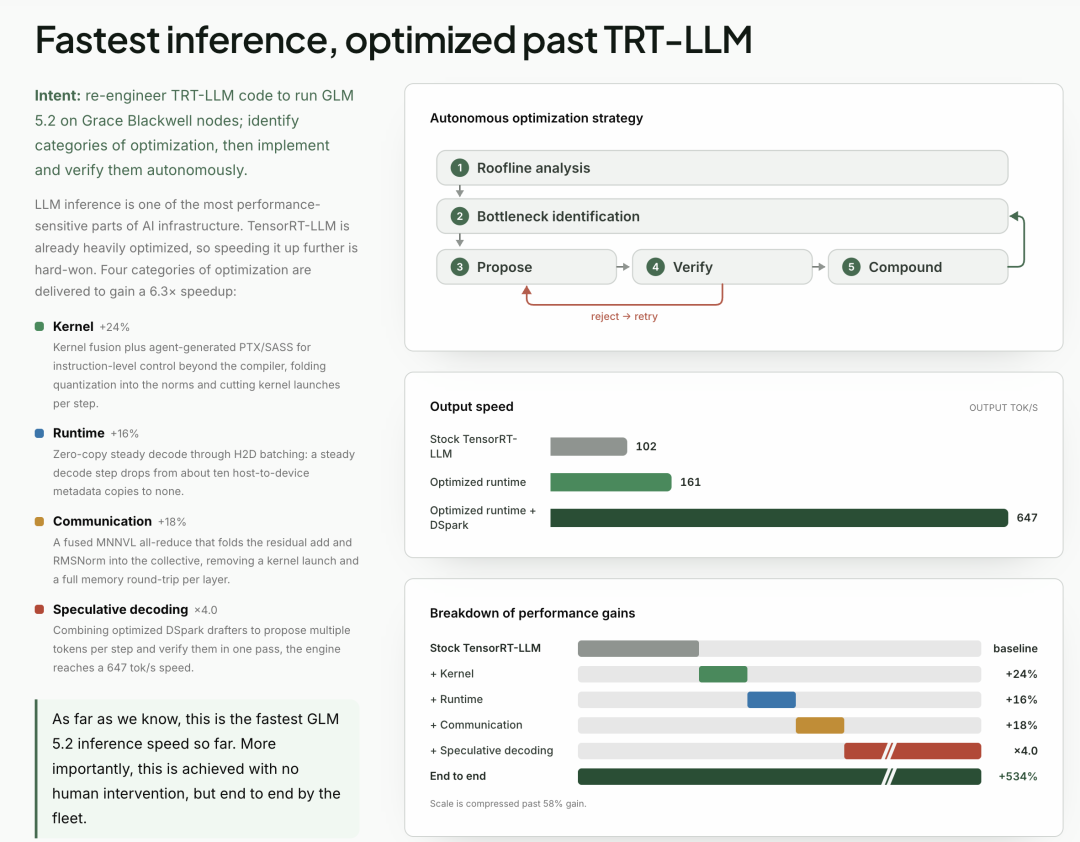
Intent Labによると、ベンチマークは2つのGrace Blackwellノードを使用した。
同社はパフォーマンス作業を4つのカテゴリに分類している。
Fleetは、カーネル融合を適用し、命令レベル制御のための低レベルPTX/SASSパスを生成したと報告されている。
Intent Labによると、ランタイムはH2Dバッチ処理とゼロコピー技術を通じて、定常状態のデコーディングから繰り返されるホストからデバイスへのメタデータコピーを削除した。
Fleetは、残余加算とRMSNormを集合操作に組み込んだ融合MNNVLオールリデュースパスを使用したと報告されている。
最大の個別ゲインは投機的デコーディングからもたらされた。
Intent Labによると、最適化されたDSparkドラフターは複数のトークンを提案し、メインモデルがそれらをバッチで検証することで、デコードスループットを大幅に向上させる。
同社は、エンドツーエンドの結果として、標準ベースラインからの534%の改善を報告している。
これらの数値はIntent Lab自身の測定値である。ハードウェア構成、ワークロードの詳細、バッチ設定、出力長、精度、同時実行性、ソフトウェアリビジョンは、推論ベンチマークに大きく影響する可能性がある。
Intent Labによると、Fleetは繰り返しのエンジニアリングループに従う:
提案された最適化が
検証に失敗すると、システムは戻って再度試行します。
「複合」ステップが重要なのは、個々に成功した最適化が互いに干渉し合うことで、パフォーマンスエンジニアリングがしばしば失敗するからです。
Fleet は、複合システムが依然として機能することを検証した後にのみ変更を保持するように設計されています。
GLM-5.2 は、Z.ai の長期的タスク向けフラッグシップモデルです。
その公式モデルカードは、100万トークンのコンテキストウィンドウ、長期的なコーディングとエージェントワークロード、柔軟な推論努力、改善されたスパースアテンションアーキテクチャ、そして MIT ライセンスによるオープンウェイトを強調しています。
長いコンテキストとエージェント的なワークロードを備えた大規模モデルは、困難なサービング問題を生み出します。
最速の実装は、カーネル設計、メモリ帯域幅、KVキャッシュの動作、インターコネクト帯域幅、バッチサイズ、投機的デコード、量子化、ホストスケジューリング、通信コレクティブ間の相互作用に依存します。
これにより、推論最適化は、自律型エンジニアリングシステムにとって有用なストレステストとなります。
Fleet の2つ目の公開プロジェクトは、GPU カーネルから完全に離れています。
Intent Lab は、システムに SQLite と互換性のある SQL データベースエンジンの構築を依頼しました。
公開資料には、次の要件が示されています:
SQLite と互換性のある SQL データベースエンジンを構築する。
つまり、すべての sqllogictest テストケースに合格でき、
パフォーマンスが同等以上でなければならない。
Intent Lab は、Fleet が SQLite のソースコードやドキュメントから開始しなかったと述べています。
代わりに、既存システムの動作とテストコーパスを受け入れ契約として扱いました。
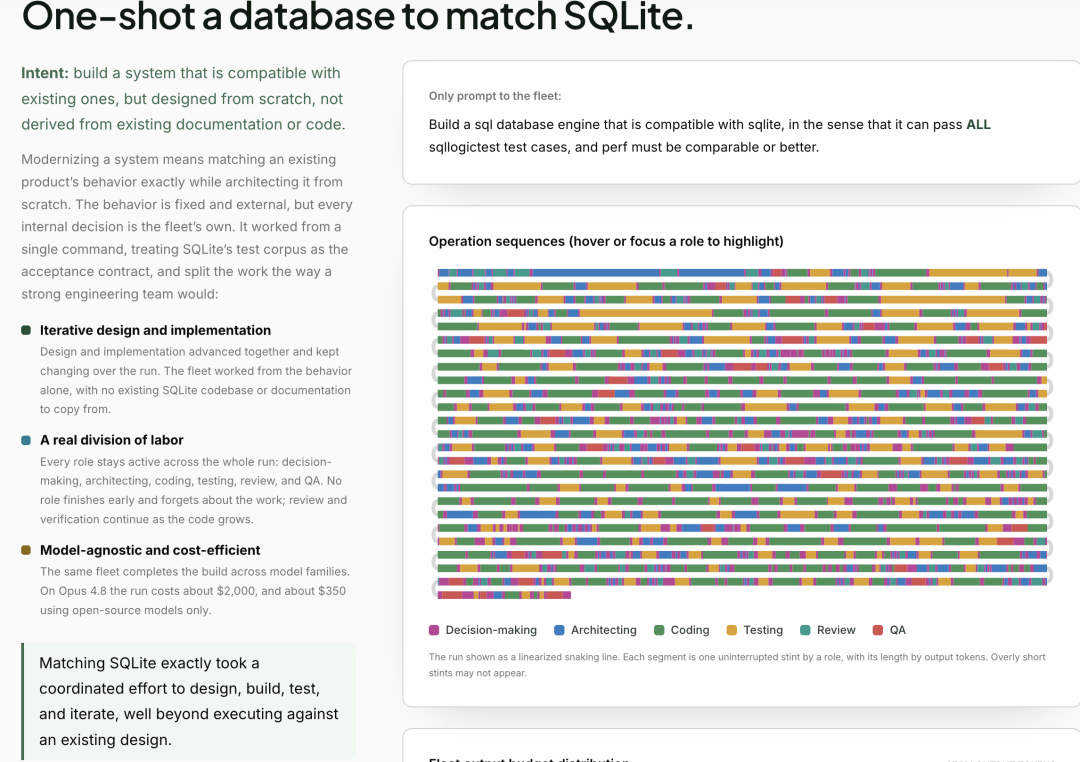
同社は、最終システムが約600万件の SQLite 互換性テストに合格したと報告しています。
この数値は Intent Lab からのものであり、この記事のために独立して再現されたものではありません。
Intent Lab は、データベース構築を、プロジェクト全体で機能する複数の役割として視覚化しています:
役割は単に直線的な引き継ぎで機能するわけではありません。
実装が進行している間にアーキテクチャが変更されることがあります。機能が追加されている間もテストは継続されます。コードベースが成長するにつれて、レビューと QA はアクティブなままです。
Intent Lab はコスト比較も公開しました。
同じデータベース構築について、同社は Opus 4.8 を使用した実行には約2,000ドル、オープンソースモデルを使用した実行には約350ドルかかったと述べています。
これらの数値は企業報告によるもので、モデル価格、トークン消費、エージェントオーケストレーション、インフラストラクチャに依存します。
それでも、エージェントエンジニアリングにとっての主要な経済的疑問を示しています: 1回のモデル呼び出しの価格ではなく、完全なプロジェクト成功のコストはいくらか、ということです。
エージェント向け検証済みファイルシステム
3つ目のデモは、AgentFSと呼ばれる分散ファイルシステムです。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
Intent Labによると、これはクラウド環境におけるエージェントワークロードのために特別に設計されたものです。
AIコーディングおよびリサーチエージェントは、特徴的なストレージパターンを生み出す傾向があります:
Intent Labは、Amazon EFSやS3FSを含む既存システムを評価したところ、このワークロードに対する制限を発見し、代わりに新しいファイルシステムを構築したと述べています。
同社は、メタデータ中心の操作において、比較対象のシステムと比べて大幅な高速化を達成したと主張しています。
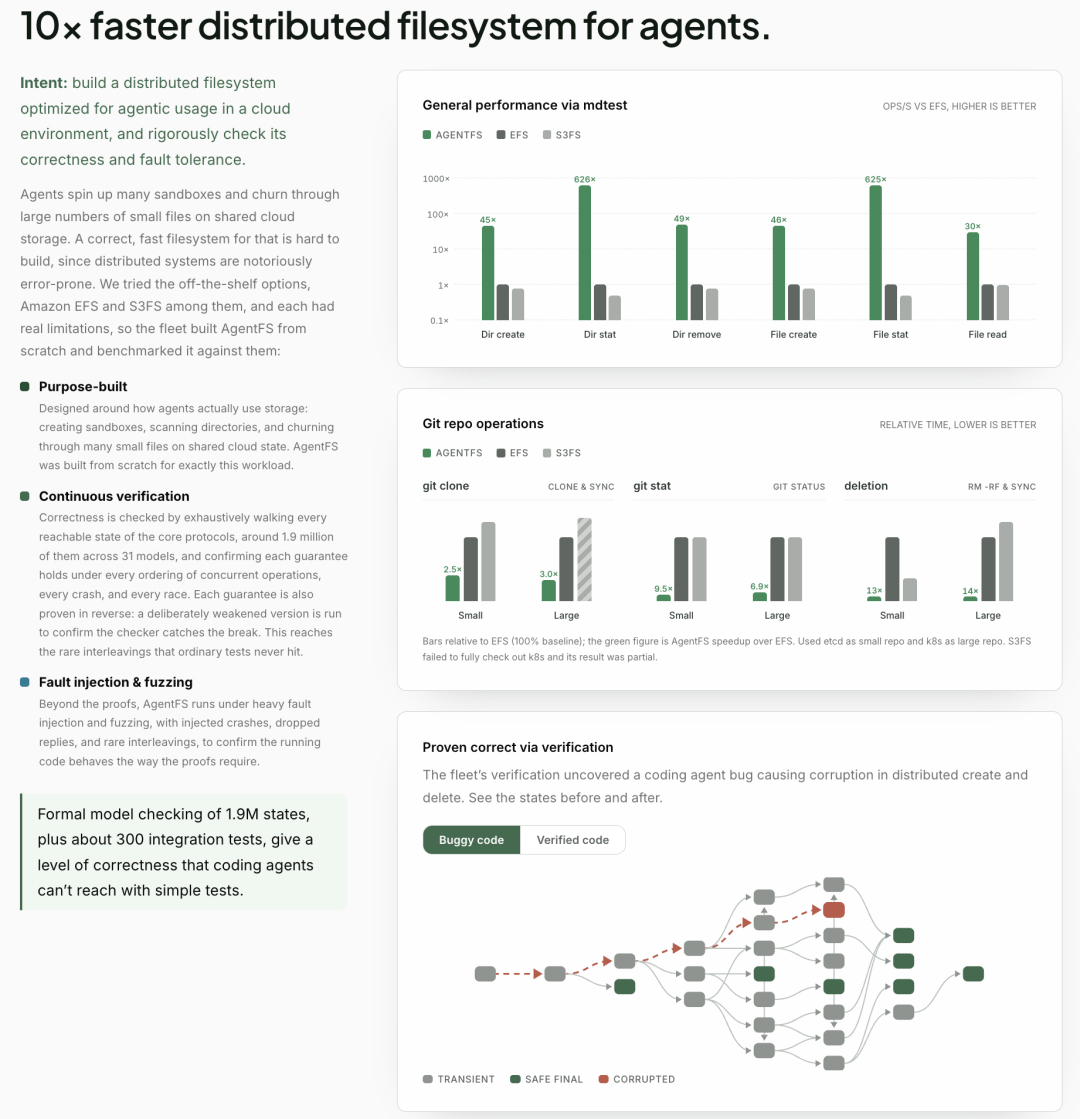
繰り返しになりますが、これらはIntent Labの発表時点でのベンチマークであり、独立した第三者による結果ではありません。
ファイルシステムの例で最も重要な部分は、ベンチマークのチャートではありません。
それは検証です。
Intent Labによると、Fleetはコアプロトコルを形式的にモデル化し、約190万状態を探索しました。
そのプロセスにより、コーディングエージェントが生成したコードにバグが発見されました。
そのバグは、分散環境での作成・削除動作中に一時的な破損状態を引き起こす可能性がありました。
Intent Labは、Fleetが実装を修正し、検証を再実行したと述べています。
同社はまた、約300件の統合テストに加え、クラッシュ注入とレプリカを用いたフォールトインジェクションおよびファジングも実施したと報告しています。
形式検証がここで価値を持つのは、ファイルシステムが稀なインターリービングに対して特に脆弱だからです。
従来のテストでは、一般的なパスが機能することを示すことができます。モデルチェッカーは、通常のテストスイートでは決して遭遇しない状態の組み合わせを体系的に探索できます。
この原則はIntent Labの外部でも確立されています。ファイルシステム研究者は、成熟したシステムのクラッシュ整合性やメタデータのバグを発見するために、数十年にわたりモデルチェッキングを使用してきました。
ここでの新しい主張は、自律型エンジニアリングシステムがこの種の検証を自らのビルドループに組み込めるということです。
Jia氏の中心的な主張は、3つのデモのいずれよりも広範です。
現代のモデルは素早くコードを書くことができます。
それは、その結果が企業が何年にもわたって運用すべきソフトウェアであることを意味しません。
彼は、残されたギャップは単にモデルのコーディング能力のさらなる飛躍ではないと主張しています。
それはモデルを取り巻くエンジニアリング層です。
本番システムには、実装以上のものが必要です。
要件、アーキテクチャ、インターフェース、
トレードオフ、調整、テスト、パフォーマンス分析、信頼性作業、検証、障害処理、保守、そして本番環境からのフィードバック。
コーディングモデルはこれらすべての活動に参加する可能性がある。
Fleetの主張は、これらを一つの自律システムとして組織化する必要があるというものだ。
Intent Labはそのエンジニアリングプロセスを6つの段階で説明している。
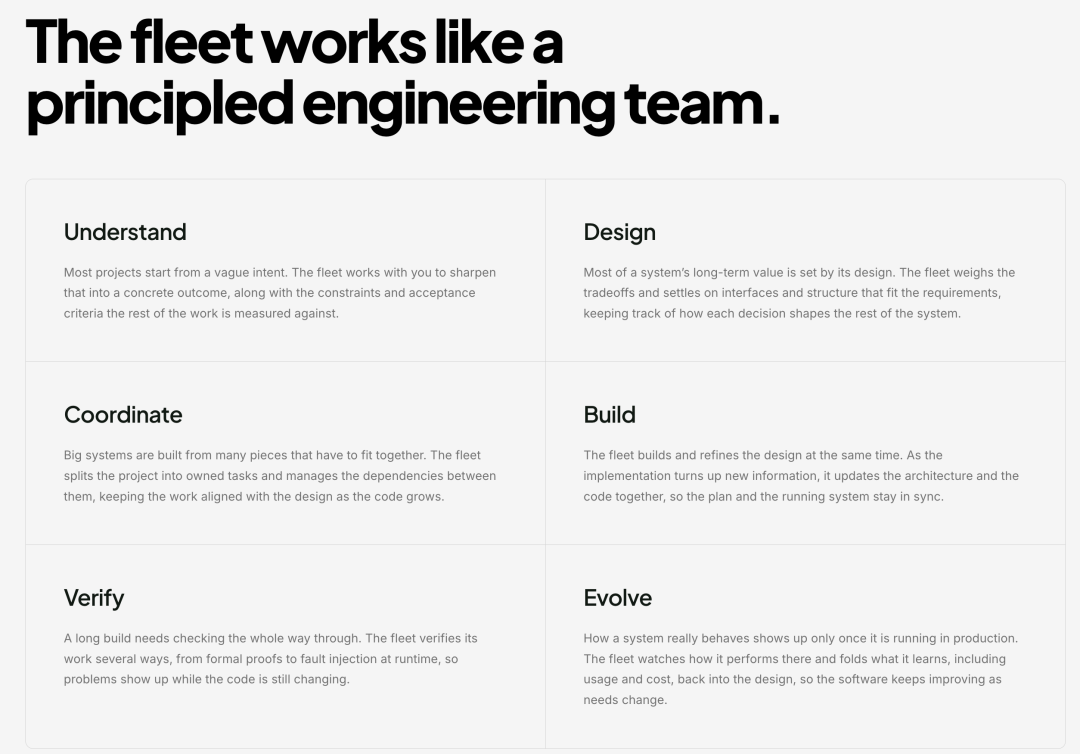
Fleetは、曖昧な意図を具体的な成果物、制約、受け入れ基準、そして成功の測定可能な定義に変換することを想定している。
Fleetはトレードオフを検討し、インターフェース、コンポーネント、長期的なシステム構造を定義する。
システムは大規模プロジェクトをタスクに分割し、依存関係を管理し、実装を全体的な設計と整合させる。
開発中に新しい情報が現れるにつれて、実装とアーキテクチャは共に進化する。
検証には、ユニットテスト、統合テスト、ベンチマーク、形式証明、モデル検査、フォールトインジェクション、ファジング、ランタイム検証が含まれる。
Fleetは、本番環境のパフォーマンスを観察し、使用状況、信頼性、コストに関する情報を設計にフィードバックすることを意図している。
ここが、Intent Labの野心が自律的なコーディングエージェントを超えて広がる点である。
目標はソフトウェア生成だけではない。
それは自律的なソフトウェア所有権である。
Intent Labは、Fleetが原則に基づくエンジニアリングチームのように動作すると説明している。
これは有用なメタファーである。なぜなら、強力なエンジニアリング組織のどの一員も、すべての関心事に責任を負うわけではないからだ。
あるエンジニアはカーネルを最適化するかもしれない。別のエンジニアはストレージプロトコルを設計するかもしれない。また別の人物はベンチマークを維持する。さらに別の人物は信頼性をレビューする。
Fleetはそれらの責任を調整されたエージェントの役割に変換しようと試みる。
したがって、難しい問いは、LLMが高品質なコードを書けるかどうかだけではない。
複数の自律プロセスが、同じプロジェクトを長期間にわたって構築、テスト、最適化、検証、改訂しながら、一貫したシステムアーキテクチャを維持できるかどうかである。
Jiaはまた経済的議論を行っている。
数十年にわたり、ソフトウェア開発には大きな固定費があった。
合理的な戦略は、一つの製品を構築し、それを多くのユーザーに販売し、異なるニーズを持つユーザーに同じソフトウェアへの適応を求めることだった。
自律的エンジニアリングがシステムの構築と維持の固定費を削減すれば、その方程式は変わる。
Intent Labの最初の成果は野心的だが、公開資料では重要な疑問が未解決のまま残されている。
6.3倍の推論結果、SQLiteのテスト数、AgentFSのパフォーマンス、形式検証の数値はすべて同社による報告値である。
独立した再現が行われれば、その主張ははるかに強力なものになるだろう。
Intent Labは、Fleet自体を再構築するのに十分な詳細を公開文書として提示していない。
各ロールにどのベースモデルが使われるのか、エージェントがどのように状態を共有するのか、タスクがどのようにスケジュールされるのか、競合がどのように解決されるのか、仕様がどのように保存されるのか、人的監督がどの程度残されているのかは、まだ明確ではない。
ベンチマーク品質のシステムを構築することと、それを何年にもわたって運用することは同一ではない。
「進化」段階はこの提言全体で最も困難な部分かもしれない。本番運用の責任者は、セキュリティパッチ、依存関係の変更、ハードウェアの移行、障害、コスト変動、機能追加要求、後方互換性に対応しなければならないからだ。
自律的なエンジニアリングは、ある種のタスクでは人間のチームよりも安価でありながら、依然として相当な推論リソースと計算リソースを消費する可能性がある。
Intent Lab自身のデータベースの例は、モデルの選択によってプロジェクト全体のコストが数倍変わり得ることを示している。
Intent Labは、単なる別のコーディングエージェントのスタートアップではない。
その提言は自律的システムエンジニアリングに近いものだ。
作業の対象単位は、コード補完やプルリクエストではない。
それは本番システムである。
だからこそ、最初の3つの例は無関係に見えるのだ。
推論エンジン、データベース、ファイルシステムは、製品レベルではほとんど共通点がない。
しかし、それらには共通のエンジニアリングパターンがある。
意図
→ 仕様
→ アーキテクチャ
→

coordinated implementation
→ measurement
→ verification
→ iteration
→ production evolution
Fleetはそのパターンを自動化することを目的としています。
それが多くの実在の企業で確実に機能するかどうかは、まだ未解決の問いです。
しかし、その野心は明確です。
Intent Labは、楊慶(Yangqing Jia)と他の経験豊富なシステムエンジニアによって共同設立された、新しいAIインフラストラクチャおよび自律型エンジニアリング企業です。最初の製品であるFleetは、高レベルのソフトウェアインテントを本番級システムに変えるために設計されています。
FleetはIntent Labの自律型エンジニアリングシステムです。同社はこれを、要件を理解し、アーキテクチャを設計し、コードを構築し、結果を検証し、デプロイ後もソフトウェアを進化させ続けることができる連携エージェントのチームと説明しています。
Intent Labは、最適化されたGLM-5.2エンジンが、標準のTensorRT-LLMでの102トークン/秒から、Grace Blackwellノード2基で647トークン/秒に出力速度を向上させたと報告しています。この数字は同社が報告したベンチマークであり、本記事でレビューした情報源ではまだ独立に再現されていません。
Intent Labによると、初期のデータベース要件は「SQLite互換のSQLエンジンを求める」という単一のプロンプトでした。その後Fleetは、同社が約600万件の互換性テストを通過したと言うまで、自律的にアーキテクチャ、コーディング、テスト、レビュー、QAを実行しました。
AgentFSは、Intent Labの3番目のローンチデモで作成された分散ファイルシステムです。多くのサンドボックスと小ファイルを含むAIエージェントのワークロードに最適化されており、Intent Labはその中核プロトコルが形式モデル検証によってチェックされたと述べています。
通常のコーディングエージェントは、既存のプロジェクト内のコード変更に取り組みます。Fleetは、要件定義、アーキテクチャ、実装、パフォーマンス作業、形式検証、障害テスト、本番進化を含む、システムエンジニアリングの全ライフサイクルを調整することを目的としています。
Intent Labはデモと製品の考え方を公開していますが、本記事でレビューした情報源には、Fleetの完全なオーケストレーションシステムの公開リリースは示されていません。最新の利用可能性については、Intent Labの公式サイトをご確認ください。
はい。NVIDIAは現在、DGX Cloud Leptonに関する製品ページとドキュメントを維持しており、ワークロード、ノードグループ、エンドポイント、Dev Pods、バッチジョブ、持ち込みコンピュート機能などが含まれています。これは、NVIDIA製品がLepton AIの当初のスタートアップロードマップをどの程度保持していたかに関する議論とは別の問題です。
GLM-5.2: Intent Labの推論エンジンデモで使用された、Z.aiによるオープンウェイトの長時間ホライズンモデル。
Yangqing Jia氏の新会社Intent Labは、コード生成ではなく、完全な本番システムのライフサイクルという、異なるAI作業単位を中心にFleetを構築している。
その最初のデモンストレーションは、GLM-5.2の推論最適化、SQLite互換データベース、および形式的に検証された分散ファイルシステムにわたる。Intent Labは、6.3倍の推論高速化、約600万件のデータベース互換性テスト、および約190万状態のファイルシステムに対するモデル検査を報告している。
共通するアイデアは、理解、設計、調整、構築、検証、進化という6段階のエンジニアリングループであり、自律エージェントを用いて強力なエンジニアリング組織の責任を再現しようとするものである。
結果はまだ初期段階であり、大部分が自己報告に依存しているため、再現性と長期的な本番運用が真の試金石となる。
Fleetの最も重要な主張は、AIが一文からコードを書けるということではなく、自律システムが一文と、何年も運用する価値のあるソフトウェアとの間のエンジニアリング作業に対して責任を負えるということである。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



