키워드 검색량이 답하는 것은 "얼마나 많은 사람이 이 단어 조합으로 검색하는가"이며, "이 사람이 결정을 내리기 전에 또 무엇을 물을 것인가"에는 답하지 않는다. AI 검색은 후자를 결정적 변수로 만들었다. 사용자가 ChatGPT, Perplexity, Gemini 또는 Google AI Mode에서 제약 조건이 붙은 질문을 던지면, 엔진은 스스로 여러 하위 질의를 생성해 검색하고, 검색된 단락을 인용이 포함된 답변으로 조합한다. 당신이 인용될 수 있는지를 결정하는 것은 더 이상 특정 단어에 순위가 있는지가 아니라, 페이지 안에 특정 하위 질의에 정확히 답하는, 단독으로 추출 가능한 단락이 있는지다.
따라서 더 정확한 표현은 이렇다. 검색량은 여전히 유용한 수요 규모 신호이지만, 그것은 시작 지표이지 종료 지표가 아니다. 키워드 리서치에는 세 가지가 새로 추가되어야 한다. 이 수요 뒤에 있는 완전한 질문 체인, 각 질문에 대응하는 검색 형태, 그리고 페이지가 추출 가능한 답변 블록을 갖추고 있는지 여부다.
검색량만 보면 실제 구매 의도를 놓치는 이유
전통적 프로세스는 "메인 키워드 → 관련 키워드 → 콘텐츠"이며, 모든 검색이 독립적이고 단어 형태가 고정된 수요라고 가정한다. 사용자 행동은 이미 변했다. 하나의 실제 질문에는 예산, 상황, 호환성, 사용 방식이 동시에 포함되는 경우가 많다. 예를 들어 "150만 원 이하, 영상 편집 가능, 배터리 오래감, 출장에 편한 노트북" 같은 식이다. 이러한 조건은 AI 검색에서 서로 다른 분기로 나뉘어 각각 검색된다.
B2B 구매를 예로 들면, "best CRM software" 뒤에는 보통 연속된追问이 따른다. 소규모 기업에는 어떤 것이 맞나? 이메일 자동화를 지원하나? Shopify와 연동되나? 월 요금이 가장 낮은 것은? 이 네 가지 질문의 검색 가치는 원래 키워드 자체보다 높을 수 있지만, 월 검색량은 거의 0에 가깝다. 사람들은 완전한 의문문을 검색창에 입력하는 경우가 드물지만, AI에게는 그렇게 묻는다.
여기서 두 가지 허점이 생긴다. 첫째, 낮은 검색량이 낮은 상업적 가치를 의미하지는 않는다. 둘째, 검색량은 답변 형태에 대한 어떤 힌트도 주지 않는다. 비교형 수요에는 표가 필요하고, 절차형 수요에는 번호 단계가 필요하며, 정의형 수요에는 단독으로 성립하는 30~50자 설명이 필요하다는 것을 알려주지 않는다. 그리고 바로 이러한 형태가 콘텐츠의 검색 가능성을 결정한다.
Query Fan-Out(쿼리 팬아웃)이란 무엇인가
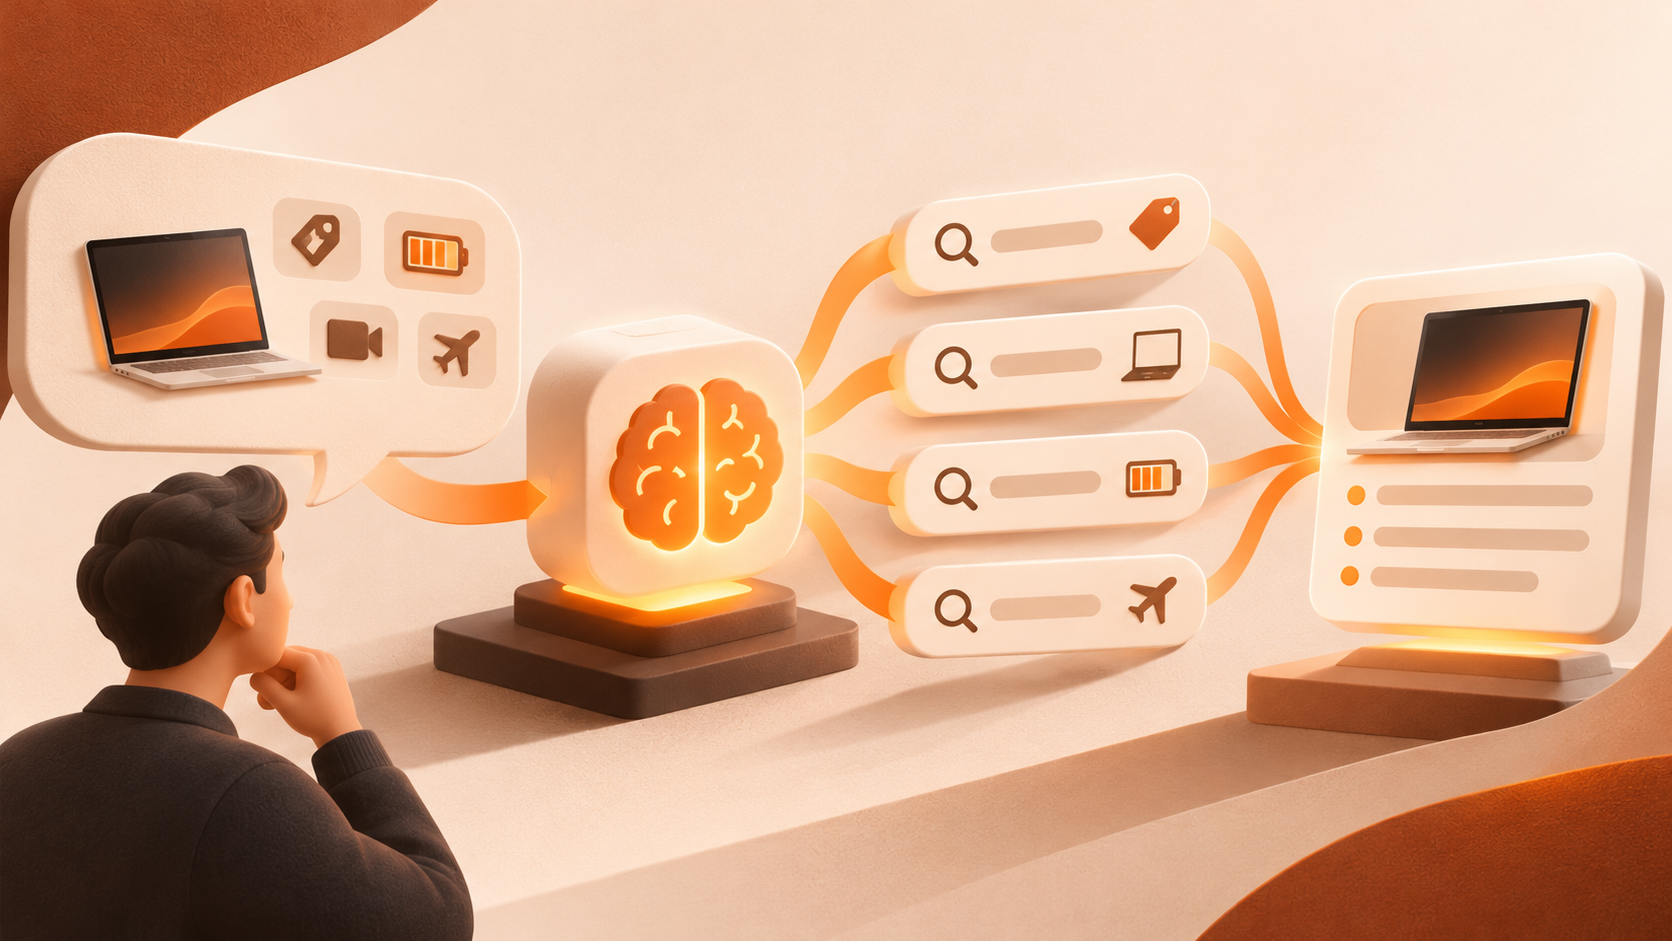
Query Fan-Out은 AI 검색 엔진이 하나의 질문을 모델이 스스로 생성한 여러 하위 질의로 나누고, 병렬로 검색하며, 반환된 단락에 점수를 매기고, 인용이 포함된 답변으로 합성하는 것을 말한다. Google은 AI 기능 문서에서 AI Mode와 AI Overviews 같은 경험이 이 기술을 사용할 수 있어 일반 결과 페이지보다 "더 넓고 다양한 유용한 링크 세트"를 제시할 수 있다고 설명한다(Google Search Central).
엔지니어링 관점에서는 보통 다섯 단계로 나뉜다. 의도와 복잡도 식별, 하위 질의 생성, 고도로 중복된 하위 질의 필터링, 병렬 검색, 답변 합성 및 인용 첨부. 세 번째 단계가 가장 쉽게 간과된다. 시스템은 중복보다 커버리지를 선호하며, 내용이 유사한 두 페이지는 일반적으로 동시에 검색에 포함되지 않는다.
규모 측면에서 공개된 관측치는 대략 다음과 같다. AI Mode는 단일 질문당 약 812개의 병렬 하위 질의를 생성하며(실측에서는 흔히 38개), ChatGPT는 평균적으로 네트워크 검색 1회당 4.7개의 하위 질의를 생성한다. "수백 번 검색"은 Deep Search 같은 다중 라운드 파이프라인에만 적용되며 상한은 약 20라운드다. 더 중요한 것은 하위 질의의 형태다. 역방향 분석에 따르면 평균 길이가 7080단어에 달해 전통적인 34단어 키워드보다 복잡도가 약 17~26배 높다(MaximusLabs). 엔진은 당신의 키워드로 검색하는 것이 아니라, 맥락과 사용 시나리오가 포함된 완전한 설명으로 검색한다.
팬아웃은 무조건 발생하지도 않는다. 관련 특허는 하위 질의 생성 여부를 입력 길이, 질의 빈도, 결과 품질, 토큰 수, 서버 부하와 연결한다. 짧은 내비게이션형 또는 단순 사실형 질문은 원래 질문에 가까운 검색을 한 번만 수행하는 경우가 많고, 긴 비교형·평가형 질문에서만 가장 큰 분기 트리가 펼쳐진다. 따라서 예산은 복잡한 상업적 질문에 우선 배분해야 한다.
검색 의도가 "한 단어"에서 "질문 체인"으로 변하다
내비게이션, 정보, 상업적 조사, 거래라는 네 가지 의도 유형은 여전히 유효하지만, AI 검색에서는 하나의 주 의도가 여러 층의 하위 의도로 확장된다. "How do I choose the best SEO tool for my business?"를 예로 들면, 주 의도는 도구 선택이지만 하위 의도에는 다음이 포함된다. 나에게 어떤 유형의 도구가 필요한가? 예산은 얼마인가? 어떤 기능이 핵심인가? 기술 SEO 역량이 필요한가? 초보자와 에이전시에는 각각 무엇이 적합한가?
여기서 자주 혼용되는 두 개념을 구분해야 한다. 키워드 클러스터링은 유사한 단어를 의도, 의미, SERP 중복도에 따라 그룹화하여 콘텐츠 구성을 해결하고, Query Fan-Out은 하나의 질문이 여러 검색 경로로 분화되는 방식(사용자가 결코 명시하지 않은 주제 포함)을 설명하여 검색 발생 방식을 해결한다(SEO for Today). 전자는 편집 방법이고 후자는 엔지니어링 메커니즘이므로 서로 대체할 수 없다.
표: 여덟 가지 하위 질의 유형과 필요한 콘텐츠 형태
팬아웃 분기를 분류하면 하나의 질문은 보통 여덟 가지 하위 질의를 생성하며, 각 유형에 필요한 단락 형태가 다르다. 이 표는 콘텐츠 자체 점검 목록으로 바로 사용할 수 있다.
| 하위 질의 유형 | 예시 | 필요한 콘텐츠 형태 |
|---|---|---|
| 정확 매칭 | best CRM software | 옵션을 직접 제시하는 답변 블록 |
| 의미 변형 | top CRM platforms | 구매자의 다른 표현으로 동일한 답변을 재진술 |
| 내비게이션형 | 특정 벤더 가격 페이지 | 크롤링 가능하고 구조가 명확한 제품 또는 가격 페이지 |
| 비교형 | A vs B for small business | 명확한 속성이 포함된 표 행 |
| 정의형 | what is pipeline attribution | 단독으로 성립하는 30~50자 짧은 정의 |
| 절차형 | how to migrate CRM data | 번호 단계, 한 단계에 하나의 행동 |
| 목록형 | CRM tools for agencies | 필터 조건이 포함된 스캔 가능한 목록 |
| 시나리오형 | CRM for a 3-person team | 팀 규모와 사용 시나리오를 명시한 한정 문장 |
순수 산문 페이지는 보통 이 중 두세 가지 유형만 커버한다. 표가 없으면 비교 분기에 추출할 내용이 없고, 번호 단계가 없으면 절차 분기가 비며, 팀 규모를 쓴 적이 없으면 시나리오 분기가 매칭되지 않는다. 형식은 여기서 레이아웃 취향이 아니라 검색 가능성 그 자체다.
하나의 키워드에서 완전한 질문 체인으로: 다섯 단계 실천법
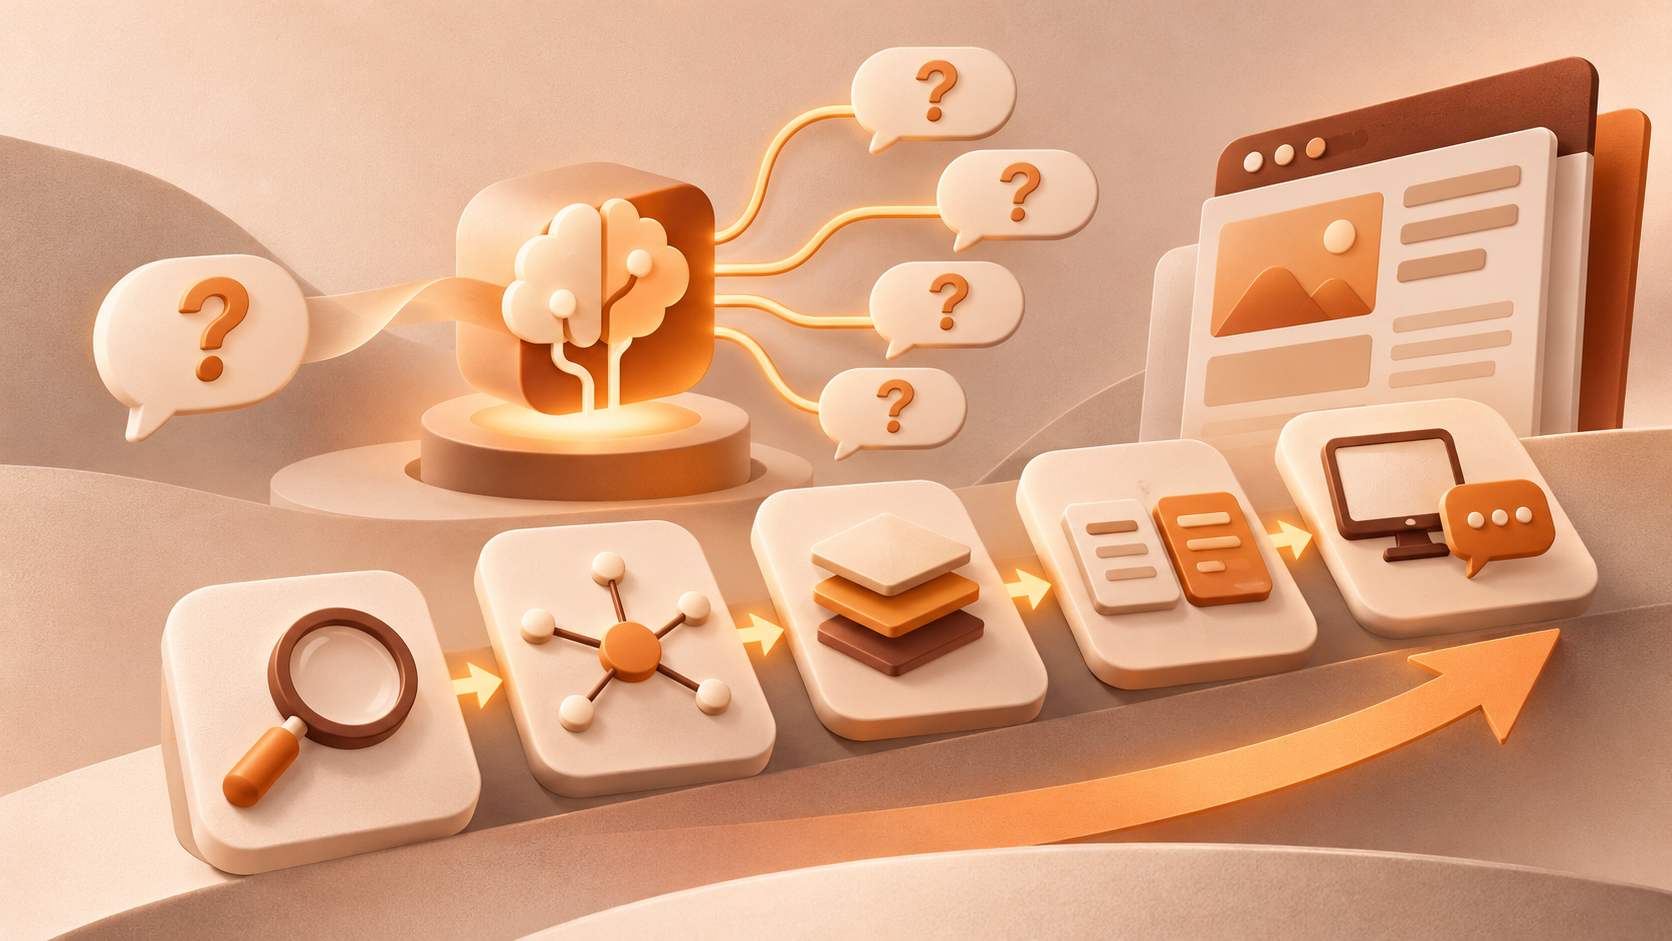
첫째, 키워드가 아닌 시드 프롬프트를 나열한다. 이상적인 고객이 데모 예약 전에 실제로 입력할 질문 10~20개를 수집하며, 구어체일수록 좋다.
둘째, 각 시드를 Perplexity에서 실행한다. 이 인터페이스는 실제 실행된 검색을 보여주며, 현재 팬아웃 행동을 관찰할 수 있는 몇 안 되는 곳이다.
셋째, 그것이 가져온 5~8개의 관련 질문을 원문 그대로 기록하고, 키워드로改写하지 않는다.
넷째, AlsoAsked 같은 Q&A 도구로 동일한 시드 그룹을 교차 확인하여 누락된 분기를 보완한다.
다섯째, 살아남은 하위 질문을 기존 페이지의 H2와 H3에 매핑한다. 원칙은 "하나의 하위 질의에 하나의 페이지"가 아니라 "하나의 질문 클러스터에 하나의 페이지"다. 각 하위 질의마다 별도의 얇은 페이지를 만들면 권위도가 희석되고, Google의 대규모 콘텐츠 남용 정책 경계에 닿을 수 있다(MaximusLabs).
실제 분기 트리는 대화형이고 개인화되어 있어 외부에서 완전히 재현할 수 없다는 점을 분명히 해야 한다. 질문 체인은 재구성된 근사치이며, 커버리지 계획에는 적합하지만 정확한 데이터로 외부 보고에 사용하기에는 적합하지 않다.
몇 분 만에 쇼케이스 사이트를 만들고 리드를 늘리세요
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
콘텐츠 클러스터: 질문 체인을 3층 구조로 만들기
실행 시 세 층으로 나눌 수 있다. 필러 페이지는 "이 결정을 어떻게 내려야 하는가의 완전한 프레임워크"에 답하고, 하위 페이지는 독립적 검색 수요가 있는 하위 질문(예: 특정 유형 솔루션 비교, 특정 업종의 가격 구조)을 담당하며, FAQ 블록은 가지 질문(예: 호환성, 환불, 최소 사양)을 담당한다.
하위 질문을 별도 페이지로 만들지 판단할 때는 세 가지 검사를 사용한다. 실제 대화에서 단독으로 질문되는가? 그 답변 작업을 필러 페이지가 주제를 벗어나지 않으면서 수행할 수 없는가? 동일 계층 페이지와 겹치지 않는 지점을 한 문장으로 설명할 수 있는가? 세 가지 모두 통과해야 새 페이지를 만든다.
동시에 하단 퍼널의 우선순위 차이를 인식해야 한다. 구매형 질문의 팬아웃은 보통 가격, 플랜, 무료 한도, 환불 정책, 경쟁사 비교에 집중되므로 비교 페이지와 가격 페이지가 정의 페이지보다 구매 경로에 들어가기 쉽다. 정의형 질문은 엔진이 스스로 답하는 경우가 많아, 그것을 얻는 것은 대개 한 번의 언급을 얻는 것에 그친다.
FAQ와 제품 페이지는 어떻게 역할을 나눠야 할까
둘은 서로 다른 검색 작업을 맡으며, 섞으면 양쪽 모두 나빠진다. 제품 페이지의 목표는 "나에게 적합한가"를 명확히 하는 것이다. 누구에게 적용되는지, 어떤 역량을 포함하는지, 경계는 어디인지, 가격 구조는 어떤지, 어떻게 시작하는지. 팀 규모, 사용 시나리오, 통합 항목, 제한 조건을 명시적으로 써야 하는데, 이것이 바로 시나리오형 하위 질의가 매칭에 사용하는 한정 정보이기 때문이다.
FAQ의 목표는 의사결정 마찰을 제거하고, 본줄기에 들어가지 않지만 사용자가 반드시 묻는 가지 질문에 답하는 것이다. 각 답변은 문맥 없이도 독립적으로 성립해야 한다. 대명사를 실제 엔터티 이름으로 바꾸고, 결론을 먼저 제시한 뒤 조건을 보충하며, 길이는 수십 자로 제한한다.
페이지 내부의 구조 순서도 검색 결정이다. 인용 모드 관측에서 약 44%의 인용 점유가 본문 앞 30%에 집중되고 이후 점차 감소한다(MaximusLabs). 따라서 가장 상업적인 답변은 페이지 마지막이 아니라 앞 3분의 1에 나타나야 한다.
검색 엔진과 대화형 검색을 동시에 커버할 수 있을까
대부분의 경우 가능하며, 중복이 생각보다 크다. 몇 가지 주요 진입점의 선호는 충돌하지 않는다. AI Mode는 하위 주제 커버리지와 단락 명확성을 중시하고, ChatGPT는 자기 완결형 Q&A 블록과 전문성 신호를 중시하며, Perplexity는 시의성과 출처 투명성을 중시하고, Claude의 리서치 모드는 깊이와 방법을 중시한다. 이들의 교집합은 답변 전치, 출처 가시성, 평이한 언어, 본문의 실제 깊이다.
주목할 방향성 변화가 있다. 공개 관측에서 AI Overview 인용은 상위 10개 자연 결과에 대한 의존도가 약 76%에서 약 38%로 떨어졌고, 상당 비율의 인용이 100위 밖 위치에서 나왔다(MaximusLabs). 그 의미는 "순위가 쓸모없다"가 아니라 "순위가 더 이상 인용의 유일한 문턱이 아니다"이며, 단락이 추출 가능하고 질문에 직접 답할 수 있는지의 가중치가 분명히 상승했다.
기본기는 여전히 해야 한다. 기술적 크롤링 가능성, 콘텐츠 구조, 내부 링크, 구조화 데이터는 여전히 AI 검색 경험에 진입하기 위한 전제다(Google Search Central).
기업이 지금 해야 할 일: 여섯 가지 점검 목록
| 우선순위 | 행동 | 완료 기준 |
|---|---|---|
| 1 | 10~20개의 실제 고객 질문으로 키워드 목록 대체 | 각 항목이 완전한 구어체 의문문 |
| 2 | Perplexity에서 실행하고 후속 질문 기록 | 각 시드당 최소 5개 분기 기록 |
| 3 | 핵심 상업 페이지에 여덟 가지 하위 질의 커버리지 자체 점검 | 여덟 유형 중 최소 여섯 유형 커버 |
| 4 | 각 H2 아래에 독립 답변 블록 추가 | 대명사를 엔터티 이름으로, 결론 먼저 조건 나중 |
| 5 | 가장 상업적인 블록을 앞 3분의 1로 전진 배치 | 첫 화면 이후 한 화면 내에 등장 |
| 6 | 각 질문 클러스터에 유일한 귀속 페이지 지정 | 동일 질문에 답하는 두 페이지가 없음 |
동시에 일부 검색량 판단은 유지한다. 그것은 여전히 수요 규모를 추정하고 우선순위를 정하며 계절성을 판단하는 저비용 신호다. 진정으로 포기해야 할 것은 "검색량이 높으면 쓰고 낮으면 쓰지 않는다"는 단선 규칙이다.
we0는 이 체인을 어떻게 이어받는가
질문 체인이 콘텐츠 자산이 되려면 결국 웹사이트에 정착해야 한다. 페이지 구조, FAQ 블록, 비교 표, 구조화 데이터, 다국어 버전, 이후 업데이트 리듬까지. we0.ai가 제공하는 경로는 웹사이트 구축과 콘텐츠 성장을 하나의 워크스페이스에 두는 것이다. 자연어로 요구 사항을 설명하면 여러 Agent가 협업해 실행 가능한 페이지를 생성하고, 시각적 캔버스에서 조정한 뒤 자체 도메인에 배포하며, CMS 백엔드로 콘텐츠를 지속적으로 유지 관리하고, 사이트 측에서 SEO와 GEO 관련 설정을 처리한다(we0.ai).
질문 클러스터를 빠르게 검증해야 하는 팀에게 이러한 통합의 가치는 "얼마나 빨리 생성하는가"가 아니라, 한 문장의 요구에서 페이지 게시, 다시 질문 체인에 따른 커버리지 점검까지, 중간에 서너 개 도구 사이를 오가며 콘텐츠와 문안을 옮길 필요가 없다는 데 있다.
FAQ
Q: 키워드 검색량은 여전히 봐야 하나?
그렇다. 다만 수요 규모와 우선순위를 판단하는 데 사용해야 하며, 주제 선정의 유일한 근거가 되어서는 안 된다. 검색량은 하위 질의 분기, 답변 형태, 의도 계층을 반영하지 못하며, 이 세 가지는 질문 체인 연구로 보완해야 한다.
Q: Query Fan-Out과 키워드 클러스터링은 같은 것인가?
아니다. 키워드 클러스터링은 의도와 의미에 따라 유사한 단어를 그룹화하여 콘텐츠 구성에 사용하고, 쿼리 팬아웃은 엔진이 하나의 질문을 여러 하위 질의로 나누어 병렬 검색하는 메커니즘으로 검색 행동을 설명한다.
Q: 내 페이지가 인용될 수 있는지 어떻게 판단하나?
추출 가능성에서 시작한다. 각 섹션에 독립적으로 성립하는 답변 블록이 있는지, 엔터티와 적용 시나리오를 명시했는지, 표나 단계가 있는지, 출처가 보이는지. 이는 모두 수동으로 확인할 수 있으며 제3자 점수에 의존할 필요가 없다.
Q: 소규모 팀이 전체 연구를 할 예산이 없으면 어떻게 하나?
최소 폐쇄 루프부터 한다. 실제 고객 질문 10개를 선택하고 대화형 검색을 실행해 분기를 기록하며, 핵심 상업 페이지에 표, 단계, 답변 블록을 보완하고, 분기별로 재실행하며 날짜를 표시해 결과 변화가 콘텐츠 조정에서 온 것인지 엔진 업데이트에서 온 것인지 구분한다.
Related Tools
- Google Search Central의 AI 기능 문서: 공식 입장과 기본 요구 사항 확인.
- Perplexity: 인터페이스에서 검색 과정을 볼 수 있어 팬아웃 행동 관찰에 적합.
- AlsoAsked: 키워드별 질문 클러스터를 가져와 누락된 분기 보완.
- we0.ai: 웹사이트 구축부터 콘텐츠 운영, SEO/GEO 설정까지 통합된 워크스페이스.
Related Links
- Google Search Central — AI features and your website
- MaximusLabs — What is Query Fan-Out?
- SEO for Today — Query Fan-Out: How AI Search Is Changing Keyword Research
- we0.ai — AI 智能建站与获客工作台
Summary
검색량은 무효화되지 않았다. 그것은 '주제 선정 근거'에서 '수요 규모 참고 지표'의 위치로 물러났을 뿐이다. 키워드 리서치의 새로운 작업은 하나의 단어를 완전한 질문 체인으로 확장하고, 각 질문에 추출 가능한 답변 형태를 준비하며, 단어가 아닌 질문 클러스터로 페이지를 배분하는 것이다. 이렇게 하면 전통적 검색 결과와 스스로 쿼리를 재작성하는 대화형 검색을 모두 지원할 수 있다. 판단 기준도 함께 변한다. 이 단어에 검색량이 얼마나 있는지가 아니라, 사용자가 네 번째, 다섯 번째 질문까지 연속追问했을 때 당신의 사이트가 여전히 인용되는 그 하나의 답변이 될 수 있는지다.