For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/claude-code-loop-engineering-four-ways.md.
Claude Code의 네 가지 루프 엔지니어링 방식인 턴 기반, 목표 기반, 예약 실행, 선제적 루프를 정리하고 트리거·검증·권한·예산·중지 조건을 설명합니다.
단순히 편집이 성공했다고 해서 UI 변경이 완료되었다고 말하지 마세요.
검사 중 하나라도 실패하면 문제를 해결하고 1단계부터 다시 실행하세요.
핵심은 표현 자체가 아니라, 이 기술을 통해 Claude가 수동 검토자와 동일한 증거 기반을 확보할 수 있다는 점에 있습니다.
정량적 검사가 특히 효과적입니다:
검증 과정을 더 정량화할수록, 수동 개입 빈도는 낮아집니다.
단일 실행으로 충분하지 않을 수 있지만, 종료 지점을 명확히 설명할 수 있을 때 목표 기반 반복 메커니즘이 특히 유용합니다.
Claude Code는 작업 에이전트가 결과가 "충분히 좋은지" 스스로 판단하게 하지 않고, 각 실행 후 독립적인 평가기를 사용합니다.
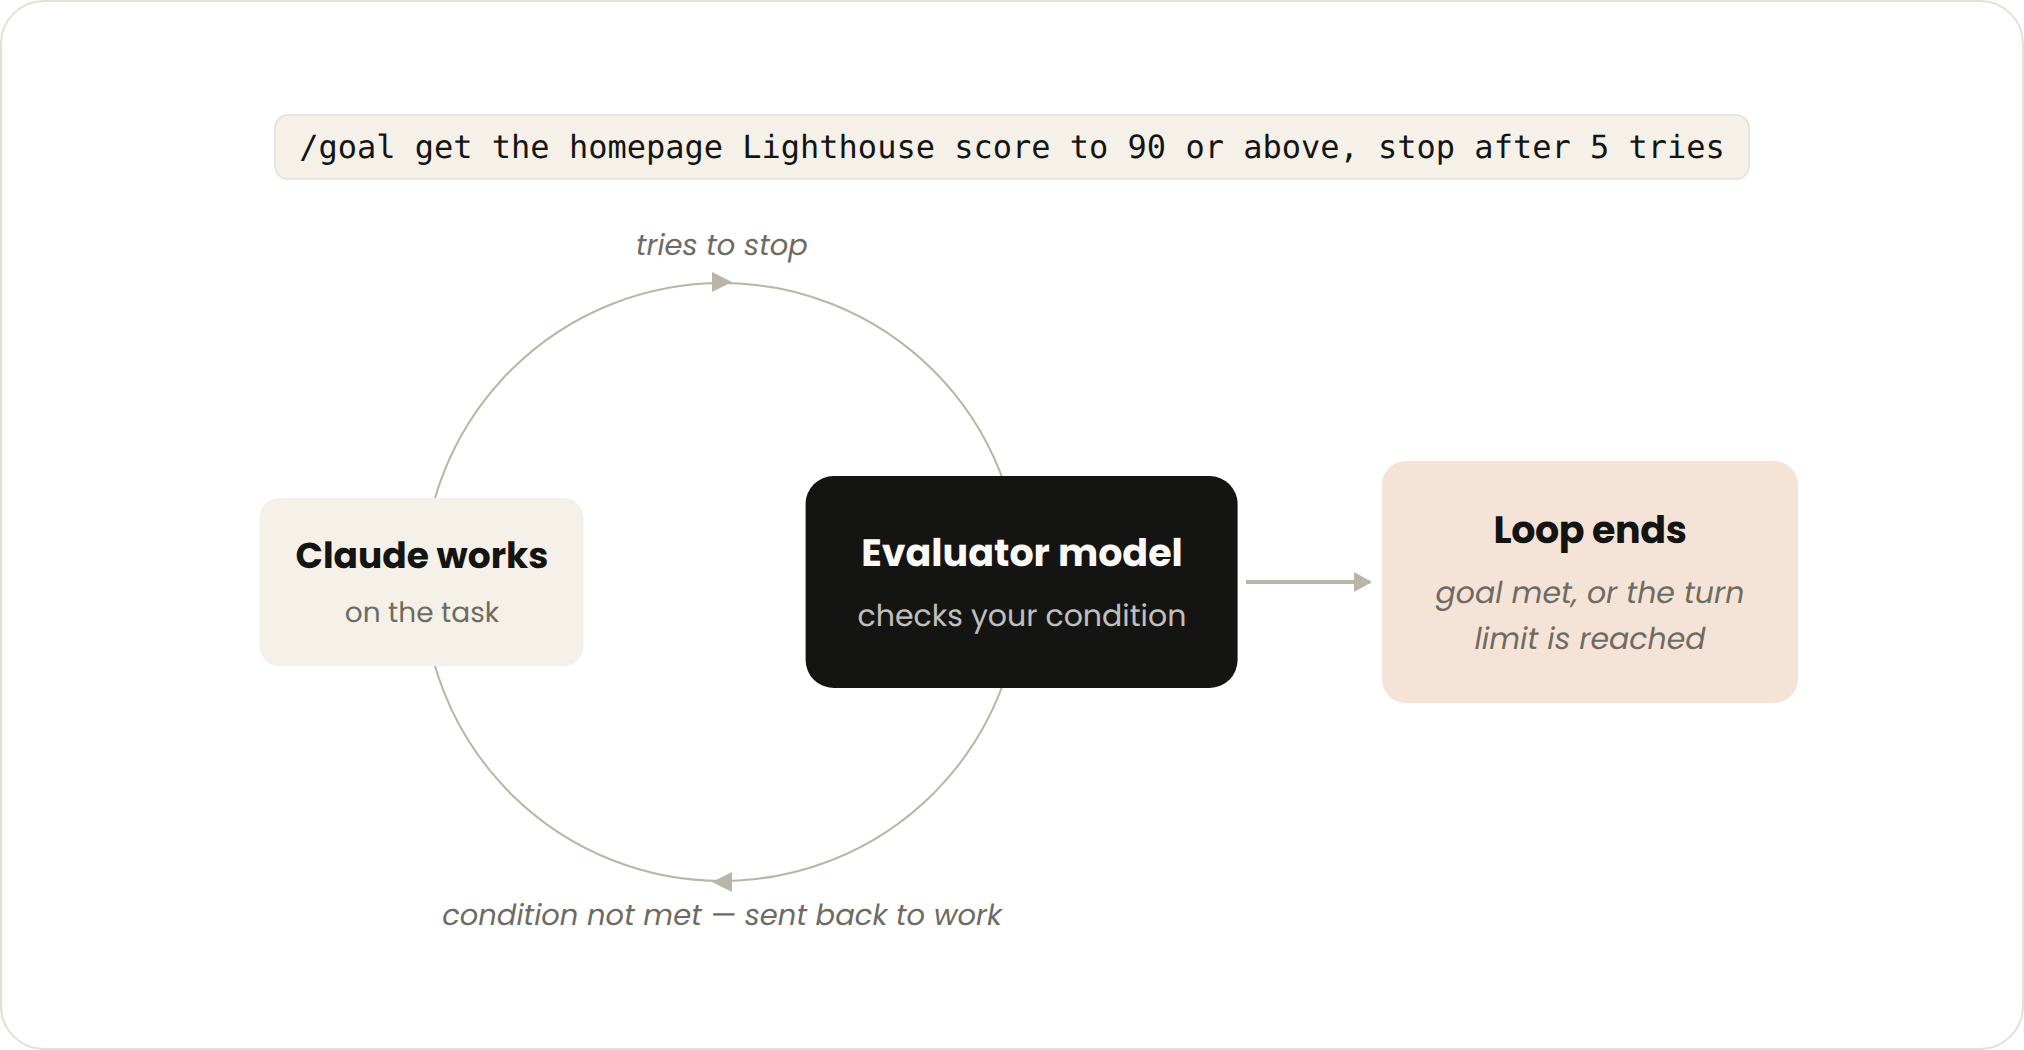
사용자가 현재 세션에서 목표를 시작합니다.
다음과 같은 경우 반복이 종료됩니다:
목표 기반 반복은 검증 가능한 종료 지점이 있는 작업에 적합합니다. 예를 들어:
Anthropic의 공식 예시는 다음과 같습니다:
/goal 홈페이지 Lighthouse 점수를 90점 이상으로 올리고, 5회 시도 후 중지
또 다른 실용적인 예시:
/goal test/auth 디렉토리의 모든 테스트 통과 및 lint 단계 오류 없음
현재 Claude Code 문서에 따르면, /goal 명령어는 Claude Code 버전 2.1.139 이상이 필요합니다.
Claude가 한 라운드의 작업을 완료하면, 경량 고속 평가기 모델이 조건이 충족되었는지 확인합니다.
조건이 충족되지 않으면 자동으로 새로운 라운드가 시작되고, 조건이 충족되면 현재 목표가 지워지고 세션 제어권이 사용자에게 반환됩니다.
이러한 분리가 중요한 이유는 작업 모델이 자신의 출력에 대한 유일한 판단자가 되어서는 안 되기 때문입니다.
효과적인 완료 조건은 다음을 갖추어야 합니다:
약한 목표:
/goal 홈페이지 개선
"개선"이라는 단어는 측정 가능한 종료 지점을 정의하지 않습니다.
강한 목표:
/goal 모바일 Lighthouse 성능 점수를 최소 90점 이상으로 올리고,
접근성 점수를 95점 이상으로 유지하며, 5회 시도 후 중지
약한 목표:
/goal 테스트 수정
강한 목표:
/goal test/payments 디렉토리의 모든 테스트 통과, 건너뛴 테스트 없음,
npm run lint 명령어 종료 코드 0
모델이 성공의 의미를 추측해서는 안 됩니다.
/goal 은 권한을 변경하지 않습니다목표는 여러 라운드에 걸쳐 지속되지만, 모든 도구 호출을 자동 승인하지는 않습니다.
기본 권한 모드에서 Claude는 아직 허용되지 않은 명령에 대해 여전히 일시 중지 확인을 요청할 수 있습니다.
무인 목표 실행의 경우, Anthropic은 가능하고 적절할 때 /goal 을 자동 모드와 함께 사용할 것을 권장합니다. 이는 허용된 도구, 저장소 경계 및 가능한 부작용을 검토한 후에 이루어져야 합니다.
/loop 및 /schedule일부 작업은 이전 라운드의 완료가 아니라 시간에 의해 트리거됩니다.
작업은 유사하게 유지되지만, 입력이 변경됩니다:
각 실행은 구성된 시간 간격 또는 일정에 따라 시작됩니다.
로컬 반복은 사용자가 취소하거나, 환경을 종료하거나, 모니터링 작업이 완료되면 중지됩니다.
클라우드 루틴은 일시 중지 또는 비활성화될 때까지 구성에 따라 계속 실행됩니다.
시간 기반 반복은 다음에 적합합니다:
공식 예시는 /loop 를 사용합니다:
/loop 5m 내 풀 리퀘스트 확인, 리뷰 의견 처리, 실패한 CI 수정
이 프롬프트는 구성된 간격으로 재실행됩니다.
로컬 반복은 현재 머신과 세션에 의존합니다. 컴퓨터가 종료되거나 프로세스가 중지되면 반복도 중지됩니다.
노트북을 닫은 후에도 계속 실행되어야 하는 작업의 경우, Claude Code는 /schedule 을 사용하여 클라우드 루틴을 생성할 수 있습니다.
활성 루틴은 다음과 같이 시작될 수 있습니다:
/schedule 1시간마다: #project-feedback 의 새 버그 보고서 확인
Claude Code 루틴은 Anthropic 관리 클라우드 인프라에서 실행되며, 다음에 의해 트리거될 수 있습니다:
이 문서 작성 시점에서 루틴은 연구 프리뷰 단계이므로, 동작, 제한 사항 및 API 인터페이스가 변경될 수 있습니다. 가용성은 관련 Claude 플랜, 조직 정책 및 웹 기반 Claude Code 활성화 여부에 따라 달라집니다.
일반적인 실수는 외부 시스템이 변경되는 속도보다 훨씬 더 자주 반복을 실행하는 것입니다.
새 문제가 하루에 몇 번만 발생한다면, 매분 문제 큐를 확인하는 것은 도움이 되지 않습니다. 이는 토큰 사용량, 도구 호출 횟수를 증가시키고——
노이즈만 추가할 뿐 결과에는 영향을 미치지 않습니다.
폴링 간격을 예상 변경 빈도와 일치시키십시오:
| 외부 변경 패턴 | 합리적인 시작 폴링 빈도 |
|---|---|
| 활발한 푸시 이후 CI 상태 | 5–10분마다 |
| 팀 피드백 채널 | 30–60분마다 |
| 일일 Slack 요약 | 하루에 한 번 오전 |
| 의존성 업데이트 | 매일 또는 매주 |
| 문서 표류 | 매일 밤 또는 매주 |
이는 시작 제안일 뿐이며 보편적인 규칙은 아닙니다. 외부 시스템이 지원할 때는 일반적으로 폴링보다 이벤트 트리거가 선호됩니다.
능동적 반복은 앞서 설명한 기본 요소들의 조합입니다.
무인 상태로 실행되며, 계획된 작업 또는 들어오는 작업에 응답하고, 각 작업 항목을 정의된 프로세스를 통해 처리합니다.
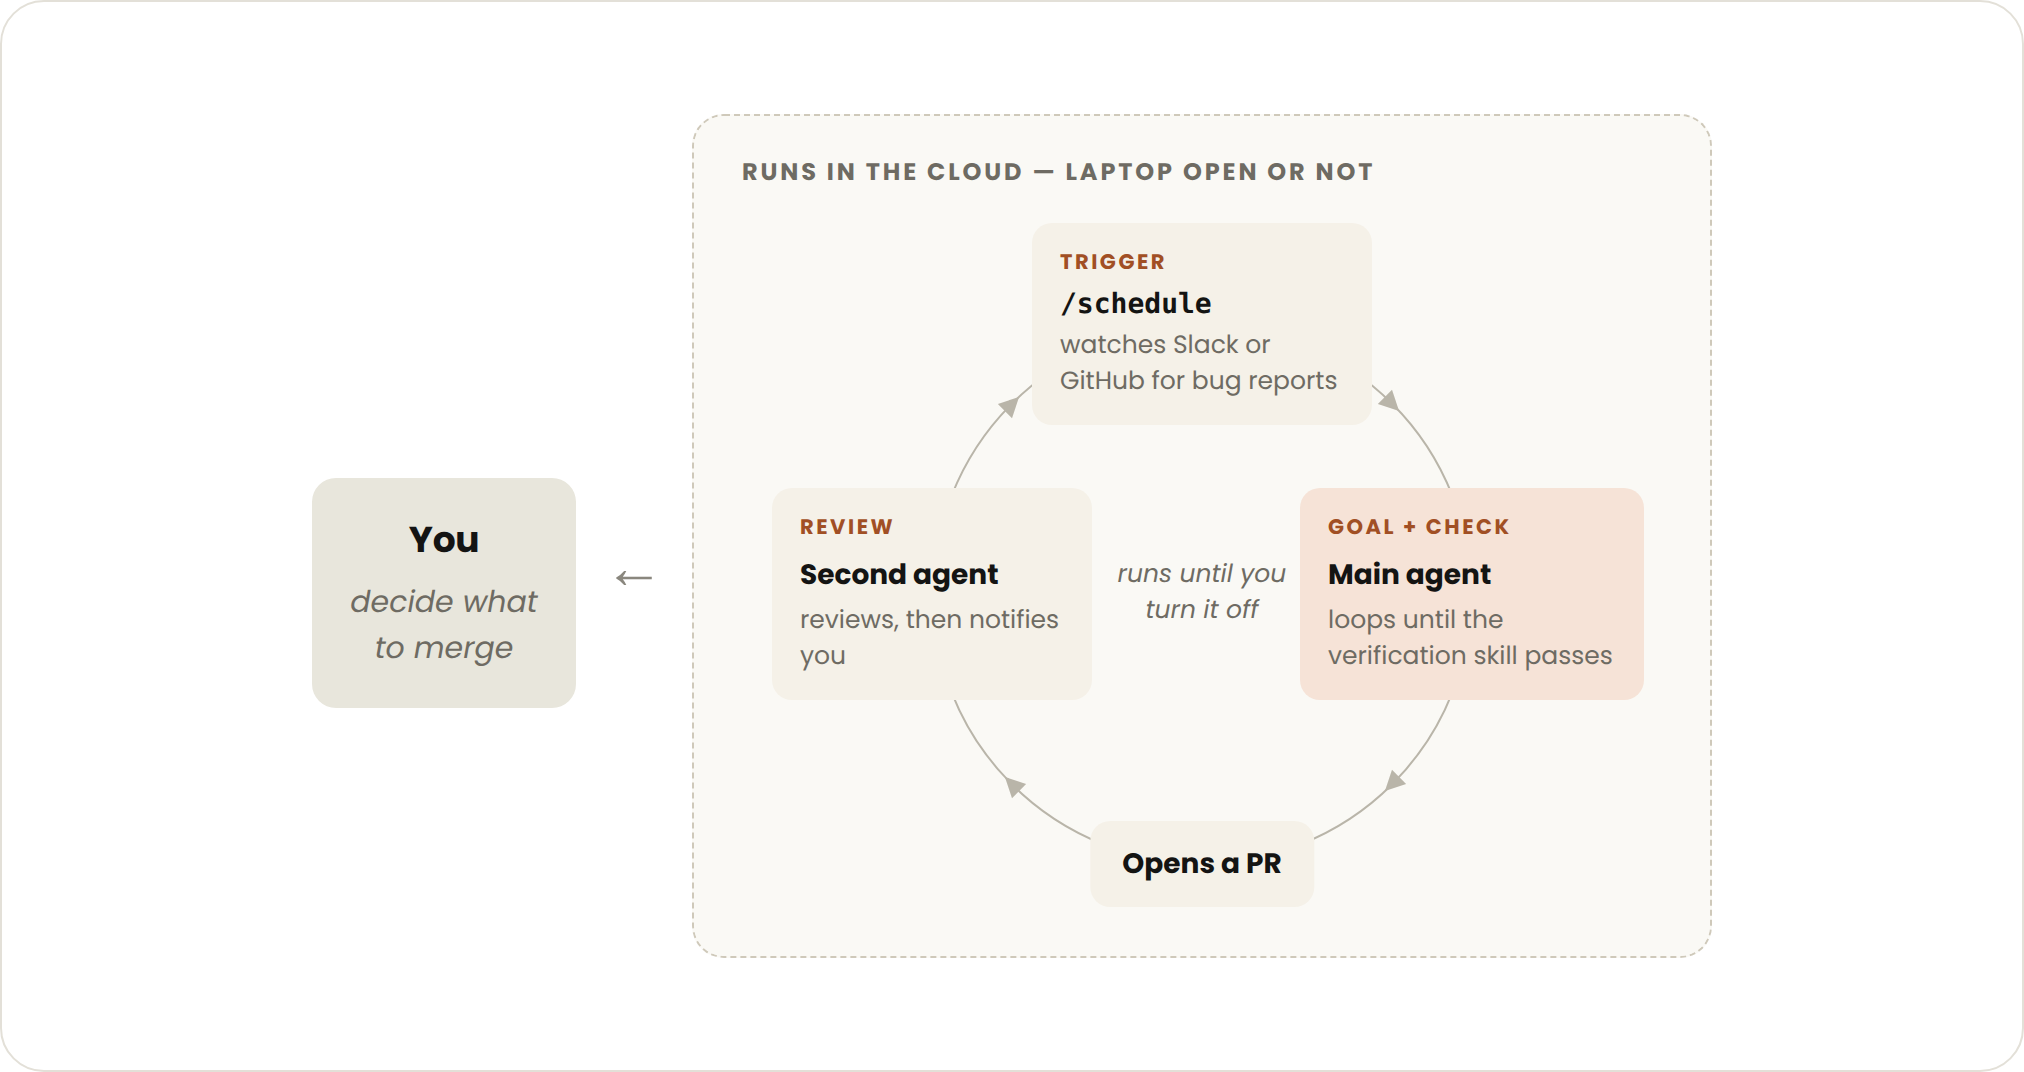
スケジュールタスク、APIリクエスト、GitHubイベント、メッセージ、問題、またはその他の外部シグナルによってワークが開始されます。
各独立タスクは、目標達成後に終了します。
周囲のルーチンは、誰かが無効にするまで将来のワークを受け取り続けます。
アクティブループは、明確に定義された反復的なワークフローに適しています。
Anthropicの例では、Claude Codeのいくつかの機能を組み合わせています。
/schedule 新しいレポートを確認します。/goal 1回の実行で完了する必要がある内容を定義します。組み合わせた指示は次のようになります。
/schedule 1時間ごと: #project-feedback のバグレポートを確認します。

/goal: この実行で見つかった各レポートについて、
トリアージ、処理、返信が完了するまで停止しません。

バグ修正時は、並行作業ツリーで3つのソリューションを探索し、
独立したレビュアーによるレビューを受けるワークフローを使用します。
これはもはや単なる繰り返しのプロンプトではありません。これは、狭いワークフローのための小さなオペレーティングシステムです。
動的ワークフローは、サブエージェントを大規模に調整するためのスクリプトです。
ClaudeがJavaScriptオーケストレーションスクリプトを作成し、実行環境がバックグラウンドでそれを実行します。中間結果はスクリプト変数に保持でき、メインの会話コンテキストを満たすことはありません。
Anthropicは、以下のタスクにワークフローを位置付けています。
現在のドキュメントでは、動的ワークフローには Claude Code バージョン 2.1.154 以降が必要とされています。これらは数十または数百のエージェントを調整できるため、大規模な本番タスクを実行する前に、小規模なパイロットを実施する必要があります。
スケジュールタスク、オーケストレーション、フィードバックループ、ワークキューは、新しいエンジニアリングコンセプトではありません。
真の変化は、コーディングエージェントがループにもっと深く関与できるようになったことです。
プロンプトは消え去ったわけではありません。それは、より大きな制御システムの構成要素になったのです。
現在、より重要な設計上の問題は次のようになります。
巧みに作られたプロンプトは、欠落した停止条件を補うことはできません。
Anthropicは検証を繰り返し強調しています。Claudeが自身の出力をチェックし測定できるようにすることです。
人間のエンジニアがブラウザアクセス権なしでページを構築するように求められたら、盲目的に作業することになります。エージェントも同様です。
有用な検証ツールは次のとおりです。
終了コード 0 または 1 を返すスクリプトは、多くの場合、モデルに要件が満たされているかどうかをゼロから推論させるよりも、安価で信頼性が高くなります。
例:
npm test
npm run lint
npm run typecheck
組み合わせた検証スクリプトは次のようになります。
#!/usr/bin/env bash
set -euo pipefail

npm run typecheck
npm run lint
npm test
Claude は、変更のたびにこのスクリプトを実行できます。このループは、承認プロセス全体を毎回再解釈する必要がありません。
Anthropic はまた、新しいコンテキストを持つレビューアの使用を提案しています。
実装エージェントは自身の推論プロセスを見ているため、同じ仮定を繰り返す可能性があります。独立したレビューアはそのパスにそれほど縛られず、別の角度から結果をチェックできます。
価値の高い変更には、システムは以下を使用できます。
エージェントが多ければ良いというものではありません。レビューの価値が追加コストを正当化する場合にのみ、それらを追加してください。
無限に続く可能性のあるループは、強力であると同時に危険でもあります。
主な障害モードは3つあります。
各ラウンドのループは、入力トークン、出力トークン、ツール呼び出し、有料モデルの使用量を消費する可能性があります。
ラウンド数や予算の上限がない場合、オープンエンドのループは、わずかな付加価値しか生み出さないまま、費用を消費し続ける可能性があります。
Claude Agent SDK は以下をサポートしています。
max_turns / maxTurnsmax_budget_usd / maxBudgetUsd公式 SDK ドキュメントは次のように述べています。
デフォルトでは、どちらの制限も設定されていません。
本番環境のエージェントにとって、明示的な制限は妥当なベースラインです。
エージェントが同じファイルを繰り返し編集しても、新しいテストの合格や測定可能な改善が生まれないことがあります。
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
システムが同じ失敗したソリューションの異なるバリエーションをループで試し続けても、ログは依然としてアクティブに見える可能性があります。
進捗がないことを示す有用なシグナルは次のとおりです。
進捗が停滞した場合、堅牢なループは実行を停止するか、エスカレーションする必要があります。
反復により、欠陥のあるソリューションがより正しくなるのではなく、より複雑になる可能性があります。
エージェントは誤った仮定の周りにレイヤーを追加し、期待される動作からますます遠ざかりながら、コードが見かけ上完成に近づいているように見せかける可能性があります。
独立したレビュー、決定論的テスト、明確なロールバックパスは、このような失敗を防ぐのに役立ちます。
実用的なループには、少なくとも3種類のゲートを含める必要があります。
完了状態は、テスト、スクリプト、評価器、または外部状態の観測によって検証可能であるべきです。
例:
少なくとも1つのハードな上限を設定します。
1つのリミットで、無限の失敗を有限の失敗に変えることができます。
システムが目標に向かって進んでいない場合に実行を停止します。
例:
3回連続の試行で新しいテスト合格がなく、
同じファイルが変更されている場合は、実行を停止し、障害を報告します。
本番実装では、これをスクリプトまたはワークフローステータスの追跡によって実現でき、指示だけに依存する必要はありません。
ループは、推論リソースを最も価値の高い部分に投入するように設計されるべきです。
Anthropic は以下のコスト管理手段を推奨しています。
작은 작업에는 멀티 에이전트 워크플로가 필요하지 않습니다.
다음 방식으로 시작하세요:
/goal 사용./loop 또는 /schedule 사용.빠르고 비용 효율적인 모델로 처리 가능한 작업:
강력한 모델은 다음을 위해 아껴두세요:
동적 워크플로는 많은 에이전트를 생성할 수 있습니다.
먼저 소규모로 실행하세요:
전체 백로그.
파일럿 프로젝트는 토큰 소비, 도구 병목, 일반적인 오류, 누락된 제어 지점을 드러냅니다.
프로세스가 결정적일 때는 코드를 한 번 작성하고 Claude가 실행하게 하세요.
예:
시간 기반 루프는 기본 시스템 변화 속도를 반영해야 합니다.
간격이 너무 짧으면 비용만 증가하고 더 나은 결과를 얻지 못합니다.
Anthropic은 소비 확인을 위한 몇 가지 명령을 제공합니다:
/usage
이 명령은 스킬, 서브 에이전트, MCP 통합 등의 영역에서 최근 사용량을 표시합니다.
인수 없이 /goal을 실행하면 현재 목표의 라운드 및 토큰 소비를 표시하고, /workflows는 워크플로 에이전트 사용량을 표시하며 중지 제어 옵션을 제공합니다.
사용 가능 여부는 Claude Code 버전 및 활성화된 기능에 따라 다를 수 있습니다.
자동화를 무제한 액세스와 혼동해서는 안 됩니다.
Claude Code는 실행할 수 있는 도구와 명령을 제어하는 권한 모드를 지원합니다.
개발 머신에서의 자율 작업을 위해 Anthropic은 명시적인 허용 규칙을 유지하거나, 제한된 일반 작업을 자동 승인하면서 고위험 명령은 제어하는 모드를 사용할 것을 권장합니다.
권한을 우회하는 모드는 격리된 환경에서만 사용해야 합니다. 예:
파일 편집, 셸 명령 실행, 외부 시스템 액세스, 풀 리퀘스트 생성이 가능한 능동 루프는 다음을 갖춰야 합니다:
목표는 모든 인간의 결정을 제거하는 것이 아니라, 진정한 판단이 필요한 결정에 인간의 힘을 집중하는 것입니다.
다음 결정 흐름을 참조하세요.
Anthropic은 현재 병목 현상이 있는 작업부터 시작할 것을 권장합니다.
세 가지 질문을 하세요.
예:
유용한 목표는 활동뿐만 아니라 상태를 설명합니다.
더 나은 작성:
모든 결제 테스트 통과, TypeScript 오류 없음.
약한 작성:
결제 모듈 계속 개선.
작업이 매시간, 매일, 매주 발생하거나 알려진 이벤트 후에 발생한다면 루프나 루틴에 적합할 수 있습니다.
어느 하나라도 긍정 대답이면 첫 번째 루프 후보가 있습니다.
실패한 풀 리퀘스트 검사를 반복적으로 수정하는 팀을 상상해 보세요.
현재 PR 확인, 실패한 CI 테스트 수정, 변경 사항 설명.
개발자는 CI가 변경될 때마다 이 작업을 수동으로 다시 실행합니다.
다음을 수행할 수 있는 스킬 생성:
/goal 모든 필수 CI 검사 통과, 4회 시도 후 중지
세션은 여러 번의 수정 시도를 계속할 수 있습니다.
/loop 10m PR 확인, 새 리뷰 코멘트 처리,
실패한 필수 검사 수정.
에이전트가 외부 변화를 확인합니다.
풀 리퀘스트 이벤트 또는 일정에 의해 트리거되는 클라우드 루틴 생성.
다음으로 제한:
진화는 점진적입니다. 각 단계는 이전 단계에서 신뢰할 수 있는 검사가 확보된 후에만 자동화를 추가합니다.
"코드베이스 개선"은 무한정 계속될 수 있습니다.
관찰 가능한 결과로 분할하세요.
테스트, 스크립트 또는 독립 평가자를 사용하세요.
단일 에이전트와 강력한 검증자가 조정이 나쁜 대규모 워크플로보다 나을 수 있습니다.
매분 폴링이 본질적으로 더 높은 응답성을 의미하지는 않습니다.
상한선이 없는 루프는 비용이 많이 드는 실패로 이어질 수 있습니다.
권한, 훅, 샌드박스, 격리 환경을 사용하여 결정적 실행을 보장하세요.
동일한 오류가 반복될 때는 이를 생성한 스킬, 규칙, 검증자 또는 워크플로를 개선하세요.
루프 엔지니어링은 중지 조건에 도달할 때까지 반복되는 에이전트 워크플로를 설계하는 것입니다. 프롬프트 내용뿐만 아니라 트리거, 검증, 제한, 권한, 에스컬레이션에 중점을 둡니다.
Anthropic은 루프를 라운드 기반, 목표 기반, 시간 기반, 능동형으로 분류합니다.
이들의 주요 차이점은 새로운 순환을 시작하는 메커니즘과 작업 중단 시점을 결정하는 주체나 요소에 있습니다.
/goal의 역할은 무엇인가요?/goal은 현재 세션에 완료 조건을 설정합니다. 각 라운드가 끝날 때마다 독립적인 평가기가 해당 조건이 충족되었는지 확인합니다. 충족되지 않은 경우 목표에 도달하거나 설정된 제한에 도달할 때까지 다음 라운드가 시작됩니다.
/loop와 /schedule의 차이점은 무엇인가요?/loop는 로컬 머신에서 일정 간격으로 프롬프트를 반복 실행하므로, 머신이나 세션이 중단되면 루프도 함께 중단됩니다. 반면 /schedule은 클라우드에서 정기 작업을 생성하여 Anthropic이 관리하는 인프라에서 계속 실행되므로, 노트북이 꺼져 있어도 영향을 받지 않습니다.
워크플로우에 경계가 없으면 루프 실행 시간이 예상보다 길어질 수 있습니다. 무인 실행을 허용하기 전에 정량화 가능한 완료 조건, 하드 라운드 또는 비용 상한, 그리고 진행이 없을 때 중단하는 규칙을 정의해야 합니다.
아니요. 일반 Claude Code 세션에 재사용 가능한 검증 스킬만으로도 충분할 수 있습니다. 대규모 병렬 처리나 독립적인 검토가 필요한 작업에서 동적 워크플로우와 여러 에이전트가 더 유용하게 사용됩니다.
가장 간단한 루프 유형을 사용하고, 일상적인 작업에는 더 작은 모델을 선택하며, 작은 워크로드에서 시범 운영하고, 결정적 추론은 스크립트로 대체하며, 불필요한 폴링을 줄이고, 명확한 라운드 또는 예산 제한을 설정하세요.
권한, 저장소, 자격 증명, 예산, 중단 조건 및 에스컬레이션 경로가 엄격히 통제된다면 책임감 있게 실행될 수 있습니다. 민감하거나 가치 있는 데이터가 있는 일반 머신에서는 권한 우회 모드를 사용하지 마세요.
SKILL.md에 저장된 재사용 가능한 절차적 명령어, 스크립트 및 리소스입니다./goal 구문, 평가 동작, 상태 제어 및 요구 사항 문서입니다.Claude Code 루프는 단순한 반복 프롬프트가 아니라 트리거, 도구, 검증, 권한, 예산 및 중단 조건이 협력하여 작동하는 통제된 시스템입니다.
라운드 기반 루프는 인간이 각 후속 단계를 제어하게 하고, 목표 루프는 완료 조건을 평가기에 위임하며, 정기 루프는 트리거를 위임합니다. 능동형 루프는 이러한 기본 요소를 조합하여 반복 실행 가능한 무인 워크플로우를 만듭니다.
가장 중요한 개선은 일반적으로 에이전트 수를 늘리는 것이 아니라, 기존 에이전트에 신뢰할 수 있는 자체 점검 메커니즘을 부여하고, 완료 기준을 명확히 정의하며, 진행 상황이나 예산이 소진될 때 시스템을 적시에 종료하는 데 있습니다.
유용한 루프는 영원히 실행될 수 있는 것이 아니라, 언제 중단해야 하는지를 증명할 수 있는 것입니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.



