For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/deepseek-dspark-apple-silicon-mlx-dflash.md.
이 글은 DeepSeek의 DSpark 추측 디코딩 방식이 mlx-dspark를 통해 Apple Silicon으로 포팅되어, 지원되는 Gemma 및 Qwen 모델에서 로컬 Mac 추론을 더 빠르게 만드는 방법을 설명합니다. 핵심은 이 포팅이 단순한 원...
DeepSeek의 DSpark가 오픈소스로 공개된 지 약 일주일 만에 커뮤니티가 이를 Apple 컴퓨터로 가져왔습니다.
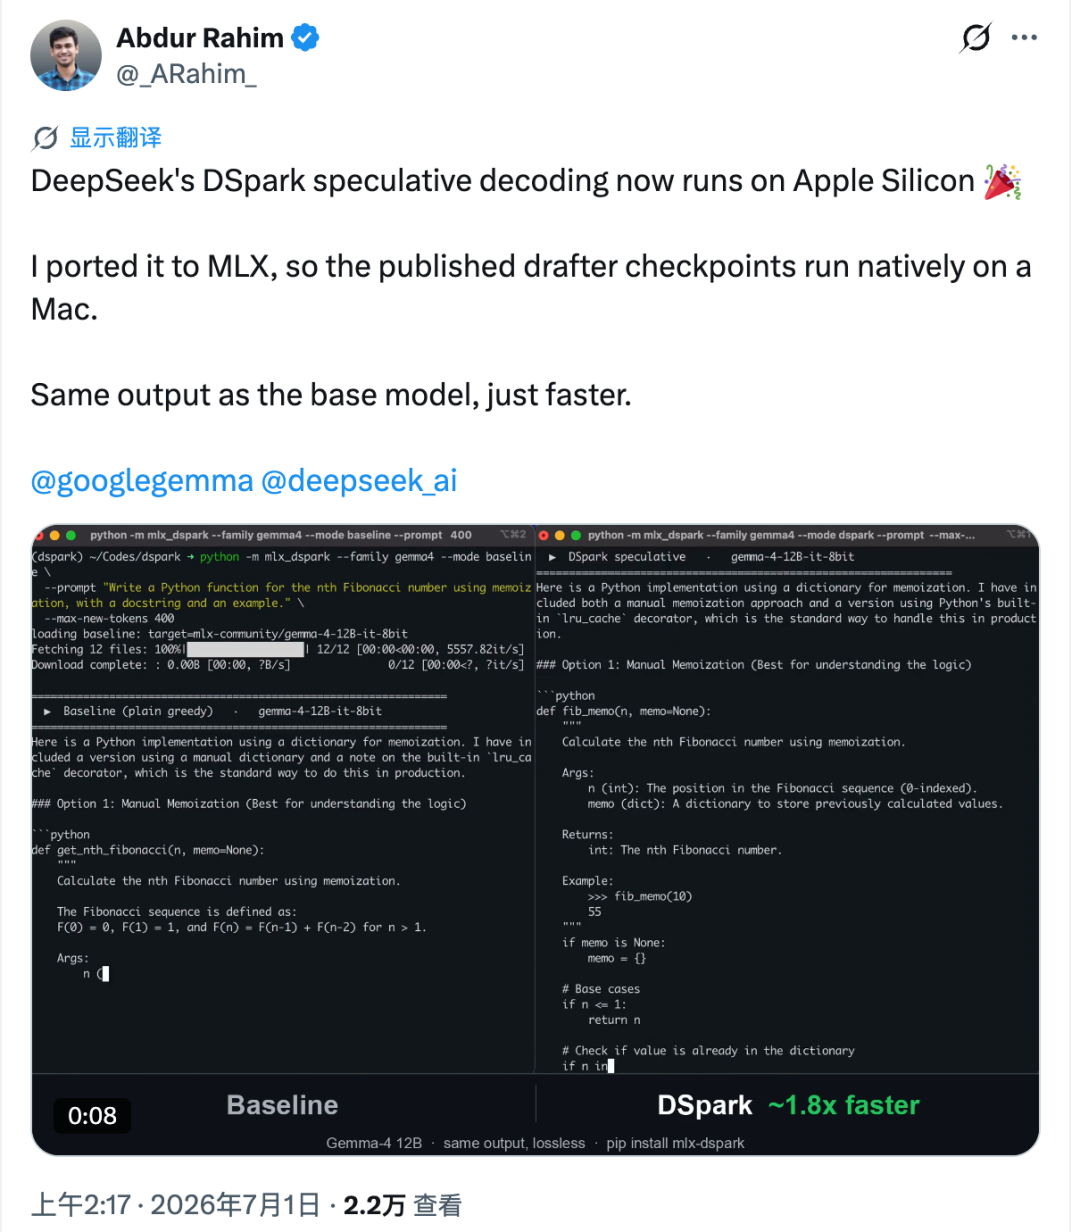
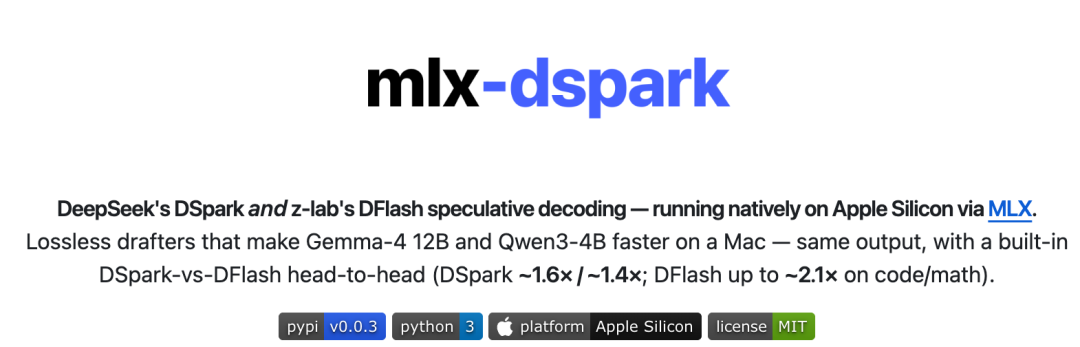
이 포트의 이름은 mlx-dspark입니다. Apple의 MLX 생태계를 통해 Apple Silicon에서 DSpark 스타일의 추측적 디코딩을 네이티브로 실행하며, Gemma-4 12B와 Qwen3-4B 같은 모델에서 테스트되었습니다. 보고된 Mac 벤치마크에서 Gemma-4 12B의 생성 속도는 약 1.6배 빨라졌고, Qwen3-4B는 약 1.4배 향상되었습니다.
이를 더 흥미롭게 만드는 점은 단순한 속도만이 아닙니다. 이 포트는 생성된 출력이 기본 타깃 모델과 일치하도록 유지하는 것을 목표로 하므로, 단순히 모델의 동작을 바꾸는 방식으로 가속을 달성한 것이 아닙니다.
DeepSeek는 6월 27일 DSpark를 추측적 디코딩 접근법으로 공개했습니다. 원래의 서버 측 환경에서 DSpark는 특정 서빙 조건에서 생성 속도를 약 60%~85% 높일 수 있는 방법으로 설명되었습니다.
하지만 처음 제공된 구현은 데이터센터 GPU 환경에 초점을 맞추고 있었습니다. Apple Silicon 네이티브 워크플로는 아니었습니다. 이 상황은 Abdur Rahim이 Mac에서 MLX 기반 추론을 위해 만든 구현인 mlx-dspark로 바뀌었습니다.
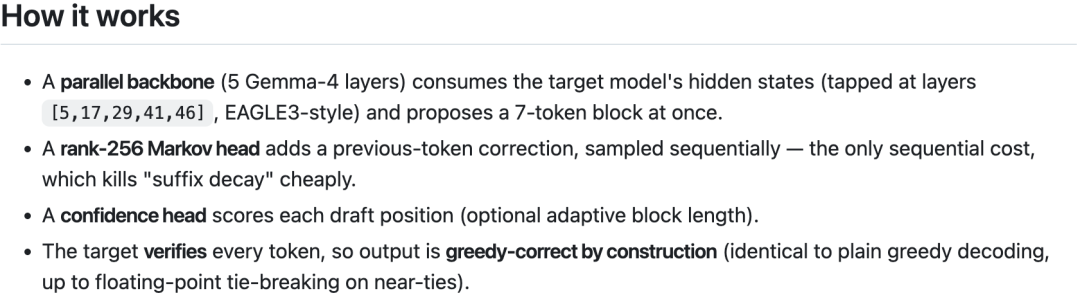
DSpark의 핵심 아이디어는 큰 틀에서 이해하기 쉽습니다.
이것이 추측적 디코딩의 핵심입니다. 더 저렴한 드래프트 경로가 앞서 추측하게 하고, 타깃 모델이 정확성을 검증하게 하는 방식입니다.
서버 GPU에서는 병목이 순수 연산보다 메모리 이동인 경우가 많기 때문에, 토큰 묶음을 검증하는 작업이 비교적 효율적일 수 있습니다. 그런 환경에서는 추가 토큰 몇 개를 검사해도 비용이 크게 늘지 않을 수 있습니다.
Apple Silicon은 다르게 동작합니다. Mac에서는 검증되는 추가 토큰 하나하나가 더 눈에 띄는 지연 시간을 추가할 수 있습니다. Rahim은 이 비용을 측정했고, Apple Silicon에서 이 방식의 가속 상한은 테스트 조건 기준으로 약 2.2배라고 추정했습니다.
이를 실용적으로 만들기 위해 그는 드래프트 체크포인트를 Hugging Face에서 MLX 워크플로로 옮기고, 이를 Gemma-4 12B 및 Qwen3-4B 타깃 모델과 결합했습니다. 검증 흐름은 MLX 내부에서 다시 구축되었고, 드래프트 가중치는 4비트로 양자화되었습니다.
보고된 M4 Pro 테스트에서 Apple의 공식 MLX 도구와 비교한 결과는 다음과 같습니다.
로컬 AI 개발자에게 이는 의미 있는 향상입니다. MacBook이 여전히 데이터센터 추론 서버는 아니지만, 이런 종류의 최적화는 더 큰 로컬 모델을 개발, 테스트, 개인 워크플로에서 더 사용하기 좋게 만들어 줍니다.
대형 모델 가속의 많은 로컬 포트는 먼저 그리디 디코딩에 초점을 맞춥니다. 그리디 디코딩에서는 모델이 각 단계에서 확률이 가장 높은 토큰을 단순히 선택합니다. 이렇게 하면 출력을 토큰 단위로 비교할 수 있기 때문에 정확성 테스트가 더 쉬워집니다.
mlx-dspark는 DSpark 논문에 설명된 temperature 샘플링 방식을 구현함으로써 한 단계 더 나아갑니다. 드래프트 모델이 토큰을 제안하고, 타깃 모델은 확률 기반 규칙을 사용해 이를 승인합니다. 거부된 부분은 다시 샘플링됩니다.
나머지 분포.
이 점이 중요한 이유는 샘플링이 많은 실제 애플리케이션에서 사용되는 방식이기 때문이다. 채팅 인터페이스, 창작 글쓰기, 에이전트 탐색, 제품 카피 생성은 엄격한 그리디 디코딩보다 temperature에 의존하는 경우가 많다.
Rahim은 샘플링 흐름이 동일한 temperature 설정에서 타깃 모델의 분포를 보존하는지 확인했다. 다시 말해 목표는 “충분히 비슷한” 근사치를 만드는 것이 아니다. 이 포트는 가속이 모델이 의도한 출력 동작을 바꾸지 않도록 설계되었다.
포팅 과정에서 얻은 몇 가지 실용적인 교훈도 있었다.
그 결과 단순히 더 빠르게 실행되는 것 이상의 로컬 구현이 만들어졌다. 또한 사용자가 원래 타깃 모델에서 기대하는 동작을 보존하려고 한다.
mlx-dspark 게시물이 주목을 받은 뒤 DFlash도 논의에 들어왔다. DFlash의 저자 중 한 명인 Jian Chen은 동일한 Mac 설정에서 DFlash 모델을 테스트할 수 있는지 물었다.
DFlash는 z-lab의 또 다른 speculative decoding 접근법이다. 설계는 DSpark와 다르다. DFlash는 더 강한 의존성 처리를 바탕으로 후보 토큰을 단계별로 생성하는 대신, 블록 확산 방식의 방법을 사용해 전체 토큰 블록을 병렬로 디노이즈한다.
테스트된 설정에서 Rahim은 Jian의 포팅 스크립트를 사용해 z-lab/gemma4-12B-it-DFlash를 MLX 기반 Gemma-4 타깃 모델에 연결했다. 그런 다음 동일한 Mac에서 DFlash와 DSpark를 비교했다.
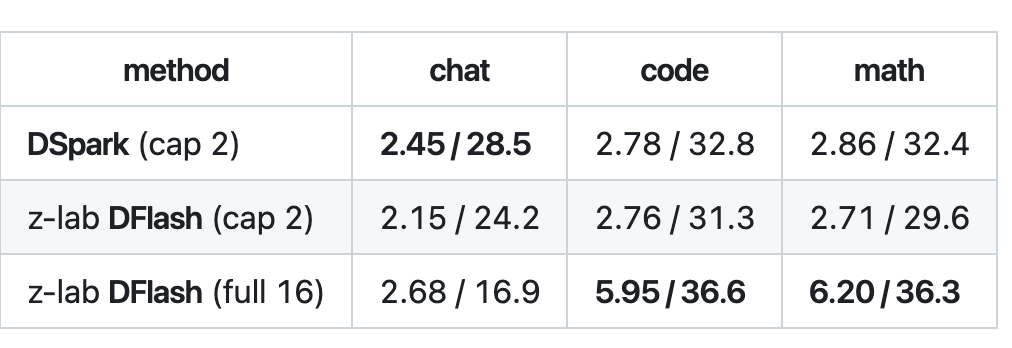
코드와 수학 같은 구조화된 작업에서 DFlash는 매우 좋은 성능을 보였다. 수락 길이는 약 5.95~6.20에 도달했고, 처리량은 보고된 설정에서 약 36 tok/s, 대략 2.1배에 달했다.
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
그렇다고 DFlash가 항상 더 낫다는 뜻은 아니다. DFlash는 한 번에 16개 토큰의 전체 블록을 드래프트하지만, 타깃 모델이 항상 전체 블록을 수락하는 것은 아니다. 수락된 토큰 수를 수락 길이라고 한다.
개방형 채팅에서는 다음 토큰을 예측하기가 더 어렵다. 수락 길이가 더 낮게 유지될 수 있으며, 이는 전체 16토큰 블록이 실제 속도 이점으로 이어지지 않는다는 의미다. 이런 설정에서는 DSpark가 더 빠를 수 있는데, 그 이유는 DSpark의 마르코프 헤드가 병렬 토큰 드래프팅에서 자주 나타나는 “suffix decay” 문제를 줄이도록 설계되었기 때문이다.
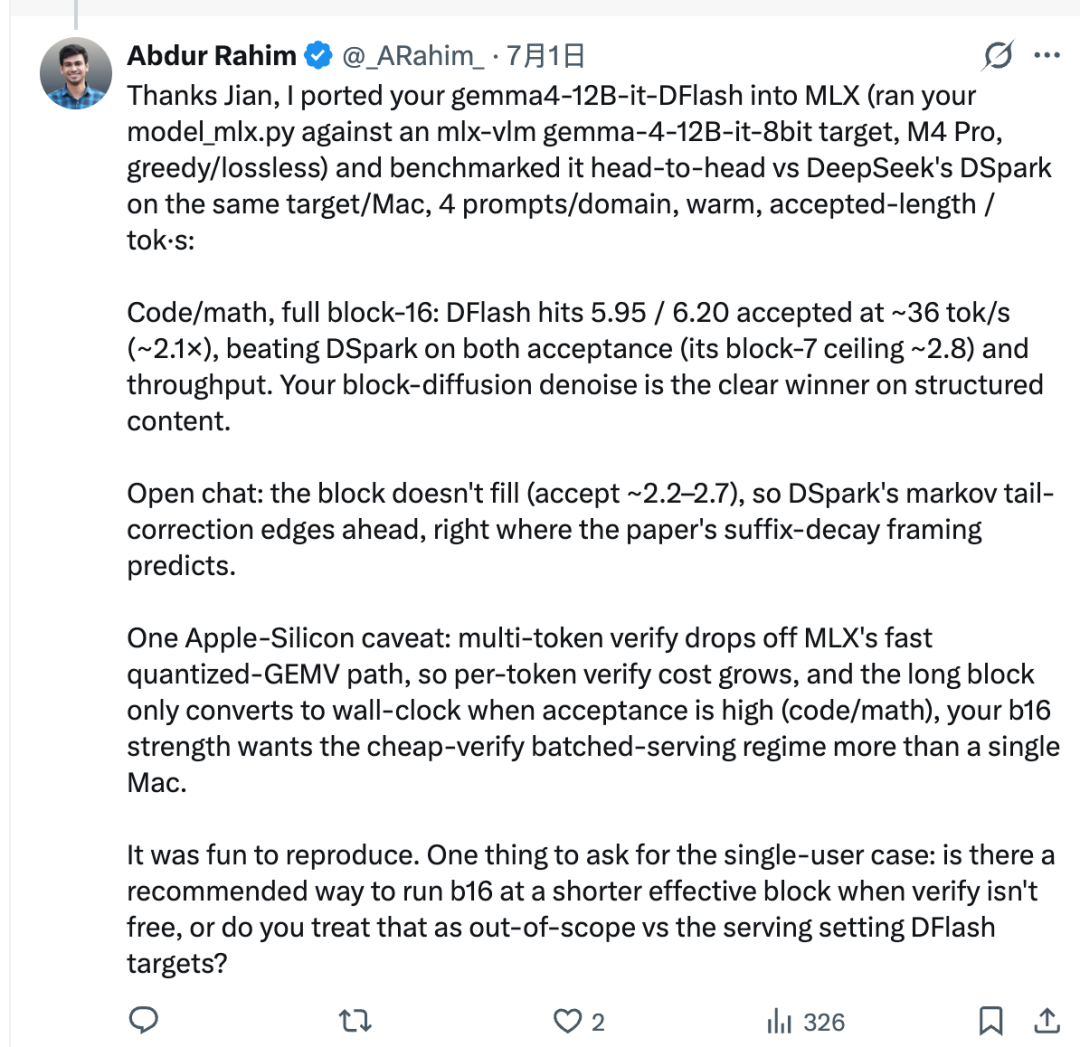
이후 mlx-dspark 업데이트에서는 z-lab의 원래 DFlash 경로가 패키지에 직접 추가되었다. 또한 유효 블록 길이를 조정하는 파라미터도 추가되었다. 이를 통해 사용자는 더 유연한 선택지를 갖게 된다.
이로써 mlx-dspark는 단일 방법 실험에 그치기보다 Apple Silicon 사용자를 위한 실용적인 로컬 추론 툴킷에 더 가까워졌다.
로컬 LLM 워크플로는 개발자, 연구자, 소규모 팀 사이에서 점점 더 보편화되고 있다. 모델을 로컬에서 실행하면 지연 시간, 데이터 처리, 실험, 오프라인 워크플로를 더 잘 제어할 수 있다.
하지만 로컬 추론에는 흔히 한 가지 고통스러운 한계가 있다. 바로 속도다. 모델이 메모리에 들어가더라도 생성이 느리게 느껴질 수 있다.
mlx-dspark가 흥미로운 이유는 완전히 새로운 타깃 모델을 요구하지 않고 이 문제를 해결하려 하기 때문이다. speculative decoding을 사용해 기존 모델이 더 빠르게 느껴지도록 하면서도, 타깃 모델이 출력을 검증하게 한다.
Mac에서 로컬 AI 앱을 구축하는 개발자에게 이는 여러 시나리오에서 유용할 수 있다.
서버 추론으로 이전하기 전에 기능을 테스트하는 경우.
2. 로컬 코딩 어시스턴트나 문서 어시스턴트를 실행하는 경우.
3. 다양한 작업 유형에 맞는 디코딩 전략을 비교하는 경우.
4. 가벼운 OpenAI 호환 로컬 서비스를 구축하는 경우.
5. 더 작은 Mac 구성이 특정 프로토타입에 충분한지 평가하는 경우.
트레이드오프는 여전히 중요합니다. 코드와 수학에서 잘 작동하는 방법이 열린 대화에 가장 적합한 선택은 아닐 수 있습니다. M4 Pro에서 성능이 좋은 방법도 구형 Apple Silicon 칩이나 메모리가 제한된 머신에서는 다르게 동작할 수 있습니다.
따라서 실용적인 결론은 “하나의 방법이 모든 곳에서 이긴다”가 아닙니다. Apple Silicon이 이제 DSpark, DFlash, MLX 네이티브 추론적 디코딩을 실험할 수 있는 더 강력한 경로를 갖게 되었다는 것입니다.
DSpark는 DeepSeek의 DeepSpec 프로젝트와 관련된 추론적 디코딩 방법입니다. 드래프트 모델을 사용해 토큰을 미리 제안하고, 대상 모델이 이를 검증하게 하여 출력 동작을 유지하면서 추론 속도를 높이는 것을 목표로 합니다.
mlx-dspark는 MLX를 통해 Apple Silicon에 DSpark 및 DFlash 스타일의 추론적 디코딩을 제공하는 커뮤니티 구현체입니다. 지원되는 Gemma 및 Qwen 대상 모델을 Mac에서 드래프트 모델 가속과 함께 실행할 수 있게 합니다.
아니요. mlx-dspark 프로젝트는 로컬 Mac 대상이 DeepSeek-V4 자체가 아니라 Gemma 및 Qwen 같은 dense 모델이라고 설명합니다. DeepSeek의 DSpark 드래프터 방식을 사용하지만, Mac 워크플로에서 토큰을 생성하는 대상 모델은 Gemma 또는 Qwen입니다.
보고된 테스트에서 Gemma-4 12B는 약 18.4 tok/s에서 약 30 tok/s로 향상되었고, Qwen3-4B는 약 52.9 tok/s에서 약 73 tok/s로 향상되었습니다. 실제 속도는 Mac 칩, 모델, 정밀도, 프롬프트 유형, 디코딩 설정에 따라 달라집니다.
DFlash는 z-lab의 블록 확산 추론적 디코딩 방법입니다. 토큰 블록을 병렬로 드래프트하며, 승인 길이가 길 때 코드와 수학 같은 구조화된 작업에서 특히 효과적일 수 있습니다.
항상 그렇지는 않습니다. DFlash는 코드와 수학 작업에서 더 나은 성능을 보일 수 있는 반면, DSpark는 긴 병렬 블록을 예측하기 어려운 개방형 채팅에서 더 강할 수 있습니다. 최선의 선택은 대상 모델과 작업 유형에 따라 달라집니다.
mlx-dspark는 MLX를 통해 Apple Silicon용으로 설계되었으므로 Apple Silicon Mac이 의도된 환경입니다. 또한 호환되는 Python 설정과 Hugging Face 또는 로컬 경로의 지원 모델 가중치가 필요합니다.
적합할 수 있지만, 프로덕션 사용에는 신중한 벤치마킹이 필요합니다. 이에 의존하기 전에 출력 충실도, 승인 길이, 지연 시간, 배치 동작, 메모리 사용량, 모델 호환성, 하드웨어별 성능을 확인해야 합니다.
이 글은 DeepSeek의 DSpark 추론적 디코딩 방법이 mlx-dspark를 통해 Apple Silicon으로 포팅되어, 지원되는 Gemma 및 Qwen 모델의 로컬 Mac 추론을 더 빠르게 만드는 방식을 설명합니다.
핵심은 이 포팅이 단순히 원시 속도만을 위한 것이 아니라는 점입니다. 대상 모델이 생성된 토큰을 검증하게 하여 출력 충실도를 유지하는 데에도 초점을 맞추며, 샘플링 디코딩 동작 지원도 포함합니다.
DFlash 통합은 또 다른 유용한 선택지를 추가합니다.
특히 긴 블록 단위의 초안 작성이 효과를 발휘할 수 있는 코드 및 수학 작업에서 그렇습니다. 개방형 채팅의 경우, 허용 가능한 길이를 유지하기가 더 어렵기 때문에 여전히 DSpark가 더 적합할 수 있습니다.
Mac 기반 로컬 AI 개발의 경우, mlx-dspark는 Apple Silicon 사용자에게 모든 것을 서버로 옮기지 않고도 더 빠른 LLM 추론을 테스트할 수 있는 실용적인 방법을 제공합니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.



