For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/embeddinggemma-2-740m-multimodal-embeddin-2078d39c.md.
Google이 스마트폰, 노트북, 브라우저 및 기타 엣지 기기에서 시맨틱 검색을 직접 실행하도록 설계된 소형 멀티모달 임베딩 모델 **EmbeddingGemma 2**를 출시했습니다.

Google이 스마트폰, 노트북, 브라우저 및 기타 엣지 기기에서 시맨틱 검색을 직접 실행하도록 설계된 소형 멀티모달 임베딩 모델 EmbeddingGemma 2를 출시했습니다.
이 모델은 2026년 10월 6일에 발표되었습니다. 수행할 수 있는 작업에 비해 주요 사양이 이례적으로 작습니다.
총 7억 4천만 개 파라미터
768차원 통합 임베딩 공간
8K 컨텍스트 윈도우
100개 이상의 언어
Pixel 11 Pro에서 텍스트 전용 가중치의 활성 RAM 약 191MB
Pixel 11 Pro에서 전체 멀티모달 모델의 활성 RAM 약 567MB
EmbeddingGemma 2는 텍스트, 코드, 이미지, 동영상, 오디오 및 이러한 모달리티가 혼합된 입력을 하나의 공유 벡터 공간에 인코딩할 수 있습니다.
즉, 각 파일을 먼저 텍스트로 변환하지 않아도 자연어 질의로 사진, 오디오 클립 또는 동영상 속 특정 순간을 검색할 수 있습니다.
Google CEO 순다르 피차이는 EmbeddingGemma 2를 Google의 첫 번째 오픈 네이티브 멀티모달 임베딩 모델이라고 설명했습니다.
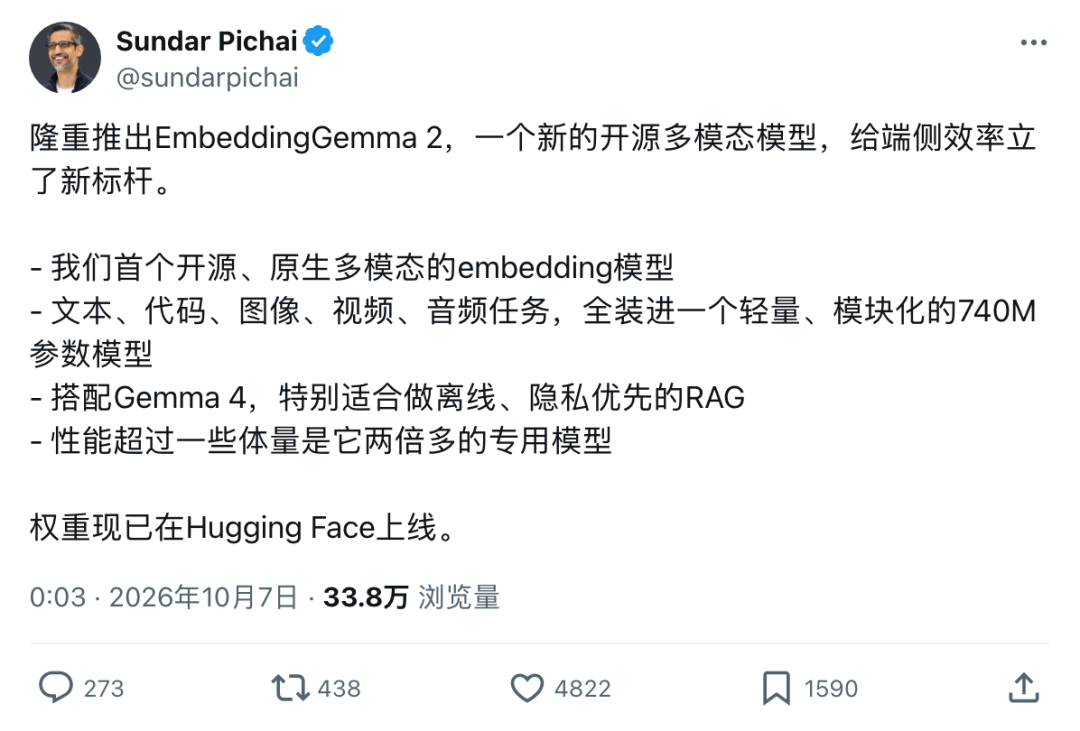
실질적인 차이는 간단합니다. 이전에는 클라우드 API나 이미지, 오디오, 텍스트별 개별 모델에 의존했던 검색을 이제 하나의 소형 모델로 로컬에서 실행할 수 있습니다.
임베딩 모델은 최종 사용자에게 잘 드러나지 않지만, 현대적인 검색 시스템과 RAG 시스템의 기반에서 작동합니다.
임베딩 모델의 역할은 콘텐츠를 수치 벡터로 변환하는 것입니다.
콘텐츠
→ 임베딩 벡터
→ 시맨틱 공간상의 위치
의미가 비슷한 항목은 서로 더 가까운 위치에 배치됩니다. 그런 다음 검색 시스템은 사용자의 질의를 또 다른 벡터로 변환하고, 가장 가까운 일치 항목을 검색합니다.
첫 번째 EmbeddingGemma는 텍스트에 집중했습니다. EmbeddingGemma 2는 이 개념을 통합 멀티모달 공간으로 확장합니다.
Google의 모델 카드는 새 모델이 텍스트, 이미지, 동영상 및 오디오를 동일한 768차원 임베딩 공간에 매핑한다고 설명합니다.
따라서 고양이 사진, “cat”이라는 단어, 고양이 울음소리를 녹음한 오디오는 원시 파일 형식이 완전히 다르더라도 모두 의미적으로 연결될 수 있습니다.
이를 통해 다음과 같은 검색이 가능합니다.
텍스트 질의 → 일치하는 이미지
텍스트 질의 → 일치하는 오디오
텍스트 질의 → 일치하는 동영상 속 장면
오디오 질의 → 일치하는 동영상
이미지 질의 → 관련 이미지 또는 미디어
하나의 콘텐츠에 여러 모달리티가 포함될 수도 있습니다.
Google은 트레일 러닝용 신발 제품 페이지를 예로 들었습니다. 이 페이지에는 텍스트 설명, 제품 사진, 젖은 바위에서 접지력을 보여주는 동영상이 포함되어 있습니다. EmbeddingGemma 2는 이 결합된 콘텐츠를 하나의 임베딩으로 표현하고 “트레일 러닝에 적합한 방수 신발”과 같은 질의와 매칭할 수 있습니다.
출시 직후 Hugging Face 엔지니어 Victor M은 브라우저에서 직접 실행되는 모델을 시연했습니다.
원문 기사에 따르면 그는 다음과 같이 입력했습니다.
새가 지저귀는 소리
그러자 결과 그리드가 즉시 재정렬되었습니다. 상위 결과에는 새 사진과 새 울음소리의 파형을 보여주는 오디오 클립이 모두 포함되었습니다.
보고된 질의 처리 시간은 약 22밀리초였습니다. 서버 측 모델 호출은 없었고 외부 API도 필요하지 않았습니다.
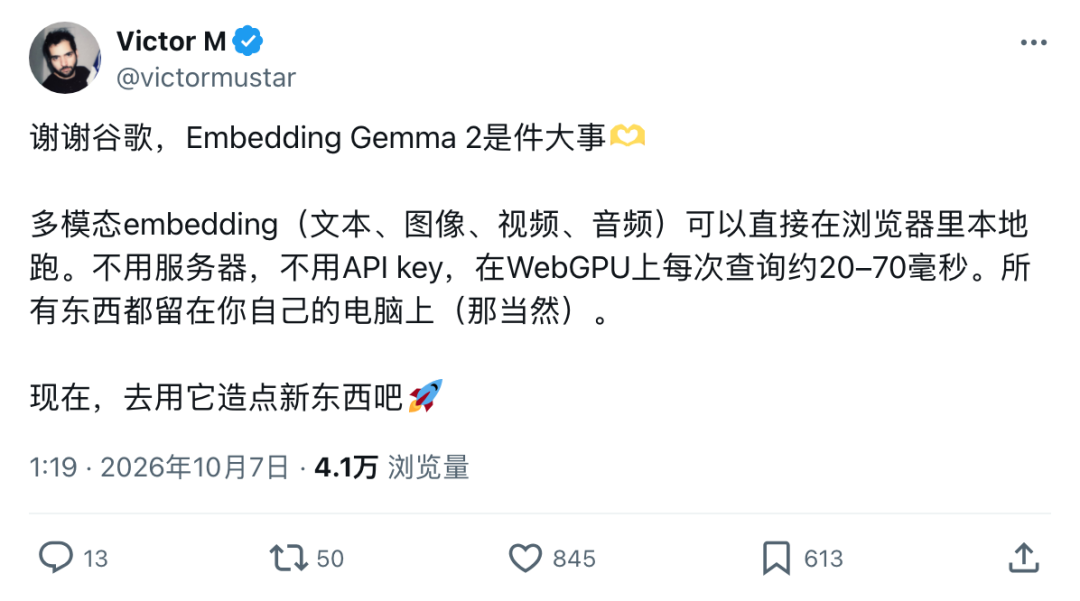
이 수치는 개발자가 브라우저에서 테스트한 결과이며, Google이 공식적으로 보장한 지연 시간은 아닙니다.
그럼에도 더 큰 방향성은 Google의 자체 배포 지침으로 뒷받침됩니다. EmbeddingGemma 2는 LiteRT, MediaPipe, WebGPU, transformers.js, MLX, llama.cpp, Ollama 및 기타 엣지 친화적 런타임을 통해 로컬에서 실행되도록 설계되었습니다.
EmbeddingGemma 2는 8,192토큰 컨텍스트 윈도우를 사용합니다. 이는 이전 EmbeddingGemma의 네 배입니다.
Google에 따르면 단일 모달리티 입력에는 대략 다음이 포함될 수 있습니다.
오디오 5.5분
이미지 29개
동영상 프레임 58개
또는 여러 모달리티가 서로 교차된 형태로 포함될 수 있습니다.
이 모델은 100개 이상의 언어도 지원합니다.
따라서 로컬 검색 시스템은 훨씬 더 유연해집니다. 애플리케이션은 짧은 텍스트 조각만 색인하는 대신, 더 긴 문단과 이미지, 동영상 프레임 또는 오디오 구간이 포함된 풍부한 콘텐츠를 표현할 수 있습니다.
Google은 EmbeddingGemma 2를 비슷한 규모의 여러 임베딩 시스템과 비교했습니다.
원문 기사는 시각적 검색에서 나타나는 가장 큰 차이를 강조합니다.
Google의 모델 카드에 따르면 결과는 다음과 같습니다.
| 벤치마크 | EmbeddingGemma 2 |
|---|---|
| MTEB Multilingual v2 | 61.36 |
| MTEB Code v1 | 78.68 |
| MIEB Lite | 64.64 |
| MMEB v2 Image | 57.28 |
| MMEB v2 Visual Document | 67.84 |
| MMEB v2 Video | 50.67 |
| MSEB Retrieval | 69.54 |
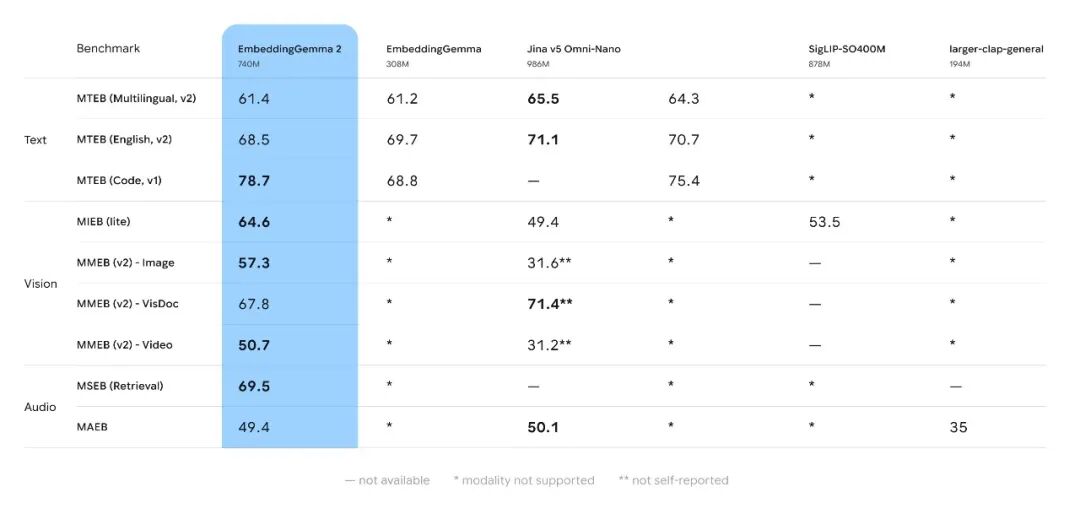
원문은 Jina v5 Omni-Nano와의 비교를 강조합니다.
MMEB v2 Image
EmbeddingGemma 2: 57.3
Jina v5 Omni-Nano: 31.6

MMEB v2 Video
EmbeddingGemma 2: 50.7
Jina v5 Omni-Nano: 31.2
이 수치는 Google이 공개한 평가표에서 가져온 것입니다.
언제나 그렇듯 벤치마크 결과는 모든 실제 운영 검색 작업에 적용되는 보편적인 순위가 아니라, 특정 평가 설정 안에서 해석해야 합니다.
총 7억 4천만 개 파라미터는 여러 모듈로 나뉩니다.
Google의 모델 카드에는 다음과 같이 기재되어 있습니다.
텍스트:
총 2억 7천만 개 파라미터
  백본 1억 3천만 개
  임베더 1억 4천만 개

비전 인코더:
1억 7천만 개 파라미터

오디오 인코더:
3억 개 파라미터
개발자가 세 구성 요소를 모두 로드해야 하는 것은 아닙니다.
| 활성 모달리티 | 유효 파라미터 규모 |
|---|---|
| 텍스트만 | 2억 7천만 개 |
| 텍스트 + 이미지 | 4억 4천만 개 |
| 텍스트 + 오디오 | 5억 7천만 개 |
| 전체 멀티모달 | 7억 4천만 개 |
이러한 모듈성은 엣지 기기에서 중요합니다. 앱이 텍스트와 코드만 검색한다면 오디오 또는 비전 인코더를 메모리에 유지할 이유가 없습니다.
Google은 Pixel 11 Pro에서 양자화한 후 모델이 대략 다음과 같이 실행될 수 있다고 보고했습니다.
텍스트 전용 활성 RAM:
약 191MB

전체 멀티모달 활성 RAM:
약 567MB
이 수치가 원문 기사의 “600MB 미만”이라는 제목의 근거입니다.
이 모델은 양자화 인식 학습을 사용하며 INT4 및 INT8 배포 옵션을 지원합니다.
이는 멀티모달 검색 파이프라인이 전통적으로 여러 개의 개별 구성 요소를 필요로 했다는 점에서 중요합니다.
이미지 인코더
+
음성 인식 또는 오디오 인코더
+
텍스트 임베딩 모델
+
추가 전처리
EmbeddingGemma 2는 이 과정의 상당 부분을 하나의 통합 아키텍처로 결합합니다.
기본 출력 차원은 768입니다.
EmbeddingGemma 2는 Matryoshka Representation Learning도 지원하므로 벡터를 다음과 같이 잘라낼 수 있습니다.
512차원
256차원
128차원
Google은 이를 통해 전체 768차원 표현과 비교할 때 로컬 벡터 데이터베이스의 저장 공간을 최대 6배 줄일 수 있다고 설명합니다.
Google AI Edge의 배포 블로그는 표현 방식과 저장 파이프라인의 구성에 따라 일부 로컬 인덱스 및 저장소 설정에서 최대 8배까지 줄일 수 있다고 설명합니다.
모델 카드에는 중요한 구현 세부 사항도 추가되어 있습니다. 코사인 유사도 검색 전에 잘린 벡터를 다시 정규화해야 합니다.
질의 벡터와 문서 벡터의 차원이 다르면 서로 직접 비교할 수도 없습니다.
Google은 이 모델을 기반으로 여러 참조 애플리케이션을 공개했습니다.
Google AI Edge Gallery의 Instant Media Search는 사용자가 자연어 또는 샘플 이미지를 사용해 로컬 사진과 동영상을 검색할 수 있도록 합니다.
앱의 작동 방식은 다음과 같습니다.
임베딩 계산에는 인터넷 연결이 필요하지 않습니다.
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
Video Moments Finder는 사용자가 로컬 동영상 파일 안의 특정 순간을 검색할 수 있도록 합니다.
Google이 제시한 예시는 다음과 같습니다.
아이들이 웃는 장면
프리스비를 잡는 개
생일 케이크 촛불을 끄는 사람
이 앱은 시각 및 오디오 구간을 색인하고 일치하는 타임스탬프를 반환합니다.
Google은 Mac용 AI Edge Foresight도 출시했습니다.
Foresight는 EmbeddingGemma 2와 Gemma 4를 함께 사용해 로컬 검색 및 컨텍스트 기반 추론을 수행합니다.
Google에 따르면 이 도구는 회의 기록을 색인하고, 비공개 파일을 검색하며, 이미지·문서·메모를 검색하고, 오프라인으로 작동하며, 민감한 원본 자료를 기기 안에 보관할 수 있습니다.
이는 원문 기사에서 설명한 로컬 RAG 아키텍처와 유사합니다.
EmbeddingGemma 2
→ 관련 로컬 컨텍스트 검색

Gemma 4
→ 검색된 컨텍스트를 바탕으로 추론
원문 기사는 초기 개발자 실험도 여러 건 수집했습니다.
이 사례들은 유용한 예시이지만 공식 Google 벤치마크가 아니라 커뮤니티가 보고한 결과로 보아야 합니다.
Mac 앱 Nativ는 Apple M5 Max에서 8비트 양자화 모델을 사용해 테스트한 결과를 보고했습니다.
공개된 수치는 다음과 같습니다.
FP32 대비 코사인 유사도:
0.9997

배치 32에서 텍스트 임베딩 처리량:
초당 817개 항목
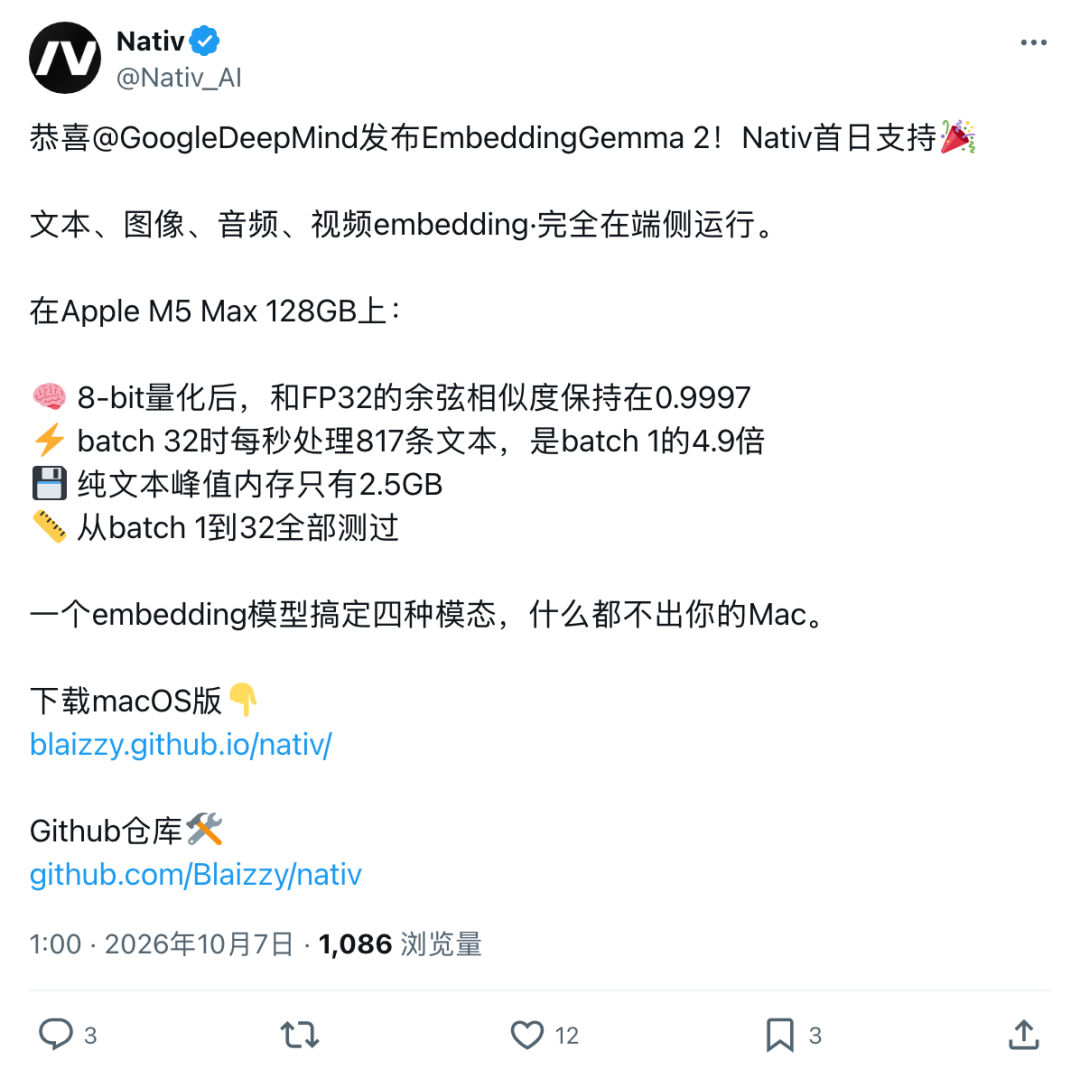
이 수치는 구체적인 구현 방식, 양자화, 하드웨어 및 배치 크기에 따라 달라집니다.
원문에 인용된 한 터키 개발자는 개인 메모를 대상으로 소규모 테스트를 구축했습니다.
메모는 대부분 영어로 작성되었고 질의는 터키어로 입력되었습니다.
그가 보고한 테스트 결과는 다음과 같습니다.
키워드 매칭 적중률:
15%

EmbeddingGemma 2 적중률:
97%
이 테스트는 정답 메모가 상위 18개 후보 안에 포함되는지를 확인했습니다.
그는 오탈자가 많은 실제 메시지도 테스트했으며, 시맨틱 모델이 키워드 검색보다 대략 두 배 많은 관련 메모를 찾았다고 보고했습니다. 각 질의에는 로컬에서 약 50밀리초가 걸렸다고 합니다.
이는 표준화된 벤치마크는 아니지만 임베딩 검색이 유용한 주요 이유 중 하나를 보여줍니다. 시맨틱 유사도는 질의와 저장된 텍스트가 서로 다른 단어나 언어를 사용하더라도 작동할 수 있습니다.
개발자 Nick Lo는 llama.cpp를 통해 Nano 개발 보드에서 실행되는 양자화된 EmbeddingGemma 2 빌드도 시연했습니다.
그는 소규모 로컬 이미지 검색 시스템에서 텍스트 질의를 임베딩으로 변환하는 데 대략 다음 시간이 걸렸다고 보고했습니다.
약 15밀리초
일치하는 이미지를 찾은 후 ESP32-S3가 이미지를 한 줄씩 그렸습니다.

다시 말해 이 결과는 공식 참조 지연 시간이 아니라 개발자 실험입니다.
이 모델은 미디어에만 관련된 것이 아닙니다.
코드 검색 성능은 이전 EmbeddingGemma보다 크게 향상되었습니다.
Google이 보고한 수치는 다음과 같습니다.
MTEB Code v1

EmbeddingGemma:
68.76

EmbeddingGemma 2:
78.68
이는 9.92포인트 상승한 수치입니다.
Google Gemma는 로컬 코드베이스 색인, 시맨틱 코드 검색 및 코딩 에이전트 검색을 주요 사용 사례로 구체적으로 강조합니다.
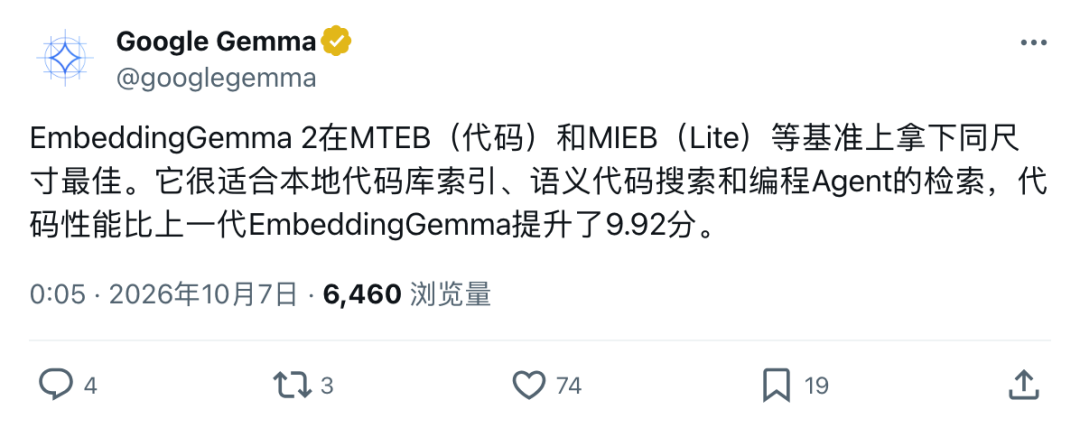
코딩 에이전트와 같은 도구는 코드를 수정하기 전에 먼저 저장소의 관련 부분을 찾아야 합니다.
소형 로컬 임베더를 사용하면 개발자는 다음과 같은 아키텍처를 선택할 수 있습니다.
소스 저장소
→ 로컬에서 임베딩 생성
→ 로컬에 인덱스 저장
→ 자연어 질의
→ 관련 코드 검색
→ 선택한 컨텍스트만 더 큰 코딩 모델에 전달
색인 생성과 1차 검색을 개발자 자신의 컴퓨터에 유지할 수 있습니다.
Google은 이미 2026년 초 Gemini Embedding 2를 클라우드 API로 출시했습니다.
EmbeddingGemma 2는 다른 접근 방식을 취합니다.
멀티모달 임베딩 생성을 위해 호스팅 API를 요구하는 대신, 로컬에서 실행할 수 있는 오픈 웨이트 모델입니다.
| 접근 방식 | 주요 장점 |
|---|---|
| 클라우드 임베딩 API | 관리형 인프라 및 간편한 확장 |
| 온디바이스 EmbeddingGemma 2 | 개인정보 보호, 오프라인 작동, 낮은 로컬 지연 시간 |
개인 미디어, 비공개 파일, 기업 메모 및 로컬 코드 저장소의 경우 두 번째 옵션이 매력적일 수 있습니다. 원본 자료를 반드시 기기 밖으로 전송하지 않아도 되기 때문입니다.
Google은 이를 개인정보 보호를 우선하는 설계로 명시적으로 홍보합니다.
그렇다고 모든 애플리케이션이 자동으로 비공개가 되는 것은 아닙니다. 보안이 적용된 로컬 저장소, 접근 제어, 검색된 콘텐츠의 신중한 처리 등 애플리케이션의 나머지 부분도 올바르게 설계해야 합니다.
EmbeddingGemma 2는 Gemma 4 기술을 기반으로 구축된 Google의 오픈 웨이트 멀티모달 임베딩 모델입니다. 텍스트, 코드, 이미지, 동영상, 오디오 및 혼합 입력을 공유 768차원 벡터 공간에 매핑하여 검색, RAG, 유사도 분석, 분류 및 클러스터링에 사용할 수 있습니다.
전체 모델은 7억 4천만 개의 파라미터를 사용합니다. 텍스트 구성 요소는 2억 7천만 개의 파라미터를 사용하며, 선택 사항인 비전 및 오디오 인코더가 각각 1억 7천만 개와 3억 개의 파라미터를 추가합니다.
예. Google은 이 모델을 온디바이스용으로 설계했으며 스마트폰, 노트북, 브라우저 및 엣지 하드웨어를 위한 배포 경로를 제공합니다. Google의 자체 AI Edge 데모는 클라우드 임베딩 호출 없이 로컬 검색을 수행합니다.
Google은 Pixel 11 Pro에서 양자화된 텍스트 전용 가중치에 약 191MB의 활성 RAM이 필요하고, 전체 멀티모달 모델에는 약 567MB가 필요하다고 보고했습니다. 실제 메모리 사용량은 런타임, 하드웨어, 정밀도 및 활성화된 인코더에 따라 달라집니다.
예. 지원되는 모든 모달리티가 동일한 벡터 공간에 매핑되므로 텍스트로 이미지, 오디오 또는 동영상 구간을 검색할 수 있으며, 미디어끼리 서로 비교할 수도 있습니다.
Google은 상업적으로 허용적인 Apache 2.0 라이선스에 따라 모델 가중치를 공개하며 이를 오픈 모델이라고 설명합니다. 사용자는 여전히 Gemma 금지 사용 정책과 해당 약관을 준수해야 합니다.
예. Google은 이전 EmbeddingGemma의 68.76에서 향상된 78.68의 MTEB Code 점수를 보고했으며, 로컬 저장소 색인과 코딩 에이전트 검색을 의도된 사용 사례로 명시하고 있습니다.
EmbeddingGemma 2는 검색과 유사도 분석을 위해 콘텐츠를 벡터로 변환하는 임베딩 모델입니다. Gemma 4는 검색된 정보를 바탕으로 추론할 수 있는 생성 모델이므로 Google은 두 모델을 완전한 로컬 RAG 워크플로에 결합해 보여줍니다.
EmbeddingGemma 2는 멀티모달 시맨틱 검색을 클라우드에서 꺼내 일반적인 소비자 하드웨어에서도 사용할 수 있도록 합니다. 하나의 7억 4천만 개 파라미터 모델이 텍스트, 코드, 이미지, 동영상 및 오디오를 하나의 벡터 공간에 임베딩할 수 있으며, Google의 전체 멀티모달 Pixel 11 Pro 구성에서는 약 567MB의 활성 RAM을 사용합니다.
가장 실질적인 장점은 아키텍처의 단순성입니다. 하나의 소형 모델로 로컬 미디어 검색, 동영상 장면 검색, 비공개 RAG, 다국어 메모 검색 및 저장소 색인을 지원할 수 있으며, 모든 원본 파일을 서버에 업로드할 필요가 없습니다.
Google의 공식 데모, 모델 카드 및 배포 스택은 온디바이스 실행이라는 방향을 뒷받침합니다. 원문에 등장하는 브라우저, Nativ, 터키어 메모 및 Nano 보드 수치는 초기 개발자 실험으로 유용하지만, 보장된 성능이 아니라 구현별 결과로 해석해야 합니다.
EmbeddingGemma 2는 로컬 멀티모달 검색을 충분히 현실적인 수준으로 끌어올립니다. 이에 따라 사진, 녹음 파일, 동영상, 문서 및 코드를 사용자의 기기에 이미 존재하는 위치에서 점점 더 쉽게 검색할 수 있습니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.



