For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/gemini-4-argon-arc-agi-3-97-5-score-cost-f02ba71b.md.
ARC Prize는 Gemini 4 Argon이 ARC-AGI-3에서 **검증된 점수 97.5%**를 기록했다고 발표했습니다. 주최 측에 따르면 Google DeepMind는 이 벤치마크에서 95%를 넘은 두 번째 프런티어 연구소입니다.
ARC Prize는 Gemini 4 Argon이 ARC-AGI-3에서 **검증된 점수 97.5%**를 기록했다고 발표했습니다. 주최 측에 따르면 Google DeepMind는 이 벤치마크에서 95%를 넘은 두 번째 프런티어 연구소입니다.
이 결과에는 마찬가지로 중요한 비교가 따릅니다. 같은 모델 계열은 Provider Adapter를 사용했을 때 97.5%를 기록한 반면, Standard 하네스를 사용했을 때는 **49.8%**를 기록했습니다. 발표된 평가 비용은 각각 약 4,800달러와 5,800달러입니다.
이는 특정 설정을 적용한 시스템의 결과입니다. 헤드라인 수치에 근거해 결론을 내리기 전에 벤치마크, 추론 수준, 하네스, 미완료 실행을 이해해야 합니다.
ARC Prize 발표에 제시된 수치는 다음과 같습니다.
| 벤치마크 및 설정 | 발표 점수 | 발표된 평가 비용 |
|---|---|---|
| ARC-AGI-1, 보고된 최고 설정 | 98.5% | 태스크당 약 0.16달러 |
| ARC-AGI-2, 보고된 최고 설정 | 91.3% | 태스크당 약 0.32달러 |
| ARC-AGI-3, Provider Adapter, 낮은 추론 수준 | 97.5% | 평가 전체 약 4,800달러 |
| ARC-AGI-3, Standard, 낮은 추론 수준 | 49.8% | 평가 전체 약 5,800달러 |
비용 단위가 서로 다릅니다. ARC-AGI-1과 ARC-AGI-2의 금액은 태스크당 비용이며, ARC-AGI-3의 금액은 평가 실행 비용입니다. 이러한 차이를 고려하지 않고 같은 비용 기준으로 비교해서는 안 됩니다.
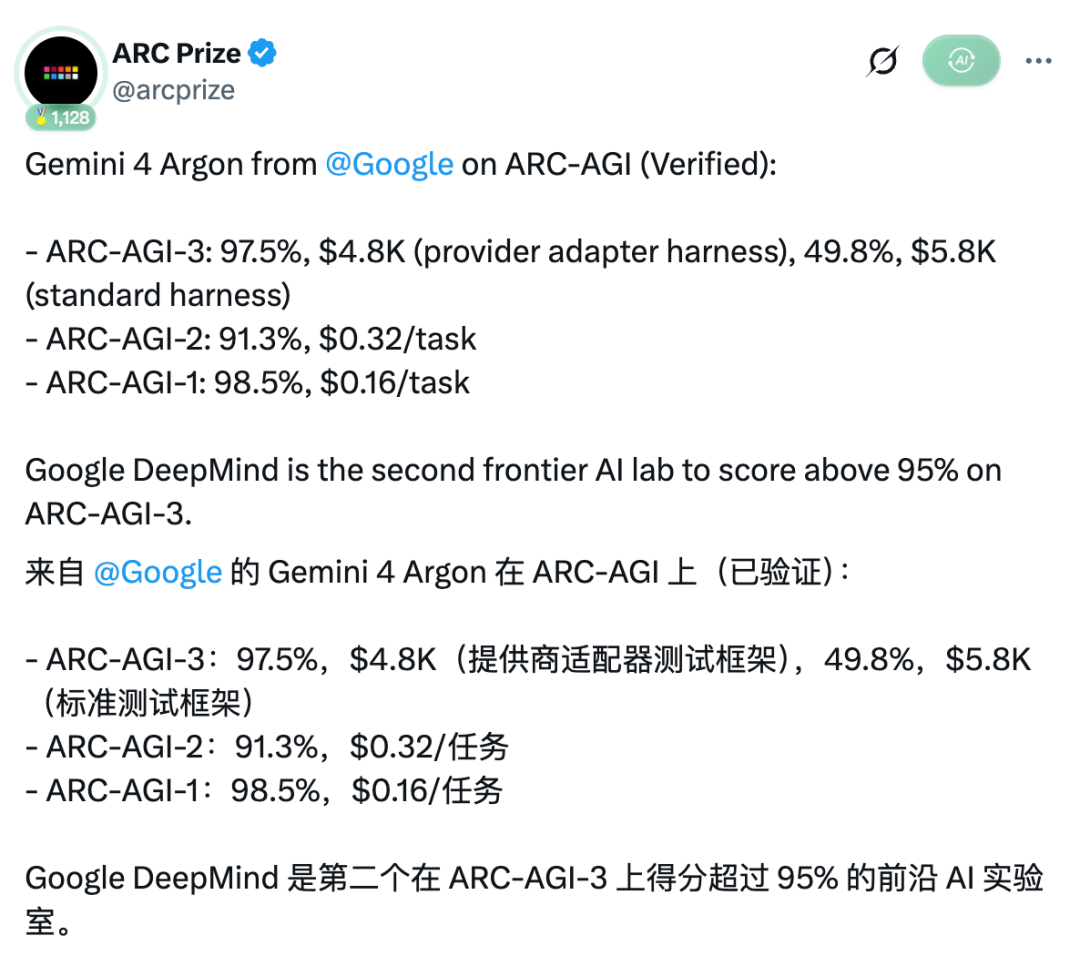
원본 보도에 재현된 ARC Prize의 검증 점수 발표입니다.
현재 표에는 ARC-AGI-1의 태스크당 비용이 0.162달러, ARC-AGI-2의 태스크당 비용이 0.325달러로 더 정확하게 나와 있습니다. 표에는 발표 내용과 일치하는 ARC-AGI-2 점수 91.3%가 기재되어 있지만, 결과 페이지에 함께 실린 문단에는 91.2%라고 적혀 있습니다. 이 글에서는 발표 및 표에 기재된 값을 사용하면서 해당 불일치도 알립니다.
ARC-AGI-3은 앞선 두 세대와 다릅니다. 정적인 예시를 바탕으로 출력 그리드를 추론하는 대신, 에이전트가 익숙하지 않은 상호작용 환경을 탐색하고, 행동 방식이 어떻게 작동하는지 알아내며, 게임을 설명하는 자연어 지시 없이 목표를 달성하는 방법을 학습합니다.
ARC Prize는 이 테스트가 시간이 지남에 따라 기술 습득 효율성, 적응력, 계획 능력을 측정한다고 설명합니다. 따라서 이 점수는 단순히 “게임에서 이긴 비율”이 아닙니다. 벤치마크 설명에 따르면 100% 점수는 인간 기준과 같은 효율성으로 게임을 완료하는 것에 해당합니다.
원본 자료는 ARC-AGI-3가 3월에 출시될 무렵 프런티어 모델의 점수가 1% 미만이었던 데서 그해 후반 거의 최고점에 가까운 결과로 변화한 과정을 추적합니다. OpenAI의 앞선 GPT-6 Astra 결과에 이어 Gemini가 95%를 넘은 일을 강조합니다.
이는 해당 평가에서 상당한 변화입니다. 그렇다고 주최 측이 가능한 모든 추론 유형을 테스트했다거나, 두 시스템 중 어느 하나가 사람처럼 새로운 과제를 학습할 수 있다고 입증했다는 의미는 아닙니다.
보고서는 공개 게임 25개에서 높은 행동 효율성도 설명합니다. 인간 기준보다 행동 횟수가 62% 적었고, 세 게임에서는 스피드런 기록과 같거나 더 빨랐으며, 여섯 게임에서는 해당 기록보다 10% 이내로 느렸습니다. 이러한 비교는 원본 자료에 보고된 공개 세트 관찰 결과입니다. 이를 평가 태스크 55개 전체나 임의의 게임에 일반화해서는 안 됩니다.
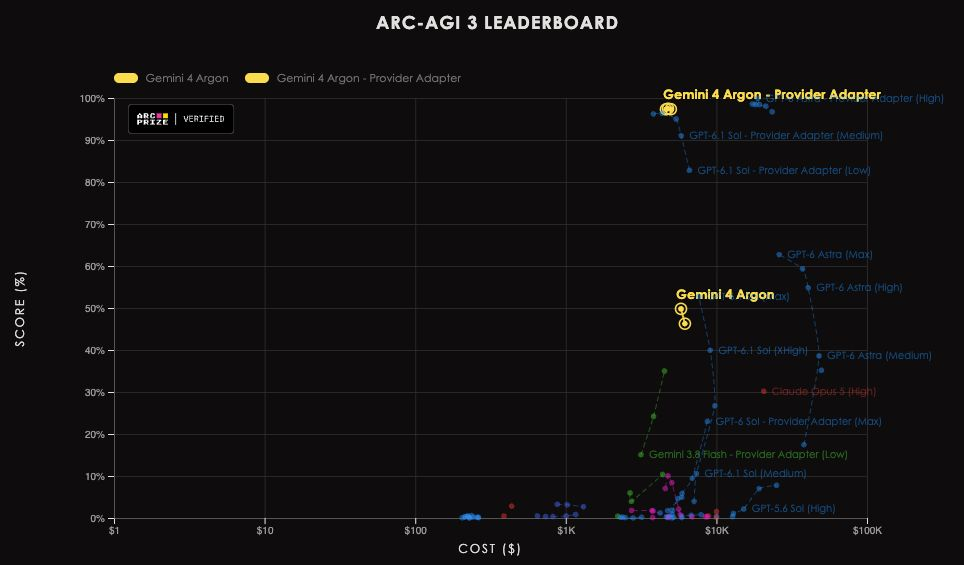
보고서에 포함된 리더보드 스크린샷입니다. 현재 구성 세부 정보는 실시간 결과 페이지에서 확인할 수 있습니다.
에이전트 하네스는 모델과 상호작용하는 방식을 제어합니다. 관찰 정보를 전달하는 방식, 행동을 전송하는 방법, 유지할 컨텍스트, 대화가 길어졌을 때의 처리 방식 등이 여기에 포함됩니다.
ARC Prize는 두 조건을 각각 다음과 같이 정의합니다.
Gemini 4 Argon의 현재 결과는 다음과 같습니다.
| 추론 수준 | Standard 하네스 | Provider Adapter 하네스 |
|---|---|---|
| 낮음 | 49.8% | 97.5% |
| 중간 | 46.3% | 97.3% |
| 높음 | 완료된 비교 결과 없음 | 97.3% |
낮은 추론 수준에서 두 결과의 차이는 47.7%포인트입니다. 이는 설정된 상호작용 시스템이 측정 결과에 실질적인 영향을 미친다는 점을 보여주지만, 특정 원인 하나만 따로 규명하지는 않습니다. 하네스 명칭과 더불어 컨텍스트 처리, 실행 조건, API 안정성 및 기타 설정도 고려해야 합니다.
특히 ARC Prize는 API 문제로 Standard 평가를 완료하지 못했다고 보고합니다. 낮음, 중간, 높음 설정의 실행은 각각 55개 태스크 중 42개, 46개, 19개를 완료했습니다. 발표된 종합 점수에는 미완료 실행의 부분 점수를 포함해 55개 태스크 전체가 반영됩니다. 완료 횟수는 각각 42개나 46개의 게임을 반드시 완전히 해결했다는 뜻이 아닙니다.
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
완료되지 않은 고추론 수준의 Standard 결과는 차트에서 제외되었습니다. 따라서 이번 평가에서는 추론 노력을 높여도 서로 비교 가능한 Standard 결과의 일관된 완료 순서가 나오지 않았습니다.
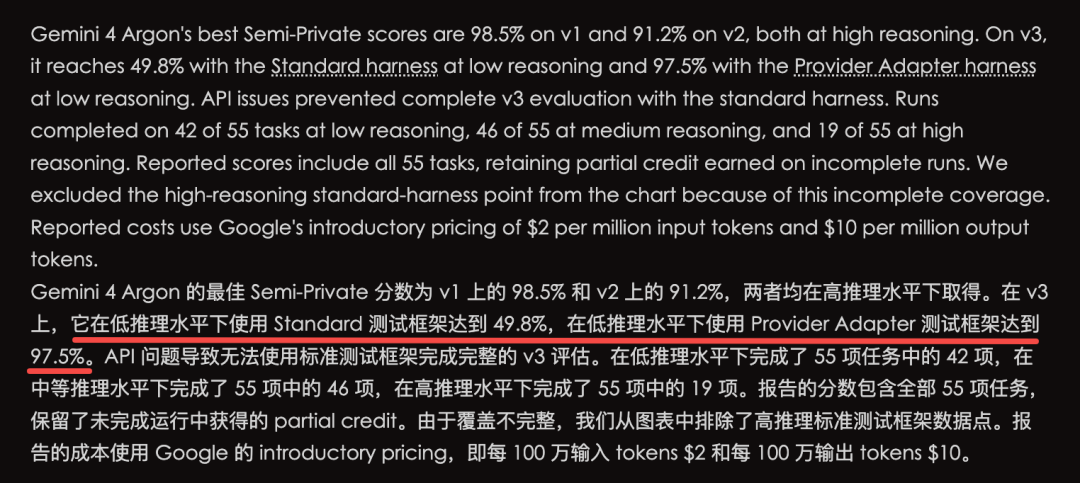
원본 자료에 재현된 구성 및 평가 범위 참고 사항입니다. 업데이트 내용은 실시간 결과 페이지에서 확인하시기 바랍니다.
ARC Prize에 따르면 비용 추정에는 Google의 출시 초기 API 가격인 입력 토큰 100만 개당 2달러, 출력 토큰 100만 개당 10달러가 적용됩니다. 이 금액은 새로운 실제 과제를 해결하는 데 드는 고정 가격이 아니며, 가격이나 구성에 따라 달라질 수 있습니다.
원본 자료의 핵심적인 실무 교훈은 타당합니다. 모델 이름과 단일 백분율만으로는 평가 대상 시스템의 여러 중요한 측면을 알 수 없습니다. 컨텍스트 관리 인터페이스가 다르면 같은 모델 이름이 붙은 두 점수도 서로 다른 질문에 답할 수 있습니다.
ARC Prize의 정책은 두 하네스가 서로 다른 평가 질문을 다루므로 결과를 별도로 보고한다고 명시합니다. 검증된 결과는 공개된 방법론에 따라 주최 측이 수행한 평가입니다. 근거가 제시되지 않은 공급업체 발표 자료보다 강력한 증거이지만, 여전히 테스트된 태스크 분포와 조건의 범위 안에서 해석해야 합니다.
이 결과를 비교할 때 유용한 확인 순서는 벤치마크 버전, 정확한 모델 구성, 추론 수준, 하네스, 태스크 범위, 채점 규칙, 비용 단위입니다. 이러한 순서를 따르면 실제 성능 개선과 서로 다른 실험의 비교를 구분하기가 더 쉽습니다.
최고점에 가까운 성능은 테스트에 어느 정도의 성능 여지가 남아 있는지에 대한 연구 질문도 제기합니다. 그렇다고 남아 있는 한계가 사라지는 것은 아니며, “AGI 벤치마크”라는 표현이 일반 지능의 증거로 바뀌는 것도 아닙니다.
ARC Prize는 낮은 추론 수준에서 Provider Adapter 하네스를 사용해 97.5%를 기록했다고 보고합니다. 낮은 추론 수준의 Standard 결과는 미완료 실행을 포함한 다른 평가 조건에서 49.8%였습니다.
아닙니다. ARC-AGI-3은 효율성 기반 채점 시스템으로 성능을 측정하며 부분 점수를 부여할 수 있습니다. 점수를 완전히 완료한 게임의 개수로 곧바로 환산해서는 안 됩니다.
Standard 하네스는 모델이 선택한 메모를 유지하는 최소한의 공급자 중립적 인터페이스입니다. Provider Adapter는 추론 상태 유지와 대화 압축을 포함해 공급자별 컨텍스트 관리 기능을 사용할 수 있습니다.
발표된 낮은 추론 수준의 실행 비용은 Provider Adapter를 사용했을 때 약 4,800달러, Standard 하네스를 사용했을 때 약 5,800달러였습니다. ARC Prize는 이 추정치에 출시 초기 토큰 가격이 적용됐다고 밝혔습니다. 이는 태스크당 비용이 아니라 평가 전체 비용입니다.
ARC Prize는 결과를 검증된 것으로 표시하고, 테스트 정책과 모델별 결과 페이지를 공개합니다. 이 글에서는 해당 기록을 확인했지만, 평가를 다시 실행하거나 점수를 독립적으로 재현하지는 않았습니다.
단일 벤치마크만으로 그런 결론을 내릴 수는 없습니다. 이 결과는 명시된 시스템 구성에서 ARC-AGI-3에 높은 성능을 보였다는 점을 나타냅니다. 해당 조건을 넘어서는 신뢰성과 일반화 능력에는 추가 증거가 필요합니다.
Gemini 4 Argon의 검증된 ARC-AGI 결과는 정적 테스트와 상호작용형 테스트에서 높은 성능을 보여줍니다. ARC-AGI-3의 헤드라인 수치인 97.5%는 낮은 추론 수준의 특정 Provider Adapter 구성에서 나온 결과이며, 발표된 평가 비용은 약 4,800달러입니다.
Standard 결과, 미완료 실행, 컨텍스트 관리의 차이는 비교 결과를 해석하는 데 필수적입니다. 모델, 하네스, 평가 조건을 함께 살펴보세요. 백분율만으로는 AGI가 입증되지 않습니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.



