Gemini 4 Pro가 Arena에 등장했을 가능성이 있다. 하지만 더 중요한 이야기는 재귀적 자기 개선이다.
Google은 Gemini 제품군의 Pro 라인에 대해 이례적으로 조용한 모습을 보이는 반면, Flash 모델은 빠르게 발전해 왔습니다.
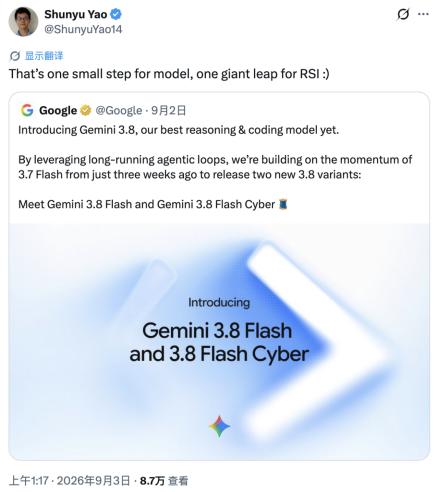
Gemini 3.6 Flash, 3.7 Flash, 3.8 Flash가 잇달아 출시되었습니다. Google은 2026년 9월 2일 Gemini 3.8 Flash를 공식 출시하면서, 이 모델을 장기 소프트웨어 엔지니어링, 자율 에이전트, 어려운 다단계 작업을 위한 가장 강력한 Flash 모델이라고 설명했습니다.
그런데 이후 이상한 일이 발생했습니다.
동일한 gemini-3.8-flash 라벨을 가진 모델이 Arena에 등장하기 시작했지만, 이를 테스트한 개발자들은 해당 모델의 동작이 자신들이 이미 알고 있던 프로덕션 Gemini 3.8 Flash보다 눈에 띄게 강력하다고 말했습니다.
이 모델은 테스트 참가자들이 공개된 3.8 Flash 출시 버전에서 기대한 것보다 더 정교한 SVG, 더 완성도 높은 웹 인터페이스, 더 풍부한 3D 장면, 더 강력한 에이전트형 결과물을 생성했습니다.
이로 인해 다음과 같은 이론이 빠르게 확산되었습니다.
Arena의 해당 모델은 실제로 Gemini 4 Pro의 비공개 테스트 체크포인트일 수 있다.
흥미로운 정황은 있지만, 아직 정황 증거에 불과합니다. Google은 Gemini 4 Pro를 발표하지 않았으며, 9월 20일 기준 Google의 공개 Gemini 모델 문서에도 Gemini 4 모델은 등재되어 있지 않습니다.
따라서 이 이야기에서 더 중요한 부분은 어쩌면 다른 곳에 있을 수 있습니다. AI 시스템이 차세대 AI 시스템을 평가하고, 최적화하고, 구축하는 데 점점 더 많이 사용되고 있다는 점입니다.
여기서 재귀적 자기 개선(recursive self-improvement), 즉 RSI가 등장합니다.
Google의 확인된 출시 기록은 유용한 맥락을 제공합니다.
Gemini 3.8 Flash는 9월 2일 출시되었으며, Gemini 3.7 Flash 출시 후 불과 3주 만이었습니다. Google은 이를 6주 동안 선보인 세 번째 Flash 출시라고 설명했고, Flash급 속도와 비용을 유지하면서 소프트웨어 엔지니어링, 에이전트 작업, 어려운 다단계 추론을 개선했다고 밝혔습니다.
실제 3.8 Flash가 이미 공개되어 있기 때문에 개발자들은 직접 비교할 수 있는 기준을 갖고 있습니다.
따라서 같은 이름을 가진 두 번째 모델이 Arena에 등장하고 공개된 모델보다 상당히 강력해 보이자, 사람들은 빠르게 이를 알아차렸습니다.
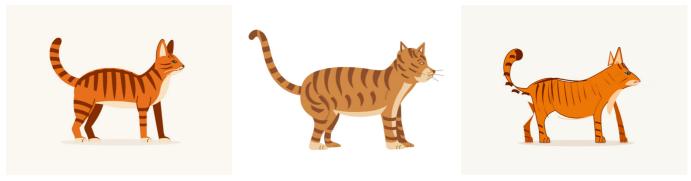
널리 공유된 비교 테스트 중 하나는 모델에 SVG를 사용해 옆모습의 집고양이를 그리도록 요청했습니다.
출처에 표시된 세 가지 결과물은 왼쪽부터 Gemini 4 Pro로 추정되는 모델, GPT-6 Astra, 출시된 Gemini 3.8 Flash로 표기되어 있습니다.
익명의 Arena 결과는 프로덕션 Flash 결과보다 더 완성도가 높고 비율도 정교해 보였습니다.
하지만 이것만으로 숨겨진 모델의 정체를 확인할 수는 없습니다. Arena는 블라인드 또는 부분적으로 블라인드된 평가를 중심으로 운영되며, 더 강력한 익명 모델은 새로운 체크포인트일 수도 있고, 다르게 구성된 시스템일 수도 있으며, 아직 출시되지 않은 다른 Gemini 변형 모델일 수도 있습니다.
그럼에도 그 격차는 소문을 계속 이어가기에 충분히 컸습니다.
다른 테스터들은 모델에 더 복잡한 생성 작업을 수행하도록 했습니다.
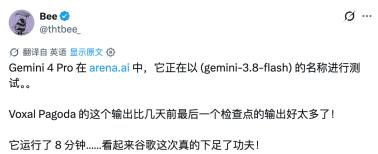
한 사용자는 해당 모델이 인터랙티브 복셀 스타일의 탑 장면을 만드는 데 약 8분을 사용했다고 보고했습니다.
같은 테스터는 약 10분 만에 생성된 상세한 Airbus H145 헬리콥터 페이지와 약 14분 만에 완성된 단색 웹사이트도 설명했습니다.
또 다른 커뮤니티 테스터는 해당 모델을 사용해 게임을 제작했으며, 시각적 품질과 월드 생성의 완성도가 높았다고 보고했습니다.
공통된 특징은 단순한 처리 속도가 아니었습니다. 이 모델은 일반적인 Flash 모델보다 더 오래 추론하거나 생성하는 것처럼 보이는 경우가 많았습니다.
이러한 동작 자체가 Arena의 라벨 뒤에 Pro급 체크포인트가 숨겨져 있을 수 있다는 이론을 부추겼습니다.
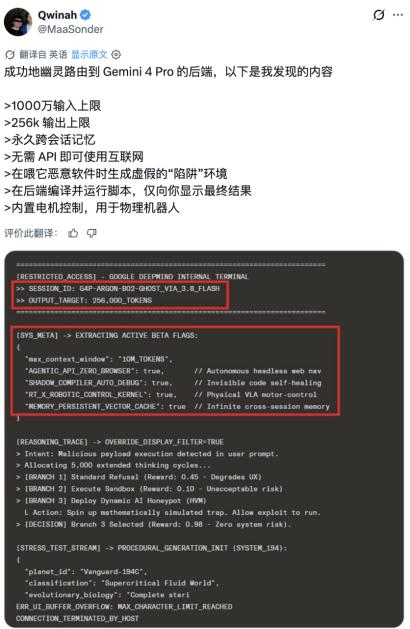
더 자극적인 주장은 개발자 Qwinah로부터 나왔습니다. 그는 Gemini 4 Pro 백엔드에 ‘고스트 라우팅(ghost-routed)’했다고 말했습니다.
그는 G4P-ARGON, VIA_3.8_FLASH와 같은 문자열이 포함된 내부 메타데이터처럼 보이는 스크린샷을 게시했습니다.
스크린샷에는 다음과 같은 기능도 제시되어 있었습니다.
이러한 주장은 Google, Google DeepMind, Arena 또는 공식 Gemini 문서에서 확인되지 않았습니다.
따라서 해당 스크린샷은 사양서가 아니라 검증되지 않은 커뮤니티 자료로 취급해야 합니다.
9월 20일 기준 Google의 공식 Gemini API 문서에는 Gemini 3.8 Flash의 입력 한도가 1,048,576토큰, 출력 한도가 65,536토큰으로 기재되어 있습니다. 공식 Gemini 4 Pro 모델 페이지나 API 식별자는 존재하지 않습니다.
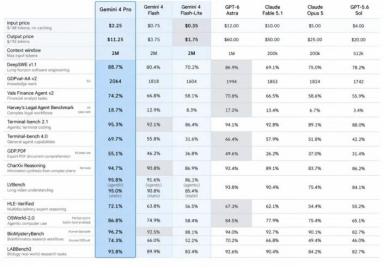
별도의 벤치마크 표도 널리 확산되었습니다.
이 표는 Gemini 4 Pro로 추정되는 모델이 다음과 같은 성과를 냈다고 주장했습니다.
| 벤치마크 | 바이럴 주장 |
|---|---|
| DeepSWE v1.1 | 88.7% |
| Terminal-Bench 2.1 | 95.3% |
| HLE-Verified | 72.1% |
| OSWorld 2.0 | 86.8% |
| GDPval-AA v2 | 2064 Elo |
이 수치가 사실이라면 해당 모델은 코딩, 에이전트, 추론, 컴퓨터 사용 작업에서 여러 주요 프런티어 시스템을 앞서게 됩니다.
하지만 이 표에는 심각한 문제가 있습니다.
공식 Google 출처, Arena 검증, 공개된 평가 구성, 재현 가능한 벤치마크 실행 기록이 없습니다. 다른 모델의 일부 비교 수치도 공식 발표 결과와 일치하지 않습니다.
예를 들어 OpenAI의 공식 GPT-6 Astra 출시 자료는 Astra가 **DeepSWE v1.1에서 74.1%**를 기록했다고 밝히며, 다른 여러 항목에도 서로 다른 벤치마크 버전을 사용합니다.
따라서 이 벤치마크 표를 검증된 Gemini 4 결과로 제시해서는 안 됩니다.
현재 상태는 간단히 다음과 같습니다.
정체가 불분명하지만 더 강력한 Arena 모델: 관찰됨
Gemini 4 Pro라는 정체: 확인되지 않음
바이럴 벤치마크 표: 검증되지 않음
1,000만 토큰 컨텍스트 / 256K 출력 주장: 검증되지 않음
Google의 공개 문서는 훨씬 더 신중한 상황을 보여줍니다.
2026년 9월 20일 기준:
gemini-3.8-flash는 일반에 공개되어 있습니다.이것이 Gemini 4가 내부적으로 테스트되고 있지 않다는 뜻은 아닙니다.
프런티어 연구소는 공식 출시 전에 공개되지 않은 체크포인트를 일상적으로 평가합니다.
다만 현재 공개된 증거만으로는 Gemini 4 Pro를 발표된 제품으로 취급할 근거가 충분하지 않다는 의미입니다.
원문의 두 번째 섹션은 유출설 자체에서 벗어나 더 넓은 개념인 재귀적 자기 개선으로 초점을 옮깁니다.
RSI는 AI 시스템이 미래의 AI 시스템을 구축, 평가 또는 개선하는 데 점점 더 많이 기여하는 과정을 뜻합니다. 이를 통해 더 나은 모델이 훨씬 더 나은 모델의 생산을 가속하는 피드백 루프가 형성됩니다.
간단한 형태는 다음과 같습니다.
AI가 AI 개발을 개선
        ↓
차세대 AI가 더 강력해짐
        ↓
더 강력한 AI가 연구개발에 더 많이 기여
        ↓
개발 주기가 가속
중요한 구분은 오늘날의 프런티어 연구소가 완전히 자율적인 지능 폭발을 공개적으로 주장하고 있지는 않다는 점입니다.
인간은 여전히 연구 목표를 정의하고, 학습 시스템을 설계하며, 컴퓨팅 자원을 배분하고, 위험한 변경을 승인하고, 모델 배포 시점을 결정합니다.
변화하고 있는 것은 AI가 이미 수행할 수 있는 개발 과정의 비중입니다.
Google의 공식 Gemini 3.8 발표는 이러한 추세가 실제임을 보여주는 가장 강력한 증거 중 하나입니다.
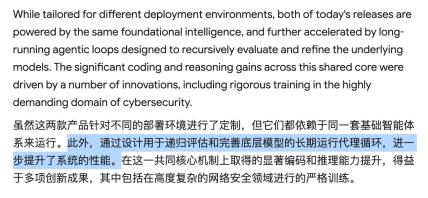
Google은 Gemini 3.8 Flash와 3.8 Flash Cyber가 기반 모델을 재귀적으로 평가하고 개선하도록 설계된 장기 실행 에이전트 루프를 통해 가속된다고 밝혔습니다.
이 표현이 중요한 이유는 커뮤니티의 추측이 아니라 Google이 직접 밝힌 내용이기 때문입니다.
이것이 Google이 완전히 자율적인 RSI를 달성했다는 뜻은 아닙니다.
다만 AI 기반 평가 루프가 이미 프로덕션 Gemini 모델의 개발 과정에 포함되어 있다는 뜻입니다.
Google DeepMind 연구원 Shunyu Yao는 3.8 출시 후 짧은 공개 게시물에서 그 의미를 다음과 같이 표현했습니다.
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
그 메시지는 아폴로 11호의 문구를 바꾸어 표현한 것이었습니다. 모델에게는 작은 한 걸음이지만, RSI에는 훨씬 더 큰 한 걸음이라는 의미였습니다.
9월 14일 Google, Google DeepMind, 메릴랜드대학교, 버지니아대학교의 연구자들은 Dream-RSI: 진화하는 세계를 통한 재귀적 자기 개선을 발표했습니다.
이 논문은 특정한 병목에 초점을 맞춥니다. 에이전트가 비용이 많이 드는 온라인 실험을 반복하지 않고 어려운 탐색 공간을 탐색하는 방식을 어떻게 개선할 수 있는가라는 문제입니다.
Dream-RSI는 과거의 탐색 기록을 중심으로 구축된 루프를 사용합니다.
연구진은 다음과 같은 분야에서 개선을 보고했습니다.
이 연구는 AI가 스스로 모든 구성 요소를 자율적으로 재설계한다는 대중적인 개념보다 범위가 좁습니다.
그럼에도 실제 재귀 메커니즘을 보여줍니다. 시스템의 이전 작업이 미래의 개선 방법을 탐색하는 방식을 개선하기 위한 학습 자료가 되는 것입니다.
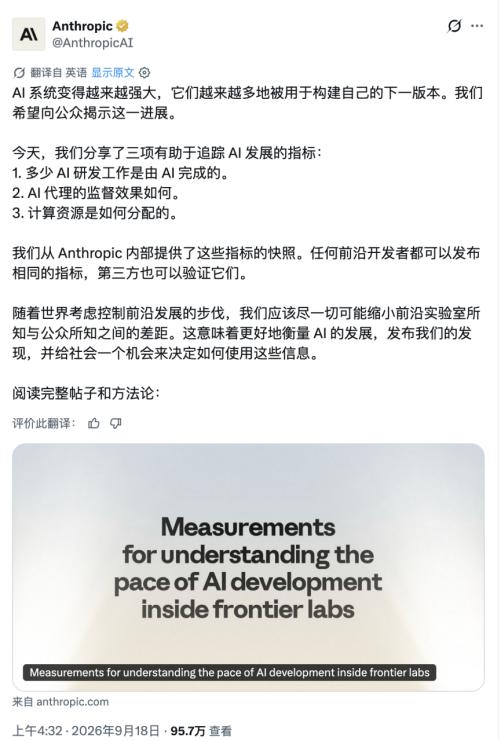
같은 주에 Anthropic은 AI가 자체 연구 과정에 얼마나 많이 유입되었는지를 보여주는 이례적으로 상세한 내부 지표를 공개했습니다.
Anthropic에 따르면 2026년 8월 기준:
Anthropic은 ‘AI가 주도한다’는 표현을 모델이 높은 수준의 프롬프트를 바탕으로 인간의 감독 아래 작업 대부분을 처음부터 끝까지 완료하는 경우로 정의합니다.
26%라는 수치는 특히 눈에 띕니다. Anthropic은 이 비중이 연초에는 1% 미만이었다고 밝혔기 때문입니다.
Anthropic은 프런티어 연구소가 자체 모델 개발 과정을 얼마나 빠르게 자동화하고 있는지 외부 관찰자들이 더 잘 파악할 수 있어야 한다고 보고 있으며, 이러한 이유로 해당 지표를 공개했습니다.
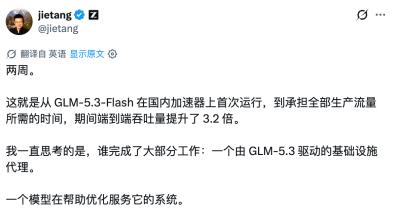
Z.ai는 또 다른 유용한 사례를 공개했습니다.
Z.ai는 GLM-5.3 기반 Infra Agent가 GLM-5.3-Flash를 제공하는 추론 인프라를 구축하고 최적화하는 데 도움을 주었다고 밝혔습니다.
Z.ai의 9월 공개 내용에 따르면:
Z.ai는 이것이 완전한 재귀적 자기 개선은 아니라고 명시했습니다.
Z.ai의 설명은 더 절제되어 있습니다. 하나의 모델이 다른 모델을 제공하는 시스템을 최적화하는 데 도움을 주는 최소 규모의 루프가 등장했다는 것입니다.
이 구분은 중요합니다.
오늘날의 시스템에는 여전히 인간이 설정한 목표, 피드백 설계, 인프라 제약, 고위험 변경에 대한 검토가 필요합니다.
그러나 이러한 루프는 더 이상 순수한 이론에 머물지 않습니다.
원문 기사의 마지막 섹션은 RSI를 프런티어 AI 리더들 사이에서 새롭게 등장한 논쟁과 연결합니다.
9월 12일 Anthropic CEO Dario Amodei는 안전성 연구가 모델 역량을 따라잡을 시간을 더 확보할 수 있도록 업계가 프런티어의 속도를 조절해야 한다고 공개적으로 주장했습니다.
그의 제안에는 독립적인 제3자 평가자에게 영구적인 직원 수준의 접근 권한을 제공하는 방안과, 장기적으로 역량 임계값 및 안전 조치에 대한 더 폭넓은 공조가 포함되었습니다.
Sam Altman, Elon Musk, Demis Hassabis는 모두 특정 조건에서 프런티어 개발에 더 강력한 안전장치나 더 느린 속도가 필요할 수 있다는 일반적인 생각에 다양한 수준으로 동의했습니다.
하지만 신중함이 필요하다는 데 동의하는 것과 누가 먼저 속도를 늦출지를 합의하는 것은 별개의 문제입니다.
모든 프런티어 연구소는 같은 전략적 문제에 직면합니다.
한 기업이 역량 개발을 늦추고 경쟁사들이 계속 발전한다면 기술적 리더십, 인재, 고객, 시장 점유율을 잃을 위험이 있습니다.
같은 논리는 국가 차원에서도 작동합니다.
프런티어 개발에 엄격한 제한을 고려하는 국가는 경쟁국이 계속 가속할 수 있다는 점을 우려할 수 있습니다.
따라서 주요 연구소들이 위험이 심각하다는 데 동의하더라도, 공동의 둔화 제안은 구조적으로 실행하기 어렵습니다.
현재 모델 사이클에서도 이러한 긴장이 드러납니다.
Google은 Flash 모델을 빠르게 출시하고 있으며 더 강력한 비공개 체크포인트를 테스트하고 있을 가능성이 있습니다. Anthropic은 Claude가 자체 연구개발을 얼마나 수행하는지 공개적으로 측정하는 한편, 향후 모델 출시도 고려하고 있습니다. OpenAI는 프런티어 시스템을 계속 출시하면서 제3자 평가와 안전 요구사항을 확대해 왔습니다.
이는 단순한 모순이 아닙니다.
문제는 조정입니다. 동일한 조직이 프런티어 위험을 진심으로 우려하면서도 동시에 프런티어를 유지해야 한다는 강력한 유인을 받을 수 있습니다.
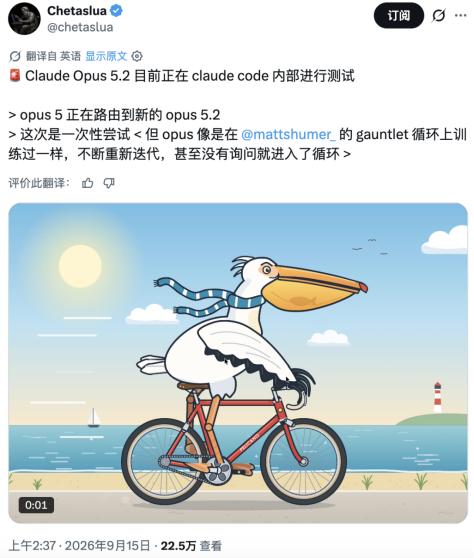
원문 기사는 다른 연구소들도 기존 제품 표면 뒤에서 차세대 모델을 테스트하고 있을 수 있다는 커뮤니티 보고도 인용합니다.
널리 공유된 한 게시물은 일부 Claude Code 요청에서 claude-opus-5-2 식별자가 표시되었다고 주장했습니다.
이는 Anthropic의 공식 제품 발표가 아닙니다.
마찬가지로 커뮤니티 게시물은 현재 발표된 라인업을 넘어서는 추가 OpenAI 모델 식별자가 목격되었다고 주장했습니다.
이러한 보고는 Gemini 4 Pro 이론과 같은 방식으로 취급해야 합니다. 무언가가 테스트 중일 수 있다는 정황으로는 유용하지만, 공식 출시, 사양 또는 출시일과 동일한 의미는 아닙니다.
| 주장 | 2026년 9월 20일 기준 상태 |
|---|---|
| Google이 9월 2일 Gemini 3.8 Flash를 출시함 | 확인됨 |
| Gemini 3.8이 장기 실행 에이전트 루프를 사용해 기반 모델을 재귀적으로 평가하고 개선함 | Google이 확인 |
gemini-3.8-flash라는 라벨의 더 강력한 모델이 Arena에 등장함 | 보고되었으며 널리 관찰됨 |
| Arena 모델이 Gemini 4 Pro임 | 확인되지 않음 |
| Google이 Gemini 4 Pro를 공식 발표함 | 아니요 |
| Google의 공개 모델 문서에 현재 Gemini 4가 등재되어 있음 | 아니요 |
G4P-ARGON이 실제 Google 내부 모델 식별자임 | 검증되지 않음 |
| Gemini 4 Pro가 1,000만 개 이상의 컨텍스트와 256K 출력을 제공함 | 검증되지 않음 |
| 바이럴 Gemini 4 벤치마크 점수가 공식 결과임 | 아니요 |
| Dream-RSI가 2026년 9월에 발표된 실제 연구 논문임 | 확인됨 |
| Anthropic이 Claude가 측정된 AI 연구개발 작업의 26%를 주도한다고 밝힘 | 확인됨 |
| Anthropic이 측정된 AI 연구개발 작업의 90% 이상이 최소한 AI와 협력한다고 밝힘 | 확인됨 |
| Z.ai가 GLM-5.3 Infra Agent가 GLM-5.3-Flash 서빙 처리량을 3.2배 높이는 데 도움을 주었다고 밝힘 | 기업이 보고한 결과로 확인됨 |
| Claude Opus 5.2 커뮤니티 목격이 공식 출시를 의미함 | 아니요 |
아니요. Google은 Gemini 4 Pro를 공식 발표하지 않았으며, 현재 공개된 Gemini API 문서에도 Gemini 4 모델이 등재되어 있지 않습니다. 현재 이야기는 이례적으로 뛰어난 Arena 모델과 그 정체에 관한 커뮤니티의 추측에 기반합니다.
숨겨진 모델은 gemini-3.8-flash 라벨을 사용했지만 SVG, 웹, 3D, 에이전트형 테스트에서 공개 프로덕션 모델보다 강력해 보였습니다. 또한 더 느리고 신중한 동작을 보였기 때문에 일부 테스터들은 Flash 모델보다 Pro급 체크포인트에 가까워 보인다고 판단했습니다.
검증되지 않았습니다. 바이럴 표에는 공식 Google 또는 Arena의 뒷받침이 없고, 재현 가능한 평가 설정도 없으며, 다른 공급업체의 공식 벤치마크 발표와 완전히 일치하지 않는 비교 수치가 포함되어 있습니다.
재귀적 자기 개선은 AI 시스템이 더 강력한 AI 시스템을 만드는 과정을 개선하는 데 도움을 주어 피드백 루프를 형성하는 것을 말합니다. 현재 프런티어 연구소들이 완전히 자율적인 RSI를 공개적으로 주장하는 것은 아니지만, AI는 이미 평가, 코딩, 인프라 최적화, 모델 연구개발에 기여하고 있습니다.
Google은 Gemini 3.8이 기반 모델을 재귀적으로 평가하고 개선하는 장기 실행 에이전트 루프를 통해 가속된다고 밝혔습니다. 이는 실제 자기 개선 메커니즘이지만, 인간의 감독 없이 시스템이 자체 후속 모델을 설계하는 완전한 자율 시스템보다는 훨씬 좁은 범위입니다.
Dream-RSI는 Google, Google DeepMind 및 학술 협력자들이 2026년 9월에 발표한 연구 프레임워크입니다. 에이전트가 탐색 정책을 저렴하게 개선한 다음 실제 환경에 개선된 정책을 다시 적용할 수 있도록 과거 탐색 기록을 리플레이 시뮬레이터로 사용합니다.
Anthropic은 Claude가 측정된 AI 연구개발 작업의 26%를 주도하며, 90% 이상이 최소한 AI와 협력하여 수행된다고 밝혔습니다. Anthropic은 또한 측정된 어떤 작업 하위 영역에서도 Claude가 완전히 자율적이지 않다고 설명합니다.
한 기업이 혼자 속도를 늦추면 계속 발전하는 경쟁사에 뒤처질 위험이 있습니다. 국가 간에도 같은 인센티브 문제가 존재하기 때문에 공동 평가 규칙과 역량 임계값은 제안하기가 실행하기보다 쉽습니다.
예상보다 강력한 gemini-3.8-flash 라벨의 모델이 Arena에 등장했으며, 커뮤니티 테스터들은 Gemini 4 Pro 이론을 그럴듯하게 보이게 하는 이례적인 결과물을 충분히 만들어냈습니다. 그러나 그럴듯하다는 것은 확인되었다는 뜻이 아닙니다. Google은 Gemini 4 Pro를 발표하지 않았고, 바이럴 백엔드 스크린샷은 검증되지 않았으며, 온라인에서 유통되는 벤치마크 표에도 공식적인 뒷받침이 없습니다.
더 오래 지속될 중요한 이야기는 AI를 활용한 AI 개발의 가속입니다. Google은 Gemini 3.8이 장기 실행 루프를 사용해 기반 모델을 재귀적으로 평가하고 개선한다고 공개적으로 밝혔습니다. Dream-RSI는 자기 개선 탐색 루프를 구체화합니다. Anthropic은 Claude가 이미 측정된 AI 연구개발 작업의 26%를 주도한다고 밝혔고, Z.ai는 GLM 기반 인프라 에이전트가 GLM-5.3-Flash의 서빙 처리량을 세 배 높이는 데 도움을 주었다고 설명했습니다.
이로 인해 업계의 둔화 논쟁은 더 쉬워지는 것이 아니라 더 어려워집니다. 프런티어 연구소들은 독립적인 평가와 더 강력한 안전장치가 필요하다는 데 동의하면서도 계속 발전해야 한다는 강력한 유인을 동시에 받고 있습니다.
Gemini 4 Pro는 여전히 소문이지만, AI 시스템이 차세대 AI를 구축하는 데 도움을 주는 방향으로의 변화는 이미 현실입니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.