For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/glm-5-3-highspeed-in-zcode-490-tps-test-1-df8d564e.md.
새로운 Z.ai 모델명인 **GLM-5.3 Highspeed**가 ZCode 내부에 조용히 등장했습니다.
새로운 Z.ai 모델명인 GLM-5.3 Highspeed가 ZCode 내부에 조용히 등장했습니다.
이 모델은 ZCode 3.15.1에서 확인되었으며, 일부 구독자는 무작위로 HighSpeed 체험판 대상에 선정되고 있습니다. 사용자 @leo114119는 출력 속도가 초당 약 490토큰에 근접하는 실행 결과를 게시했으며, 다른 스크린샷에는 약 493 tok/s가 표시되었습니다.
이는 눈에 띄는 수치입니다.
모델이 초당 490개의 출력 토큰을 지속적으로 생성할 수 있다면, 10,000개의 출력 토큰을 생성하는 데 걸리는 시간은 약 다음과 같습니다.
10,000 / 490 ≈ 20.4초
이 계산에는 토큰 생성 단계만 포함됩니다. 첫 토큰까지의 시간, 가시적 출력 이전의 추론, 도구 호출, 네트워크 오버헤드, 에이전트 워크플로 내의 지연은 포함하지 않습니다.
더 중요한 점은, 현재 490 TPS 결과는 공식적인 Z.ai 처리량 보장이 아니라 커뮤니티 관측치라는 것입니다.
확인된 사실은 ZCode 3.15.1이 구독자를 대상으로 무작위 GLM HighSpeed 체험을 도입했다는 점과, glm-5.3-highspeed 식별자가 이미 Pi의 공개 모델 카탈로그에 존재한다는 점입니다.
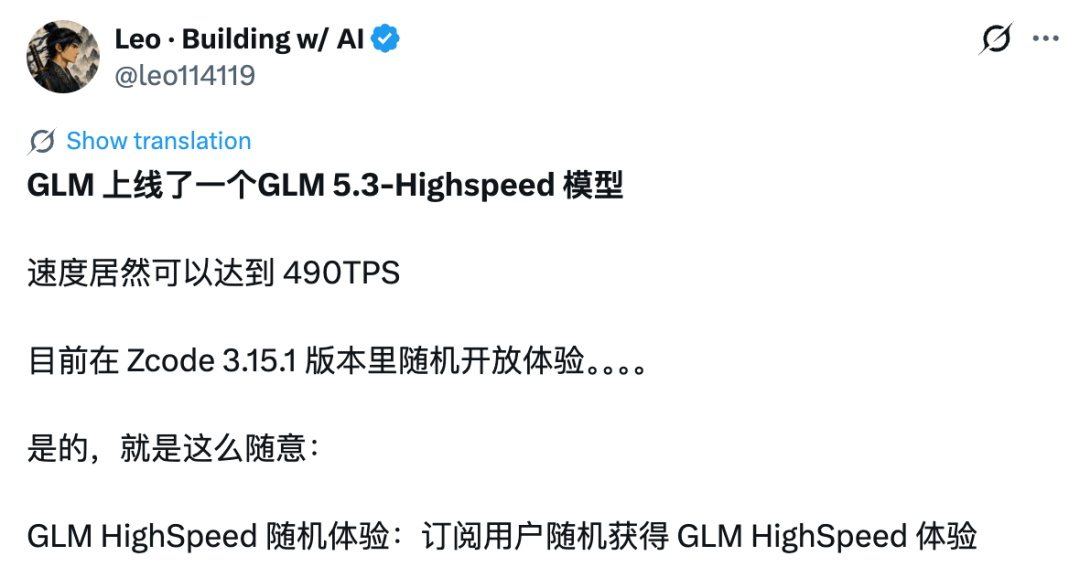
첫 단서는 단순한 소셜 미디어 스크린샷만이 아닙니다.
ZCode의 공식 버전 3.15.1 릴리스 노트에는 다음과 같이 명시되어 있습니다.
이제 구독자는 무작위로 GLM HighSpeed 체험 대상에 선정될 수 있습니다.
이 문구는 계정마다 액세스 가능 여부가 다른 이유를 설명한다는 점에서 중요합니다.
원문은 작성자가 GLM-5.3 Highspeed를 수동으로 추가하고 전환하려 했지만 Lite 구독에서는 사용할 수 없었다고 전합니다.
UI에는 모델이 존재하는 것으로 표시되었지만, 현재 요금제에는 액세스 권한이 포함되지 않았습니다.
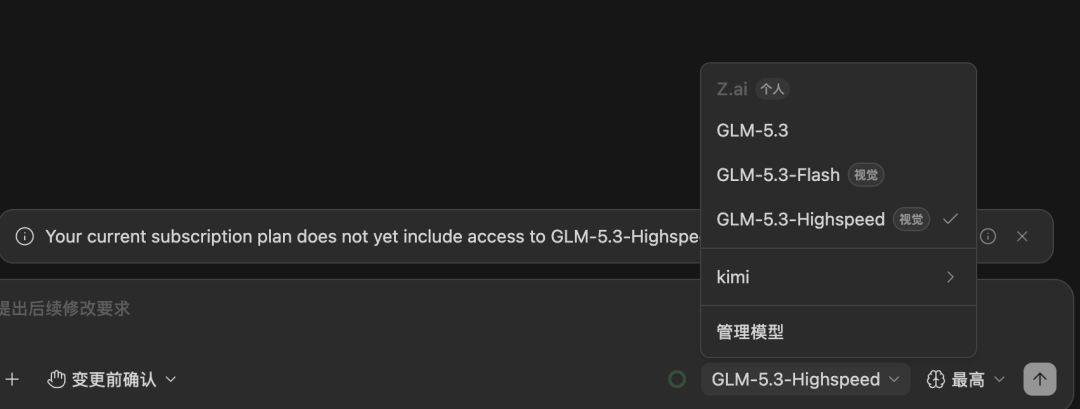
이는 ZCode의 현재 출시 전략과 일치합니다.
ZCode 3.15.1로 업데이트
        ↓
구독자 계정
        ↓
무작위 HighSpeed 체험 자격
        ↓
선정된 경우 클라이언트에 체험 액세스 표시
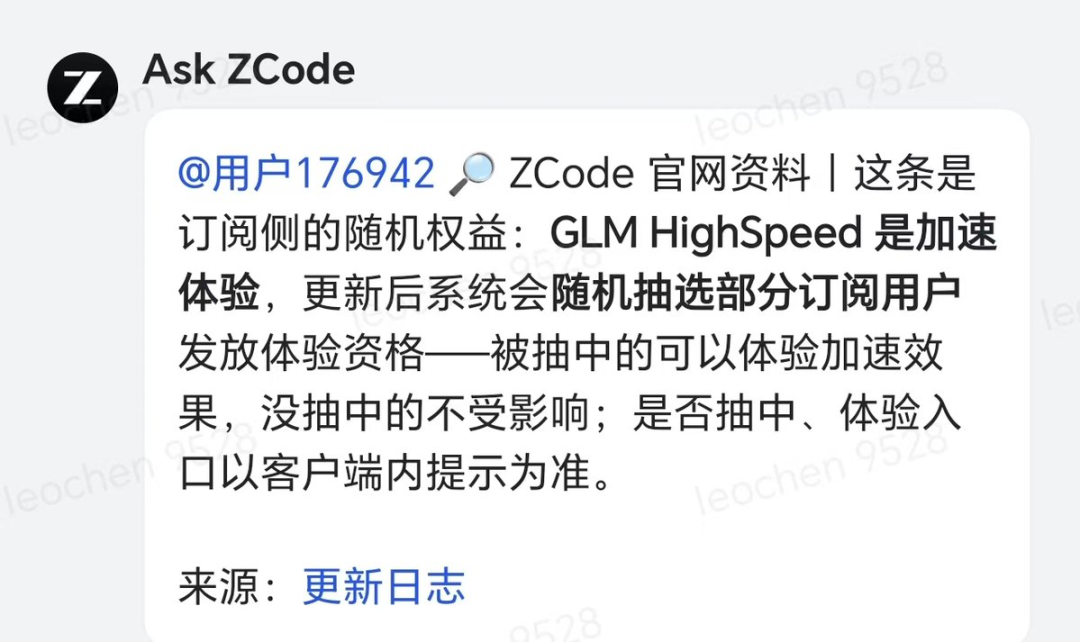
현재로서는 모든 유료 등급에서 자동으로 제공되는 기능이라고 설명되지 않습니다.
ZCode 자체 문구를 요약한 커뮤니티 스크린샷도 같은 점을 보여 줍니다. HighSpeed 경험은 무작위로 부여되는 구독자 혜택이며, 특정 계정이 선정되었는지는 클라이언트가 기준이 됩니다.
이 모델이 주목받은 가장 큰 이유는 속도 스크린샷입니다.
원문에서 언급된 사용자는 약 493 tok/s를 보여 주는 실행 결과를 게시했습니다.
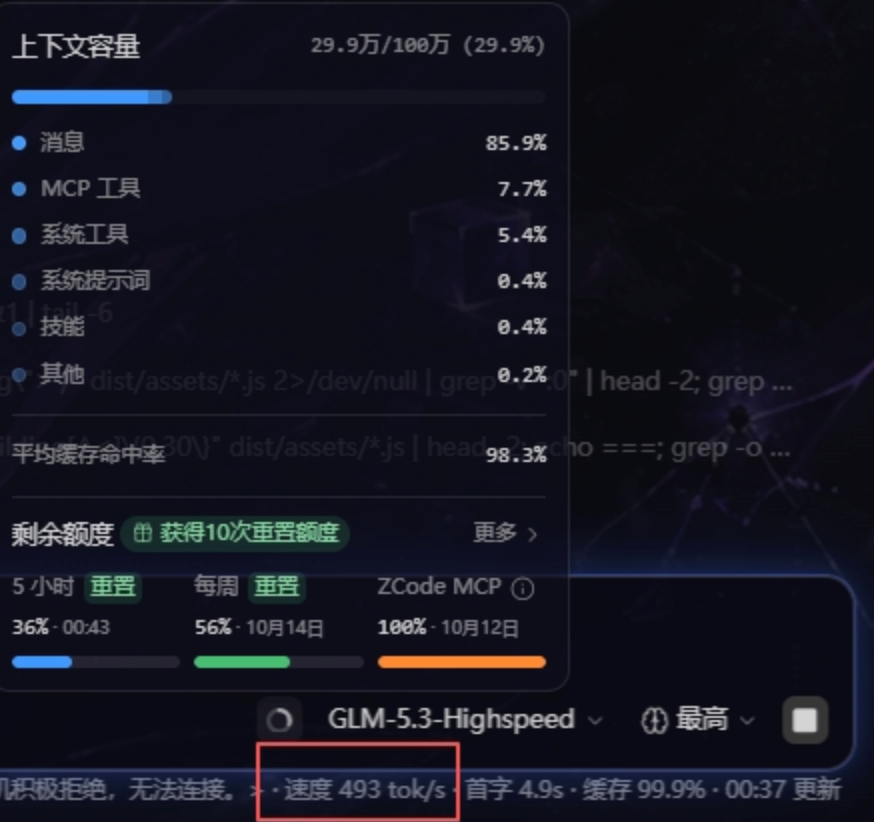
이는 글의 제목에 쓰인 490 TPS 수치와 충분히 가깝기 때문에, 그 차이는 의미가 없습니다.
다만 이 스크린샷이 알려 주는 것과 알려 주지 않는 것을 정확히 구분할 필요가 있습니다.
GLM-5.3-Highspeed로 표시된 ZCode 세션.처리량은 다음 요소들에 크게 좌우될 수 있습니다.
따라서 현재 가장 적절한 결론은 다음과 같습니다.
GLM-5.3 Highspeed는 공개된 ZCode 테스트 최소 한 건에서 매우 높은 출력 처리량을 보여 주었지만, Z.ai는 아직 공식적인 490 TPS 사양을 발표하지 않았습니다.
이 수치가 두드러지는 이유는 GLM 계열에 이미 여러 속도 중심 서빙 옵션이 존재하기 때문입니다.
Z.ai 문서에 따르면 GLM-5.3-FlashX는 최대 200 tokens/s에 도달할 수 있습니다. FlashX는 GLM-5.3-Flash의 고속 서빙 변형입니다.
Pi와 Z.ai 문서는 GLM-5.3-Flash에 대해 100만 토큰 컨텍스트 윈도우와 128K급 최대 출력을 명시하고 있으며, FlashX는 더 낮은 서빙 지연 시간과 빠른 생성에 중점을 둡니다.
원문은 작성 시점에 Z.ai의 퍼스트파티 API에서 GLM-5.3-Flash가 약 60 tokens/s를 기록했다는 Artificial Analysis 측정치도 인용합니다.
독립적인 처리량 측정치는 시간에 따라 변하며, 이후 스냅샷은 제공업체와 날짜에 따라 의미 있는 차이를 보여 왔습니다. 따라서 단일 수치를 영구적인 값으로 받아들여서는 안 됩니다.
따라서 유용한 비교는 다음과 같습니다.
| 모델 / 서빙 경로 | 보고되었거나 문서화된 속도 | 상태 |
|---|---|---|
| ZCode의 GLM-5.3 Highspeed | 사용자 스크린샷에서 약 490–493 tok/s | 커뮤니티 관측 / 무작위 체험 |
| GLM-5.3-FlashX | 최대 200 tok/s | 공개적으로 문서화된 속도 중심 변형 |
| Z.ai API의 GLM-5.3-Flash | 독립적인 퍼스트파티 스냅샷에서는 훨씬 낮음 | 독립 측정치는 날짜/제공업체에 따라 달라짐 |
그 격차가 충분히 크기 때문에, 사람들은 자연스럽게 “Highspeed”가 실제로 무엇을 의미하는지 궁금해합니다.
glm-5.3-highspeed가 등록되어 있습니다모델명은 ZCode에만 등장한 것이 아닙니다.
Pi의 공개 모델 카탈로그에는 이미 GLM-5.3 Highspeed 페이지가 있습니다.
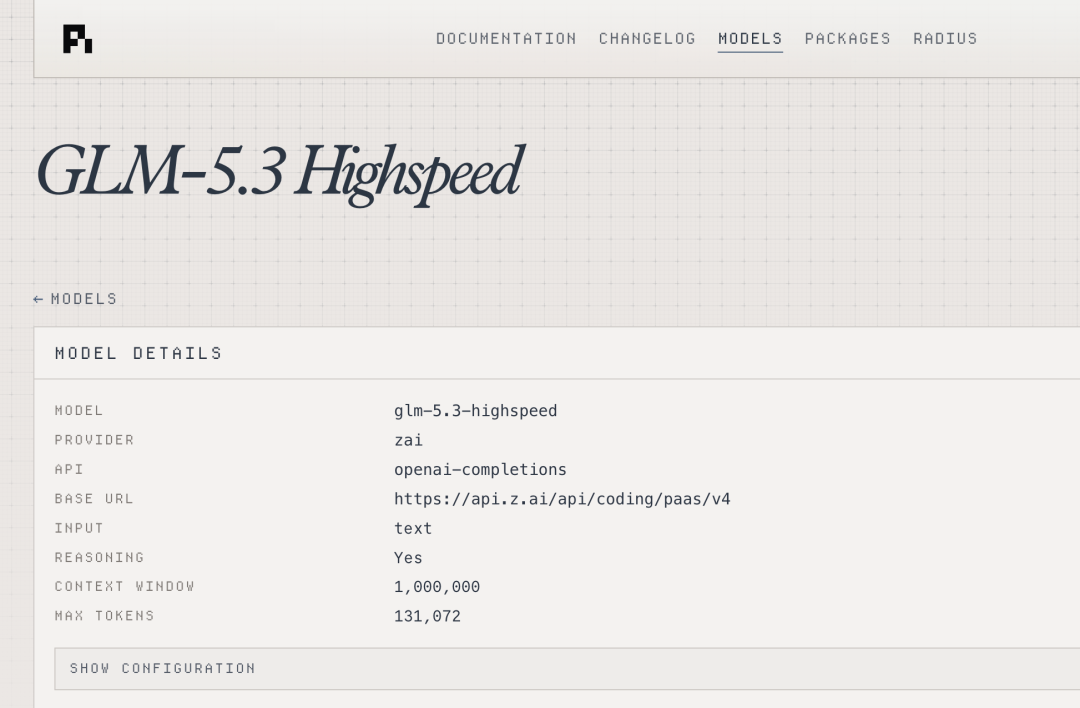
등록된 구성은 다음과 같습니다.
| 필드 | 값 |
|---|---|
| 모델 ID | glm-5.3-highspeed |
| 제공업체 | zai |
| API 스타일 | OpenAI 호환 completions |
| 입력 | 텍스트 |
| 추론 | 예 |
| 컨텍스트 윈도우 | 1,000,000토큰 |
| 최대 출력 | 131,072토큰 |
| 추론 수준 | low / high / max |
Pi에 표시된 엔드포인트는 다음과 같습니다.
https://api.z.ai/api/coding/paas/v4
Pi는 이 모델을 Z.ai의 코딩 API 형식에도 매핑합니다.
특히 다음 두 가지 세부 사항이 주목할 만합니다.
이는 현재 GLM-5.3 계열 도구 전반에서 확인되는 장문 컨텍스트 구성과 일치합니다.
코딩 에이전트에서 100만 토큰 컨텍스트는 다음과 같은 작업에 유용할 수 있습니다.
이는 약 128K 토큰입니다.
이 역시 여러 GLM-5.3 계열 항목의 현재 장문 출력 구성과 일치합니다.
따라서 Pi 등록 정보는 Highspeed가 일반 GLM-5.3 계열과 명백히 다른 컨텍스트 아키텍처를 사용한다는 것을 시사하지 않습니다.
주로 Highspeed 식별자가 구조화된 제공업체 구성을 가질 만큼 실재한다는 점을 확인합니다.
Pi는 다음 세 가지 활성 추론 설정을 매핑합니다.
low
high
max
원문은 이러한 설정이 일반 GLM-5.3 구성에서도 익숙한 설정이라고 언급합니다.
이 점은 Highspeed가 완전히 새로운 베이스 모델이라고 성급하게 가정하지 말아야 할 또 다른 이유입니다.
다음과 같은 가능성이 있습니다.
Z.ai 모델 카드가 없는 상황에서는 이러한 가능성을 확실히 구분할 수 없습니다.
이름만으로는 충분하지 않습니다.
여기서부터는 이야기가 추측의 영역으로 들어갑니다.
ZCode 스크린샷이 등장하기 전부터 Reddit 사용자들은 Pi 카탈로그 내의 glm-5.3-highspeed를 발견하고 이것이 Omen Alpha와 관련되었을지 질문했습니다.
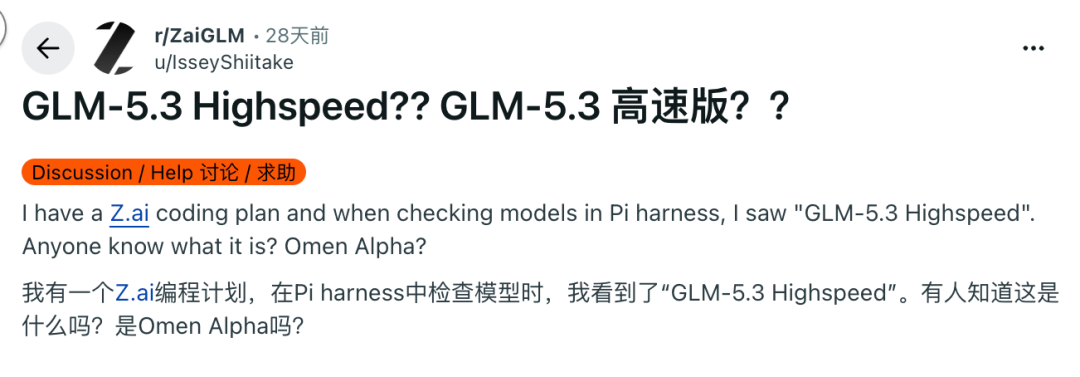
Omen Alpha는 OpenCode 테스트에서 등장한 익명 모델입니다.
커뮤니티 구성원들은 관찰된 동작과 인프라 단서를 바탕으로 이를 Zhipu/Z.ai와 연결해 왔습니다.
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
한 Reddit 답변은 GLM-5.3-Flash에 가까운 품질을 유지하면서 훨씬 높은 처리량을 가진 새로운 고속 GLM 변형일 수 있다고 추측했습니다.
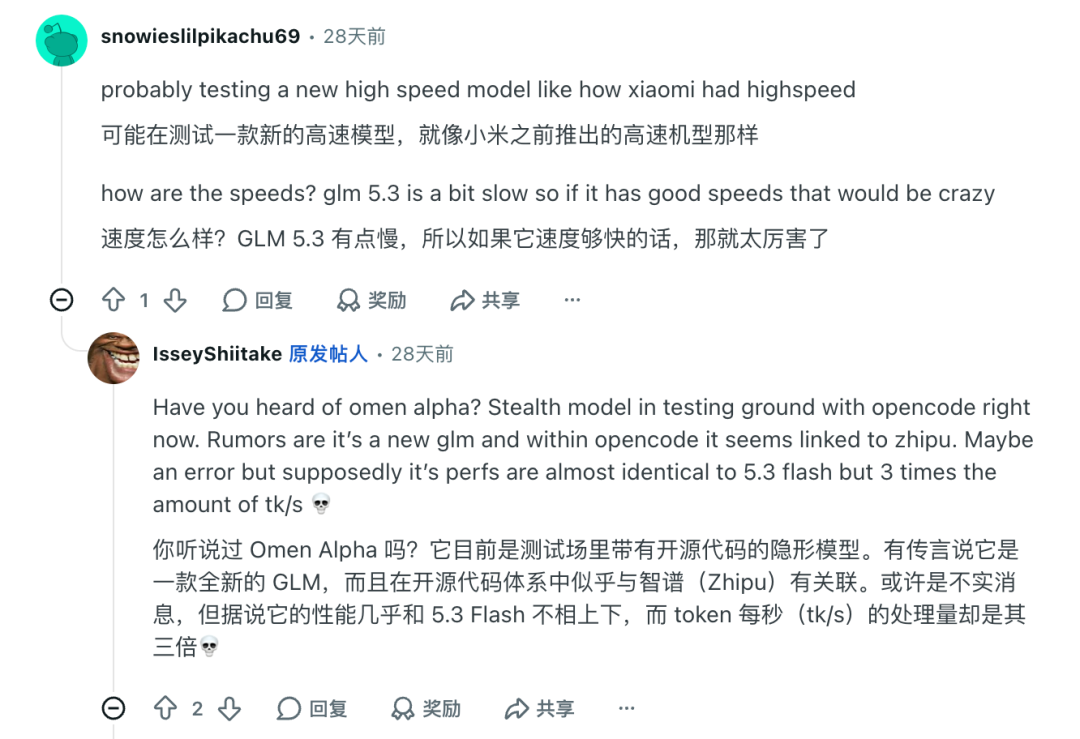
또 다른 출처 스크린샷에는 Zhipu 관련 제공업체 레이블에 연결된 omen-alpha 모델 항목이 표시되어 이 이론에 힘을 보탰습니다.
하지만 이 중 어떤 것도 모델의 정체를 결정적으로 입증하지는 못합니다.
원문은 여러 추측을 열거합니다.
Z.ai가 공식 매핑을 발표하기 전까지 이러한 명칭은 커뮤니티 추측의 범주에 머물러야 합니다.
두 엔드포인트는 같은 모델이 아니더라도 매우 비슷하게 느껴질 수 있습니다.
관찰된 동작은 다음 요인의 영향을 받을 수 있습니다.
따라서 행동상의 유사성은 근거가 될 수 있지만 증거는 아닙니다.
이 명칭 자체는 Zhipu에 낯선 방식이 아닙니다.
이 회사는 이전에도 GLM 모델의 고속 버전을 출시했습니다.
원문은 2026년 5월 초당 약 400토큰의 출력 속도로 홍보된 GLM-5.1-highspeed를 가리킵니다.
더 최근의 GLM-5.3 계열에도 최대 200 tok/s로 문서화된 공개 속도 중심 변형인 FlashX가 있습니다.
이는 더 넓은 제품 패턴을 시사합니다.
베이스 또는 플래그십 모델
        ↓
고속 서빙 경로
        ↓
대화형 워크로드를 위한 더 낮은 지연 시간 / 더 높은 처리량
이 패턴은 새 모델 가중치를 가정하지 않더라도 GLM-5.3 Highspeed 제품이 기술적으로 타당하다는 점을 보여 줍니다.
다만 이는 공식 제품 설명이 아니라 추론에 불과합니다.
490 TPS가 왜 중요한가요?
200토큰짜리 짧은 응답에서는 100 TPS와 500 TPS의 차이가 불과 몇 초입니다.
하지만 장문의 에이전트 출력, 코드 생성 또는 상세한 추론에서는 그 차이가 훨씬 커집니다.
예를 들면 다음과 같습니다.
| 출력 길이 | 100 tok/s | 200 tok/s | 490 tok/s |
|---|---|---|---|
| 1,000토큰 | 10.0초 | 5.0초 | 약 2.0초 |
| 5,000토큰 | 50.0초 | 25.0초 | 약 10.2초 |
| 10,000토큰 | 100.0초 | 50.0초 | 약 20.4초 |
이는 단순화한 디코드 시간 계산일 뿐입니다.
실제 에이전트 작업에는 다음도 포함됩니다.
그럼에도 더 빠른 디코드는 긴 반복형 워크플로를 훨씬 더 반응성 있게 느끼도록 만들 수 있습니다.
이는 특히 하나의 사용자 요청이 하나의 최종 답변이 아니라 여러 모델 호출을 생성할 수 있는 ZCode와 같은 코딩 에이전트에서 중요합니다.
약 493 tok/s 스크린샷에는 매우 높은 캐시 적중률도 표시됩니다.
이 점은 주목할 가치가 있습니다.
높은 캐시 적중률은 장시간 에이전트 세션에서 반복되는 프롬프트 처리를 줄일 수 있습니다.
일반적인 코딩 세션은 다음을 반복적으로 함께 전달할 수 있습니다.
시스템 지침
+ 리포지토리 컨텍스트
+ 도구 정의
+ 이전 대화
+ 최근 변경 사항
이 컨텍스트의 상당 부분이 효율적으로 재사용되면, 시스템은 각 턴의 입력 측을 다시 계산하는 데 드는 시간을 줄일 수 있습니다.
그러나 표시되는 tok/s 수치는 일반적으로 프롬프트 캐시 처리량만이 아니라 출력 생성 처리량을 의미합니다.
캐시 수치는 프롬프트 재사용과 빠른 디코딩이 모두 잘 작동할 때 전체 세션 지연 시간이 훨씬 더 좋아 보일 수 있기 때문에 여전히 중요합니다.
이 역시 하나의 스크린샷만으로 모델을 완전히 특성화할 수 없는 이유입니다.
GLM-5.3-FlashX는 Z.ai 문서가 이미 속도 중심 모델로 설명하고 있으므로 가장 명확한 공개 비교 대상입니다.
현재 FlashX에 대해 공개된 정보에는 다음이 포함됩니다.
glm-5.3-flashx.따라서 FlashX는 Z.ai가 이를 완전히 새로운 지능 세대로 제시하지 않고도 전용 고처리량 변형을 만들 수 있음을 보여 줍니다.
GLM-5.3 Highspeed도 더 빠른 서빙 계층에서 같은 제품 논리를 따를 수 있습니다.
이는 공식 확인이 아닌 추론에 머뭅니다.
현재 증거는 세 가지 신뢰 수준으로 구분할 수 있습니다.
glm-5.3-highspeed를 Z.ai 모델로 등록하고 있습니다.이 구분이 현재 출시 상황을 읽는 가장 안전한 방법입니다.
GLM-5.3 Highspeed는 ZCode와 Pi의 공개 모델 카탈로그에 등장한 Z.ai 모델 식별자입니다. ZCode 3.15.1은 구독자를 위한 무작위 GLM HighSpeed 체험을 공식적으로 확인하지만, 여기서 확인한 출처에서는 Z.ai가 GLM-5.3 Highspeed의 완전한 독립 모델 카드를 아직 게시하지 않았습니다.
공개 사용자 스크린샷은 한 번의 ZCode 실행에서 약 493 tok/s를 보여 주며, 이것이 490 TPS라는 제목의 근거입니다. 유용한 관측치이지만 공식적인 지속 처리량 보장은 아니며, 워크로드, 캐시 동작, 지역 및 서버 상태에 따라 달라질 수 있습니다.
Pi는 현재 glm-5.3-highspeed에 대해 1,000,000토큰의 컨텍스트 윈도우와 최대 131,072토큰의 출력을 등록하고 있습니다. 이 값들은 다른 현재 GLM-5.3 계열 모델의 장문 컨텍스트 구성과 유사합니다.
아니요. ZCode의 공식 v3.15.1 변경 로그는 구독자가 GLM HighSpeed 체험 대상에 무작위로 선정된다고 밝힙니다. 계정이 선정되지 않았다면 모델명이 보이더라도 반드시 실행할 수 있는 것은 아닙니다.
두 제품이 동일하다는 공식 확인은 없습니다. FlashX는 최대 200 tok/s로 문서화된 GLM-5.3-Flash의 공개 고속 변형인 반면, GLM-5.3 Highspeed는 현재 ZCode 체험과 Pi의 코딩 제공업체 카탈로그를 통해 나타나고 있습니다.
그것은 여전히 추측입니다. Reddit과 OpenCode 사용자들은 Omen Alpha를 Zhipu/Z.ai와 연결해 왔지만, Omen Alpha가 glm-5.3-highspeed에 매핑된다는 것을 확인하는 공식 출처는 없습니다.
코딩 에이전트는 파일 읽기, 패치 작성, 도구 실행, 결과 검토 중에 여러 번의 긴 모델 호출을 수행하는 경우가 많습니다. 높은 디코드 처리량은 특히 모델이 호출당 수천 토큰을 생성할 때 그 단계들 사이의 대기 시간을 줄일 수 있습니다.
체험을 포함하는 버전으로 업데이트한 뒤 최신 ZCode 클라이언트를 사용하세요. ZCode의 자체 릴리스 노트에 따르면 액세스는 구독자에게 무작위로 할당되므로, 자격 여부는 계정/클라이언트 UI가 실질적인 기준입니다.
glm-5.3-highspeed 제공업체 구성을 노출하는 공개 모델 및 에이전트 도구 카탈로그입니다.GLM-5.3 Highspeed는 더 이상 단순히 우연히 보인 모델명이 아닙니다. ZCode 3.15.1은 구독자를 위한 무작위 GLM HighSpeed 체험을 공식적으로 확인했으며, Pi는 이미 100만 토큰 컨텍스트 윈도우와 131,072토큰 출력 제한을 가진 구조화된 glm-5.3-highspeed 구성을 노출하고 있습니다.
눈길을 끄는 490–493 tok/s 수치는 실제 공개 스크린샷에서 비롯되었지만, 공식 Z.ai 처리량 보장이 아니라 사용자 관측치에 머뭅니다. 가장 안전한 해석은 Z.ai가 매우 빠른 코딩 서빙 경로를 테스트하고 있으며, 아직 전체 제품 사양을 공개하지 않았다는 것입니다.
Omen Alpha와의 연관성도 여전히 해결되지 않았습니다. 관련이 있는 것으로 밝혀질 수는 있지만, 현재 증거는 공식적이라기보다 정황적이고 커뮤니티 주도적입니다.
현재 확인된 것은 출시 절차와 모델 식별자이며, 아직 확인되지 않은 것은 정확한 아키텍처, 공개 가격, 지속 처리량, 그리고 Omen Alpha가 동일 모델인지 여부입니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.



