For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/gpt-6-astra-unitree-g1-homebody-kitchen-r-56df14d6.md.
Stanford와 Caltech의 HomeBody 프로젝트는 GPT Astra와 Unitree G1 휴머노이드를 연결해 낯선 주방을 탐색하고, 공간 기억을 구축하며, 디지털 트윈을 재구성하고, 재사용 가능한 내비게이션 및 조작 스킬을 호출해 장기 작업...
체화된 AI의 최신 단계는 또 하나의 탁상형 로봇 팔 데모가 아닙니다.
Unitree G1 휴머노이드는 이제 낯선 주방을 탐색하고, 물체의 위치를 기억하며, 방 건너편에 있는 물건을 정리하고, 서랍을 열고, 더 이상 보이지 않는 약을 가져와 사람에게 건네는 모습을 보여주었습니다.
이 프로젝트의 이름은 HomeBody이며, Stanford University와 Caltech의 연구진이 진행했습니다.
핵심 아이디어는 놀라울 정도로 간단합니다.
프런티어 비전-언어 모델이 로봇 스킬을 도구로 취급하도록 합니다.
모델에 모든 관절 명령을 출력하도록 요구하는 대신, HomeBody는 GPT Astra가 작업을 이해하고 다음에 일어나야 할 일을 결정한 뒤, 내비게이션, 집기, 놓기, 서랍 열기 및 물체 회수를 위한 재사용 가능한 스킬을 호출하도록 합니다.
이를 통해 모델은 저수준 모터 컨트롤러가 아니라 고수준 플래너가 됩니다.
그 결과 일반적인 “물체 보기, 집기, 중지” 방식보다 더 긴 시간 범위의 로봇 워크플로가 구현됩니다.
주방 시연에서 로봇은 먼저 환경을 탐색하고 지속적인 공간 기억을 구축합니다. 그런 다음 디지털 트윈을 재구성하고, 해당 표현을 실제 방과 정렬하며, 기억된 관찰 정보를 사용해 이후 지시를 수행합니다.
예를 들어 사용자는 다음과 같이 말할 수 있습니다.
“주방을 정리해 줘. 커피 봉지는 아일랜드에 놓고 상한 우유팩은 버려 줘.”
그러면 G1은 서로 다른 위치 사이를 이동하고, 커피 봉지를 수거하며, 지정된 우유팩을 버립니다.
두 번째 작업은 이 시스템의 특성을 더욱 분명하게 보여줍니다.
“약을 두고 왔는데 가져다줄 수 있어? 그리고 가는 김에 상한 우유팩도 버려 줘.”
요청이 이루어지는 순간 약은 보이지 않습니다.
HomeBody는 저장된 공간 기억을 검색하고, 약이 이전에 관찰된 서랍을 기억한 뒤 그곳으로 이동해 서랍을 열고 약을 꺼내 사람에게 건넵니다. 동시에 우유팩을 버리는 작업도 완료합니다.
이것이 중요한 변화입니다.
로봇은 더 이상 현재 카메라 앞에 보이는 것에만 반응하지 않습니다. 전체 공간에 걸쳐 현재 인식, 기억된 관찰, 방의 기하 구조, 내비게이션, 조작, 작업 순서를 결합합니다.
HomeBody의 핵심 설계는 한 문장으로 요약할 수 있습니다.
GPT Astra는 구조화된 도구 호출을 통해 로봇 스킬을 선택하고 순서를 정합니다.
모델은 사용자의 목표를 이해하고 다음에 무엇이 일어나야 하는지 결정합니다.
로봇 스택은 물리적 세부 사항을 처리합니다.
간단히 표현하면 다음과 같습니다.
사용자 지시
      ↓
GPT Astra / System 2
      ↓
스킬 + 대상 선택
      ↓
내비게이션 / 집기 / 놓기 / 서랍 열기 / 서랍에서 집기
      ↓
인식 + 모션 플래닝 + 저수준 제어
      ↓
실행 결과
      ↓
결과를 GPT Astra로 반환
      ↓
다음 행동 선택
하지만 로봇이 낯선 주방에서 무언가를 가져오려면 스킬 라이브러리 이상의 것이 필요합니다.
주방이 어떻게 생겼는지, 기억된 물체가 어디에 있는지 알아야 합니다.
HomeBody는 3단계로 이러한 맥락을 구축합니다.
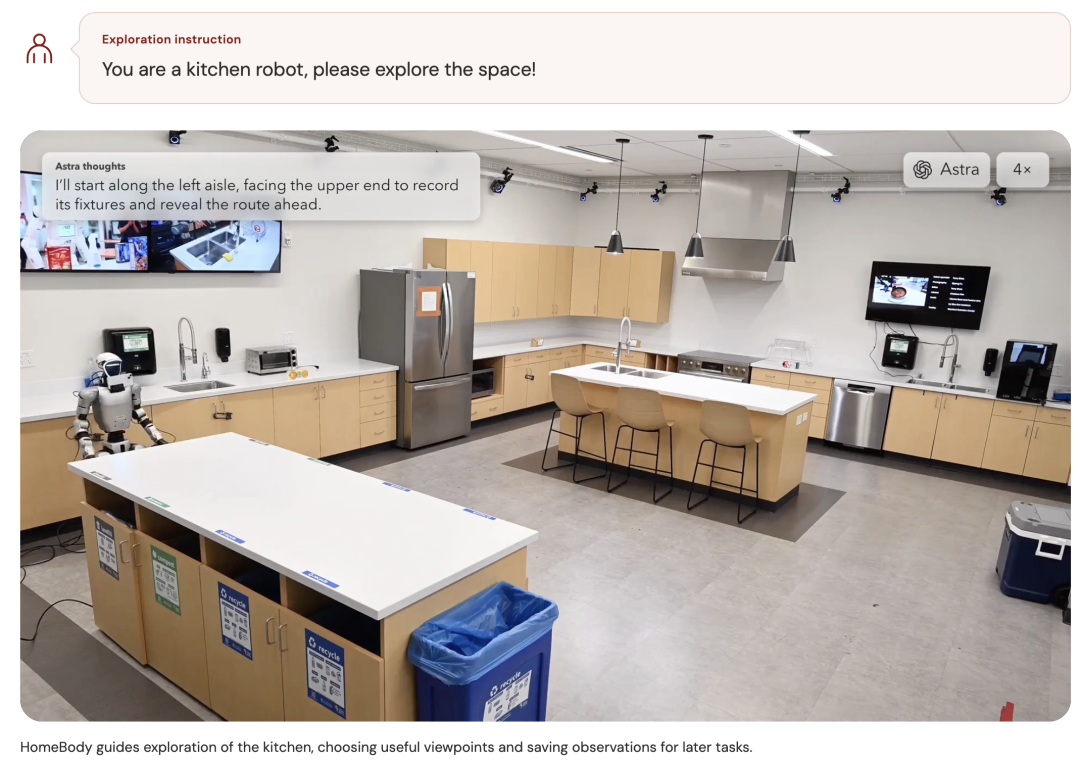
첫 번째 지시는 의도적으로 단순합니다.
당신은 주방 로봇입니다. 공간을 탐색해 주세요!
그런 다음 GPT Astra는 유용한 시점을 선택하고 G1을 방 안으로 이동시킵니다.
탐색 중 HomeBody는 다음과 같은 여러 형태의 데이터를 수집합니다.
카메라는 방 안의 내용을 보여줍니다.
LiDAR와 기타 센서는 측정된 공간 구조를 제공합니다.
SLAM(동시적 위치 추정 및 지도 작성)은 로봇이 지도 안에서 자신의 위치를 추정하면서 지도를 구축하도록 돕습니다.
핵심은 지속성입니다.
G1이 물체에서 고개를 돌렸다고 해서 카메라 화면과 함께 정보가 사라지지 않습니다.
HomeBody는 관찰 정보와 해당 위치를 연결해 저장하므로 이후 작업에서 이를 검색할 수 있습니다.
이것이 “약을 가져다줘”라는 요청이 약이 현재 서랍 안에 숨겨져 있거나 로봇의 시야 밖에 있어도 작동할 수 있는 이유입니다.
탐색만으로는 충분하지 않습니다.
다음으로 HomeBody는 GPT Astra를 Real2Sim 에이전트로 사용해 NVIDIA Isaac Sim 안에 환경을 디지털 형태로 재구성합니다.
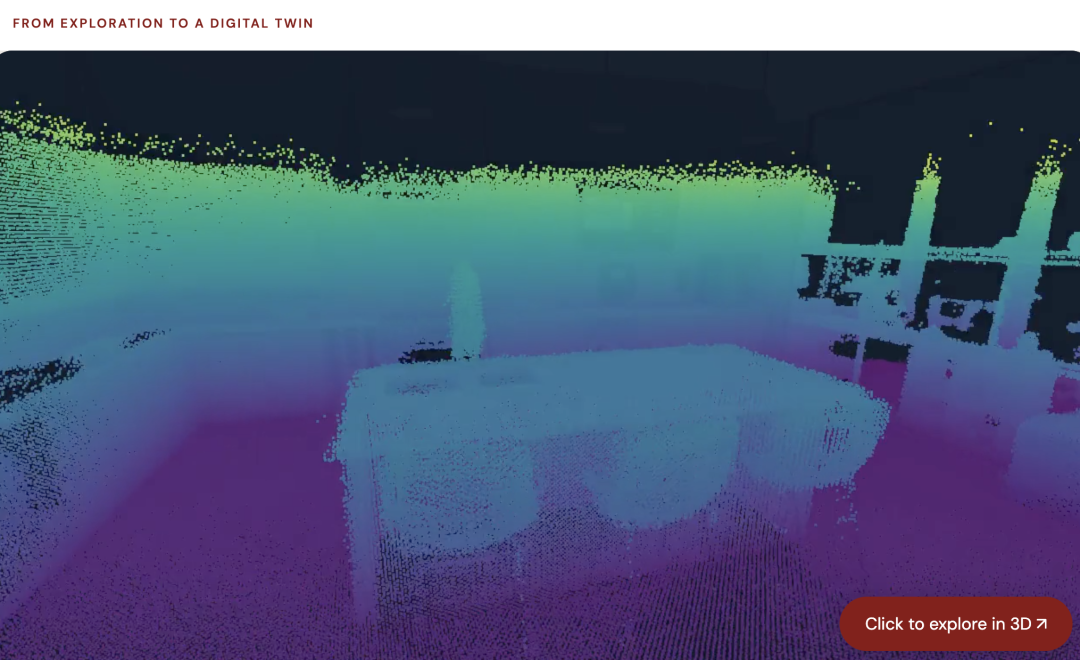
디지털 트윈은 주방의 공간 모델 역할을 합니다.
시스템에는 다음과 같은 구조화된 표현이 제공됩니다.
중요한 점은 재구성이 외관만을 기반으로 하지 않는다는 것입니다.
HomeBody는 측정된 SLAM 기하 정보도 Real2Sim 프로세스에 입력합니다.
이를 통해 재구성 결과에 실제 환경의 치수 제약이 반영됩니다.
이는 시각적으로 매력적인 재구성만으로는 로보틱스에 충분하지 않기 때문에 중요합니다.
로봇은 통로가 실제로 지나갈 만큼 넓은지, 몸체를 서랍에 충분히 가까이 세울 수 있는지, 환경과 충돌하지 않고 팔이 대상에 도달할 수 있는지를 알아야 합니다.
그런 다음 시스템은 실제 SLAM 지도와 재구성된 시뮬레이션을 하나의 공유 좌표계로 정렬합니다.
저장된 카메라 관찰, 의미론적 설명 및 로봇 위치를 방 안의 물리적 장소와 연결할 수 있습니다.
따라서 단순히 다음과 같이 기억하는 대신:
약병을 봤다.
HomeBody는 다음에 가까운 형태로 보존할 수 있습니다.
이 서랍 안에서 약을 봤다.
기억된 이 위치에 있으며,
공유된 방 좌표계 안에 있다.
이것이 이후 회수를 가능하게 합니다.
탐색과 재구성이 끝나면 사용자는 일상적인 작업을 지시할 수 있습니다.
예를 들면 다음과 같습니다.
주방을 정리해 줘.
커피 봉지는 아일랜드에 놓고
상한 우유팩은 버려 줘.
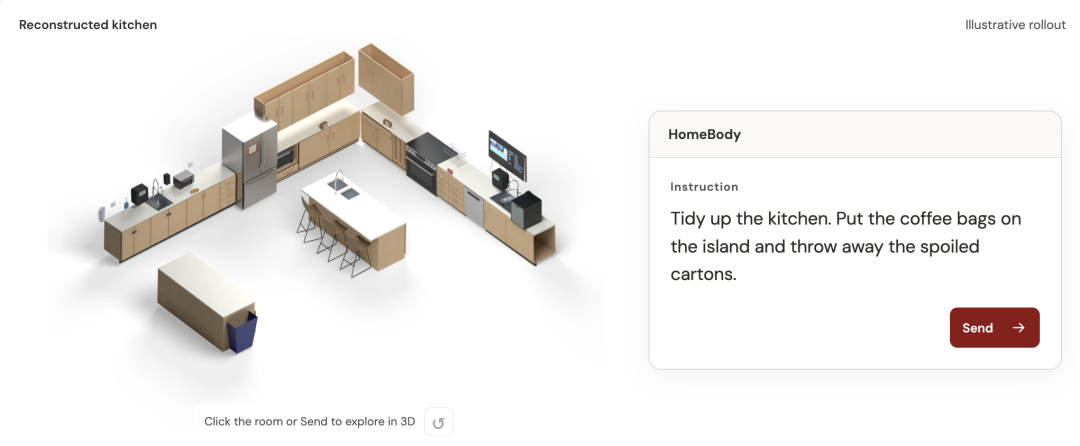
각 단계에서 GPT Astra는 다음 정보를 고려할 수 있습니다.
그런 다음 다음에 실행할 스킬과 대상을 선택합니다.
약 시연은 이러한 방식이 유용한 이유를 보여줍니다.
사용자는 서랍을 지정하지 않습니다.
모델은 이전 관찰 정보를 기억하고 올바른 영역으로 다시 이동한 뒤 서랍을 열고 약병을 꺼내 사람에게 건넬 수 있습니다. 이후 남은 정리 지시도 계속 수행합니다.
작업이 충분히 길기 때문에 어떤 단일 카메라 프레임에도 작업을 완료하는 데 필요한 모든 정보가 담겨 있지 않습니다.
바로 이 지점에서 지속적인 공간 기억이 중요해집니다.
이것은 HomeBody에서 가장 중요한 아키텍처 세부 사항입니다.
“GPT가 휴머노이드 로봇을 제어한다”는 말을 들으면 언어 모델이 모든 관절 각도를 직접 출력한다고 생각하기 쉽습니다.
하지만 시스템은 그렇게 작동하지 않습니다.
RoboCurve와 같은 초기 연구는 카메라 이미지와 로봇 상태를 관찰한 뒤 그리퍼 위치, 방향 및 열림/닫힘 상태를 지정하는 도구를 사용해 프런티어 모델이 로봇 팔 작업을 제어하는 방식을 보여주었습니다.
HomeBody는 더 높은 추상화 수준에서 작동합니다.
이 프로젝트는 일반적인 휴머노이드 스택을 3가지 개념적 수준으로 설명합니다.
일반적인 학습 기반 행동 아키텍처는 다음과 같습니다.
System 2 VLM
     ↓
System 1 VLA
     ↓
System 0 전신 컨트롤러
HomeBody는 이 파이프라인의 중간 부분을 변경합니다.
학습된 VLA가 고수준 의도를 행동으로 변환하도록 요구하는 대신, VLM이 직접 조합 가능한 스킬 라이브러리를 호출합니다.
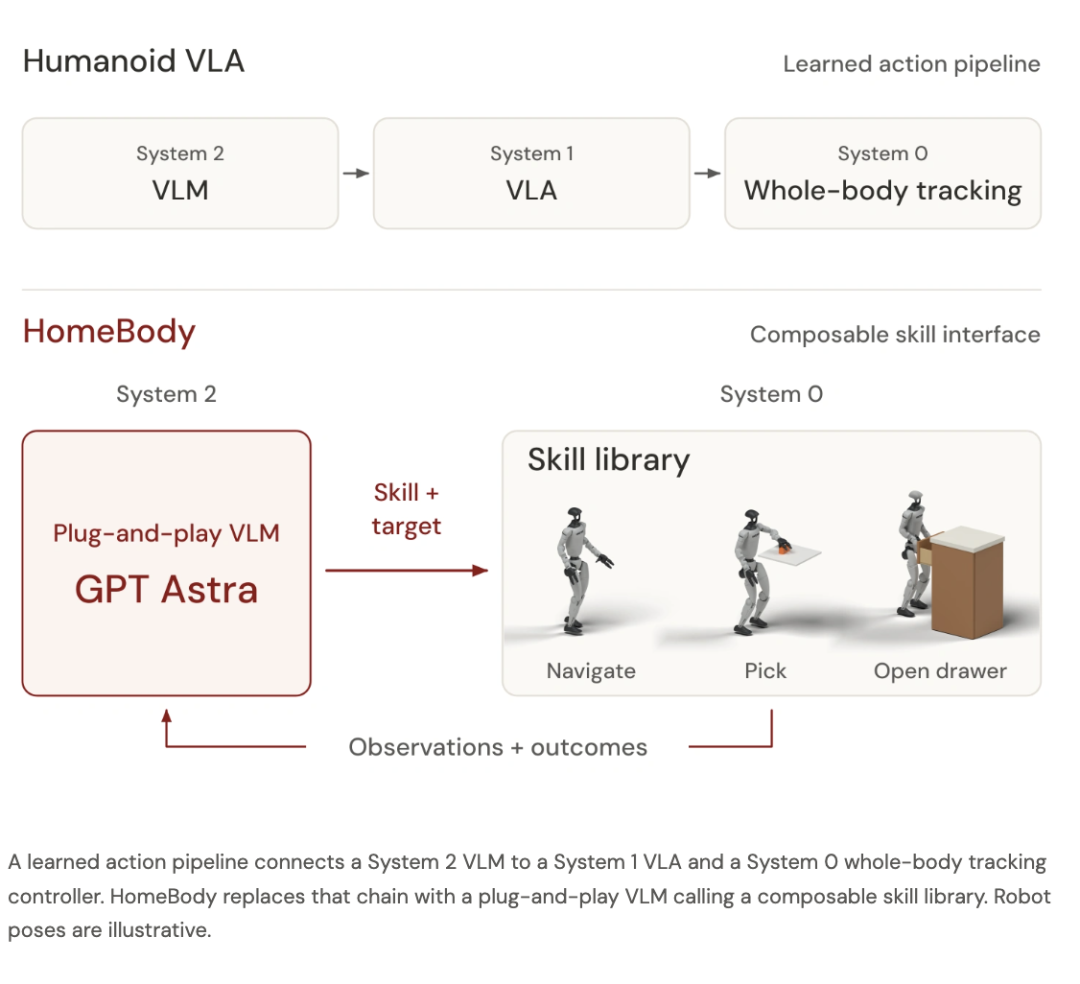
그 결과 구조는 다음에 가까워집니다.
System 2 VLM
     ↓
스킬 라이브러리
     ↓
모션 플래닝 + 인식
     ↓
System 0 전신 제어
HomeBody의 현재 스킬 구성은 다음과 같습니다.
| 스킬 | 고수준 모델이 제공하는 정보 | 스킬이 처리하는 내용 |
|---|---|---|
| 내비게이션 | 대상 위치와 방향 | 경로 계획 및 이동 실행 |
| 집기 | 이미지 지점과 사용할 손 | 분할, 깊이, 파지 자세, 팔 궤적, 재시도 |
| 놓기 | 손과 3D 릴리스 대상 | 들고 있는 물체를 대상으로 이동하고 놓기 |
| 서랍 열기 | 서랍/손잡이 대상 | 정렬, 걸기 자세, 뒤로 당기는 순서 |
| 서랍에서 집기 | 열린 서랍 안의 물체 대상 | 뻗기, 잡기, 들어 올리기 및 국소 재시도 로직 |
모든 스킬은 대상과 실행 결과를 위한 공통 인터페이스를 공유합니다.
모델은 각 스킬의 내부 저수준 구현을 이해할 필요가 없습니다.
어떤 스킬을 실행할지, 대상이 무엇인지 결정하면 됩니다.
집기 동작에서 GPT Astra는 1인칭 카메라 이미지 안의 한 지점을 선택하고 사용할 손을 결정합니다.
그다음 스킬 스택이 작업을 이어받습니다.
HomeBody 구현에 따르면 과정은 다음과 같습니다.
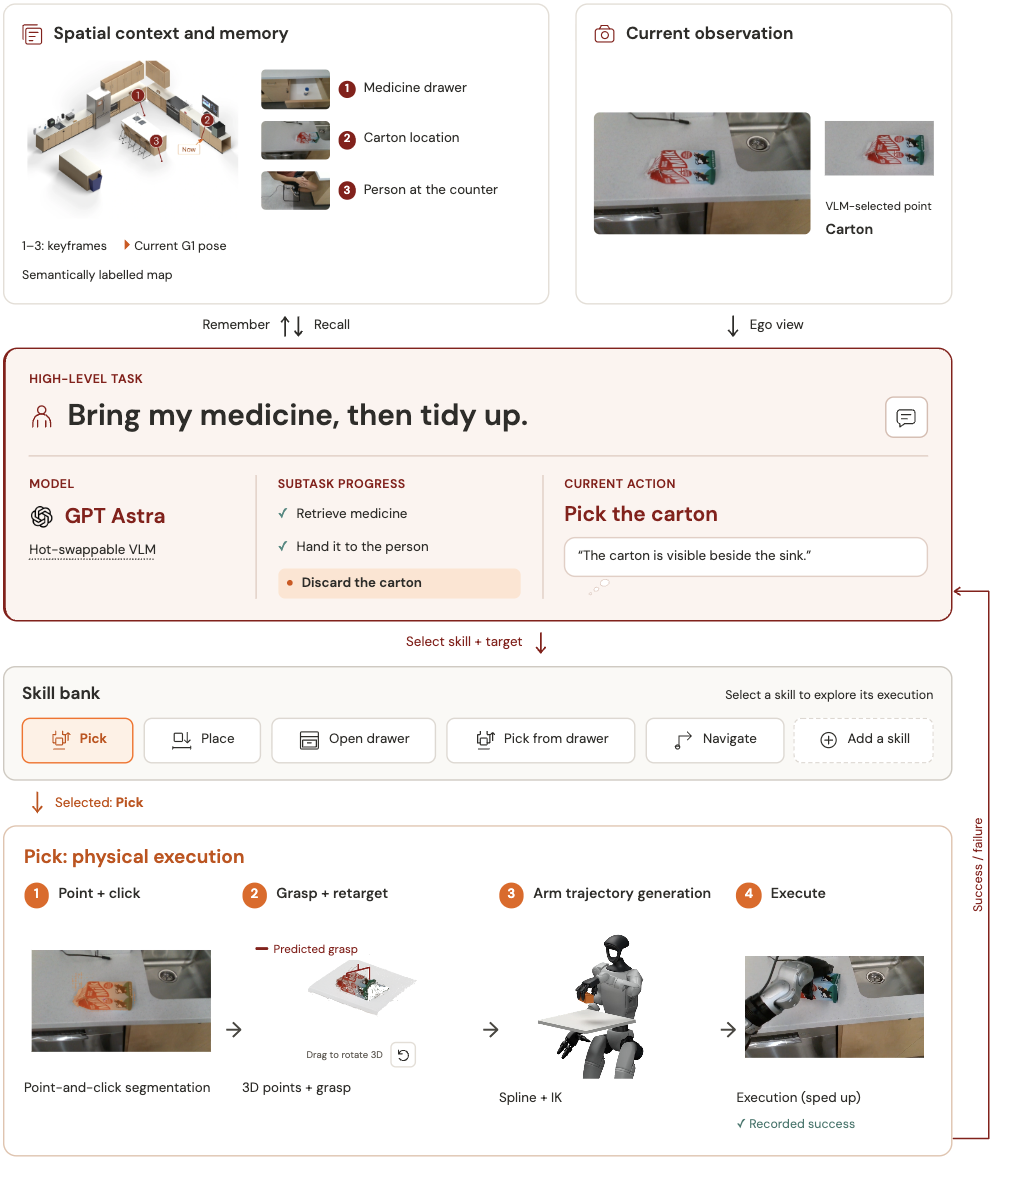
다시 말해:
GPT는 무엇을 집을지
어느 손을 사용할지 결정합니다.

로봇 스킬은 손이 물리적으로
어떻게 그곳에 도달할지 결정합니다.
이러한 분리는 프런티어 모델이 실시간 모터 제어를 담당하지 않고 추론과 작업 순서 결정에 집중하도록 합니다.
물리적 세계에는 잡음이 많습니다.
로봇이 물체에 접근할 때 카메라 이미지 안에서 물체가 이동할 수 있습니다.
파지 동작이 접촉 없이 끝날 수도 있습니다.
로봇은 자세를 조정해야 할 수도 있습니다.
따라서 HomeBody는 모든 작은 수정마다 새로운 GPT 결정을 요구하지 않습니다.
프로젝트는 프레임 사이에서 대상을 추적하기 위해 분할 및 SAM 2.1 추적과 SAMURAI 방식의 메모리 선택을 사용합니다.
그런 다음 시각적 서보잉이 정렬을 국소적으로 보정할 수 있습니다.
파지에 실패하면 스킬이 다른 파지 후보를 시도하거나 위치를 조정하고 다시 계획할 수 있습니다.
이러한 국소 재시도에는 한도가 있습니다.
국소 스킬이 더 이상 복구할 수 없으면 실패 이유를 GPT Astra로 반환합니다.
그러면 VLM은 다른 대상을 선택하거나 로봇의 위치를 조정하거나 고수준 계획을 변경할 수 있습니다.
루프는 다음과 같습니다.
결정
  ↓
스킬 실행
  ↓
결과 관찰
  ↓
가능하면 국소 재시도
  ↓
결과를 GPT Astra로 반환
  ↓
필요할 경우 재계획
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
이를 통해 다음과 같이 여러 스킬을 긴 순서로 연결할 수 있습니다.
서랍으로 이동
→ 서랍 열기
→ 약 집기
→ 사람에게 이동
→ 약 건네기
→ 우유팩 찾기
→ 우유팩 버리기
고수준 플래너가 올바른 스킬을 선택하더라도 휴머노이드는 걷고 뻗는 동안 균형을 유지해야 합니다.
HomeBody는 상체를 고려한 하체 제어를 위해 사전 학습된 **AMO(Adaptive Motion Optimization)**를 사용합니다.
이 컨트롤러는 이동을 조정하면서 상체 목표를 반영합니다.
프로젝트 페이지에 따르면 팔과 손 명령은 250Hz로 실행되며, AMO 정책은 다섯 번의 제어 틱마다 한 번씩, 즉 50Hz로 업데이트됩니다.
이는 “추가 학습 없음”이라는 표현에 맥락이 필요한 또 다른 이유입니다.
새로운 주방에 진입할 때 해당 환경에 특화된 행동 정책을 새로 학습할 필요는 없습니다.
그러나 시스템은 여전히 VLM 아래에서 사전에 학습되고 설계된 구성 요소에 의존합니다.
HomeBody의 가장 강력한 주장 중 하나는 환경에 특화된 학습 데이터를 수집하거나 해당 방을 위한 새로운 행동 정책을 학습하지 않고도 이전에 보지 못한 주방으로 이동할 수 있다는 것입니다.
이는 의미 있는 성과입니다.
전통적인 로봇 배포는 로봇이 안정적으로 행동하기 전에 시연, 정책 학습 또는 환경별 조정을 요구하는 경우가 많습니다.
HomeBody는 대신 다음 요소를 결합합니다.
이를 통해 적응 부담의 일부가 재학습에서 추론 + 매핑 + 재사용 가능한 도구로 이동합니다.
전체 HomeBody 흐름은 다음과 같이 요약할 수 있습니다.
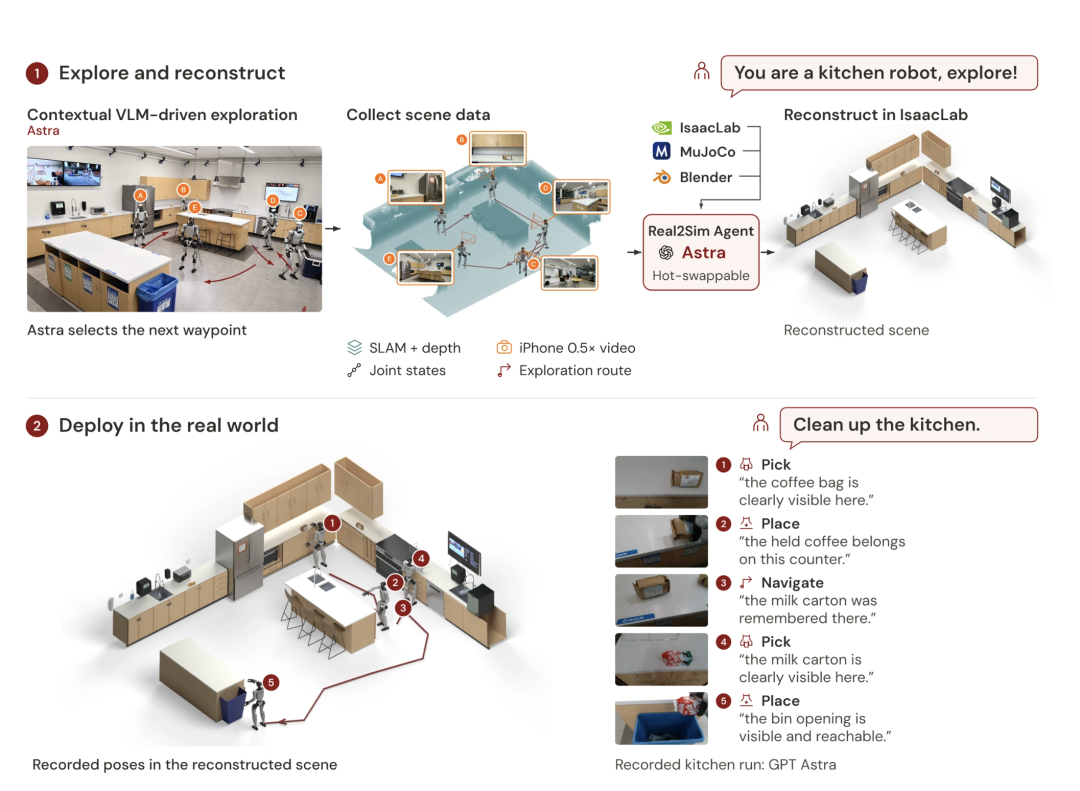
낯선 방 탐색
        ↓
1인칭 관찰 + SLAM + 자세 정보 수집
        ↓
Real2Sim으로 디지털 트윈 구축
        ↓
실제 좌표계와 시뮬레이션 좌표계 정렬
        ↓
공간 관찰 정보 저장
        ↓
일상적인 지시 수신
        ↓
GPT Astra가 스킬 + 대상 선택
        ↓
국소 로보틱스 스택 실행
        ↓
결과 반환
        ↓
작업이 완료될 때까지 계속
연구 데모는 인상적이지만 G1을 구매하고 API 키를 입력하면 가정용 로봇을 얻는 것과는 다릅니다.
현재 HomeBody 스택에는 여전히 상당한 로보틱스 인프라가 필요합니다.
연구진은 인식, 모션 플래닝 및 스킬 실행이 RTX 4090 GPU를 탑재한 Razer Blade 노트북 한 대에서 실행된다고 보고했습니다.
GPT Astra는 원격으로 실행되며 스킬 요청과 대상을 로컬 컴퓨터로 전송합니다.
이는 아키텍처가 두 가지 컴퓨팅 환경으로 나뉜다는 의미입니다.
원격 프런티어 모델
→ 고수준 추론 및 스킬 선택

로컬 RTX 4090 시스템
→ 인식, 기하, 계획, 스킬, 실행
프로젝트는 다음과 같은 실무적 비용과 제약도 제시합니다.
공간 표현을 전체 워크플로에서 사용하려면 먼저 디지털 트윈을 구축해야 합니다.
이로 인해 준비 시간이 추가됩니다.
원격 프런티어 모델은 계획 및 Real2Sim 작업 중 호출됩니다.
이에 따라 API 비용이 발생합니다.
Astra는 즉시 응답하지 않습니다.
연구진은 고수준 추론이 완료되는 동안 스킬 사이에 일시적인 멈춤이 발생한다고 설명합니다.
가정용 작업에서는 물리적 작업 자체가 순수한 디지털 작업보다 훨씬 오래 걸리기 때문에 이러한 지연이 중요합니다.
장시간 지속되는 휴머노이드 조작에는 기계적 한계도 존재합니다.
HomeBody 페이지는 장시간 작동 중 발생하는 손가락 서보 과열을 구체적으로 언급합니다.
로봇은 현재의 손, 도달 범위, 균형, 인식 능력 및 구현된 스킬 세트가 지원하는 작업만 수행할 수 있습니다.
따라서 이 프로젝트는 장기 자율성에 대한 연구 시연이지, 임의의 집안일을 이미 처리할 수 있는 범용 가정용 도우미가 아닙니다.
HomeBody는 프런티어 모델을 물리적 로봇과 연결하는 광범위한 연구 흐름에 속합니다.
원문은 점점 일반화되고 있는 세 가지 접근 방식을 강조합니다.
RoboCurve 방식의 설정에서 모델은 이미지와 로봇 상태를 입력받은 뒤 다음과 같은 대상을 지정하는 도구를 호출합니다.
저수준 역기구학 또는 제어 스택이 이러한 대상을 로봇 움직임으로 변환합니다.
모델은 빈번한 관찰-결정-행동 루프 안에 남아 있습니다.
두 번째 접근 방식은 느린 고수준 추론을 위해 프런티어 언어/비전 모델을 사용하고, 행동 생성을 위해 학습된 VLA를 사용합니다.
개념적으로는 다음과 같습니다.
VLM 플래너
→ VLA 행동 모델
→ 저수준 컨트롤러
이 방식은 프런티어 모델을 모터 계층보다 높은 곳에 두면서도 학습된 정책을 사용해 계획을 물리적 행동으로 변환합니다.
HomeBody는 다른 경로를 선택합니다.
중간에 학습된 VLA가 필요하다는 요구를 제거하고, 프런티어 VLM이 재사용 가능한 스킬을 직접 호출하도록 합니다.
이러한 스킬은 고전적 알고리즘, 학습된 정책 또는 다른 컨트롤러로 구성될 수 있습니다.
HomeBody 프로젝트는 공유 인터페이스를 통해 새로운 스킬을 추가할 수 있도록 명시적으로 허용합니다.
이로써 아키텍처는 모듈식이 됩니다.
VLM을 교체하거나
새로운 스킬을 추가해도
전체 로봇 스택을 다시 설계할 필요가 없습니다.
더 깊은 의미는 단순히 “System 0 계층을 하나 더 추가한다”는 데 있지 않습니다.
이는 추론과 물리적 실행을 연결하는 방식 자체가 다르다는 뜻입니다.
공간 기억과 결합하면 이러한 연결을 통해 로봇은 하나의 탁상 주변이 아니라 방 전체에서 작업할 수 있습니다.
원문은 RoboCurve의 제3자 로봇 제어 평가 결과를 살펴보며 마무리됩니다.
이 결과는 작업별 로보틱스 벤치마크 측정치로 읽어야 하며, 모델의 전반적인 지능에 대한 보편적인 진술로 해석해서는 안 됩니다.
Jay Chooi가 공유한 RoboCurve 결과에 따르면 GPT-6 Sol은 로보틱스 작업 세트에서 GPT-5.6 Sol보다 약 1.6배 높은 점수를 기록했으며, 시험당 비용은 약 47% 낮았습니다.
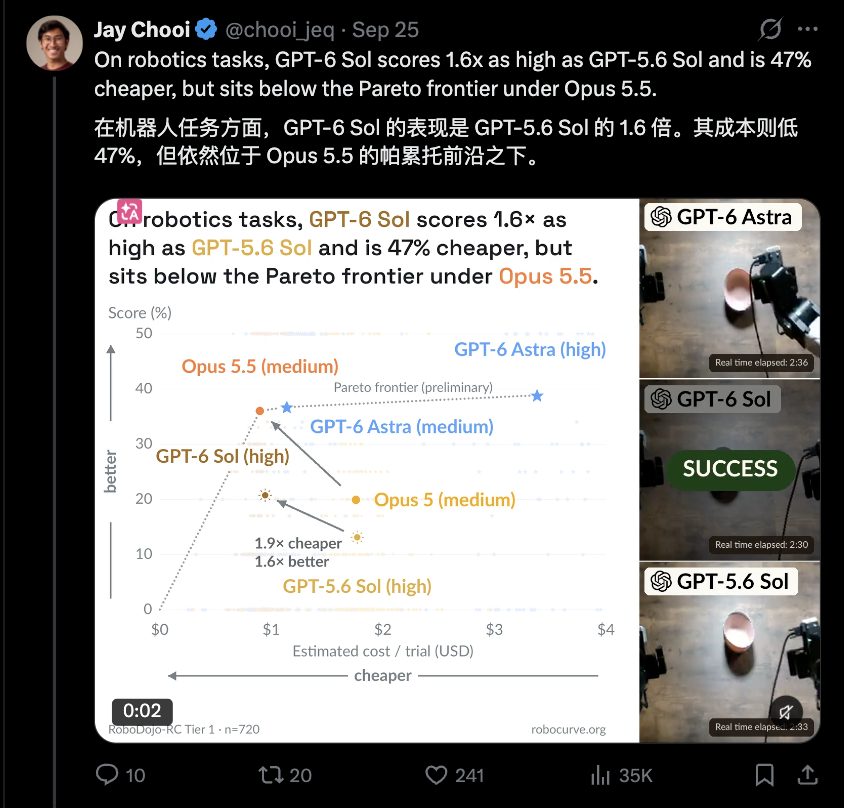
동일한 차트에서 GPT-6 Sol은 해당 평가에서 더 강력한 Opus 5.5 구성으로 형성된 예비 파레토 프런티어보다 낮은 위치에 있었습니다.
이는 비용과 로봇 제어 성능이 항상 같은 방향으로 움직이지는 않는다는 유용한 근거입니다.
다른 모델이 여전히 더 높은 점수를 기록하더라도 더 저렴한 모델이 운영 측면에서 더 나은 선택일 수 있습니다.
또 다른 RoboCurve 결과는 360회의 로보틱스 시험을 다뤘습니다.
보고된 평균에 따르면 Opus 5.5는 Opus 5보다 약 1.8배 높은 점수를 기록했으며, 비용은 대략 절반이었습니다. 또한 Astra와 비슷한 평균 점수를 기록하면서 비용은 약 21% 낮았습니다.
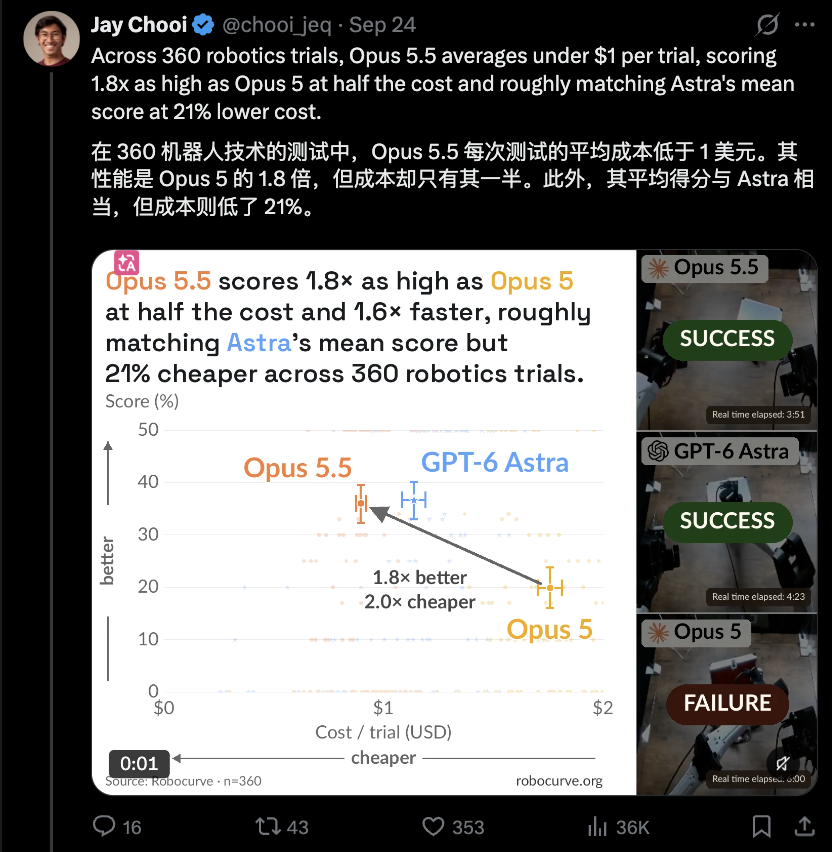
다시 말해 이는 Anthropic 또는 OpenAI의 일반 벤치마크가 아닙니다.
특정 작업, 하드웨어, 프롬프트 및 시험 조건을 대상으로 한 제3자 로봇 제어 평가입니다.
이 구분은 중요합니다. 체화된 AI의 성능은 전체 시스템에 좌우되기 때문입니다.
모델
×
프롬프트 작성
×
로봇 하드웨어
×
인식
×
제어 스택
×
스킬 설계
×
작업 정의
코딩 벤치마크에서 가장 좋은 성능을 낸 모델이 로봇을 제어할 때 최고의 비용 대비 성능을 보이는 모델이라는 보장은 없습니다.
HomeBody에서 가장 흥미로운 부분은 휴머노이드가 커피 봉지를 옮겼다는 사실이 아닙니다.
로봇은 수년 동안 물체를 조작해 왔습니다.
중요한 변화는 아키텍처에 있습니다.
HomeBody는 다음 요소를 결합하는 실용적인 방법을 보여줍니다.
프런티어 모델은 모든 모터 세부 사항을 학습할 필요가 없습니다.
로봇도 각 주방에 맞춰 새로운 엔드투엔드 정책을 학습할 필요가 없습니다.
대신 범용 모델이 구조화된 환경을 추론하고 재사용 가능한 기능을 조정합니다.
이는 소프트웨어 에이전트가 점점 더 작동하는 방식과 유사합니다.
모델이 추론
→ 도구 호출
→ 결과 읽기
→ 다음 도구 선택
HomeBody는 동일한 패턴을 물리적 세계로 가져옵니다.
도구는 더 이상 웹 검색, Python 또는 데이터베이스가 아닙니다.
다음과 같은 기능입니다.
내비게이션
집기
놓기
서랍 열기
서랍에서 집기
이것이 이 프로젝트가 체화된 에이전트에 중요한 단계처럼 느껴지는 이유입니다.
HomeBody는 휴머노이드 로봇에 지속적인 공간 기억과 조합 가능한 모터 스킬 라이브러리를 제공하는 Stanford와 Caltech의 연구 시스템입니다. 프런티어 비전-언어 모델이 장기 작업을 계획하고 구조화된 도구 인터페이스를 통해 해당 스킬을 호출합니다.
아닙니다. HomeBody 프로젝트 페이지는 플래너를 GPT Astra로 명시하며, GPT Astra를 고수준 System 2 모델로 사용합니다. 내비게이션, 조작, 인식, 모션 플래닝, 재시도 및 전신 제어는 하위 로보틱스 모듈과 사전 학습된 컨트롤러가 처리합니다.
연구진은 시연된 낯선 주방에서 환경별 학습 데이터나 추가적인 정책 학습이 필요하지 않다고 설명합니다. 그러나 시스템은 사전 학습된 인식 모델, 재사용 가능한 스킬, SLAM, 계획 소프트웨어 및 사전 학습된 AMO 전신 컨트롤러에 여전히 의존합니다.
탐색 중 HomeBody는 1인칭 카메라 관찰 정보를 의미론적 내용 및 공유된 공간 좌표계상의 위치와 함께 저장합니다. 이후 보이지 않는 물체에 대한 요청이 들어오면 GPT Astra는 저장된 키프레임을 회상하고 기억된 위치로 다시 이동할 수 있습니다.
Real2Sim 단계는 고수준 플래너에 방의 구조화된 공간 모델을 제공합니다. HomeBody는 측정된 SLAM 기하 정보로 재구성 결과를 보정하므로 내비게이션 및 조작 결정이 단순한 시각적 외관이 아니라 실제 치수에 기반하도록 합니다.
프로젝트에 따르면 로컬 스킬, 인식 및 모션 플래닝은 RTX 4090 GPU가 탑재된 Razer Blade 노트북에서 실행되고 GPT Astra는 원격으로 실행됩니다. 현재 설정에는 휴머노이드 하드웨어, 카메라, LiDAR/SLAM 구성 요소, 네트워킹 및 프로젝트의 로보틱스 소프트웨어 스택도 필요합니다.
아닙니다. 이 프로젝트는 의미 있는 장기 자율성을 보여주지만, 자체적으로 Real2Sim 설정 시간, API 비용, 추론 지연, 조작 한계 및 손가락 서보 과열과 같은 하드웨어 내구성 문제를 한계로 제시합니다.
아닙니다. 원문에서 논의된 수치는 독립적인 제3자 평가 기관인 RoboCurve에서 나온 것이며, 해당 기관의 로보틱스 작업 세트와 시험 조건에 적용됩니다. 이러한 수치를 전체 모델 순위로 일반화해서는 안 됩니다.
HomeBody는 프런티어 모델이 모든 저수준 모터 명령을 직접 생성하지 않고도 휴머노이드의 고수준 플래너가 될 수 있음을 보여줍니다. GPT Astra는 낯선 방을 탐색하고 Real2Sim 재구성과 지속적인 공간 기억을 사용한 다음, 내비게이션 및 조작 스킬을 조합해 장기 주방 작업을 완료합니다.
핵심 설계 선택은 모듈성입니다. 모델은 다음에 무엇을 해야 하는지 결정하고, 인식, 기하, 모션 플래닝, 국소 재시도 및 전신 제어는 로봇이 물리적으로 어떻게 수행할지를 결정합니다. 이를 통해 시스템은 새로운 환경에 특화된 행동 정책을 새로 학습하지 않고도 새로운 주방에 진입할 수 있지만, 상당한 사전 학습 및 설계 기반 로보틱스 인프라에는 여전히 의존합니다.
현재 구현은 플러그 앤 플레이 가정용 로봇이라기보다 연구 시스템에 가깝습니다. RTX 4090급 로컬 컴퓨터, 원격 모델 추론, 시뮬레이션 설정, API 액세스 및 견고한 로봇 하드웨어가 필요합니다. 연구진은 장시간 실제 작업에서 여전히 중요한 지연 및 내구성 한계도 문서화했습니다.
중요한 단계는 단순히 “GPT가 로봇을 제어할 수 있다”는 것이 아니라, 범용 모델이 소프트웨어 에이전트가 도구를 사용하는 것과 유사하게 공간 기억과 재사용 가능한 물리적 스킬을 사용할 수 있게 되었다는 점입니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.



