For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/h-jepa-explained-hierarchical-jepa-world-f7e48311.md.
Yann LeCun의 월드 모델 스타트업인 **Advanced Machine Intelligence(AMI)**가 첫 번째 주요 연구 성과 중 하나를 공개했습니다.
Yann LeCun의 월드 모델 스타트업인 **Advanced Machine Intelligence(AMI)**가 첫 번째 주요 연구 성과 중 하나를 공개했습니다.
H-JEPA: 시각적 계획을 위한 계층적 월드 모델의 엔드투엔드 학습이라는 논문에서 AMI, New York University, INRIA Paris, Brown University의 연구진은 여러 개의 행동 조건부 JEPA로 구성된 계층적 월드 모델을 소개합니다.
핵심 아이디어는 간단합니다. 즉각적인 모터 제어와 장기 계획을 하나의 잠재 표현으로 처리하도록 강제하는 대신, H-JEPA는 계층의 각 수준에 서로 다른 시간 범위와 표현 공간을 부여합니다.
상위 수준은 미래를 더 멀리 내다보며 더 거친 수준에서 계획을 수립합니다. 상위 수준이 예측한 중간 상태는 하위 수준의 서브골이 되고, 하위 수준은 이를 점진적으로 구체화해 실행 가능한 행동으로 변환합니다.
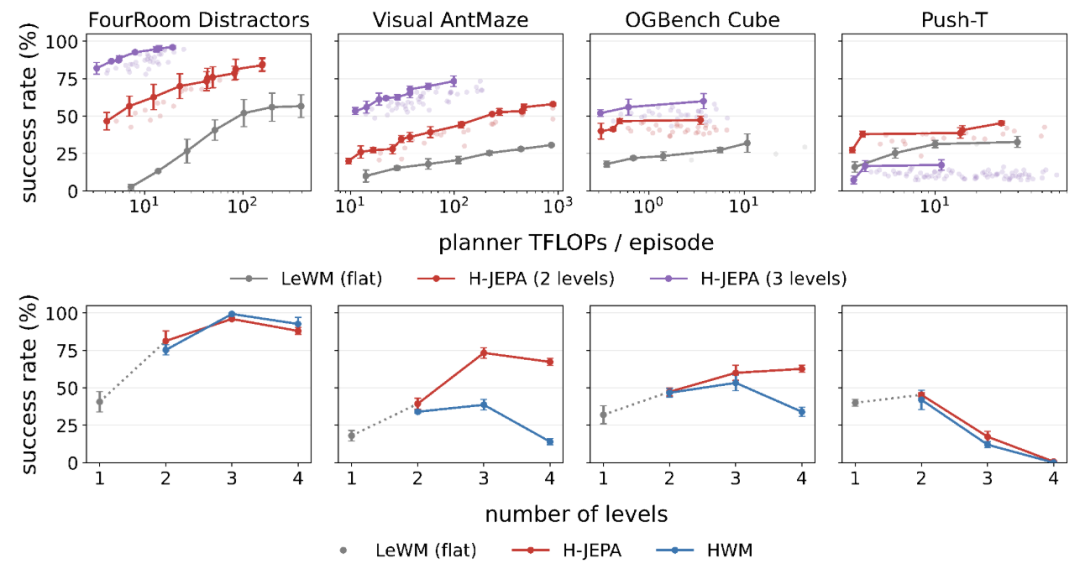
Visual AntMaze에서 3단계 H-JEPA는 약 73.3%의 계획 성공률을 달성했습니다. 이는 플랫 LeWorldModel 기준선의 **18.0%**와 비교되는 수치이며, 성공률과 연산량의 균형 측면에서도 더 나은 성능 곡선을 보였습니다.
이 프로젝트는 AMI가 출범 이후 강조해 온 오픈 리서치 방향을 따릅니다. 저자들은 학습 및 평가 코드, 사전 학습된 체크포인트, 관련 데이터셋을 공개했습니다.
공식 GitHub 저장소는 MIT 라이선스로 배포됩니다. Hugging Face에 공개된 H-JEPA 체크포인트 저장소 역시 MIT 라이선스로 표시되어 있으며, 함께 제공되는 데이터셋 저장소는 CC BY 4.0으로 배포됩니다.
LeCun은 수년간 계층적 계획의 필요성을 주장해 왔습니다.
기본적인 직관은 사람들이 복잡한 현실의 과제를 계획하는 방식과 유사합니다.
New York University의 사무실에 앉아 파리로 이동하기로 결정하는 상황을 생각해 보겠습니다.
가장 높은 수준에서 중요한 정보는 목적지, 항공편, 일정입니다. 이 결정이 내려지면 다음 수준에서는 계획이 더 구체화됩니다. 사무실을 나서고, 아래층으로 내려가고, 공항에 도착한 뒤, 비행기에 탑승하는 식입니다.
가장 낮은 수준에서는 다시 주의의 초점이 바뀝니다. 계단을 내려가려면 바닥, 다음 계단, 신체 움직임에 관한 정보가 필요합니다. 대서양 횡단 항공편을 선택할 때는 중요하지 않았던 세부 정보가 갑자기 핵심이 됩니다.
로보틱스에서도 같은 문제가 나타납니다.
고수준 계획기는 과제의 목표, 공간적 관계, 장기적인 이동 방향을 이해해야 합니다. 저수준 제어기는 즉각적인 움직임과 신체 구성에 관한 정밀한 정보가 필요합니다.
하나의 표현이 모든 시간 범위에서 모든 세부 정보를 보존해야 한다면 계획은 불필요하게 어려워집니다.
예를 들어 사족보행 로봇이 이미 올바른 위치에 있지만 다리 자세가 목표 이미지와 다를 수 있습니다. 빠르게 변하는 다리 세부 정보에 지나치게 큰 비중을 두는 표현은 과제와 관련된 위치가 이미 올바른데도 로봇이 목표에서 멀리 떨어져 있다고 잘못 판단할 수 있습니다.
H-JEPA 논문은 다음과 같이 더 구체적인 질문을 던져 이 문제를 다룹니다.
각 수준이 자신의 시간 범위에서 중요한 정보를 학습하면서도, 고수준 계획을 저수준 행동으로 변환할 수 있게 할 수 있는가?
H-JEPA는 계층의 각 수준에 세 가지 주요 구성 요소를 부여합니다.
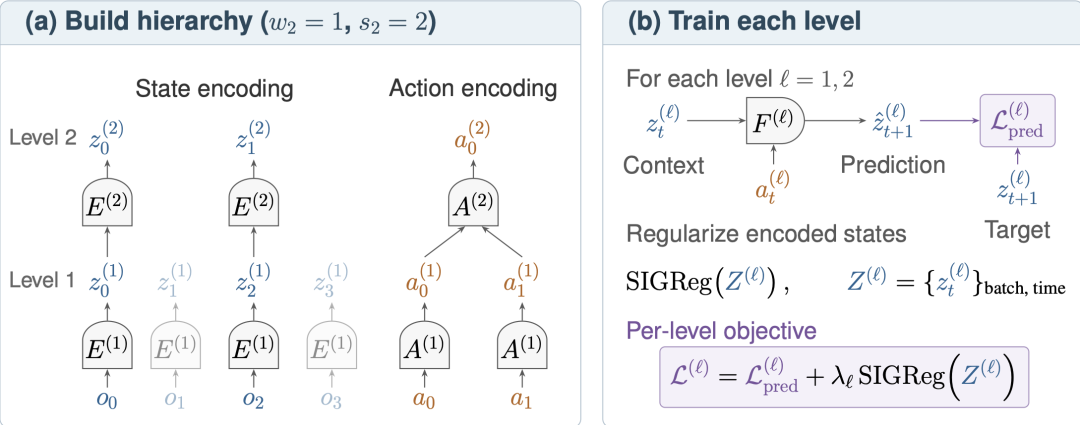
상태 인코더는 환경의 잠재 표현을 추출합니다.
가장 낮은 수준에서 인코더는 시각적 관측을 직접 처리합니다. 상위 수준은 하위 수준의 표현을 입력으로 받아 상태를 점진적으로 더 추상적인 형태로 학습합니다.
이를 통해 상위 수준은 빠르게 변하거나 장기 범위에서 예측하기 어렵거나 장기 계획과 관련이 적은 세부 정보를 제거할 수 있습니다.
Visual AntMaze 실험에서 상위 수준은 개미의 다리 자세에 관한 정보를 점점 더 억제하면서 개미의 위치와 미로의 배치에 관한 정보는 유지합니다.
이는 계층이 학습하도록 설계된 바로 그러한 종류의 추상화입니다.
행동 인코더는 각 시간 범위에서 행동이 미치는 영향을 설명합니다.
가장 낮은 수준에서 행동은 비교적 구체적인 제어 변화에 해당합니다. 상위 수준에서는 여러 개의 하위 수준 행동이 더 긴 기간에 걸쳐 상태가 어떻게 변하는지를 나타내는 더 거친 표현으로 압축됩니다.
이렇게 각 계층은 서로 다른 시간 해상도를 갖게 됩니다.
보고된 설정에서 상위 수준의 예측 한 단계는 그보다 낮은 수준보다 더 많은 환경 스텝에 걸쳐 있습니다.
예측기는 현재의 잠재 상태와 인코딩된 행동을 결합해 미래의 잠재 상태를 추정합니다.
따라서 각 수준은 자체적인 행동 조건부 월드 모델을 학습합니다.
플랫 월드 모델과의 핵심적인 차이는 H-JEPA가 모든 수준에 하나의 공유 잠재 공간 안에서 예측하도록 요구하지 않는다는 점입니다.
대신 각 수준은 자신의 계획 범위에 적합한 표현을 개발할 수 있습니다.
추론 시점의 계획은 계층의 상위 수준에서 하위 수준으로 진행됩니다.
최상위 수준은 먼저 최종 목표를 향한 거친 경로를 탐색합니다.
최상위 수준이 예측한 중간 상태는 그 아래 수준의 서브골이 됩니다. 하위 수준은 할당된 서브골에 도달하기 위한 더 세밀한 계획을 탐색하며, 이 과정은 최하위 수준이 원시 행동을 생성할 때까지 계속됩니다.
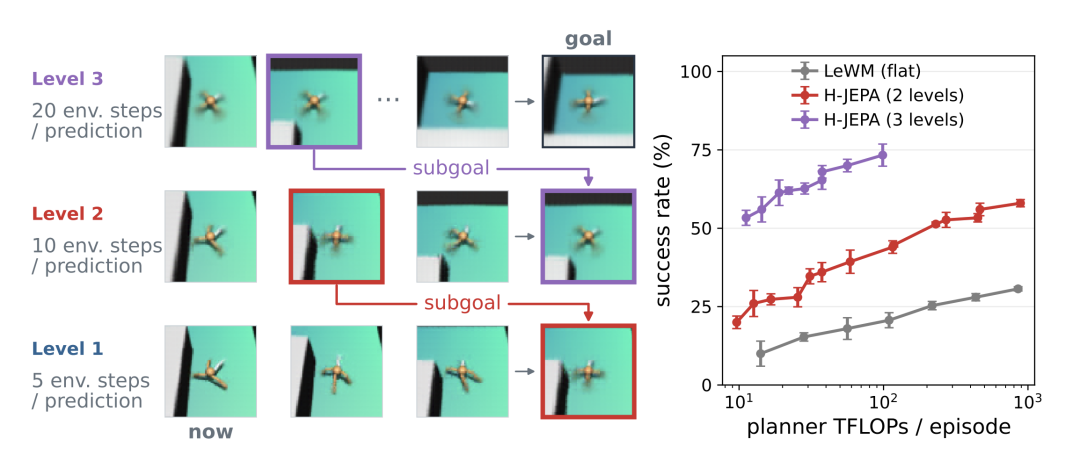
이 과정은 거친 수준에서 세밀한 수준으로 진행되는 계획을 만듭니다.
행동의 일부를 실행한 뒤 시스템은 새로운 상태를 관측하고 다시 계획을 수립합니다.
이러한 반복적 재계획을 통해 계층은 하나의 긴 오픈 루프 계획에 고정되지 않고 실제 환경에 대응할 수 있습니다.
이 계층은 엔드투엔드 방식으로 학습됩니다.
이는 각 수준이 독립적인 모듈로 학습되지 않는다는 뜻입니다. 상위 수준의 목표가 하위 수준 인코더에 영향을 줄 수 있으므로 전체 표현 계층이 공동으로 발전할 수 있습니다.
그러나 월드 모델 학습에는 표현 붕괴라는 고전적인 실패 모드가 있습니다.
인코더가 모든 입력 상태를 동일한 잠재 벡터로 매핑하면, 예측기는 아무것도 유용하게 학습하지 않고도 같은 벡터를 출력해 낮은 예측 오류를 쉽게 달성할 수 있습니다.
H-JEPA는 Randall Balestriero와 Yann LeCun이 이전 LeJEPA 연구에서 소개한 SIGReg, 즉 Sketched Isotropic Gaussian Regularization을 사용해 이 문제를 해결합니다.
SIGReg는 잠재 분포를 제약해 서로 다른 관측이 동일한 표현으로 붕괴하지 않도록 합니다.
이전의 LeWorldModel은 픽셀에서 엔드투엔드 월드 모델을 학습할 때 이러한 방식의 정규화를 적용했습니다. H-JEPA는 LeWorldModel을 최하위 수준의 기반으로 사용한 뒤 그 위에 추가적인 JEPA 수준을 더합니다.
이를 통해 기본적인 JEPA 원칙이 유지됩니다. 즉, 미래의 모든 픽셀을 재구성하는 대신 미래의 유용한 표현을 예측합니다.
논문은 다음 네 가지 시뮬레이션 내비게이션 및 조작 환경에서 H-JEPA를 평가합니다.
또한 DROID 데이터셋의 실제 로봇 궤적을 활용해 오프라인 계획도 평가합니다.
Visual AntMaze는 계층적 접근의 장점을 가장 명확하게 보여줍니다.
공식 저장소에 따르면 3단계 H-JEPA는 73.3%의 계획 성공률을 기록했으며, 플랫 LeWorldModel 기준선은 **18.0%**였습니다.
계층 구조는 성공률과 계획기 연산량 사이의 균형도 개선합니다.
이는 계층적 계획기가 유용하려면 추가된 수준이 계획을 감당하기 어려울 정도로 비싸게 만들지 않아야 한다는 점에서 중요합니다.
계층 구조는 다른 시뮬레이션 환경에서도 플랫 기준선보다 성능을 개선하지만, 계층이 깊을수록 항상 좋은 것은 아닙니다.
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
원문은 Push-T를 중요한 반례로 제시합니다. 2단계 모델은 플랫 기준선보다 성능이 좋지만, 세 번째 또는 네 번째 수준을 추가하면 성능이 낮아질 수 있습니다.
논문은 그 원인 중 하나로 과제의 길이를 제시합니다. 더 짧은 궤적에서는 긴 시간 범위에서 작동하는 매우 높은 수준에 의미 있는 샘플이 충분히 제공되지 않습니다.
이는 중요한 한계를 시사합니다.
계층 구조는 과제에 여러 시간 범위에 걸친 실제 구조가 있을 때 유용합니다. 수준을 기계적으로 추가한다고 해서 성능 향상이 보장되는 것은 아닙니다.
실제 로봇 데이터는 또 다른 표현 문제를 만듭니다.
다양한 영상에서는 순수한 예측 목표가 안정적인 배경 정보에 지나치게 집중할 수 있습니다. 배경은 예측하기 쉽기 때문입니다. 반면 제어에 실제로 중요한 움직이는 로봇에는 표현 용량이 덜 할당될 수 있습니다.
이를 해결하기 위해 연구진은 DROID 실험에 역동역학 감독을 추가합니다.
모델은 미래의 잠재 상태를 예측할 뿐 아니라 연속된 잠재 상태를 연결하는 행동도 추론하도록 학습됩니다.
이렇게 하면 표현이 로봇의 움직임과 제어 가능한 상태에 관한 정보를 보존하도록 유도할 수 있습니다.
H-JEPA 프로젝트 페이지에 따르면 학습된 두 번째 수준은 플랫 기준선보다 오프라인 계획 충실도를 개선하는 동시에 계획기 연산량을 줄입니다.
DROID 평가는 오프라인 방식입니다. 논문은 폐루프 실제 로봇 과제의 성공을 주장하는 대신 예측된 말단장치 경로를 전문가 궤적과 비교합니다.
결과를 해석할 때 이 차이는 중요합니다.
저자들은 H-JEPA 구현을 GitHub에 공개했습니다.
공식 저장소에는 다음 과제를 위한 학습 및 계획 코드가 포함되어 있습니다.
또한 논문의 일부 그림과 표를 재현하기 위한 스크립트도 제공합니다.
Hugging Face 체크포인트 저장소에는 현재 시뮬레이션 과제 전반에 걸쳐 플랫 LeWorldModel, 2단계·3단계·4단계 H-JEPA 변형 모델, 공유 공간 HWM 기준선의 사전 학습 모델과 DROID 체크포인트가 포함되어 있습니다.
함께 제공되는 H-JEPA 데이터셋 저장소에는 시뮬레이션 데이터, 계획 평가 과제, 프로빙 데이터셋, 공개 릴리스에 필요한 DROID 관련 데이터가 포함되어 있습니다.
이로써 이 연구는 논문만으로 끝나는 시연을 넘어섭니다. 연구자들은 구현을 살펴보고, 학습된 모델을 불러오며, 보고된 계획 결과를 재현하려고 시도할 수 있습니다.
H-JEPA는 LeCun이 수년간 추진해 온 더 넓은 연구 방향을 따릅니다.
JEPA는 Joint-Embedding Predictive Architecture의 약자입니다.
일반적인 언어 모델은 미래의 토큰을 예측하면서 학습합니다. 반면 시각적 JEPA는 관측의 표현을 학습하고 잠재 공간에서 목표 표현을 예측합니다.
H-JEPA와 같은 월드 모델에서는 행동이 과정에 추가됩니다. 이를 통해 모델은 행동을 취한 뒤 세계에 대한 내부 표현이 어떻게 변하는지 예측할 수 있습니다.
이후 계획기는 서로 다른 행동의 예측 결과를 비교하고 목표를 향한 경로를 탐색할 수 있습니다.
이는 지능이 언어 생성 이상의 것을 필요로 한다는 LeCun의 오랜 관점을 반영합니다. 그의 연구 방향에서 시스템은 세계를 이해하고, 행동의 결과를 예측하며, 관련 상태를 기억하고, 시간에 걸쳐 계획해야 합니다.
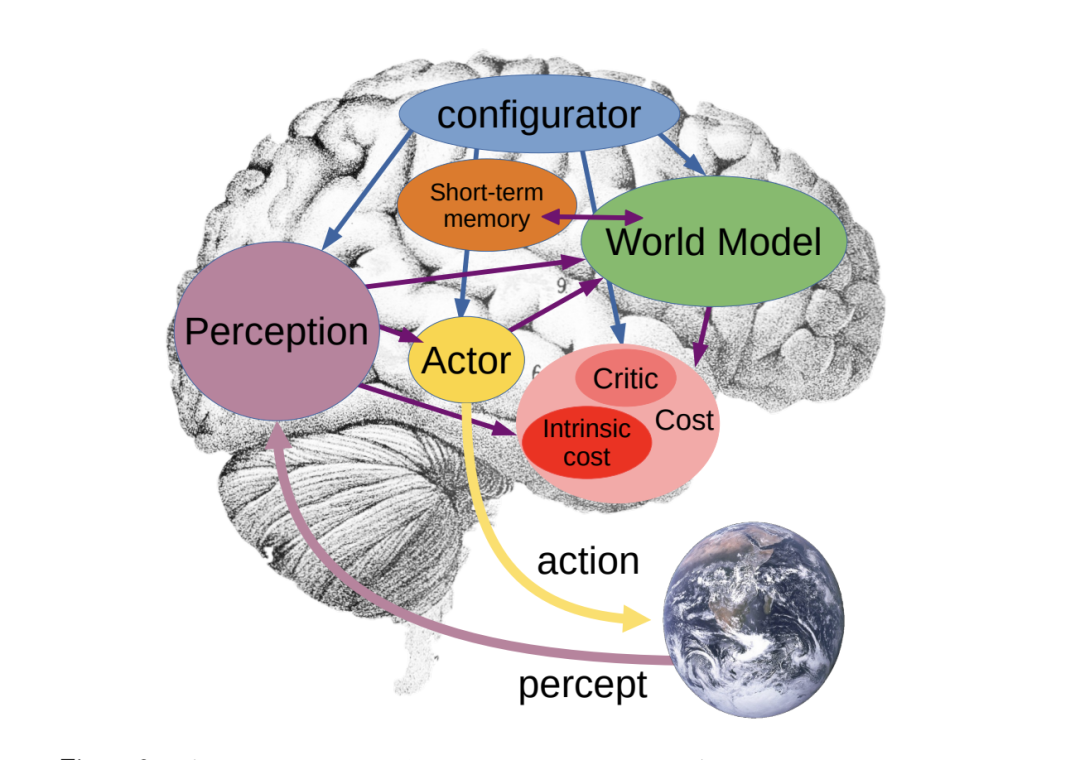
원문은 LLM의 규모 확장만으로 인간 수준의 지능에 반드시 도달할 수 있다는 주장에 대한 LeCun의 반복적인 비판도 언급합니다. 동시에 그는 LLM 기반 도구가 실제로 매우 유용하다는 점도 인정해 왔습니다.
따라서 H-JEPA는 오늘날 모든 언어 모델을 대체하려는 시도라기보다, LeCun이 주장해 온 대안적 아키텍처를 구체적으로 실험한 결과로 이해하는 것이 가장 적절합니다.
이 연구 방향은 이제 AMI의 사업 전략에도 포함되어 있습니다.
Reuters와 당시의 다른 보도에 따르면 AMI는 2026년 3월 10억 3천만 달러를 조달했으며, 기업가치 산정 전 평가액은 35억 달러였습니다.
회사는 다음 인물을 포함한 팀이 이끌고 있습니다.
Michael Rabbat은 H-JEPA 논문의 저자 중 한 명이기도 합니다.
AMI는 세계를 이해하고, 지속적인 기억을 유지하며, 추론과 계획을 수행하고, 제어 가능성과 안전성을 유지하는 시스템을 구축하는 것을 목표로 설명합니다.
BAAI 원문이 작성된 시점에 회사는 광범위하게 이용 가능한 공개 제품보다는 연구, 팀, 채용을 중심으로 자신을 소개하고 있었습니다.
따라서 H-JEPA는 스타트업의 월드 모델 가설에서 나온 구체적인 기술적 결과를 제공한다는 점에서도 중요합니다.
원문은 AMI를 또 다른 유명 월드 모델 기업인 Fei-Fei Li의 World Labs와 비교하며 마무리됩니다.
2026년 9월 28일 AMD는 World Labs를 인수하기 위한 최종 계약을 발표했습니다.
AMD의 SEC 제출 자료에 따르면 이 모든 주식으로 진행되는 거래의 가치는 통상적인 조정 사항을 적용하기 전 약 82억 달러입니다.
두 회사는 서로 다른 조직적 경로를 추구하고 있지만, 모두 월드 모델, 공간 지능, 로보틱스, 시뮬레이션, 물리적 AI의 중요성이 커지고 있음을 보여줍니다.
AMI는 계층적 예측 모델을 중심으로 자체 연구 프로그램을 계속 발전시키고 있으며, World Labs는 대형 AI 컴퓨팅 기업과의 통합을 향해 나아가고 있습니다.
H-JEPA에 대해 당장 제기되는 질문은 기업 측면보다는 기술 측면에 가깝습니다. 잠재 계층적 계획이 시뮬레이션 제어와 오프라인 로봇 영상에서 더 풍부한 폐루프 현실 시스템으로 얼마나 확장될 수 있는가 하는 문제입니다.
이것이 이 아키텍처의 다음 시험입니다.
H-JEPA는 시각적 계획을 위한 엔드투엔드 계층적 월드 모델입니다. 여러 개의 행동 조건부 JEPA를 쌓아 상위 수준은 더 먼 미래를 예측하고 잠재 서브골을 하위 수준으로 전달합니다.
플랫 월드 모델은 하나의 표현과 하나의 계획 시간 범위를 사용합니다. H-JEPA는 여러 시간 범위에서 별도의 잠재 공간을 학습하므로, 상위 수준은 느리게 변하는 과제 관련 구조에 집중하고 하위 수준은 제어에 필요한 세부 정보를 보존할 수 있습니다.
공식 GitHub 저장소에 따르면 3단계 H-JEPA는 약 73.3%의 계획 성공률을 기록했으며, 플랫 LeWorldModel 기준선은 **18.0%**였습니다. 계층 구조는 성공률과 계획기 연산량 사이에서도 더 나은 균형을 달성합니다.
SIGReg는 Sketched Isotropic Gaussian Regularization의 약자입니다. LeJEPA에서 소개된 이 방법은 잠재 분포를 제약해 표현 붕괴를 방지합니다. 표현 붕괴란 인코더가 서로 다른 여러 상태를 거의 동일한 임베딩으로 매핑하는 현상입니다.
그렇습니다. 공식 GitHub 코드 릴리스는 MIT 라이선스를 사용하며, 사전 학습된 체크포인트는 Hugging Face에서 제공됩니다. 관련 H-JEPA 데이터셋 저장소는 CC BY 4.0으로 공개되어 있습니다.
논문은 역동역학 감독을 사용해 DROID의 다양한 실제 로봇 영상으로 접근 방식을 확장합니다. 해당 실험은 오프라인 계획 충실도를 평가한 것이며, 완전한 폐루프 로봇 과제 성공을 평가한 것은 아닙니다. 따라서 이를 자율적인 실제 환경 배포 성과로 과장해서는 안 됩니다.
아닙니다. 논문은 과제에 여러 시간 범위에 걸친 의미 있는 구조가 있을 때 더 깊은 계층이 도움이 되지만, Push-T와 같은 짧은 과제에서는 매우 깊은 계층이 성능을 저하시킬 수 있음을 보여줍니다. 상위 수준이 유용한 학습 신호를 충분히 받지 못할 수 있기 때문입니다.
H-JEPA는 LeCun의 JEPA 및 월드 모델 가설을 따릅니다. 즉, 세계의 압축된 표현을 학습하고, 모든 픽셀 대신 미래의 잠재 상태를 예측하며, 그 예측을 계획에 활용합니다. H-JEPA는 서로 다른 수준이 서로 다른 시간 범위와 추상화에서 작동할 수 있도록 명시적인 계층을 추가합니다.
H-JEPA는 JEPA 월드 모델 아이디어를 명시적인 계획 계층으로 전환합니다. 상위 수준은 더 긴 시간 범위와 더 추상적인 표현에서 작동하며, 하위 수준은 이러한 계획을 점점 더 구체적인 서브골과 행동으로 변환합니다.
가장 강력한 결과는 Visual AntMaze에서 나타났습니다. 3단계 H-JEPA는 플랫 LeWorldModel 기준선의 18%에 비해 약 73%의 계획 성공률을 기록했으며 계획 효율성도 개선했습니다. 동시에 이 연구는 계층이 자동으로 유용한 것은 아니라는 점을 보여줍니다. 추가 수준이 도움이 되는지는 과제의 시간 범위와 데이터 가용성에 달려 있습니다.
이 프로젝트는 새롭게 공개된 연구 결과로서는 이례적으로 재현성이 높습니다. 코드, 체크포인트, 데이터셋이 이미 공개되어 있기 때문입니다.
H-JEPA의 핵심 기여는 단순히 미로 점수를 높인 것이 아닙니다. 서로 다른 계획 범위에 대해 서로 다른 표현을 학습함으로써 월드 모델이 이점을 얻을 수 있다는 점을 구체적으로 보여준 것입니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.



