For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/harness2-explained-recursive-agent-harnes-65188473.md.
Harness²(또는 Harness2)는 고정된 언어 모델을 둘러싼 소프트웨어를 변경하는 실용적인 재귀적 개선 방식을 탐구합니다. 수정 가능한 실행 환경에는 프롬프트, 가드레일, 메모리, 스킬, 도구 사용 지침, 스크립트, 서브에이전트 및 미들웨어가 ...
Harness²(또는 Harness2)는 고정된 언어 모델을 둘러싼 소프트웨어를 변경하는 실용적인 재귀적 개선 방식을 탐구합니다. 수정 가능한 실행 환경에는 프롬프트, 가드레일, 메모리, 스킬, 도구 사용 지침, 스크립트, 서브에이전트 및 미들웨어가 포함됩니다.
이 연구는 Google Cloud AI Research와 Northwestern University에서 수행했습니다. 매번 실패할 때마다 새로운 모델을 학습하는 대신, 시스템은 에이전트의 실행 과정을 분석하고 하네스 변경 사항을 테스트하며 어떤 변경이 도움이 되었는지에 대한 근거를 보존합니다.
저자들은 OpenCode 환경에서 한 번의 개선 단계만으로 GLM-5의 WorkBuddy-Bench 평균 점수가 64.2에서 75.7로 상승했다고 보고합니다. 이는 특정 평가에서의 11.5점 향상이며, 모든 모델이나 애플리케이션에서 보장되는 개선은 아닙니다.
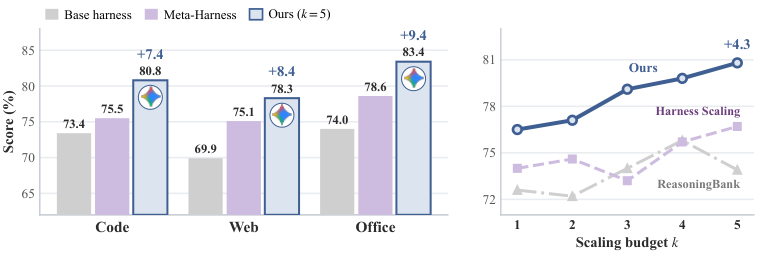
연구팀의 그림으로, QbitAI/BAAI 보고서에 재현됨.
이 연구의 배경에는 두 가지 문제가 있습니다.
Harness2는 현재 실행에 사용되는 하네스와 이를 개선하는 프로세스를 분리합니다. 이후 작업은 공통 기본 하네스에서 시작하며, 개선기는 과거의 모든 규칙을 무조건 가져오는 대신 이전 근거를 선택적으로 활용합니다.
시스템은 먼저 초기 하네스를 사용해 기준 실행을 기록합니다. 그런 다음 해당 추적 정보를 활용해 약점을 식별하고 가능한 수정 사항을 테스트합니다.
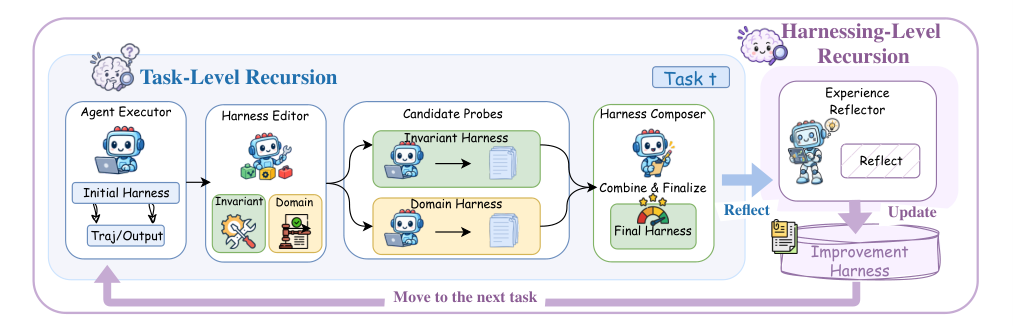
개선 단계는 세 가지 과정으로 구성됩니다.
행동 비교는 적응 과정에서 사용할 수 없는 정답 기반 피드백을 대신합니다. 하지만 최종 결과물의 정확성을 판단하는 완벽한 심판은 아닙니다. 이 방법이 실제로 작동하는지를 측정하려면 외부 벤치마크 평가가 여전히 중요합니다.
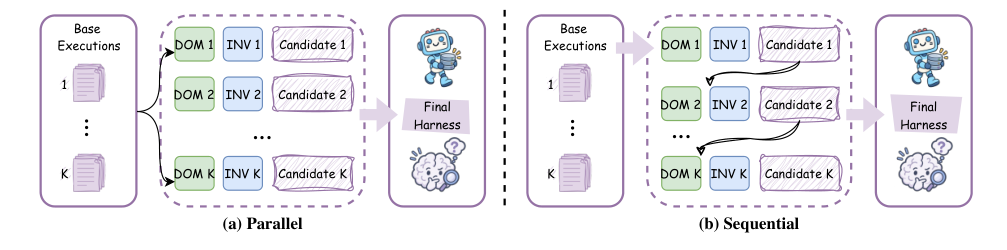
이 방법은 병렬 재귀를 통해 더 폭넓게 탐색하거나, 순차 재귀를 통해 연속적인 수정을 수행할 수 있습니다. 병렬 예산이 k인 경우, 일반 후보 k개와 도메인 후보 k개를 탐색한 뒤 k개의 조합 결과를 생성합니다. 후보가 많아질수록 더 많은 계산이 필요합니다.
작업이 끝나면 경험 반영기가 기준 추적 정보, 제안된 편집 내용, 탐색 근거 및 조합 결정을 검토합니다. 그런 다음 EXPERIENCE.md의 메모를 포함해 재사용 가능한 구성 요소와 교훈을 기록합니다.
다음 작업에는 기본 실행 하네스가 제공되지만, 편집 프로세스는 이전에 얻은 교훈을 검색할 수 있습니다. 지속되는 것은 특정 수정이 유용한 시점에 대한 지식이지, 이전 작업의 전체 구성을 영구 설정으로 삼는 가정이 아닙니다.
모델 파라미터는 고정된 상태로 유지됩니다. 이는 파일과 실행 근거를 통한 런타임 적응이며, 모델 가중치를 자율적으로 학습했다는 의미는 아닙니다.
이 연구는 WorkBuddy-Bench의 코드, 웹 및 오피스 결과물, JobBench의 전문 작업, Harvey의 Legal Agent Benchmark를 평가합니다. 실행 하네스로는 OpenCode 및 Codex와 함께 GLM-5와 Gemini 3.5 Flash를 사용합니다.
기본 편집기는 OpenCode 환경의 Claude Opus 4.8입니다. 따라서 주요 결과는 실행 모델 자체만의 무료 성능 향상이 아니라, 실행 모델을 둘러싼 개선 시스템의 결과로 이해해야 합니다.
| 실행 모델 | 초기 하네스 | 기본 WorkBuddy 평균 | Harness2 1회 단계 | 향상 폭 |
|---|---|---|---|---|
| GLM-5 | OpenCode | 64.2 | 75.7 | 11.5점 |
| GLM-5 | Codex | 64.4 | 75.3 | 10.9점 |
| Gemini 3.5 Flash | OpenCode | 72.4 | 77.5 | 5.1점 |
| Gemini 3.5 Flash | Codex | 74.5 | 77.5 | 3.0점 |
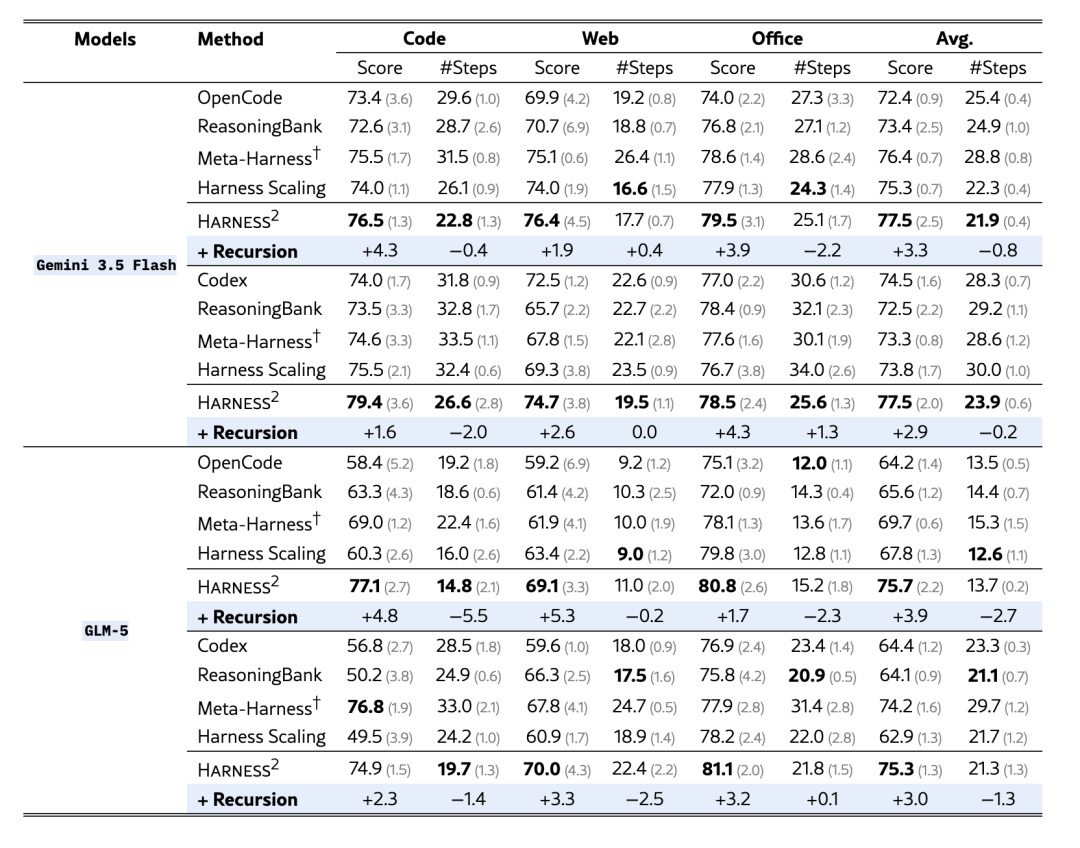
이 비교에서 개선된 하네스를 적용한 GLM-5는 수정하지 않은 Gemini의 해당 기준선을 넘어섭니다. 이는 런타임 설계가 모델 순위에 영향을 줄 수 있음을 보여주지만, 모든 작업에서 GLM-5가 더 강하다는 의미는 아닙니다.
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
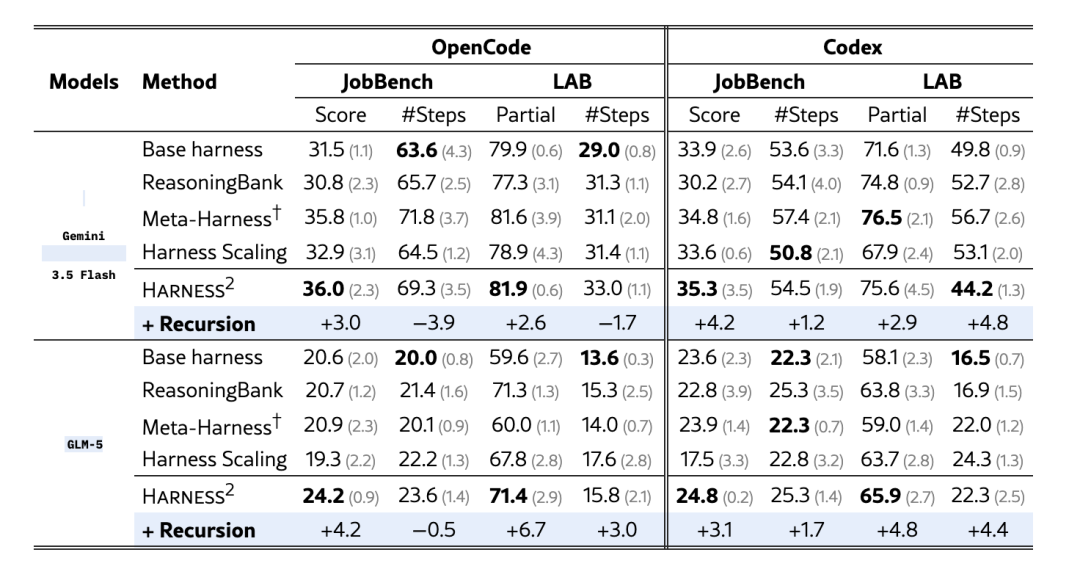
논문은 JobBench에서 최대 4.5점, LAB Partial에서 최대 11.8%포인트의 1회 단계 향상을 보고합니다. 여기서 Partial은 기준별 통과율이며, 모든 기준을 충족하는 작업의 비율과는 다릅니다.
병렬 예산을 k=5로 늘리면 1회 단계와 비교해 WorkBuddy에서 최대 3.9점, JobBench에서 4.2점, LAB Partial에서 6.7%포인트가 추가됩니다. 주요 표에는 작업 순서를 섞어 세 번 실행한 결과의 평균과 표준편차가 보고되어 있습니다.
전이 실험도 유용한 정보를 제공합니다. JobBench에서 축적한 라이브러리는 해당 비교에서 추가 탐색 없이 WorkBuddy의 1회 단계 개선을 코드에서 0.6점, 웹에서 0.5점, 오피스에서 2.9점 향상시킵니다.
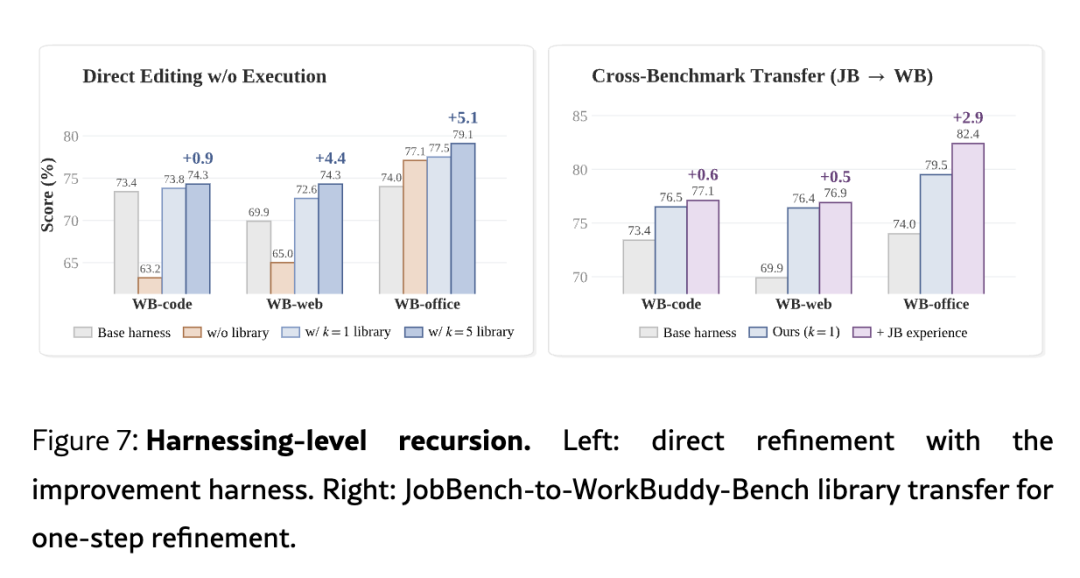
이러한 결과는 개선 경험을 선택적으로 재사용하는 방식을 뒷받침합니다. 그러나 축적된 모든 규칙이 전이된다는 의미는 아니며, 실제 작업 분포에서 적용한 하네스를 점검할 필요가 사라지는 것도 아닙니다.
논문에는 Ruiyao Xu, Yanfei Chen, Zhongying CuiZhu, Bhavana Dalvi Mishra, Yifei Ming, Han Yu, Rujun Han, Chen-Yu Lee 및 Tomas Pfister 등 9명의 저자가 기재되어 있습니다. 연구 자료에서는 Northwestern의 박사과정 학생인 Xu와 Google Cloud 연구자인 Chen 및 CuiZhu의 프로필을 소개합니다.
공개 저장소는 두 실행 하네스와 두 재귀 모드를 모두 지원합니다. Linux, Python 3.12 및 uv를 요구하며, 모델 기반 벤치마크에는 추가 종속성과 API 비용이 발생합니다. WorkBuddy에는 Docker가 필요하고, LAB에는 Pandoc 및 Poppler를 포함한 도구가 필요합니다.
README는 실행 모델의 네트워크 접근이 제한 없이 허용되며, 해당 설정에서는 Codex 실행 샌드박스가 비활성화되어 있다고도 경고합니다. 벤치마크 사용자는 결과를 평가하기 전에 정답과 채점 기준에 대한 접근을 차단하도록 제한을 구성해야 합니다. 논문에서 제시한 런타임 개선은 이러한 실행 및 평가 조건과 함께 검토해야 합니다.
언어 모델을 둘러싼 런타임을 수정하며, 여기에는 프롬프트, 도구, 메모리 및 스킬이 포함됩니다. 기반 모델의 가중치는 고정된 상태로 유지됩니다.
작업 수준 재귀는 현재 작업에 대한 수정 사항을 테스트하고 조합합니다. 하네싱 수준 재귀는 이후 편집 결정을 개선하기 위해 근거와 재사용 가능한 교훈을 보존합니다.
적응 방법은 정답 검증기 대신 실행 추적 정보 간의 대비를 사용합니다. 따라서 라벨이 없는 경우에도 근거를 확보할 수 있지만, 결과물의 정확성을 보장하지는 않습니다.
아닙니다. 이는 연구에서 보고한 GLM-5/OpenCode WorkBuddy 평균 향상 폭입니다. 다른 모델, 하네스 및 벤치마크 조합에서는 향상 폭이 달라집니다.
후보 실행과 개선 작업이 추가됩니다. 논문은 실행 토큰과 개선 토큰을 포함한 전체 계산량과 함께 성능을 분석합니다.
저장소에서는 WorkBuddy-Bench에 Docker가 필요하다고 안내합니다. 로컬 결정론적 데모와 다른 벤치마크는 요구 사항이 다르므로, 선택한 워크플로의 지침을 따라야 합니다.
Harness2는 작업별 실험과 에이전트 런타임 개선에 관한 교훈 라이브러리를 결합합니다. 보고된 결과는 모델 가중치를 고정한 상태에서도 프롬프트, 도구 처리 및 실행 구조가 결과를 실질적으로 바꿀 수 있음을 보여줍니다.
이 근거는 계산량, 검증 및 전이의 한계를 명확히 드러낸 조건에서 더 나은 하네스 엔지니어링을 뒷받침합니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.



