For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/houmo-m50-open-source-software-for-local-1781bd08.md.
AI 워크로드를 로컬 디바이스로 옮기려면 성능 좋은 가속기만으로는 충분하지 않습니다. 개발자는 모델을 준비하고, 효율적으로 실행하며, 여러 구성 요소를 연결하고, 완성된 제품을 유지·관리할 방법이 필요합니다.
AI 워크로드를 로컬 디바이스로 옮기려면 성능 좋은 가속기만으로는 충분하지 않습니다. 개발자는 모델을 준비하고, 효율적으로 실행하며, 여러 구성 요소를 연결하고, 완성된 제품을 유지·관리할 방법이 필요합니다.
Houmo의 최신 생태계 발표는 바로 그 소프트웨어 계층을 다룹니다. 제공된 보고서에 따르면, 이 회사는 AI 소프트웨어 스택을 단계적으로 공개할 계획이며, 2027년 1월까지 15개 프로젝트를 공개할 예정입니다. 모델 예제, 양자화 도구, 널리 알려진 추론 프레임워크의 개조 버전을 포함한 여러 리포지토리는 이미 공개되어 있습니다.
로드맵과 현재 이용 가능한 코드의 차이는 중요합니다. 전체 스택을 오픈소스로 공개하겠다는 계획이 모든 구성 요소가 이미 게시되었거나 모든 런타임 종속성이 사라졌다는 뜻은 아닙니다.
보고서는 이 스택을 네 개 계층으로 구성합니다.
| 계층 | 배포에서의 역할 |
|---|---|
| 모델 준비 | 양자화, 컴파일, 정확도 검사 및 지원되는 형식으로의 변환 |
| 추론 프레임워크, 연산자 및 런타임 | Houmo 하드웨어에서의 실행 및 스케줄링 |
| 도메인 키트, 파이프라인 및 미들웨어 | 모델과 애플리케이션 구성 요소 간의 조정 |
| 배포 및 운영 | 배포된 디바이스 전반의 업데이트, 모니터링 및 관리 |
회의 보조 도구는 이러한 계층이 함께 필요한 이유를 보여 줍니다. 음성 인식 결과는 언어 모델로 전달되어야 하고, 언어 모델은 유용한 기록을 생성해야 하며, 애플리케이션은 이를 저장하거나 표시해야 합니다. 각 단계에는 고유한 메모리, 지연 시간 및 호환성 요구 사항이 있습니다.
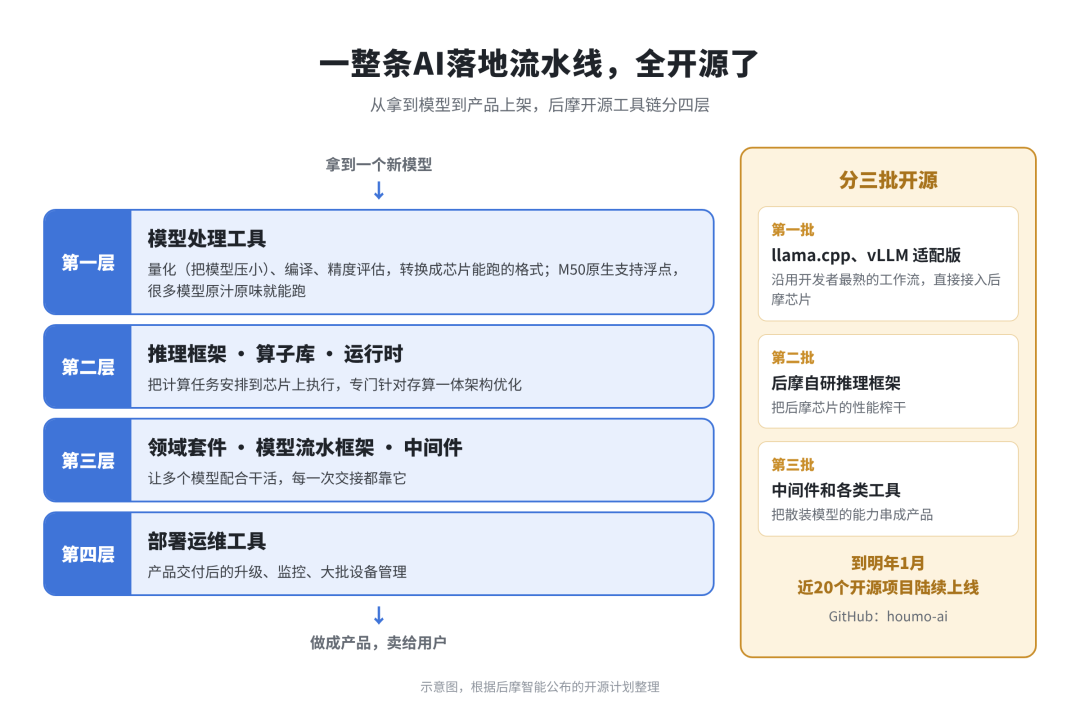
신즈위안/BAAI 보고서의 소프트웨어 스택 다이어그램이며, 원본 라벨은 중국어로 되어 있습니다.
보고된 공개 순서는 llama.cpp 및 vLLM의 개조 버전으로 시작한 뒤 Houmo 자체 추론 프레임워크, 그리고 미들웨어와 기타 도구를 순차적으로 공개하는 방식입니다. 더 광범위한 로드맵에는 가속기 및 클러스터 관리를 위한 인프라도 포함됩니다.
공개된 postmo-modelzoo 리포지토리는 양자화, 컴파일, 정확도 평가, 성능 측정 및 애플리케이션 배포를 다루는 예제를 설명합니다. 모델 범주에는 음성 인식, 음성 생성, 언어 모델, 비전 언어 모델, 임베딩, OCR, 세그멘테이션 및 이미지 생성이 포함됩니다.
그 밖에 확인 가능한 리포지토리로는 postmo-quantflow, postmo-gptqmodel, vllm-postmo, 그리고 Houmo의 llama.cpp 및 vLLM 포크가 있습니다. 개발자는 설치 절차나 지원 수준이 동일하다고 가정하지 말고 각 리포지토리의 README와 현재 브랜치를 확인해야 합니다.
모델 예제 README는 다음과 같은 구체적 제약 조건을 제시합니다.
houmo-tcim-runtime 및 houmo-drv의 라이브러리에 의존합니다.이러한 요구 사항은 계획 수립에 중요합니다. 오픈 예제 리포지토리는 검토 가능한 통합 코드를 제공하지만, 하드웨어 독립적인 실행 환경은 아닙니다.
출처는 M50과 관련하여 100곳 이상의 고객 및 150개 이상의 계획된 단말 제품이 있다고 설명합니다. 이 수치는 검증된 출하량이 아니라 보고된 생태계 파이프라인을 나타냅니다.
보고서는 Lenovo의 P7을 무게 약 300g, 최대 시스템 전력 30W 등급의 AI 컴퓨터로 설명합니다. 이 기기는 128K 컨텍스트를 지원하면서 1,220억 파라미터 모델을 로컬에서 초당 50토큰으로 실행한다고 보고되었습니다.
이 수치는 누락된 테스트 조건과 함께 해석해야 합니다. 이 글은 모델 아키텍처, 정밀도, 워크로드 및 측정 구성에 관한 세부 정보를 충분히 제공하지 않으므로, 이를 일반적인 성능 보장으로 간주할 수 없습니다. 특히 파라미터 수만으로는 배포에 필요한 메모리 용량을 알 수 없습니다.
M50 자체는 INT8 기준 160 TOPS 성능, 일반적인 10W 전력 수치, 최대 48GB LPDDR5/5X 메모리 지원을 제공하는 것으로 설명됩니다. 가속기 전력, 전체 시스템 전력, 이론적 처리량 및 생성 토큰 속도는 서로 다른 지표입니다.
그 밖에 보고된 제품에는 Deepshard의 Truffle 1 M50 버전, Ugreen의 HomeAgent HA100 Pro, ClawHouse X1이 포함됩니다. 이들의 사례는 로컬 메모리, 가정용 미디어 처리 및 개인 에이전트 인터페이스에 초점을 맞춥니다. 이메일과 같은 연결형 서비스는 모델이 로컬에서 실행되더라도 인증과 네트워크 접속에 계속 의존합니다.
보고서는 Kylin V11을 실행하는 Great Wall N90 Pro 노트북이 350억 파라미터 모델을 오프라인에서 초당 30토큰으로 실행한다고 설명합니다. 또한 인식과 메모리를 위해 로컬 처리를 사용하는 동반 로봇과, 각각 4개의 M50 칩을 통합한 LM5040 가속기 카드 기반의 교육용 장비도 언급합니다.
교육 시스템의 보고된 연산 및 메모리 수치는 단일 M50이 아니라 조립된 장비 전체에 적용됩니다. 제품을 비교하는 독자는 실제 카드 수, 메모리 토폴로지, 정밀도 및 측정된 워크로드를 확인해야 합니다.
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
아키텍처 관련 논의는 Mixture-of-Experts 모델과 밀집형 모델을 구분합니다. MoE 모델은 토큰 하나를 처리할 때 전문가의 일부만 활성화할 수 있지만, 더 넓은 파라미터 집합 전체를 저장해야 합니다. 밀집형 모델은 일반적으로 각 단계에서 더 많은 비율의 파라미터를 사용하므로 메모리 트래픽이 주요 고려 사항이 됩니다.
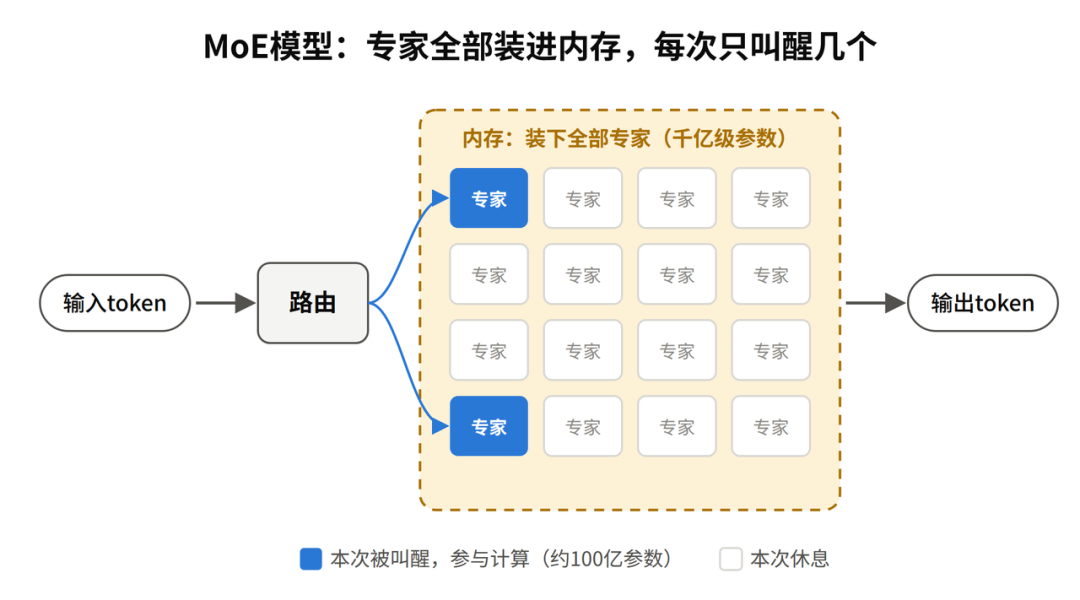
출처 보고서의 MoE 일러스트레이션이며, 원본 라벨은 저장된 전문가와 활성화된 전문가를 설명합니다.
Houmo는 두 가지 개발 경로를 제시합니다. 외부 메모리를 활용해 용량과 연산을 강조하는 2D 컴퓨트-인-메모리와, 적층형 설계를 통해 대역폭을 강조하는 3D 컴퓨트-인-메모리입니다. 보고서는 로직 계층의 SRAM 기반 연산을 후자의 차별화 요소로 설명합니다.
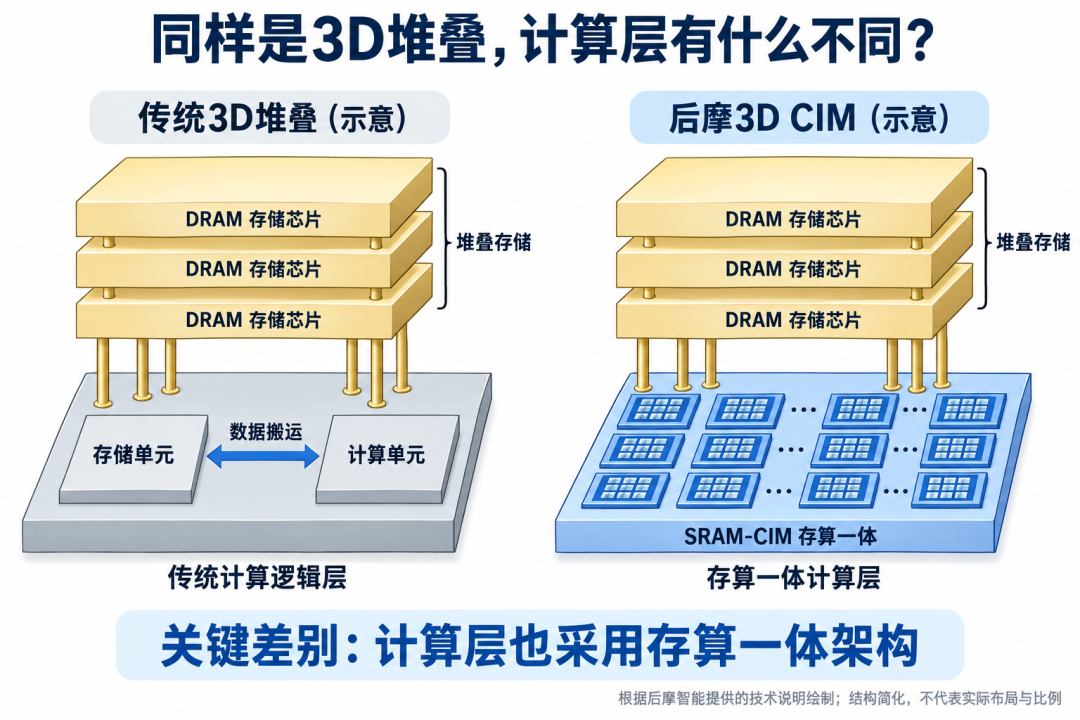
신즈위안/BAAI 보고서에 재현된 아키텍처 비교이며, 독립 벤치마크가 아닙니다.
회사가 제시한 면적 및 전력 비교는 비교 대상에 따라 달라집니다. 공개된 측정 설정 없이 이를 모든 칩이나 모델에 적용해서는 안 됩니다. Flash 또는 RRAM에 대한 향후 언급 역시 현재 제품 가용성의 보장이 아니라 개발 방향을 설명하는 내용입니다.
출처는 이번 발표를 창립자 겸 CEO인 Qiang Wu의 이전 GPGPU 및 OpenCL 작업과 연결합니다. 실무적으로는 도구를 공개함으로써 개발자가 통합 동작을 검토하고, 예제를 조정하며, 수정 사항에 기여할 수 있게 됩니다.
이러한 접근은 디바이스 제조사 전반의 반복 작업을 줄일 수 있습니다. 그러나 최종 제품에서는 품질, 발열, 메모리 사용량, 라이선스, 오프라인 작동 및 복구 동작을 테스트할 필요가 여전히 남습니다. 의도한 하드웨어에서 재현 가능한 예제는 헤드라인의 파라미터 수보다 더 나은 출발점입니다.
M50은 보고서에서 설명한 로컬 디바이스 AI 시나리오에 사용되는 엣지 AI 가속기입니다. 예로는 에이전트 컴퓨터, 노트북, 홈 시스템, 로봇 및 엣지 추론 장비가 있습니다.
보고서는 2027년 1월까지 이어지는 단계적 공개 계획을 설명합니다. 현재 여러 리포지토리가 공개되어 있지만, 개발자는 각 구성 요소의 실제 공개 상태와 라이선스를 확인해야 합니다.
이 리포지토리는 서로 다른 플랫폼 요구 사항을 가진 준비 및 평가 도구를 포함합니다. 추론 예제에는 지원되는 Houmo 하드웨어와 런타임 라이브러리가 필요하며, 대규모 모델 양자화에는 GPU도 필요합니다.
필요한 자산이 설치되어 있다면 로컬 추론은 클라우드 모델 서비스 없이 작동할 수 있습니다. 하지만 실시간 이메일, 메시징 또는 기타 온라인 서비스를 포함하는 작업에는 여전히 연결성과 인증이 필요합니다.
아니요. TOPS는 특정 정밀도에서의 연산 처리량 수치인 반면, 토큰 속도는 모델 아키텍처, 메모리 트래픽, 정밀도 및 소프트웨어 동작에 따라 달라집니다. 동일한 모델과 워크로드에 대해 측정된 결과를 비교해야 합니다.
아니요. README는 대부분의 서드파티 데이터셋을 별도로 획득하고 각 데이터셋의 자체 약관에 따라 사용해야 한다고 명시합니다. 리포지토리 라이선스는 참조된 모든 데이터 또는 모델 자산에 대한 상업적 권리를 부여하지 않습니다.
Houmo의 발표는 모델 준비부터 작동하는 엣지 제품까지의 경로를 더 쉽게 재사용할 수 있도록 하는 데 목적이 있습니다. 공개 리포지토리는 이미 유용한 예제를 제공하지만, 더 광범위한 스택은 여전히 단계적 공개 계획에 속합니다.
보고된 M50 디바이스는 여러 가능한 배포 형식을 보여 주지만, 실질적인 결정은 여전히 정확한 모델, 하드웨어 및 런타임 요구 사항에 달려 있습니다. 지원되는 예제부터 시작하고 전체 제품 워크로드를 측정하세요.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.
