For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/minicpm-v-4-7-35b-moe-on-iphone-les-and-l-9db57311.md.
MiniCPM-V 4.7은 휴대폰을 포함한 로컬 기기에 350억 매개변수 mixture-of-experts 모델을 제공합니다. ModelBest와 OpenBMB는 최적화된 배포 스택을 사용해 iPhone 17 Pro Max에서 약 3GB의 메모리로 초...

MiniCPM-V 4.7은 휴대폰을 포함한 로컬 기기에 350억 매개변수 mixture-of-experts 모델을 제공합니다. ModelBest와 OpenBMB는 최적화된 배포 스택을 사용해 iPhone 17 Pro Max에서 약 3GB의 메모리로 초당 13개 이상의 생성 토큰을 보고했습니다.
이 수치에는 맥락이 필요합니다. 완전한 35B 모델이 3GB 다운로드에 들어간다는 뜻도 아니며, RAM이 3GB인 모든 휴대폰이 광고된 속도로 실행할 수 있다는 뜻도 아닙니다. 이 모델은 스토리지에서 전문가 가중치를 스트리밍하고, 스케줄링, 양자화 및 추론 최적화를 사용하여 활성 작업 세트를 작게 유지합니다.
이번 릴리스에는 두 가지 주요 변형이 있습니다.
| 변형 | 설계 | 의도된 용도 |
|---|---|---|
| MiniCPM-V 4.7 35B-A3B | 총 35B 매개변수와 토큰당 약 3B가 활성화되는 MoE | 더 강력한 로컬 이미지, 문서, 다중 이미지 및 동영상 이해 |
| MiniCPM-V 4.7 1B | 소형 밀집형 모델, QbitAI는 약 1.3B 매개변수로 설명 | 저리소스 시각 작업, OCR 및 문서 추출 |
35B-A3B 모델은 MiniCPM-V 시리즈 최초의 MoE입니다. 프로젝트는 2026년 10월 12일에 4.7을 발표했고, 이어 10월 15일에 두 변형 모두를 위한 DSpark 추측 디코딩 헤드를 공개했습니다.
리포지토리는 iOS, Android 및 HarmonyOS 배포 지원을 나열합니다. 또한 Intel, AMD, Arm, Rockchip 및 Houmo 플랫폼 전반의 지원도 설명합니다. 실제 성능은 기기, 모델 형식, 추론 백엔드 및 설정에 따라 달라지므로, 플랫폼 지원이 하드웨어 전반에서 동일한 속도를 뜻하는 것으로 해석해서는 안 됩니다.
공식 35B-A3B 평가 표는 Instruct 모드에서 다음 결과를 보고합니다.
| 벤치마크 | 4× 시각 압축 | 16× 시각 압축 |
|---|---|---|
| MMBench | 91.72 | 90.87 |
| MMStar | 80.67 | 80.13 |
| MMMU | 80.22 | 80.00 |
| MathVista | 88.00 | 87.30 |
| OCRBench | 91.20 | 90.40 |
| OmniDocBench v1.6 | 94.24 | 93.25 |
| Video-MME, 자막 없음 | 76.40 | 74.70 |
| LongVideoBench | 68.90 | 67.60 |

출처: OpenBMB, MiniCPM-V 리포지토리. 이 표는 Instruct 모드의 공식 체크포인트를 사용한 팀의 로컬 평가와 공개 보고서를 결합합니다.
이 표는 더 강한 시각 압축으로 전환할 때 여러 작업에서 하락 폭이 비교적 작다는 점을 보여줍니다. 예를 들어 MMBench는 0.85점, OCRBench는 0.80점 하락합니다. 다른 작업은 더 크게 하락하므로, 개발자는 작은 텍스트, 차트 또는 시각적 세부 사항이 자체 워크로드에서 중요한지 계속 확인해야 합니다.
이는 모델 평가 결과이며, 모바일 구성이 모든 점수를 재현하거나 모든 사용자 이미지가 정확하게 해석된다는 증거는 아닙니다. 무엇을 테스트할지 선택하는 데 유용한 참조점입니다.
MoE는 토큰 하나에 대해 선택된 전문가만 활성화하여 연산량을 줄입니다. 그러나 이후 토큰과 레이어에서 다른 전문가를 선택할 수 있으므로, 다른 전문가를 저장할 필요까지 없애지는 않습니다.
메모리가 제한된 휴대폰에서는 이 가중치를 플래시에 저장하면 모델을 사용할 수 있지만, 스토리지를 반복적으로 기다리면 디코딩이 느려질 수 있습니다. 라우팅을 고정된 전문가 하위 집합으로 제한하면 로딩은 줄지만 모델이 사용할 수 있는 전문가도 바뀝니다. 대신 MiniCPM-V 4.7은 모델 라우터의 실제 결정을 보존하면서 로딩과 연산을 겹치게 하려 합니다.
Lookahead Expert Scheduling, 즉 LES는 다음 레이어에 필요할 가능성이 높은 전문가를 예측하고 가중치를 미리 로드합니다. 실제 라우터가 전문가를 선택하면 엔진은 먼저 이미 사용할 수 있는 선택 전문가를 계산하고, 남은 필수 전문가를 로드합니다.
이 예측은 준비와 실행 순서를 변경합니다. 모델의 라우팅 결정을 대체하지는 않습니다. 예측이 놓친 전문가도 계속 로드되고 평가됩니다. 이 구분은 이 기법이 영구적으로 축소된 전문가 풀에 의존하지 않고 속도를 향상할 수 있는 이유를 설명합니다.
공식 가이드는 LES를 세밀한 레이어별 양자화와 결합합니다. 더 작은 전문가 가중치는 스토리지와 메모리 간 트래픽을 줄이고, 최적화된 레이아웃은 로딩 효율을 높입니다. 팀은 온디바이스 최적화 작업으로 실제 기기에서 디코딩 성능이 5배 향상되었다고 보고합니다. 이는 테스트한 구성의 결과이며, 보편적인 배수는 아닙니다.
DSpark는 메인 모델이 검증할 토큰을 제안하는 초안 모델을 추가합니다. 이 릴리스는 두 크기 모두에 전용 초안 헤드를 제공합니다. 이것 역시 최적화된 스택의 구성 요소이므로, 범용 백엔드에서 실행되는 표준 체크포인트가 같은 속도를 낸다고 가정해서는 안 됩니다.
비전 측면에서 이 모델은 LLaVA-UHD v4를 기반으로 비전 인코더 내 조기 압축을 사용합니다. 시각 토큰을 일찍 병합하면 이후 인코더 레이어의 작업량이 줄어듭니다. 선택 가능한 4× 및 16× 설정은 시각적 세부 사항과 추론 비용 간의 절충을 제공합니다.
공식 모바일 앱 문서는 완전한 배포 상황을 훨씬 더 명확하게 보여줍니다.
| 모바일 배포 항목 | 문서화된 요구 사항 또는 크기 |
|---|---|
| 검증된 35B-A3B 휴대폰 | RAM 12GB의 iPhone 17 Pro Max |
| 35B-A3B 데모에 권장되는 기기 RAM | 최소 12GB |
| 35B-A3B 전체 모델 다운로드 | 약 16.6GB |
| 권장 여유 스토리지 | 모델 파일용 약 17GB |
| 전문가 스토리지 | 40개 샤드와 매니페스트를 포함하는 별도 experts/ 디렉터리 |
| 기본 데모 컨텍스트 윈도우 | 4K 토큰 |
분할 모바일 패키지는 표준 전체 모델 GGUF와 다릅니다. 주 -les 파일은 일치하는 전문가 디렉터리에 의존하며, 앱은 파일의 일관성을 확인합니다. 더 큰 컨텍스트 윈도우는 KV 캐시 메모리를 증가시키며, RAM이 적은 기기에서 더 작은 전문가 캐시는 생성 속도를 상당히 느리게 할 수 있습니다.
작은 작업 메모리 수치가 상당한 고속 로컬 스토리지의 필요성을 없애지는 않습니다.
QbitAI의 글은 로컬 휴대폰 및 태블릿 예시를 보여준 뒤 별도의 API 테스트를 제시합니다. 이 구분을 유지하는 것이 중요합니다. API 결과가 동일 작업이 휴대폰에서 오프라인으로 실행되었다는 증거는 아닙니다.
첫 번째 iPhone 시연에서 모델은 나폴레옹의 러시아 원정에 관한 미나르의 차트를 분석합니다. 최저 기온과 날짜를 묻자 1812년 12월 6일의 −30° Réaumur를 식별하고, °C = °Ré × 1.25를 사용해 −37.5°C로 변환합니다.
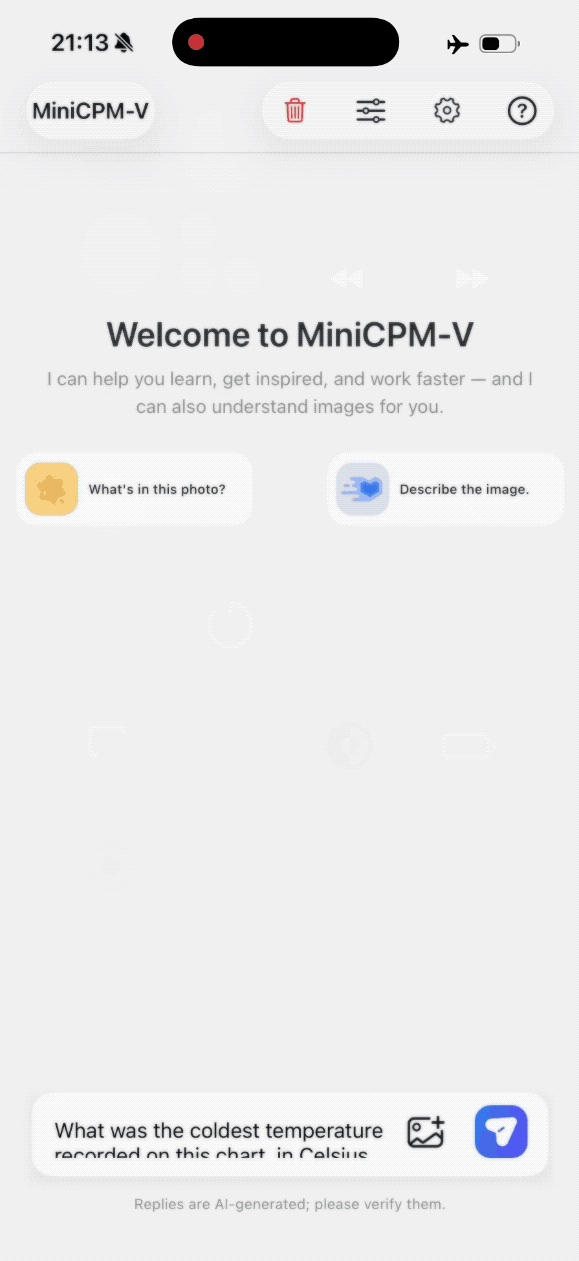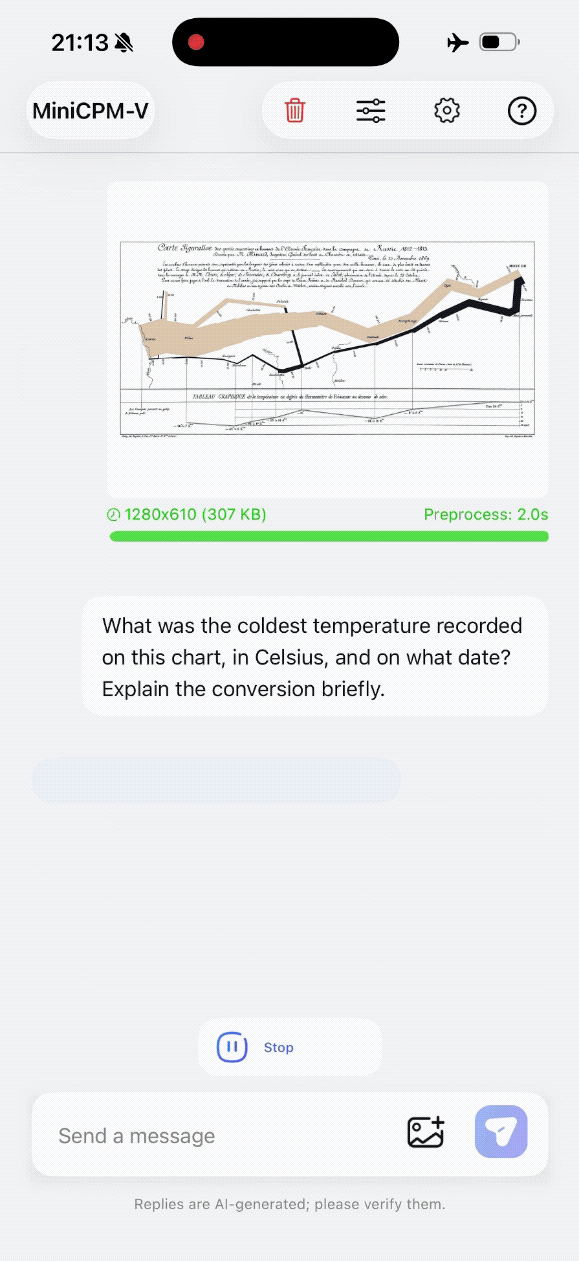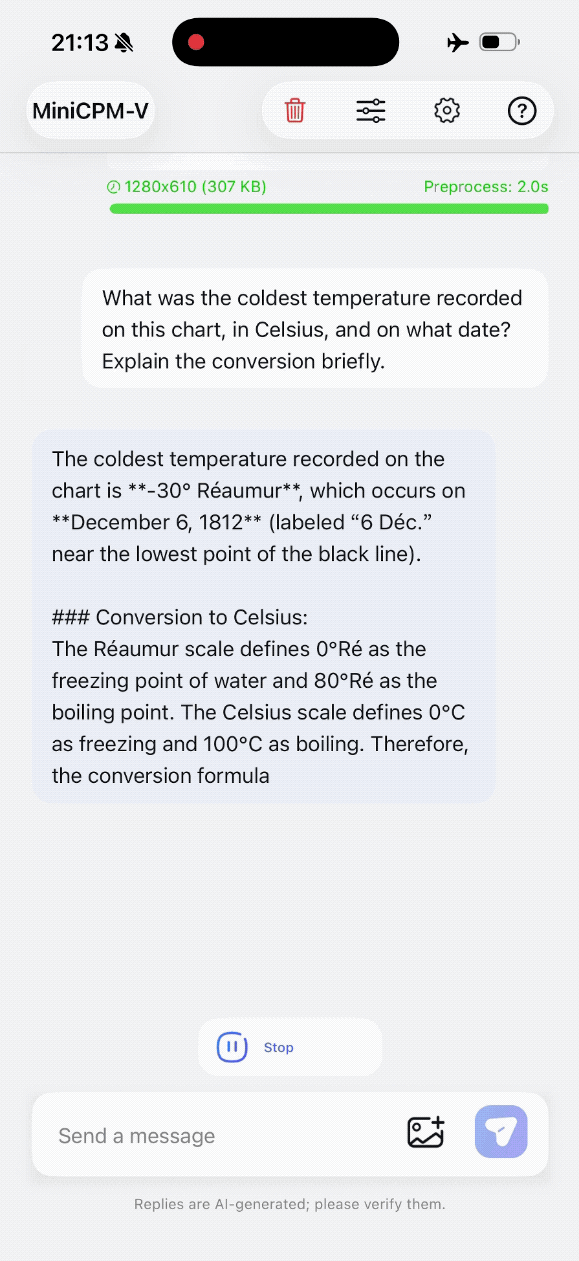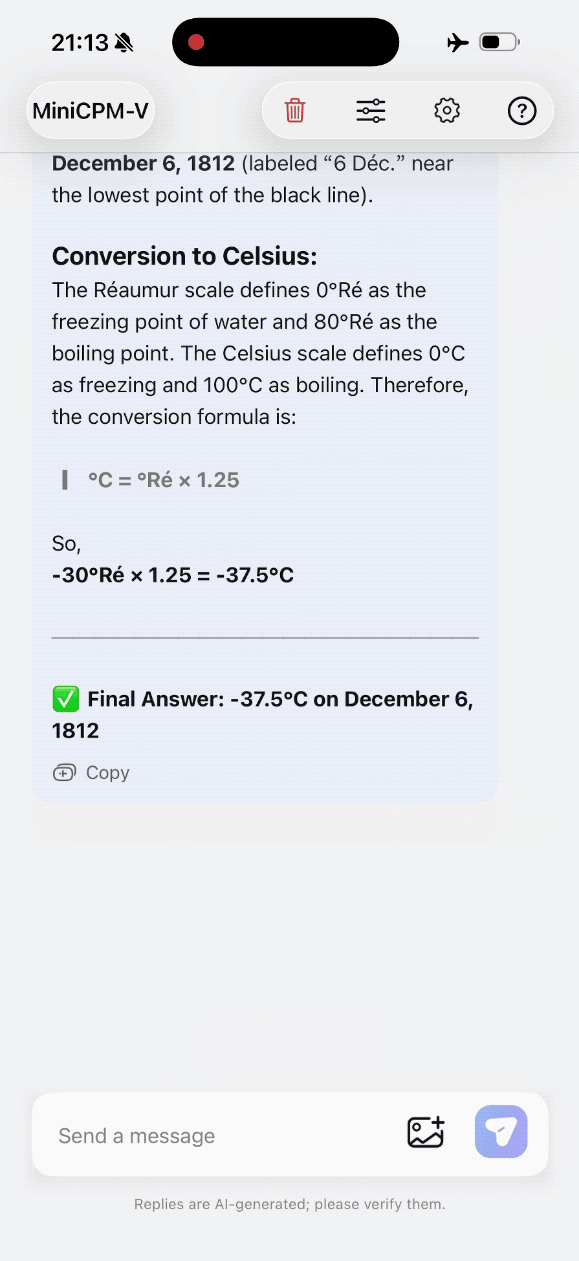
출처: BAAI를 통한 QbitAI, 애니메이션 휴대폰 화면 녹화. 이 출처는 M4 iPad에서도 같은 답변을 보고합니다.
이 예시는 텍스트 인식 이상을 테스트합니다. 모델은 차트를 읽고, 관련 지점에 날짜를 연결하고, 온도 눈금을 인식하며, 변환을 적용해야 합니다.
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
또 다른 예시는 기기 와트수와 사용 시간을 월 420kWh, 비용 ¥126의 전기 요금과 결합합니다. 보고된 출력은 나열된 기기에 대해 213.63kWh, 즉 청구량의 약 50.9%를 추정하고, 제안된 세 가지 절약 방안 중 에어컨 사용 감소가 최선이라고 식별합니다.
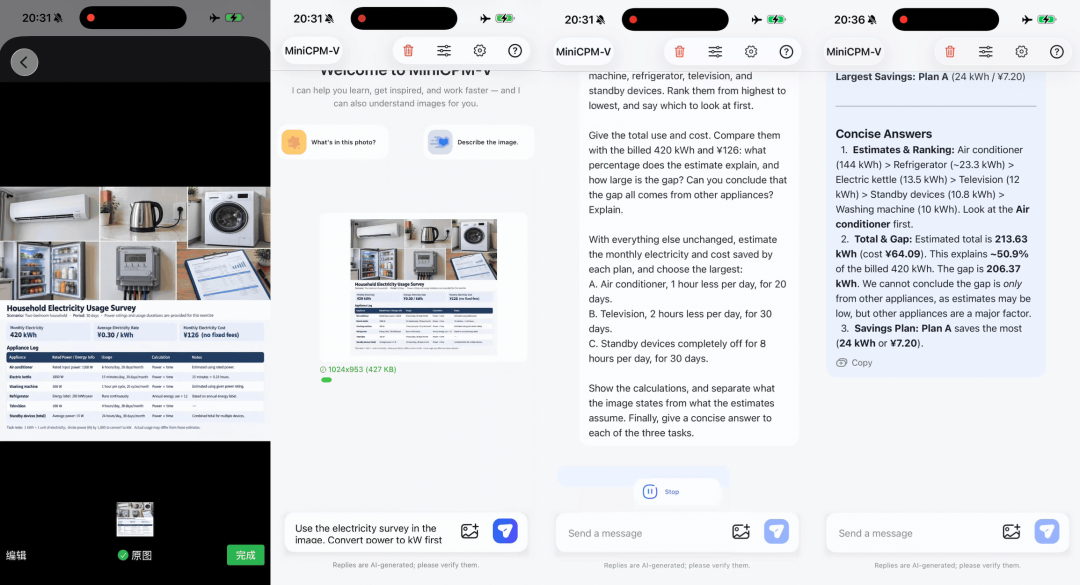
출처: BAAI를 통한 QbitAI. 표시된 답변은 설명되지 않은 소비량을 자동으로 다른 기기에 배정하지 않고 불확실한 것으로 처리합니다.
이러한 단서는 유용합니다. 추정 사용 시간, 실제 소비 전력 및 누락된 기기는 모두 청구서 비교에 영향을 줄 수 있습니다. 산술 합계가 맞는 것만으로 남은 소비량이 왜 발생했는지는 확인할 수 없습니다.
더 작은 모델은 제목, 표 및 수학 표기법을 포함한 논문 페이지를 Markdown으로 변환하는 모습으로 소개됩니다. QbitAI는 이 시연이 30초 이내에 완료되었다고 보고합니다.
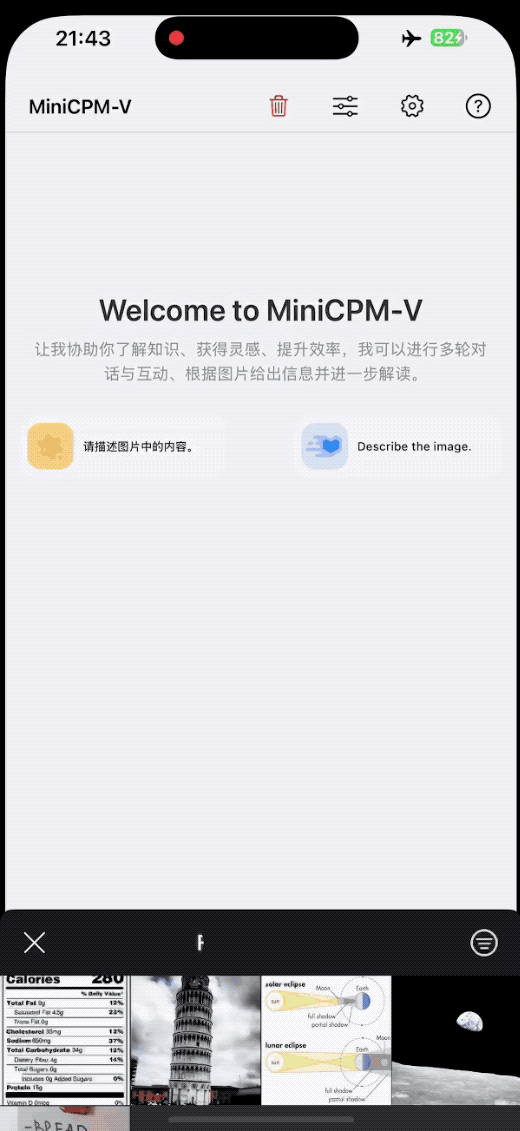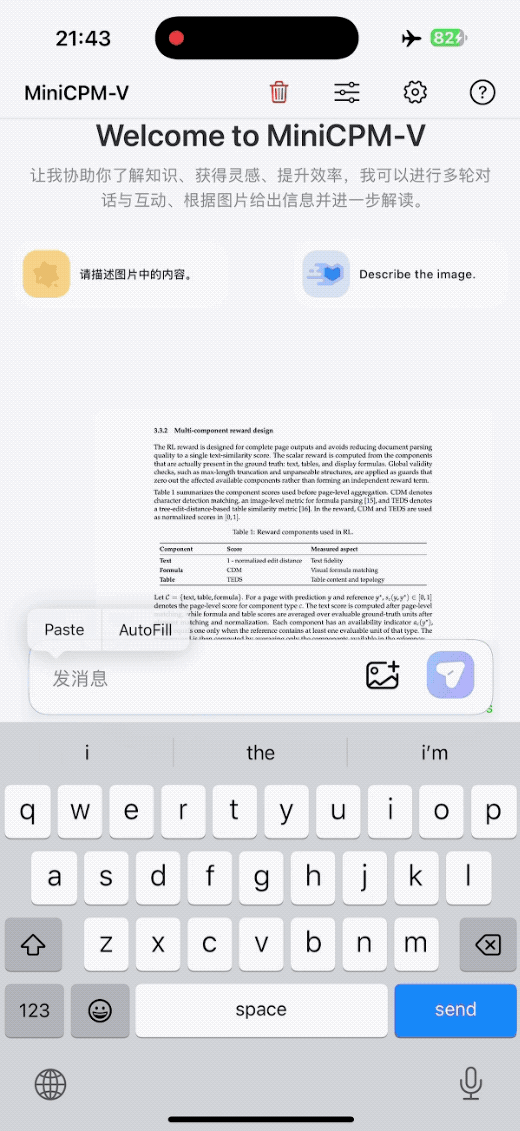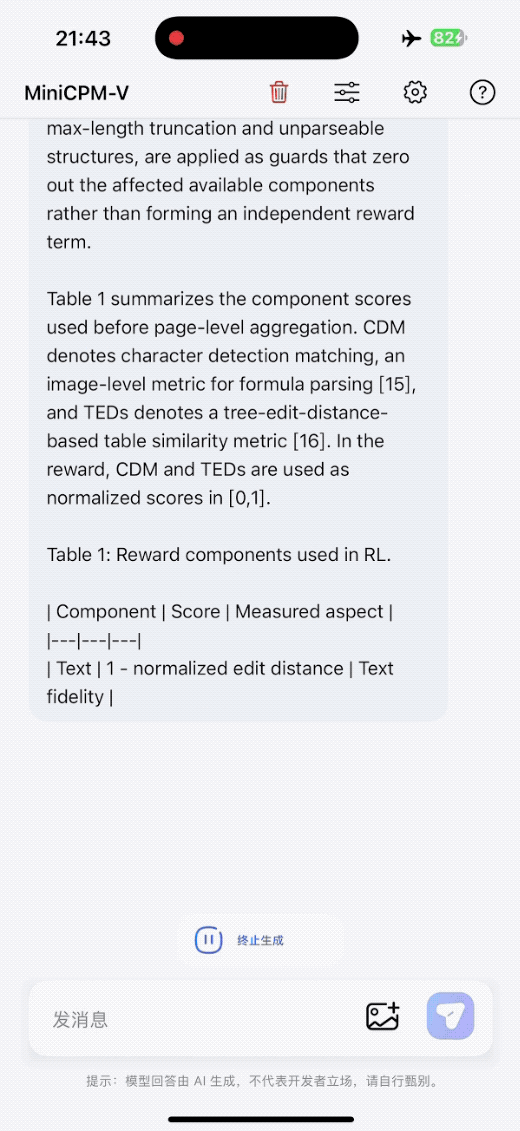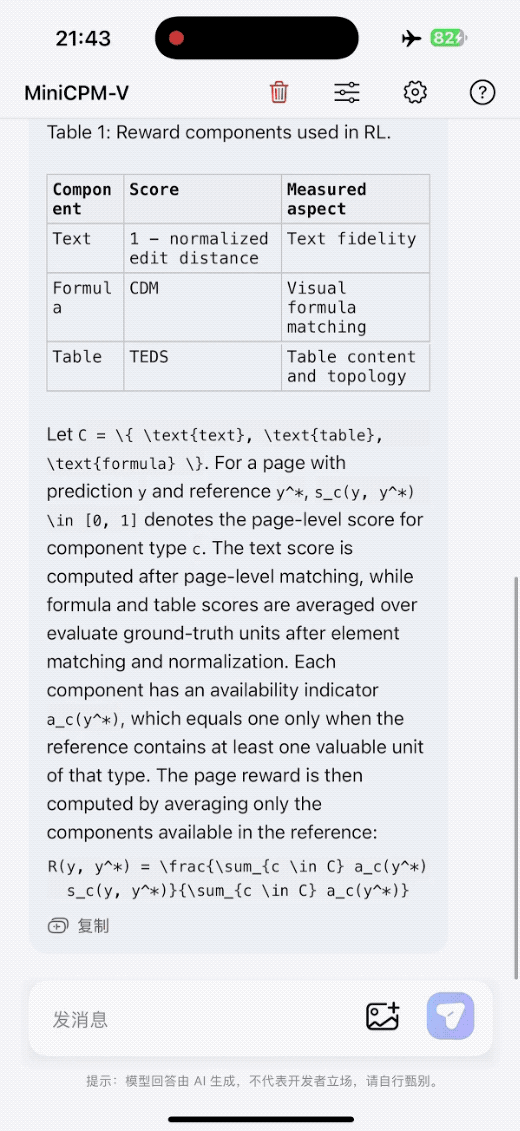
출처: BAAI를 통한 QbitAI, 애니메이션 로컬 문서 시연.
별도의 API 테스트에서 이 글은 ¥86.40에서 ¥8 할인을 뺀 계산이 ¥78.40 결제와 일치한다고 보고합니다. 또한 90분 주차를 청소 제한, 2시간 제한, 거주자 면제 및 재진입 조건과 대조하는 주차 규칙 작업도 설명합니다. 이는 체계적인 정확도 연구가 아니라 예시 테스트입니다.
관련 릴리스는 맞춤화 중 발생하는 망각을 다룹니다. Self-Replay Fine-Tuning은 원래 모델에서 일반 도메인 응답을 생성하고, 품질에 따라 필터링한 뒤, 유지된 예시를 새 작업 데이터와 표준 지도 미세 조정 과정에서 혼합합니다.
이 방법은 모델 아키텍처나 손실 함수가 아니라 학습 데이터를 변경합니다. 리플레이 예시는 학습 전에 생성하여 재사용할 수 있으므로, 매 실행마다 새 온라인 롤아웃이 필요하지 않습니다.
OpenBMB의 게시물은 초기 MiniCPM 모델과 다른 모델 계열에 대한 테스트를 포함해, 카운팅 및 문서 OCR 실험에서 고무적인 유지 결과를 보고합니다. 이러한 결과를 모든 4.7 미세 조정에 대한 포괄적 보장으로 제시해서는 안 됩니다. 프롬프트 범위, 필터링 품질 및 작업 대 리플레이 비율은 여전히 실험적 선택 사항입니다.
모바일 앱 리포지토리는 iOS, Android 및 HarmonyOS 데모를 제공합니다. 휴대폰 MoE 경로에서 앱 내 모델 관리자는 일치하는 메인 파일, 비주얼 프로젝터 및 전문가 샤드를 다운로드합니다. 리포지토리는 일반적인 분할되지 않은 데스크톱 GGUF 파일이 이 모바일 패키지와 호환되지 않는다고 경고합니다.
다른 배포를 위해 4.7 가이드는 SGLang, vLLM, llama.cpp, Ollama를 나열하며, 미세 조정을 위해 SWIFT와 LLaMA-Factory도 제공합니다. GGUF, BNB, AWQ, GPTQ 및 FP8을 포함한 양자화 옵션으로 연결됩니다. 지원되는 모든 형식을 바로 사용할 수 있는 모바일 모델로 취급하기보다, 의도한 런타임에 맞는 아티팩트를 선택해야 합니다.
필요한 앱과 모델 파일이 로컬에 존재하면 오프라인 추론이 시작됩니다. 이는 각 추론 요청을 클라우드 모델로 보낼 필요를 없애지만, 앱 권한, 로컬 데이터 처리, 스토리지 및 하드웨어 성능은 여전히 실질적인 배포 고려 사항입니다.
이는 ModelBest와 OpenBMB의 멀티모달 모델 릴리스로, 35B-A3B MoE와 소형 1B 변형을 제공합니다. 이미지, 문서, 다중 이미지 및 동영상과 관련된 작업을 지원합니다.
프로젝트는 iPhone 17 Pro Max에서 최적화된 35B-A3B 배포를 시연합니다. 모든 35B 매개변수를 한 번에 RAM에 로드하는 대신, 로컬 스토리지에서 전문가를 스트리밍하며 더 작은 작업 세트를 메모리에 유지합니다.
아닙니다. 공식 모바일 데모는 35B-A3B 패키지에 약 16.6GB의 전체 다운로드가 필요하다고 명시하고 약 17GB의 여유 스토리지를 권장합니다. 검증된 iPhone은 기기 RAM 12GB를 탑재했습니다.
아닙니다. LES는 미리 가져올 전문가를 예측하고 이미 사용할 수 있는 전문가를 먼저 스케줄링합니다. 모델의 실제 라우터는 예측이 놓친 전문가를 포함해 계산할 전문가를 계속 선택합니다.
예. 필요한 파일을 다운로드하거나 설치한 후 로컬 데모는 기기에서 추론을 수행합니다. 출처의 API 예시는 별도 테스트이며 오프라인 동작과 혼동해서는 안 됩니다.
아닙니다. 이 데모에는 -les 메인 파일, 비주얼 프로젝터 및 전문가 샤드가 포함된 일치하는 분할 패키지가 필요합니다. 앱 문서는 표준 전체 모델 GGUF 파일이 동일한 휴대폰 배포 동작을 제공하지 못하는 이유를 설명합니다.
MiniCPM-V 4.7은 희소 연산을 전문가 스트리밍, 룩어헤드 스케줄링, 양자화 및 시각 압축과 결합하여, 더 큰 멀티모달 모델을 일부 선택된 로컬 기기에서 실용적으로 만듭니다. 시연은 차트 해석, 문서 변환 및 일상 계산을 다루며, 공개된 벤치마크는 평가의 출발점을 제공합니다.
핵심 배포 제약은 작업 메모리, 전체 기기 RAM 및 저장된 가중치의 차이입니다. 휴대폰 결과는 특정 최적화 구성에서는 신뢰할 수 있지만, 완전한 35B 모델이 3GB에 들어가거나 모든 기기에서 동일하게 잘 실행된다는 약속은 아닙니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.