For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/muse-wonder-benchmarks-coding-results-lim-2cf7d1eb.md.
Meta의 Muse Wonder 출시는 강력한 벤치마크 결과와 때로는 훨씬 덜 설득력 있었던 개발자 데모라는 두 종류의 매우 다른 근거를 제시했습니다. BAAI Hub에 재게시된 Xinzhiyuan의 중국어 보도는 이 격차를 벤치마크 중심 최적화에 대...
Meta의 Muse Wonder 출시는 강력한 벤치마크 결과와 때로는 훨씬 덜 설득력 있었던 개발자 데모라는 두 종류의 매우 다른 근거를 제시했습니다. BAAI Hub에 재게시된 Xinzhiyuan의 중국어 보도는 이 격차를 벤치마크 중심 최적화에 대한 강도 높은 비판으로 발전시켰습니다.
이견은 면밀히 검토할 가치가 있지만, 부진한 데모가 부정행위를 입증하는 것은 아닙니다. 공정하게 해석하려면 정확한 모델 변형, 테스트된 작업, 모델을 둘러싼 에이전트 소프트웨어, 그리고 각 결과의 출처를 확인해야 합니다.
원문은 개발자들이 브라우저 또는 3D 게임 결과물을 비교하면서 Wonder가 경쟁 모델들에 비해 실망스럽다고 평가한 사례를 설명합니다. 이러한 데모는 쉽게 검토할 수 있습니다. 시청자는 움직임이 작동하는지, 카메라가 합리적으로 동작하는지, 장면이 요청한 결과와 유사한지를 직접 볼 수 있기 때문입니다.
원문은 Meta의 Alexandr Wang이 팀이 3D 데모 게임을 위해 명시적으로 학습하지는 않았으며, 개발자들에게 실제 코딩 작업을 시도해 보라고 권장했다고 인용합니다. 이는 Xinzhiyuan이 보도한 내용이며, 실패한 모든 코딩 작업을 포괄적으로 설명하는 근거가 되어서는 안 됩니다.
게임 데모는 여전히 관련성 있는 근거입니다. 코드 생성, 시각적 판단, 상호작용, 디버깅의 실제 조합을 시험하기 때문입니다. 다만 범위에는 한계가 있습니다. 하나의 프롬프트와 한 번의 실행만으로 리포지토리 유지보수, 터미널 작업 또는 장기간의 소프트웨어 프로젝트 전반에 걸친 성능을 확정할 수는 없습니다.
Meta의 공식 발표는 개인 및 전문 에이전트를 위한 모델로 Muse Wonder와 Muse Wonder Full을 소개합니다. Wonder는 Meta Model API와 Muse Code를 통해 제공되며, Full은 Muse Code 구독자에게 제공됩니다.
이 발표는 Active Memory를 대화 전반에서 중요한 맥락을 유지하고 관련 시점에 이를 검색하는 기능으로 정의합니다. Active Focus는 대안을 시도하고, 새로운 정보에 적응하며, 명확화가 필요할 때 질문하고, 중요한 작업 전에 확인하는 것을 포함해 목표를 향해 지속적으로 진전하는 능력을 설명합니다.
이러한 설명은 Meta가 무엇을 개선하려는지 이해하는 데 도움이 됩니다. 그러나 이는 제품 및 평가에 관한 주장이지, 에이전트가 할당된 모든 작업을 완료한다는 보장은 아닙니다.
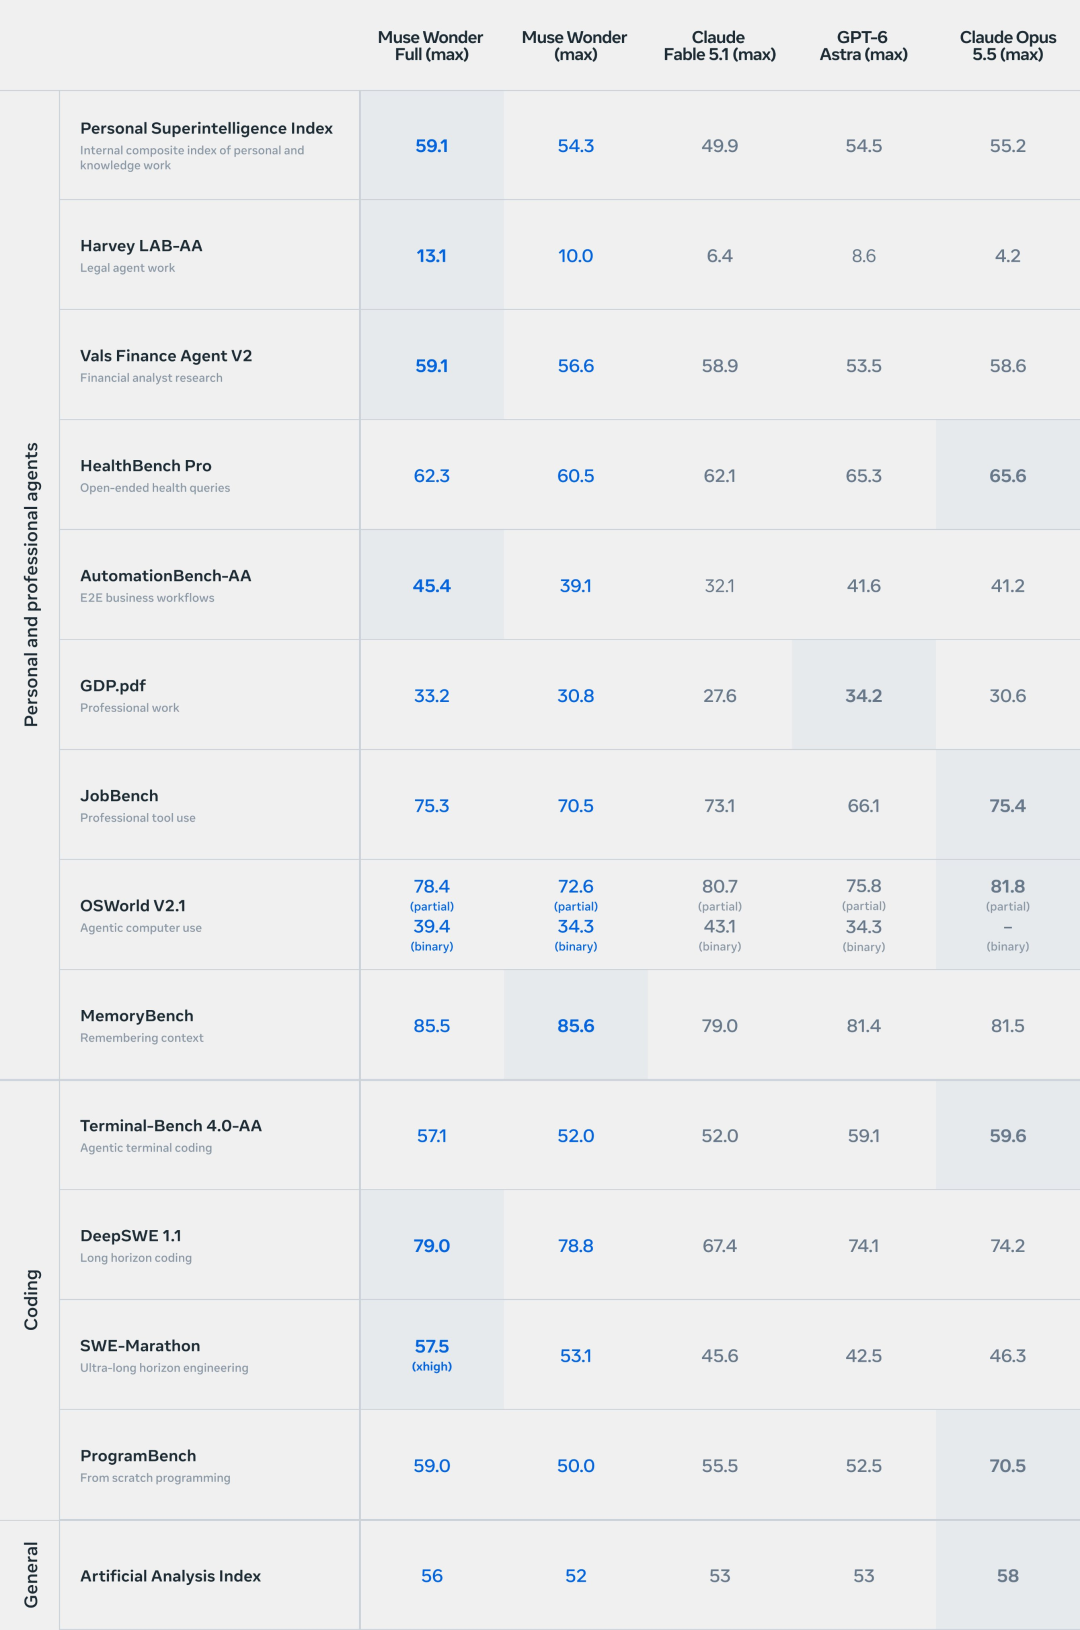
Xinzhiyuan이 BAAI Hub에서 재현한 Meta의 공개 비교 표입니다. 수치는 출시 자료에 제시된 구성과 평가 조건에 해당합니다.
이 표는 보편적인 승자를 보여 주지 않습니다. 코딩 결과는 작업별로 상당한 차이를 보입니다.
| 평가 | Muse Wonder Full | Claude Opus 5.5 | 비교 방향 |
|---|---|---|---|
| DeepSWE 1.1 | 79.0 | 74.2 | Full의 점수가 더 높음 |
| SWE-Marathon | 57.5 | 46.3 | 보고된 설정에서 Full의 점수가 더 높음 |
| Terminal-Bench 4.0-AA | 57.1 | 59.6 | Opus의 점수가 더 높음 |
| ProgramBench | 59.0 | 70.5 | Opus의 점수가 더 높음 |
Meta의 부속 자료는 메모리 및 에이전트 워크플로에서의 강점과 다른 모델이 앞서는 영역을 함께 보고합니다. 장기 실행 소프트웨어 작업에서 강력한 결과가 존재한다고 해서 처음부터 애플리케이션을 생성하는 작업에서도 최고 성능을 의미하지는 않습니다.
SWE-Marathon에서는 평가 조건이 특히 중요합니다. Meta의 모델 카드는 경쟁 모델들이 Codex와 Claude Code를 통해 실행된다고 설명하는 한편, Wonder Full의 강조된 결과에는 xhigh 구성이 사용됩니다. 이는 의미 있는 제품 수준의 결과이지만, 모든 모델에 동일한 에이전트 하니스를 적용한 단일 통제 실험은 아닙니다.
Meta의 출시 블로그는 익숙한 벤치마크와 낯선 작업 사이의 격차를 명시적으로 다룹니다. 이 분석은 테스트 시점 연산량이 증가할 때 분포 내 및 분포 외 성능을 비교하며, Wonder Full의 더 강력한 기본 모델이 사후 학습의 이득이 다른 작업으로 전이되는 방식을 개선한다고 주장합니다.
이는 Meta의 입장과 관련된 기술적 근거입니다. 그러나 모델 개발사가 선택하고 제시한 평가이며, 개발자 결과물에 관한 모든 불만을 해결하지는 못합니다.
마찬가지로, 실망스러운 게임 데모에 대한 보고는 벤치마크 오염이나 조작을 입증하지 않습니다. 그러한 주장을 입증하려면 원문이 제공하는 것보다 데이터, 방법론 또는 조작된 결과에 관한 더 직접적인 증거가 필요합니다.
Artificial Analysis의 독립 보도에 따르면, 최대 추론 노력에서 Intelligence Index v4.3 점수는 Wonder Full이 56, Wonder가 52입니다. 따라서 일반 Wonder를 테스트하는 API 사용자는 여러 차트에서 핵심으로 제시된 Full 모델과는 다른 출시 제품을 평가하는 것입니다.
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
Artificial Analysis는 각 변형 모델에 대해 100만 토큰 컨텍스트 윈도우를 명시합니다. Wonder의 경우 입력 토큰 100만 개당 4달러, 캐시된 입력 토큰 100만 개당 0.20달러, 출력 토큰 100만 개당 20달러를 보고합니다. Intelligence Index 작업당 4.52달러라는 추정치는 평가에 특화된 비용일 뿐, 모든 사용자 요청에 적용되는 고정 가격은 아닙니다.
원문은 공개 오픈 웨이트 릴리스가 없다는 점도 비판합니다. 확인한 출시 발표 및 접근 설명 어디에도 다운로드 가능한 Wonder 가중치 릴리스는 제공되지 않으므로, 개발자는 로컬 자체 호스팅이 가능하다고 가정해서는 안 됩니다.
Meta는 Wonder가 기가와트 규모의 Prometheus 데이터 센터에서 학습되었다고 말합니다. BAAI 기사는 이번 출시를 AI 인프라 투자 규모와 상거래에서 개인 에이전트의 역할에 관한 Mark Zuckerberg 및 Wang의 발언과 연결합니다.
이러한 발언은 더 넓은 전략을 설명합니다. 이를 이 특정 모델의 검증된 학습 비용 수치로 전환해서는 안 됩니다. 마찬가지로, 에이전트가 서비스를 협상하거나 구매하는 사례는 제품 행동에 대한 비전이지, 그러한 모든 워크플로가 배포되었다는 증거는 아닙니다.
다음으로 유용한 단계는 반복 가능한 테스트입니다. 요구사항을 일정하게 유지하고, 변형 모델과 추론 설정을 식별하며, 환경을 문서화하고, 완료된 작업을 측정해야 합니다. 이는 하나의 헤드라인 점수나 하나의 눈에 띄는 실패보다 강점과 약점을 더 신뢰성 있게 드러낼 수 있습니다.
아니요. 이는 시연된 작업에서의 낮은 성능을 보여 줄 수 있지만, 벤치마크 부정행위를 입증하려면 평가 방식, 데이터 또는 조작된 결과에 관한 별도의 증거가 필요합니다.
두 모델은 서로 다른 출시 접근 경로를 가진 모델 패밀리 내의 별도 제품입니다. Artificial Analysis는 Intelligence Index v4.3에서 최대 추론 노력 기준 Wonder 52, Full 56을 보고합니다.
인용된 표는 코딩 평가마다 다른 답을 제시합니다. Full은 DeepSWE 1.1과 보고된 SWE-Marathon 설정에서 앞서지만, Opus는 Terminal-Bench 4.0-AA와 ProgramBench에서 앞섭니다.
설정에 관한 단서를 붙여야만 가능합니다. Meta의 모델 카드는 경쟁 모델들이 각자의 코딩 제품을 사용한다고 설명하므로, 기본 모델 자체뿐 아니라 에이전트 동작과 도구의 차이도 결과에 영향을 줄 수 있습니다.
Artificial Analysis의 출시 보도는 입력 토큰 100만 개당 4달러, 캐시된 입력 토큰 100만 개당 0.20달러, 출력 토큰 100만 개당 20달러를 보고합니다. 프로덕션 사용을 결정하기 전에 현재 제공업체의 과금 조건을 확인해야 합니다.
확인한 출시 자료에서는 공개 가중치 다운로드가 확인되지 않았습니다. 문서화된 접근 경로는 Wonder의 경우 API 및 Muse Code이며, Full은 Muse Code 구독을 통한 접근입니다.
Muse Wonder의 출시 결과는 강력한 에이전트 및 소프트웨어 엔지니어링 점수, 코딩 범주별로 고르지 않은 결과, 그리고 일반 변형과 Full 변형 간의 서로 다른 접근 경로를 가진 모델 패밀리를 보여 줍니다.
유용한 결론은 작업별로 판단해야 한다는 것입니다. 보편적인 승리 주장이나 부정행위 비난을 받아들이기 전에 정확한 모델을 확인하고 완료된 작업을 테스트해야 합니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.