For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/recursive-self-improvement-what-ai-resear-557e0db8.md.
AI 시스템은 소프트웨어 작성, 인프라 디버깅, 실험 수행, 다음 시도 제안 등 AI를 구축하는 데 필요한 업무를 더 많이 맡고 있습니다. 이 때문에 일반적으로 **RSI**로 줄여 부르는 **재귀적 자기개선**은 점점 더 현실적인 연구 질문이 되고 ...
AI 시스템은 소프트웨어 작성, 인프라 디버깅, 실험 수행, 다음 시도 제안 등 AI를 구축하는 데 필요한 업무를 더 많이 맡고 있습니다. 이 때문에 일반적으로 RSI로 줄여 부르는 재귀적 자기개선은 점점 더 현실적인 연구 질문이 되고 있습니다.
중요한 구분은 AI가 인간이 주도하는 과정을 가속하는지, 아니면 더 강력한 후속 모델을 독립적으로 설계하고 개발할 수 있는지입니다. 제공된 BAAI 보고서는 업계가 후자를 향해 나아가고 있다고 설명합니다. 공개 연구는 전자에 대한 구체적 증거를 제공하는 한편, 그러한 진전이 어디까지 갈지에 대해서는 상당한 불확실성이 남아 있습니다.
Anthropic의 연구 논의에 따르면, 완전한 RSI는 시스템이 자신의 후속 모델을 자율적으로 설계하고 개발할 수 있게 되는 것을 의미합니다. 훈련 스크립트를 개선하는 코딩 에이전트는 이 과정에 기여할 수 있지만 전체 순환을 완성하는 것은 아닙니다.
여기에는 여러 가지 구별되는 역량이 포함됩니다.
한 단계에서의 성공이 이후 모든 단계에서의 성공을 입증하지는 않습니다. Anthropic은 자사의 설명에서 완전한 RSI가 아직 달성되지 않았으며, 그것이 필연적인 것도 아니라고 명시합니다.
Anthropic은 2026년 5월 기준으로 Claude가 자사 코드베이스에 병합된 코드의 80% 이상을 작성했다고 보고합니다. 이는 병합된 코드에 대한 기여도 측정이며, AI가 모든 엔지니어링 의사결정의 80% 이상을 내렸다는 주장은 아닙니다.
또한 이 회사는 2026년 2분기의 엔지니어 1인당 일반적인 코드 산출량이 2024년 수준의 약 8배였으며, 이는 일일 병합 코드 라인 수로 측정했다고 보고합니다. 회사가 직접 제시한 단서가 중요합니다. 코드 라인 수는 양을 불완전하게 측정하므로, 이를 유용한 생산성이 8배 증가했다는 의미로 해석해서는 안 됩니다.
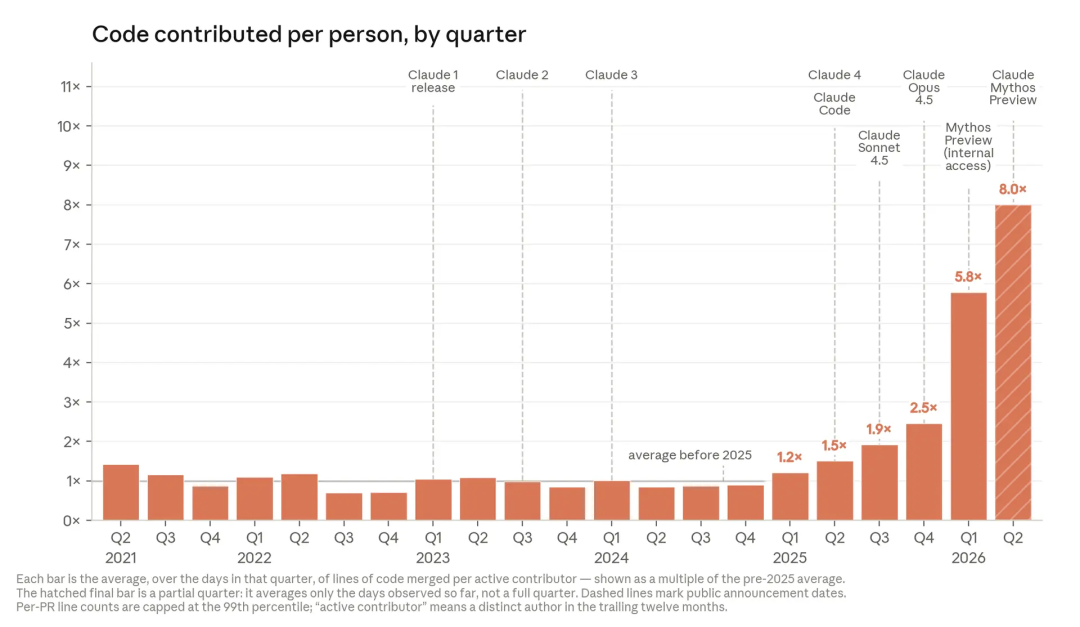
BAAI Hub의 Xinzhiyuan 기사에 재현된 Anthropic 차트.
실질적인 변화는 엔지니어가 모든 구현을 직접 타이핑하지 않고도 더 많은 업무를 지시하고 검토할 수 있게 되었다는 점입니다. 그러나 목표 설정, 코드 품질, 공유 인프라, 검토 역량은 여전히 제약 조건으로 남습니다. 이는 인간 검토가 더 이상 필요 없게 되었다는 것을 입증하지 않습니다.
구현을 작성하는 일은 연구의 일부일 뿐입니다. 에이전트는 또한 실험을 실행하고, 결과를 검토하며, 변경이 실제로 도움이 되었는지 판단해야 합니다.
Anthropic은 모델이 훈련 코드를 받아 정확성 검사를 유지하면서 더 빠르게 만들려 시도하는 반복 최적화 테스트를 설명합니다. 모델 세대가 발전함에 따라 결과는 뚜렷하게 개선되었습니다. 회사는 절대적인 속도 향상 폭이 초기 코드에 얼마나 많은 최적화 여지가 있는지에 따라 달라진다고 경고합니다. 이는 프런티어 모델 훈련에서 동등한 속도 향상을 측정한 것은 아닙니다.
Anthropic의 자동화된 약한 모델에서 강한 모델로의 연구 프로젝트는 또 다른 사례를 제공합니다. 에이전트는 인간이 선택한 문제와 채점 프레임워크 내에서 실험을 제안하고 실행할 수 있었습니다. 이는 지정된 경계 안에서 이뤄진 연구 자동화의 증거이지, 시스템이 가장 가치 있는 연구 의제를 독립적으로 선택했다는 실증은 아닙니다.
SWE-bench는 리포지터리 작업과 테스트를 기준으로 소프트웨어 변경을 평가합니다. METR의 과업 완료 시간 지평은 모델이 지정된 신뢰도 수준에서 완료할 수 있는 과업의 길이를 검토합니다.
이 측정들은 서로 다른 질문에 답합니다. 시스템은 리포지터리 이슈를 수정하거나 더 긴 과업을 완료하는 능력이 향상될 수 있지만, 그렇다고 해서 스스로 성공적인 모델 개발 프로그램을 계획할 수 있다는 뜻은 아닙니다.
시간 지평 결과 역시 확률적입니다. 벤치마크에서의 과업 지속 시간은 에이전트가 어떤 프로젝트에서든 그만큼의 실제 시간 동안 신뢰성 있게 작업할 수 있다는 의미가 아닙니다. 인간 기준선, 성공 임계값, 도구 접근성, 과업 분포가 모두 중요합니다.
원문 기사는 내부 에이전트, 짧아진 출시 주기, 미공개 모델, 대규모 과학적 산출물에 관한 소셜 미디어 논의를 인용합니다. 이러한 언급은 조사할 가치가 있는 주제를 가리킬 수는 있지만, 자율적 자기개선 순환을 독립적으로 입증하지는 않습니다.
짧은 출시 간격에는 여러 설명이 있을 수 있습니다. 모델이 어려운 수학 문제를 푼다는 것은 해당 문제들에 대한 역량을 보여주지만, 그 자체로 모델이 자신의 훈련 과정을 개선했다는 증거는 아닙니다. 마찬가지로, 한 연구소의 내부 모델에 관한 익명 주장은 재현 가능한 증거를 담은 기술 보고서를 대체할 수 없습니다.
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
방어 가능한 결론은 더 제한적입니다. 공개 자료는 AI가 엔지니어링과 일부 실험 연구에서 점점 더 큰 비중을 수행하고 있음을 보여줍니다. 이러한 진전이 완전한 RSI로 이어질지는 여전히 열린 질문입니다.
Anthropic은 점점 더 자동화되는 개발이 제공할 잠재적 이점과 위험을 모두 논의합니다. 더 유능한 연구 에이전트는 과학 연구를 가속할 수 있지만, 검증, 모니터링, 정렬을 더 까다롭게 만들 수도 있습니다.
동일한 과정은 일반적인 운영 병목도 만들 수 있습니다. 에이전트가 사람들이 검토할 수 있는 속도보다 더 빠르게 코드를 생성한다면, 더 빠른 생성이 곧바로 더 빠르고 신뢰할 수 있는 배포로 이어지지는 않습니다. 구현 비용이 낮아져도 컴퓨팅 자원 가용성, 실험 품질, 무엇을 구축할지에 관한 결정은 여전히 중요합니다.
따라서 RSI 평가는 각 단계의 증거를 추적해야 합니다. 에이전트가 무엇을 했는지, 누가 목표를 선택했는지, 어떤 자원을 사용했는지, 그리고 결과를 어떻게 검증했는지를 확인해야 합니다.
RSI는 재귀적 자기개선을 의미합니다. 이 맥락에서는 AI 시스템이 단순히 인간의 소프트웨어 개선을 돕는 데 그치지 않고, 더 강력한 후속 모델을 자율적으로 설계하고 개발할 수 있게 되는 것을 뜻합니다.
코드 생성은 개발 프로세스의 일부가 자동화될 수 있음을 보여줍니다. 완전한 RSI에는 연구 방향 설정, 구현, 훈련, 평가를 아우르는 훨씬 광범위한 결합이 필요하므로, AI가 작성한 코드의 비중이 높다는 것만으로는 충분한 증거가 아닙니다.
이는 2026년 5월 기준으로 Anthropic의 코드베이스에 병합된 Claude 기여 코드의 비중을 의미합니다. 이를 회사의 모든 업무가 자율적으로 수행된 비율이나 AI가 내린 전략적 의사결정의 비율로 해석해서는 안 됩니다.
코드 라인 수는 산출량 변화의 지표가 될 수 있지만, 유용성, 유지보수성, 비즈니스 가치를 직접 측정하지는 않습니다. Anthropic도 자체적으로 보고한 8배의 코드 산출량 증가가 실제 생산성 향상을 과대평가할 가능성이 있다고 경고합니다.
이는 인간의 과업 소요 시간을 기준으로 삼아, 명시된 성공 수준에서 특정 과업 모음에 대한 성능을 설명합니다. 이는 에이전트가 현실의 동일한 길이를 가진 모든 과제를 완료할 수 있음을 보장하지는 않습니다.
그렇습니다. 에이전트는 인간이 제공한 문제 및 채점 프레임워크 내에서 실험을 설계하고 실행할 수 있습니다. 이는 상위 수준의 의사결정을 사람이 맡는 가운데서도 가치 있는 연구 자동화가 될 수 있습니다.
Anthropic의 주요 논의는 이것이 필연적이지 않다고 명시합니다. 연구 판단, 컴퓨팅 자원, 인프라, 평가 및 기타 병목이 궤적을 제한하거나 바꿀 수 있으며, 예측은 입증된 결과와 구분되어야 합니다.
공개 증거는 AI 보조 코딩과 범위가 제한된 연구 자동화가 크게 증가했음을 뒷받침합니다. 이러한 발전은 재귀적 자기개선의 가능성을 검토할 가치가 있게 만들지만, 완전히 자율적인 후속 모델 개발 순환이 이미 존재한다는 것을 입증하지는 않습니다.
핵심 질문은 시스템이 개발의 어떤 부분을 독립적으로 수행하고 검증할 수 있는지이며, 출시 일정이나 헤드라인 벤치마크가 얼마나 극적으로 보이는지가 아닙니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.



