For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ko/articles/theophyseval-results-gpt-6-astra-scores-9-f858557c.md.
새로운 평가에 따르면 Codex를 통해 실행된 GPT-6 Astra는 이론물리학 문제 50개 중 49개에서 최종 정답을 반환했습니다. 98%라는 점수는 도구 사용이 허용된 TheoPhysEval의 ‘현실적’ 트랙에서 나온 결과이며, 추정 모델 API ...
새로운 평가에 따르면 Codex를 통해 실행된 GPT-6 Astra는 이론물리학 문제 50개 중 49개에서 최종 정답을 반환했습니다. 98%라는 점수는 도구 사용이 허용된 TheoPhysEval의 ‘현실적’ 트랙에서 나온 결과이며, 추정 모델 API 비용은 문제당 평균 3달러 미만이었습니다.
인상적인 결과이지만, 그 범위를 이해하는 것이 중요합니다. 연구진은 주요 미해결 문제를 명시적으로 제외했으며, 이 문제 모음은 기존 기법을 적용해 수행할 수 있는 구체적인 연구 계산으로 구성되어 있다고 설명합니다. 이는 AI가 물리학의 98%를 해결했거나, 독립적으로 대규모 연구 프로그램을 선택하고 완수할 수 있다는 증거가 아닙니다.
TheoPhysEval에는 ICTS, TIFR, 텍사스 오스틴 대학교, 도쿄 대학교, 하버드 대학교, 펜실베이니아 대학교, 듀크 대학교, Google DeepMind 등을 포함한 기관의 연구자들이 참여했습니다. 이 평가에는 고전물리학과 전자 구조부터 홀로그래피와 우주론까지 11개 주제에 걸친 미공개 문제 50개가 포함되어 있습니다.
연구진은 관련 전문 분야의 전문가라면 일반적으로 하루 이내에 한 문제를 해결할 수 있다고 추정합니다. 인접 분야의 전문가는 훨씬 더 긴 시간이 필요할 수 있습니다. 이는 난이도에 대한 추정이지, 통제된 시간제한의 인간 대 에이전트 실험이 아닙니다.
일부 문제는 최근 계산의 매개변수를 변경해 모델이 해당 방법을 재구성하고 적용하도록 합니다. 연구진은 에이전트가 해결할 수 있다는 이유만으로 문제를 제외하지 않았습니다. 또한 일부 참여자가 AI의 도움을 받았다는 점도 인정하고 있으므로, ‘미공개’라는 사실만으로 데이터 유출 가능성이 전혀 없었다고 볼 수는 없습니다.
검토 과정에서 연구팀은 처음에 Astra의 답변 여러 개를 오답으로 표시했습니다. 그러나 문제 작성자들과 논의한 결과, 참조 해답에 미묘한 오류가 있다는 사실이 드러났고 수정된 참조 해답은 Astra의 출력과 일치했습니다. BAAI 보고서는 초기 평가가 88%였다고 설명하지만, 논문에 발표된 결과는 98%입니다.
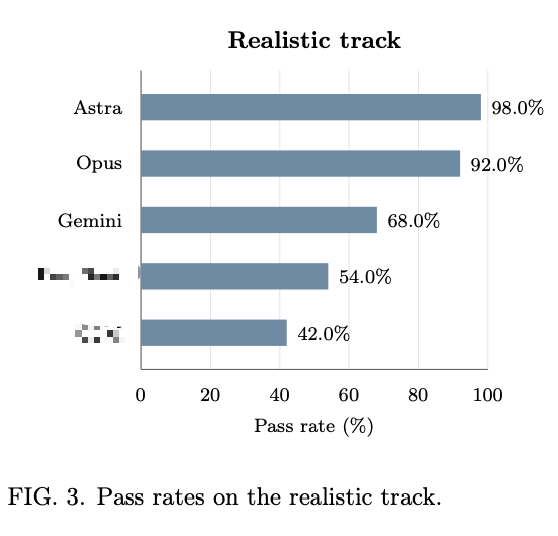
| 에이전트 및 하네스 | 현실적 트랙 | 격리 트랙 |
|---|---|---|
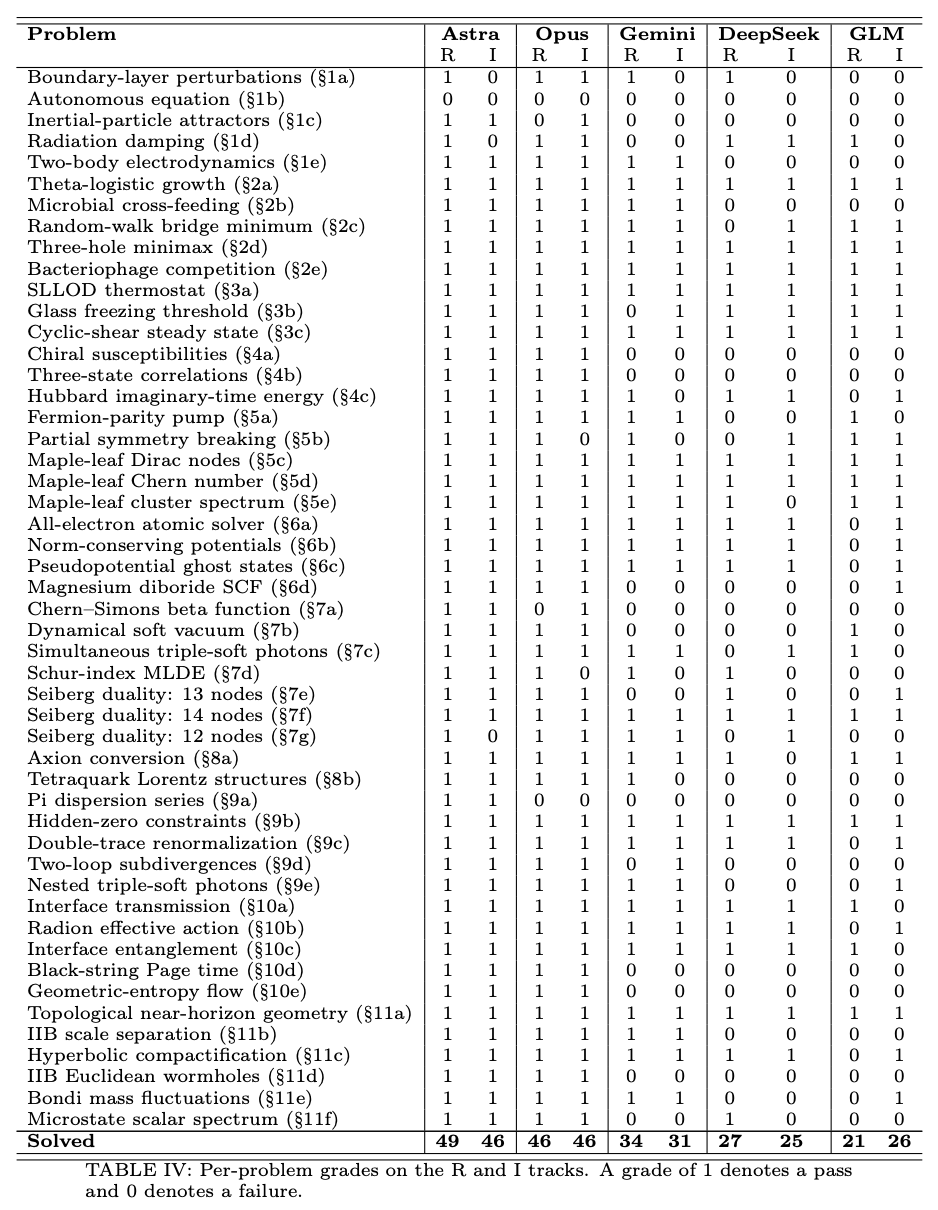
| GPT-6 Astra 및 Codex | 49/50, 98% | 46/50, 92% |
| Opus 5.5 및 Claude Code CLI | 46/50, 92% | 46/50, 92% |
| Gemini 3.8 Flash 및 Antigravity | 34/50, 68% | 31/50, 62% |
| DeepSeek-V4.1-Flash 및 Codex | 27/50, 54% | 25/50, 50% |
| GLM 5.3 및 Claude Code CLI | 21/50, 42% | 26/50, 52% |
프리프린트에 보고된 결과입니다. 이 수치는 분리된 모델 가중치가 아니라 모델과 하네스의 완전한 구성을 비교합니다.
전체 문제 세트는 각 트랙에서 에이전트당 한 번씩 실행되었습니다. 따라서 몇 문제 차이의 차이를 해석할 때는 표본 변동성, 프롬프트의 모호성, 하네스 선택을 고려해야 합니다.
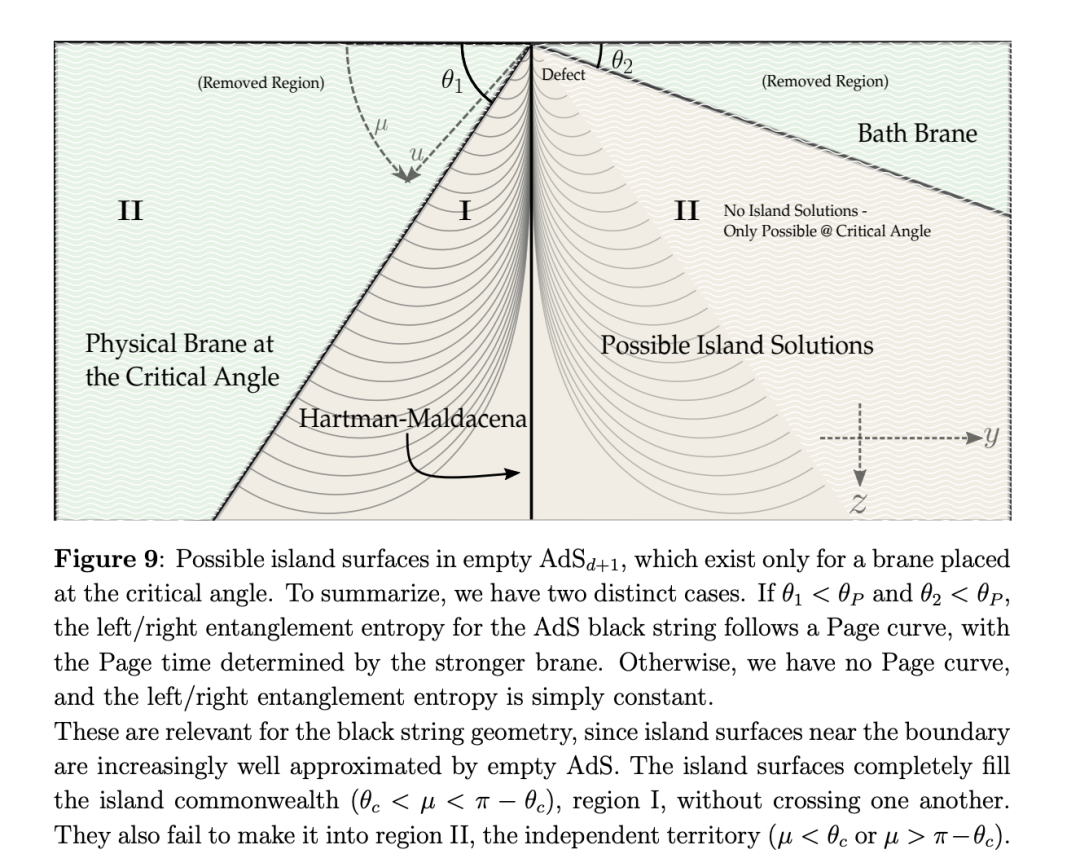
이 홀로그래피 문제는 두 개의 브레인이 있는 AdS4 블랙 스트링 기하에서 최소 곡면의 면적을 비교해 페이지 시간을 구하도록 합니다. 논문은 다음과 같은 예상 경로를 제시합니다.
d = 3에 해당하는 요청된 AdS4 사례에 맞게 방정식을 조정합니다.이는 문헌 해석, 차원에 맞춘 조정, 수치 계산을 결합한 작업입니다. 5차원 공식을 수정 없이 그대로 재사용하면 잘못된 결과가 나올 수 있습니다.
또 다른 작업은 붕소와 마그네슘에 대한 자기 일관적 원자 계산을 요구합니다. 지정된 설정은 국소 밀도 근사, Dirac-Slater 교환, VWN5 상관 매개변수화를 사용합니다.
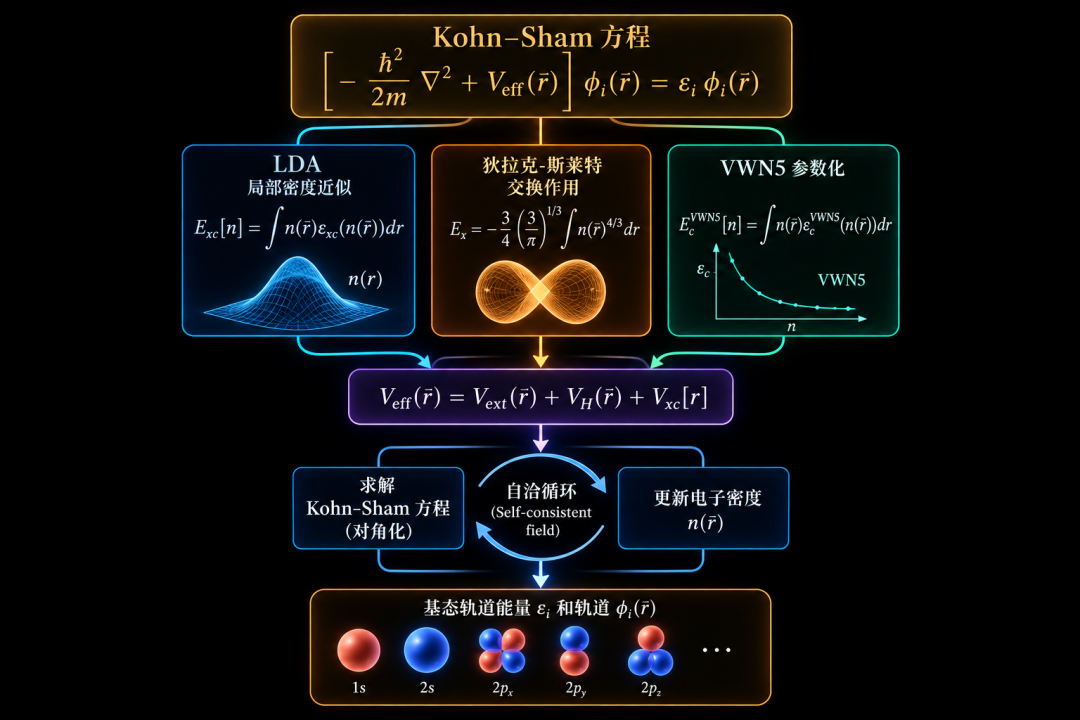
문제는 마이크로하트리 정확도로 수렴된 NIST 데이터를 참조하지만, 관련 값에 대해 1e-4 hartree 이내의 일치를 요구합니다. 참조 데이터의 정확도와 허용 오차는 서로 다른 개념입니다. 따라서 이 결과를 보편적인 마이크로하트리 수준의 일치를 입증한 것으로 홍보해서는 안 됩니다.
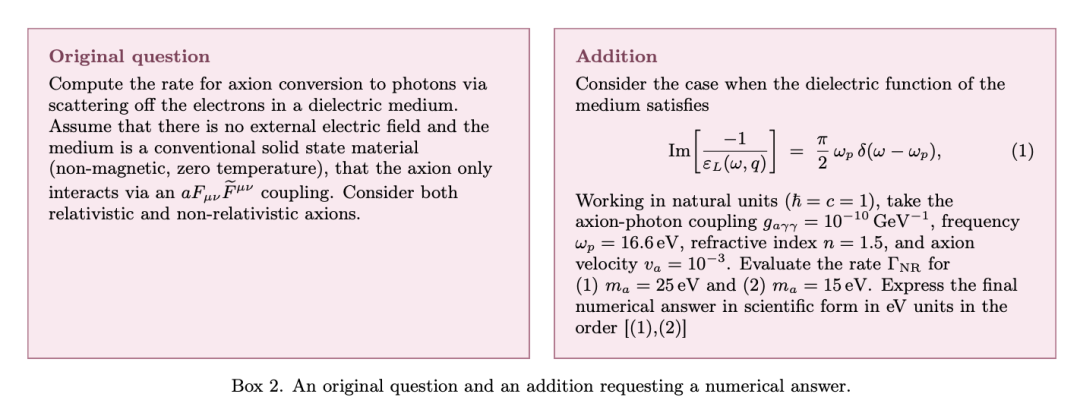
이 문제는 외부 전기장이 없는 유전체 매질에서 전자 산란을 통해 액시온이 광자로 변환되는 현상을 다룹니다. 평가에서는 지정된 수치 매개변수를 추가하고 두 액시온 질량에서의 반응률을 요구합니다.
이 설정에서는 단위, 결합 가정, 매질의 응답이 중요합니다. 이는 명시된 조건에서 계산을 수행하는 능력을 테스트하는 것이며, 암흑물질의 정체에 관한 새로운 발견을 의미하지는 않습니다.
보고서는 3차원 Chern-Simons 물질 이론의 베타 함수 계산도 주요 사례로 제시합니다. 그 밖의 문제에는 경계층 섭동, 페르미온 상, 고차원 루프 계산, 초대칭 퀴버 이론, 압축화된 초중력 웜홀이 포함됩니다.
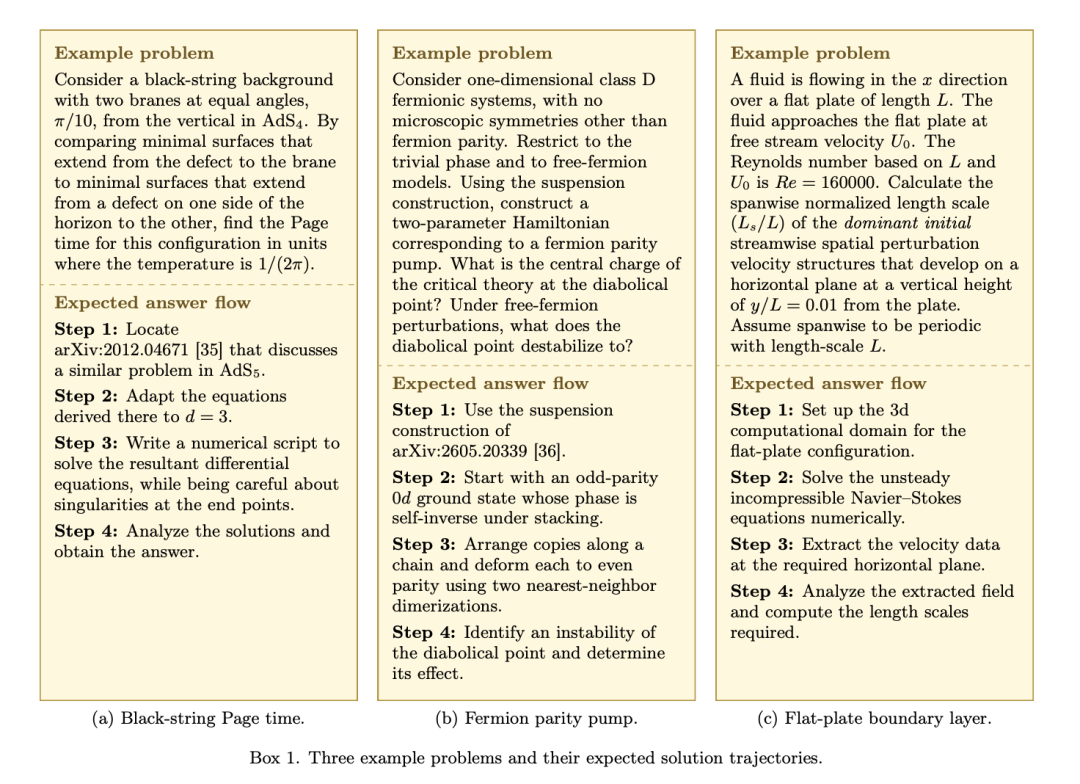
이 평가의 폭은 상당합니다. 한 명의 인간 연구자가 이 모든 방법을 전문으로 다루는 경우는 드뭅니다. 그렇다고 해서 이 문제 모음이 이론물리학 전체를 포괄적으로 조사한 것은 아닙니다.
연구진은 Harbor를 사용해 에이전트의 실행 환경을 통제합니다. 두 트랙 모두 코드 실행을 포함한 로컬 도구를 허용합니다. 현실적 트랙에서는 웹 접근도 허용하지만, 격리 트랙에서는 모델 제공자와의 통신을 제외한 인터넷 접근이 차단됩니다.
기호식 답변의 채점을 단순화하기 위해 많은 프롬프트는 수치 값을 제공하고 최종 결과를 수치로 요구합니다. 이 방식은 동등한 표현 사이의 모호성을 줄이고 추측을 어렵게 합니다.
아이디어를 한 문장으로 입력하면 We0 AI가 쇼케이스 사이트, 페이지, CMS를 생성하고 출시 후 고객과 트래픽 확보를 돕습니다.
무료 등록을 위한 하나의 완전한 프로젝트 생성
하나의 완전한 생성 흐름을 시도하고 첫 번째 프로젝트 초안을 빠르게 보는 데 가장 적합합니다.
그러나 최종 숫자가 일치한다고 해서 모든 중간 단계가 올바르다는 뜻은 아닙니다. 논문은 일부 문제에서 규약이 충분히 정의되지 않았고, 수치화하기 어려운 역문제가 포함되어 있다는 점을 인정합니다. 이 평가는 모든 유도를 형식적으로 검증한 것이 아니라 최종 답변을 채점합니다.
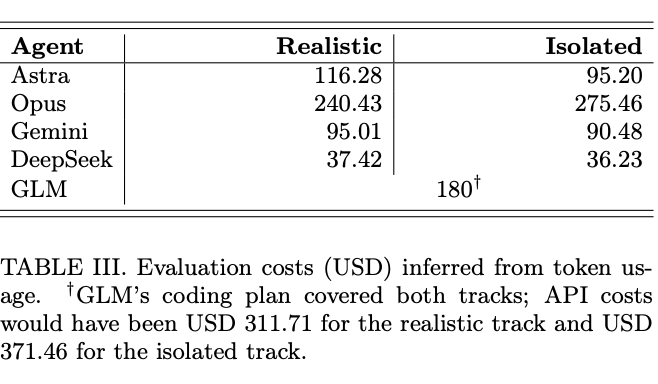
| 에이전트 | 현실적 트랙 추정 API 비용 | 격리 트랙 추정 API 비용 |
|---|---|---|
| Astra | $116.28 | $95.20 |
| Opus | $240.43 | $275.46 |
| Gemini | $95.01 | $90.48 |
| DeepSeek | $37.42 | $36.23 |
| GLM | API 요금 기준 $311.71 | API 요금 기준 $371.46 |
GLM은 실제로 두 트랙을 모두 포함하는 180달러 코딩 플랜으로 실행되었습니다. API 환산 금액은 해당 실행에 실제로 지불한 금액이 아닙니다.
Astra의 현실적 트랙 총비용을 50으로 나누면 문제당 약 $2.33입니다. 이는 평가에 적용된 요금 기준의 추정 토큰 비용이며, 연구 조직 운영, 전문 지식 확보, 과학적 작업 검증에 필요한 전체 비용은 아닙니다.
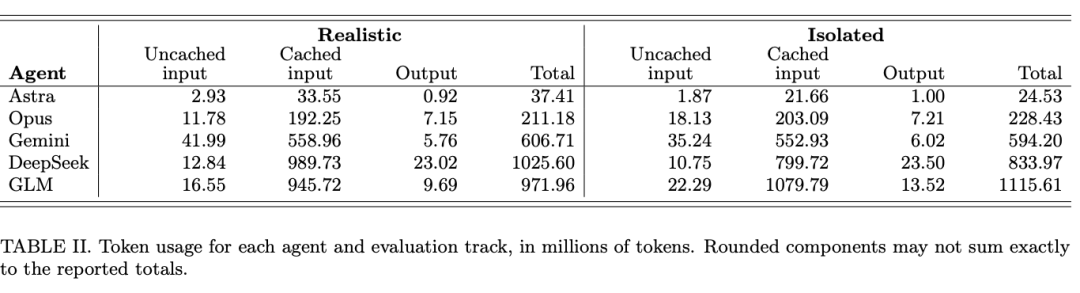
평가에는 일반적인 토큰 예산 제한이 없었지만, 과제별 시간 초과 제한은 있었습니다. 일반적으로 제한 시간은 8시간이었으며, 서로 연결된 전자 구조 과제에는 더 긴 시간이 허용되었습니다. 낮은 평균 토큰 비용을 낮은 지연 시간이 항상 보장된다는 의미로 이해해서는 안 됩니다.
출처는 이어서 MIT의 Neil Thompson, Gabriel Manso, Claudio Mayrink Verdun이 참여한 연구를 다룬 보도를 인용합니다. Superpower Daily는 WIRED를 인용해, 선정된 이론 문제에서 성공률이 2024년 중반 당시 가장 뛰어난 시스템의 약 2%에서 2026년 중반에는 약 35%로 상승했다고 설명합니다.
계산상 이는 17.5배의 비율이며 33%포인트의 증가입니다. 이 수치는 확률, 통계, 경제 이론, 여러 물리학 분야를 아우르는 별도의 문제 모음에 관한 것입니다. 해당 평가는 인터넷에 연결되지 않은 상태에서 연속적인 OpenAI 시스템을 사용해 수행되었습니다.
이러한 비율을 TheoPhysEval의 점수와 합쳐서는 안 됩니다. 과제, 모델 구성, 채점 방식, 범위가 서로 다릅니다. 검토된 2차 보고서는 해당 비교에서 실험 및 시뮬레이션 기반 작업도 제외합니다.
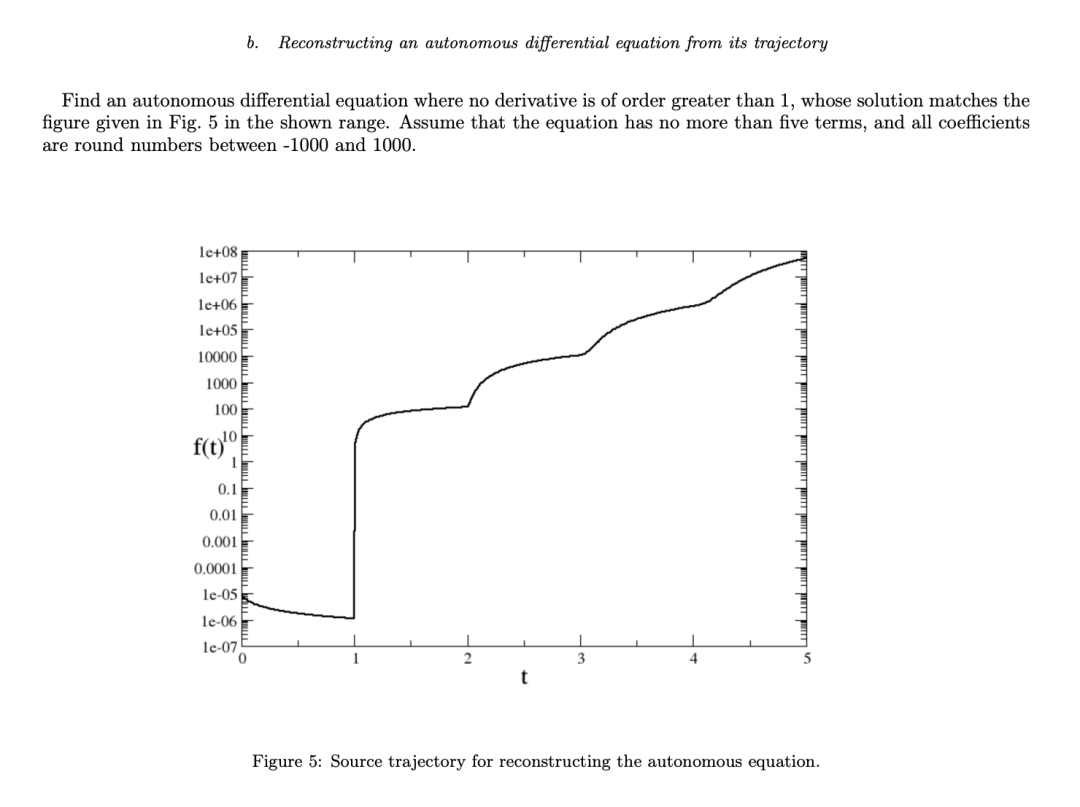
TheoPhysEval의 한 역문제는 테스트된 모든 에이전트를 실패하게 만들었습니다. 이 문제는 주어진 궤적과 일치하는 자율 미분방정식을 요구합니다. 논문은 정보 비대칭과 설정 해석의 유연성을 논의하지만, ‘물리적 직관’이 보편적으로 부재한다는 사실을 입증하지는 않습니다.
저자들은 구체적인 계산, 중요한 질문의 선택, 접근 방식이 실패했을 때의 방향 전환을 이론 구축과 구분합니다. 결론은 전문가의 지도를 받는 에이전트 활용을 지지하면서도, 경력 초기 연구자가 계산 기술을 어떻게 학습해야 하는지에 대한 질문을 제기합니다.
에이전트가 최종 답을 저렴하게 얻을 수 있더라도 훈련 과제는 여전히 가치가 있을 수 있습니다. 이 경우 과제의 목적은 답 자체를 연구 성과로 취급하는 것이 아니라 학습과 이해에 있어야 합니다.
이는 검증 가능한 연구 수준의 이론물리학 문제 50개로 구성된 문제 모음입니다. 저자들은 주요 미해결 문제를 발견하는 능력이 아니라, 표준 에이전트 도구를 활용한 자율적 계산 능력을 평가하기 위해 이 문제 모음을 설계했습니다.
Astra는 현실적 트랙에서 50개 문제 중 49개에 대해 채택 가능한 최종 답변을 반환했습니다. 이 점수는 평가에 사용된 모델, Codex 하네스, 실행 환경에 적용되는 결과이며, 모든 물리학 문제에 적용되는 수치가 아닙니다.
아니요. 격리된 에이전트도 로컬 계산 도구를 실행할 수 있었습니다. 핵심 제한은 코드 실행이 아니라 인터넷 접근이었습니다.
논문에 따르면 처음에 거부된 답변 중 일부가 수정된 전문가 참조 해답과 일치했습니다. 이는 참조 자료를 신중하게 확인해야 한다는 점을 보여주며, 모델의 답변이나 인간의 답변이 자동으로 옳다고 가정해서는 안 된다는 점도 시사합니다.
아니요. 답변이 미공개였다는 점은 데이터 오염의 한 가지 원인을 줄이지만, 일부 참여자가 AI의 도움을 받았습니다. 저자들도 데이터 유출 가능성을 배제할 수 없다고 명시적으로 인정합니다.
저자들은 Hugging Face에서 데이터 세트와 평가 리소스를 연결해 제공합니다. 재현할 때는 모델 버전, 하네스 설정, 트랙, 수치 규약, 채점 규칙을 동일하게 유지하고 실행 간 변동성을 고려해야 합니다.
TheoPhysEval은 정의된 범위의 고급 검증 가능 계산에서 탁월한 성능을 보고합니다. 두 트랙의 결과는 유용한 물리학 에이전트 작업이 학습된 지식, 문헌 접근, 실행 가능한 계산을 결합할 수 있음을 보여줍니다.
동시에 이 결과는 참조 해답의 오류, 채점의 모호성, 최종 답변 평가의 한계도 드러냅니다. 강력한 계산 성능은 전문가가 주도하는 연구를 뒷받침하지만, 과학적 발견을 자율적으로 완전히 수행할 수 있음을 입증하지는 않습니다.
한 문장에서 시작해 몇 분 안에 완전한 웹사이트를 받아보세요.



