A lógica de uma página de FAQ comum é “a pessoa procura a resposta”: o usuário decide qual item abrir, lê o parágrafo inteiro e compara com a própria situação. Já as perguntas que uma empresa realmente recebe costumam ser combinações como “nossa versão suporta implantação privada? Os dados não podem sair da rede interna”, enquanto no FAQ existe apenas um item “suporta implantação privada”; depois de ler, o usuário continua sem certeza.
A diferença do atendimento com IA é que a resposta é organizada no momento, de acordo com a pergunta. Ele usa o conteúdo do site, a documentação do produto e a lista de FAQ como base de conhecimento; quando o usuário pergunta, primeiro recupera materiais relevantes e, em seguida, o grande modelo organiza uma resposta que responde diretamente à pergunta (documentação do Atendimento ao Cliente com IA da Alibaba Cloud). Para cenários de alta frequência e repetição, como consultas pré-venda, orientação de funcionalidades e informações do site, essa diferença determina se o usuário continua lendo ou fecha a página e vai perguntar ao concorrente.
Portanto, o que deve ser entregue não é uma caixa de chat, mas um ativo de conhecimento que possa ser recuperado e que seja suficientemente preciso. O estilo da janela é a última etapa; as duas primeiras determinam se ele realmente será útil.
A estrutura técnica que faz o atendimento com IA “entender o próprio produto”: RAG
Para que um chatbot responda com base nos materiais da própria empresa, a abordagem predominante é a geração aumentada por recuperação (RAG). Seu núcleo não é fazer o modelo “memorizar” seu produto, mas, antes de cada resposta, buscar na base de conhecimento trechos relevantes e, a partir desses trechos, escrever a resposta. A documentação do RAG Studio da Cloudera descreve esse tipo de sistema assim: o chatbot acessa a base de conhecimento, recupera conteúdos relacionados à pergunta do usuário e então gera uma resposta adequada àquela pergunta (descrição de casos de uso do RAG Studio).
Uma cadeia mínima utilizável contém cinco etapas:
- Segmentação: dividir manuais, cláusulas e páginas de produto em pequenos blocos recuperáveis;
- Indexação: criar um índice vetorial ou de palavras-chave para cada bloco;
- Recuperação: quando o usuário pergunta, recuperar os blocos mais relevantes;
- Geração: entregar o conteúdo recuperado junto com a pergunta do usuário ao modelo para organizar a resposta;
- Citação: indicar a fonte ao lado da resposta, para que o usuário possa clicar e verificar.
A etapa 5 costuma ser ignorada, mas resolve dois problemas ao mesmo tempo: a confiança do usuário e a sua capacidade de rastrear depois “de qual documento saiu esta frase”. Quando os materiais são atualizados, o modelo não precisa ser retreinado; basta alterar a base de conhecimento. É também por isso que RAG é mais adequado do que ajuste fino quando os materiais de produto são iterados com frequência.
Primeira etapa: inventariar as fontes de conhecimento e distinguir o que deve entrar na base
Antes da integração, organize os materiais por categoria. Nem todo conteúdo é adequado para ser colocado diretamente na base, e nem todo conteúdo deve ser exibido publicamente.
| Fonte de conhecimento | Conteúdo adequado | O que observar na integração |
|---|---|---|
| Páginas do site | Apresentação do produto, páginas de funcionalidades, página de preços, artigos da central de ajuda | Pode ser rastreado automaticamente, mas é preciso garantir que a página online seja a versão mais recente |
| Documentos PDF / Word | Manuais de produto, folhas de especificações, descrição de interfaces, termos de serviço | Arquivos digitalizados precisam primeiro passar por reconhecimento de texto; caso contrário, não serão recuperados |
| Perguntas e respostas padrão de FAQ | Políticas, prazos, trocas e devoluções, notas fiscais, fluxos de pós-venda | Têm a maior prioridade de correspondência e as respostas mais controláveis |
| Materiais internos | Regras de preço, SOP de vendas, manuais de tratamento de falhas | Envolvem permissões e não podem ser misturados ao conhecimento público no mesmo escopo de recuperação |
Um erro comum é enviar todos os materiais sem distinção; como resultado, o modelo recupera três folhas de especificações de épocas diferentes e as respostas se contradizem. Fazer primeiro a deduplicação e a convergência de versões é muito mais eficaz do que ajustar prompts.
Segunda etapa: construir a base de conhecimento e torná-la recuperável
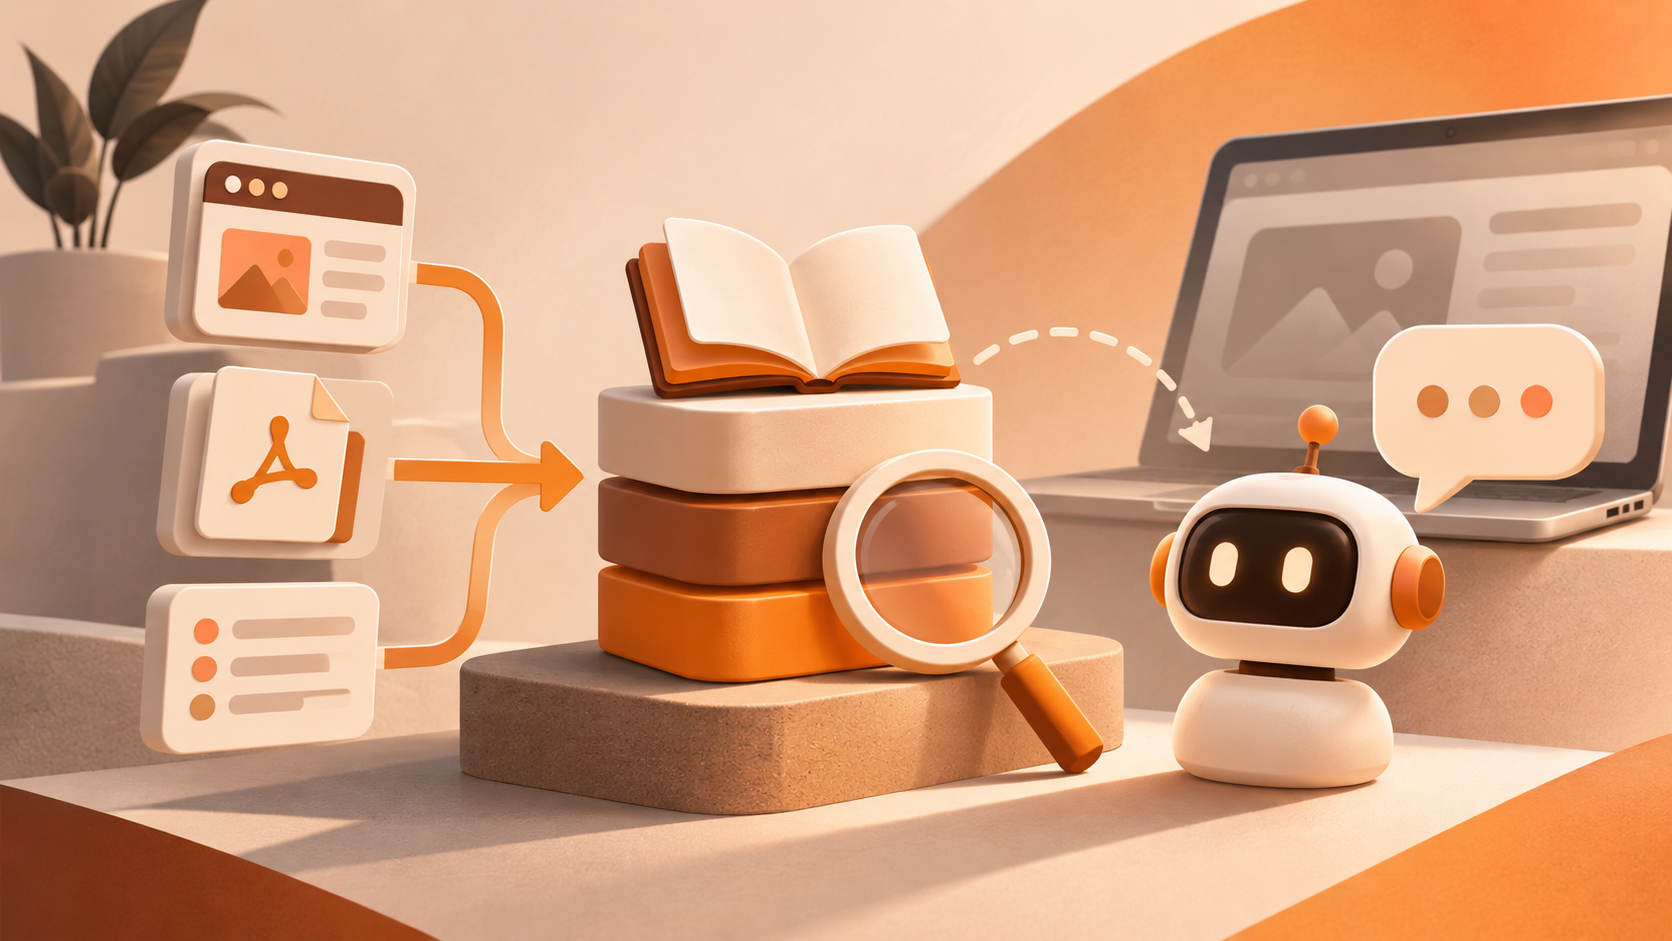
A construção da base de conhecimento costuma seguir três tipos: importação do site, upload de arquivos e entrada de FAQ. Tomando como exemplo a implementação do Atendimento ao Cliente com IA da Alibaba Cloud, após ativar o serviço o sistema analisa automaticamente o conteúdo público do site como base de conhecimento inicial, e o tempo de rastreamento depende do volume de conteúdo do site; o upload de arquivos suporta seis formatos: pdf, doc, docx, txt, markdown e excel; o FAQ serve para inserir pares de perguntas e respostas padrão e, quando a pergunta do usuário corresponde simultaneamente a várias fontes de conhecimento, o sistema prioriza a resposta padrão do FAQ (documentação do Atendimento ao Cliente com IA da Alibaba Cloud).
Em termos de execução, há algumas ações que vale a pena fixar como processo:
- Depois de concluir a importação do site, revise a lista de páginas rastreadas e exclua páginas de campanhas expiradas e páginas em rascunho;
- Quando o conteúdo for atualizado, clique manualmente uma vez para rastrear novamente ou ative a sincronização automática agendada, para evitar que a base de conhecimento fique parada há três meses;
- Escreva como FAQ os dez grupos de perguntas mais fáceis de responder errado, usando respostas padrão para cobrir o espaço de improvisação do modelo;
- Deixe um responsável para cada item de conhecimento; caso contrário, em seis meses ninguém terá coragem de excluir documentos antigos.
Terceira etapa: incorporar a janela de atendimento ao site
Com a base de conhecimento funcionando, é a vez da configuração externa. Campos como cor da janela, nome do serviço, descrição do serviço e perguntas de abertura parecem decoração, mas afetam a qualidade da primeira rodada de conversa: se a descrição do serviço deixar claros os limites de capacidade, o usuário não fará perguntas fora do escopo, como “escreva um contrato para mim”; perguntas de abertura oferecem entradas de alta frequência e reduzem significativamente o custo de hesitação do usuário na primeira frase (documentação do Atendimento ao Cliente com IA da Alibaba Cloud).
Também há uma configuração facilmente esquecida: as formas de contato. Quando a IA não consegue resolver o problema do usuário, a interface precisa oferecer telefone, e-mail ou outro canal alternativo; caso contrário, depois de ser bloqueado por um “não sei”, o usuário realmente vai embora.
Se o site já tiver um sistema de login, separar o conhecimento público do conhecimento visível apenas após o login significa criar dois escopos de conhecimento independentes. Para facilitar essa estratificação, é melhor que o site subjacente tenha capacidade de contas — por exemplo, as capacidades de site da we0 incluem verificação de e-mail, sistema básico de contas com login Google e GitHub, além de um back-end CMS para gestão de usuários e manutenção de conteúdo (visão geral das funcionalidades da we0) — esse tipo de base economiza o custo de montar por conta própria o login e a manutenção de conteúdo.
Como evitar que a IA invente informações de produto inexistentes
Este é o risco mais concreto no processo de integração: o cliente pergunta “vocês suportam SAML single sign-on?” e o modelo, para manter a conversa, provavelmente responde um “sim” que soa razoável.
Reduzir esse tipo de erro depende de restrições, não de torcida. Os meios disponíveis, ordenados por custo-benefício, são:
- Limitar o escopo de resposta: exigir explicitamente que o modelo responda apenas com base nos trechos recuperados; quando a recuperação estiver vazia, dizer diretamente que a base de conhecimento ainda não contém aquele item.
- Fornecer uma mensagem de fallback: quando não houver correspondência, não ficar em loop; em vez disso, sugerir que o usuário reformule a pergunta ou fale com um humano, e manter um botão de avaliação para coletar feedback negativo.
- Priorizar FAQ: transformar pontos que não podem errar, como parâmetros, preços e conformidade, em perguntas e respostas padrão, para que se sobreponham à formulação livre do modelo.
- Exigir fontes: a resposta deve vir com links de origem, para que o usuário possa verificar e você possa revisar depois.
- Fazer amostragem antes do lançamento: criar um conjunto de testes com perguntas históricas de tickets reais de atendimento e comparar cada resposta com a documentação; não valide com perguntas como “olá” ou “onde fica a empresa de vocês”.
Uma instrução de sistema utilizável seria mais ou menos assim:
Você é o atendimento de produto deste site. Responda apenas usando os trechos recuperados abaixo.
Se os trechos não contiverem a resposta, responda diretamente “A base de conhecimento não possui informações relevantes no momento” e indique ao usuário que consulte as formas de contato.
Não especule sobre funcionalidades, preços, versões ou compromissos que não apareçam nos trechos.
Ao final da resposta, liste os títulos das páginas de origem.
É possível recomendar produtos com base na pergunta do usuário?
Sim, mas a recomendação deve se basear em condições que realmente existem nos materiais. Uma abordagem viável é rebaixar a “recomendação” para “filtragem por condições”: extrair da descrição do usuário elementos como cenário, escala e forma de implantação, mapeá-los para diferenças de versão ou divisões de planos explicitamente escritas na documentação e, por fim, apresentar a página de produto correspondente. Assim, cada frase da recomendação é rastreável; por outro lado, deixar o modelo improvisar “a solução mais adequada para você” equivale a permitir que ele faça, em seu nome, uma promessa comercial não confirmada.
O lado de dados também pode ajudar. Alguns painéis de dados de sistemas de atendimento agrupam as perguntas por categoria, e a recomendação de produto é uma delas; ao mesmo tempo, medem número de sessões, número de usuários, número de perguntas respondidas e taxa de resolução de problemas (perguntas respondidas ÷ total de perguntas × 100%) (documentação do Atendimento ao Cliente com IA da Alibaba Cloud). Se a taxa de resolução das perguntas de recomendação for baixa por muito tempo, normalmente não é o modelo que está ruim, mas faltam informações necessárias à decisão nas páginas de produto — dimensões de comparação, faixas de preço, cenários aplicáveis e não aplicáveis.
Como transferir questões complexas para o atendimento humano
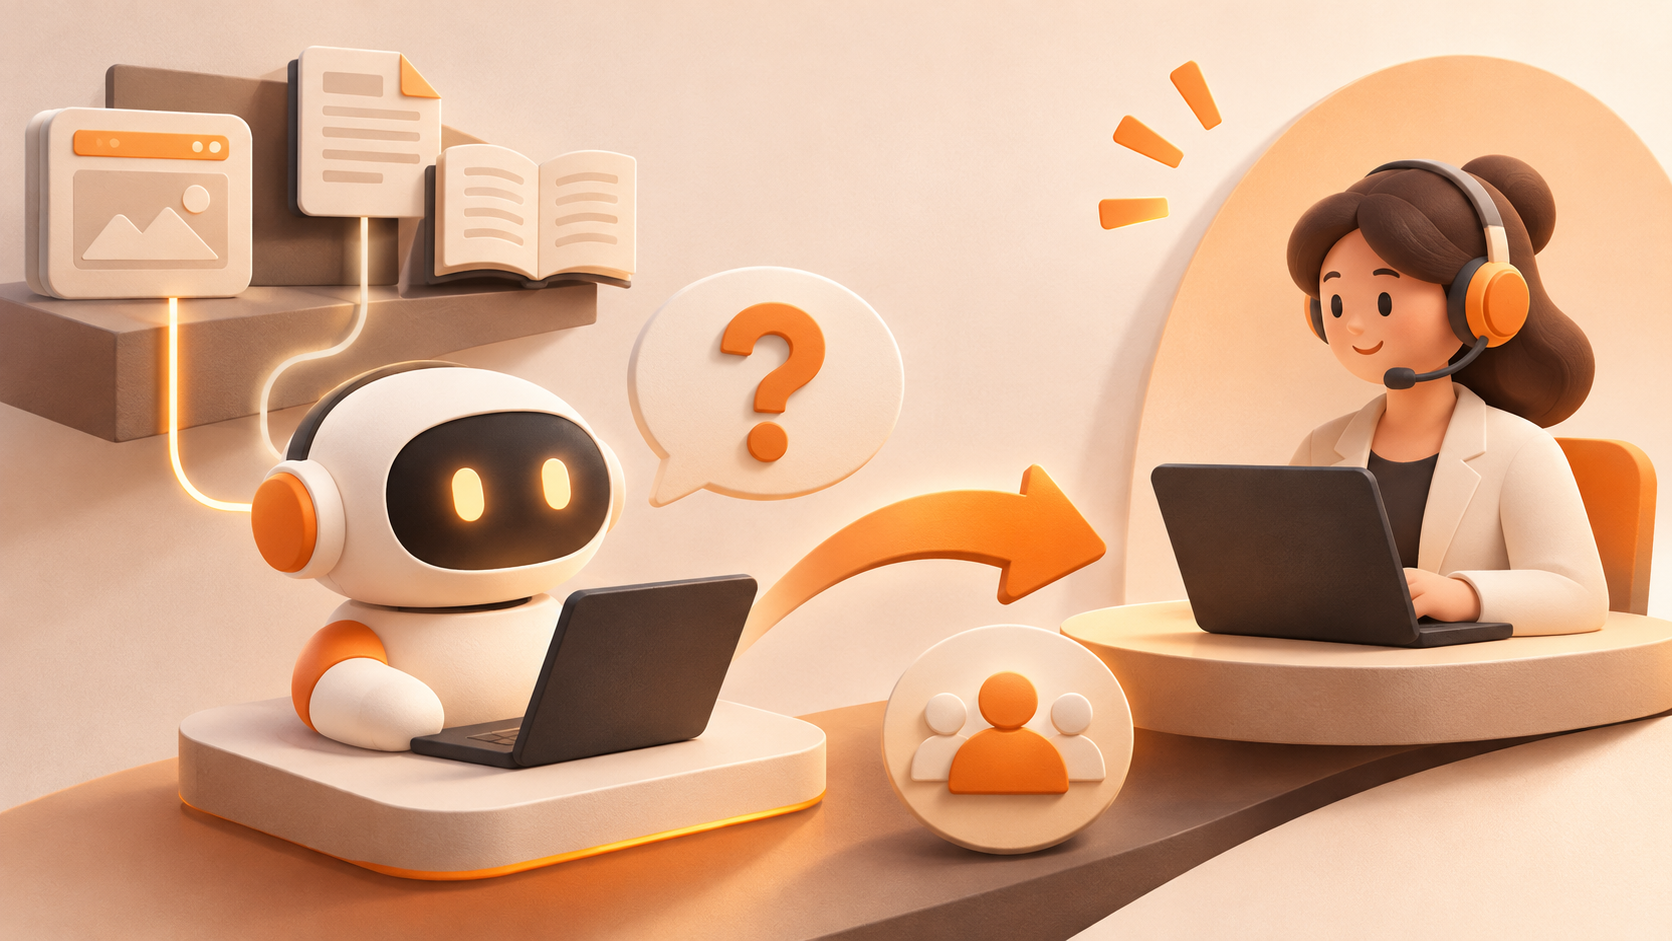
O atendimento com IA não existe para barrar pessoas, mas para absorver perguntas simples e entregar questões complexas com contexto. Recomenda-se escrever as condições de acionamento da transferência para humano como uma lista, evitando o “depende”:
Crie um site de apresentacao e gere leads em minutos
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
- O tema corresponde a palavras-chave de alto valor ou alto risco: orçamento, cláusulas contratuais, desenvolvimento personalizado, falhas e segurança de dados, reclamações;
- Duas rodadas consecutivas sem resolução, ou o usuário pede explicitamente por um humano;
- O usuário demonstra emoção claramente negativa, com expressão explícita de insatisfação;
- A taxa de correspondência da base de conhecimento está vazia e o assunto envolve conta, pedido ou outros itens que exigem consulta ao back office.
Na transferência, envie ao humano o resumo da conversa, as fontes já recuperadas e a página em que o usuário está, para que o cliente não precise repetir tudo desde o início. Essa etapa não é tecnicamente difícil, mas é o elo em que a experiência mais despenca — muitas empresas implementam atendimento com IA, mas transformam a transferência para humano em “por favor, descreva novamente o seu problema”.
Registrar as conversas e transformá-las em base para atualizar a base de conhecimento
Conversas de atendimento são a pesquisa de necessidades mais barata. O sistema normalmente mantém o histórico de sessões, incluindo a pergunta do usuário, a resposta da IA e a fonte de conhecimento em que aquela resposta se baseou, e permite filtrar por status (como respondido, parcialmente respondido) (documentação do Atendimento ao Cliente com IA da Alibaba Cloud). Reservar vinte minutos por semana para olhar esses dados permite obter três tipos de sinal:
- Perguntas que se repetem e são mal respondidas: falta um item na base de conhecimento; adicione um FAQ;
- Perguntas respondidas de forma vaga: a documentação está abstrata; é preciso acrescentar parâmetros ou exemplos concretos;
- Perguntas que o cliente faz por iniciativa própria, mas para as quais você não se preparou: sinal de demanda pré-venda que merece ser repassado a produto e marketing.
Alguns sistemas oferecem uma entrada de “otimização de perguntas”, que transforma perguntas não resolvidas em novos itens de FAQ com um clique; basta completar a resposta padrão. Incorporar isso ao processo de reunião semanal é o que faz a base de conhecimento crescer por conta própria.
Depois do lançamento: ritmo de atualização da base de conhecimento e responsáveis
Se o atendimento com IA começa a responder errado três meses após o lançamento, quase sempre é porque ninguém cuida da base de conhecimento. Recomenda-se manter uma cadência fixa:
- Semanalmente: limpar a lista de perguntas não resolvidas e adicionar 3–5 FAQs;
- Mensalmente: verificar a consistência entre a página de preços, a página de planos e a documentação, e retirar conteúdos de campanhas expiradas;
- A cada lançamento de versão: atualizar a documentação de funcionalidades e o changelog no mesmo dia, para não deixar a IA se tornar porta-voz de versões antigas;
- Trimestralmente: fazer amostragem de 30 conversas reais, rodar novamente o conjunto de testes e registrar a variação da taxa de resolução.
O responsável não precisa ser o supervisor de atendimento, mas precisa ser uma pessoa, e não “a equipe”. Gestão compartilhada por várias pessoas equivale a ninguém responsável.
Exemplo de cadeia completa em uma empresa SaaS
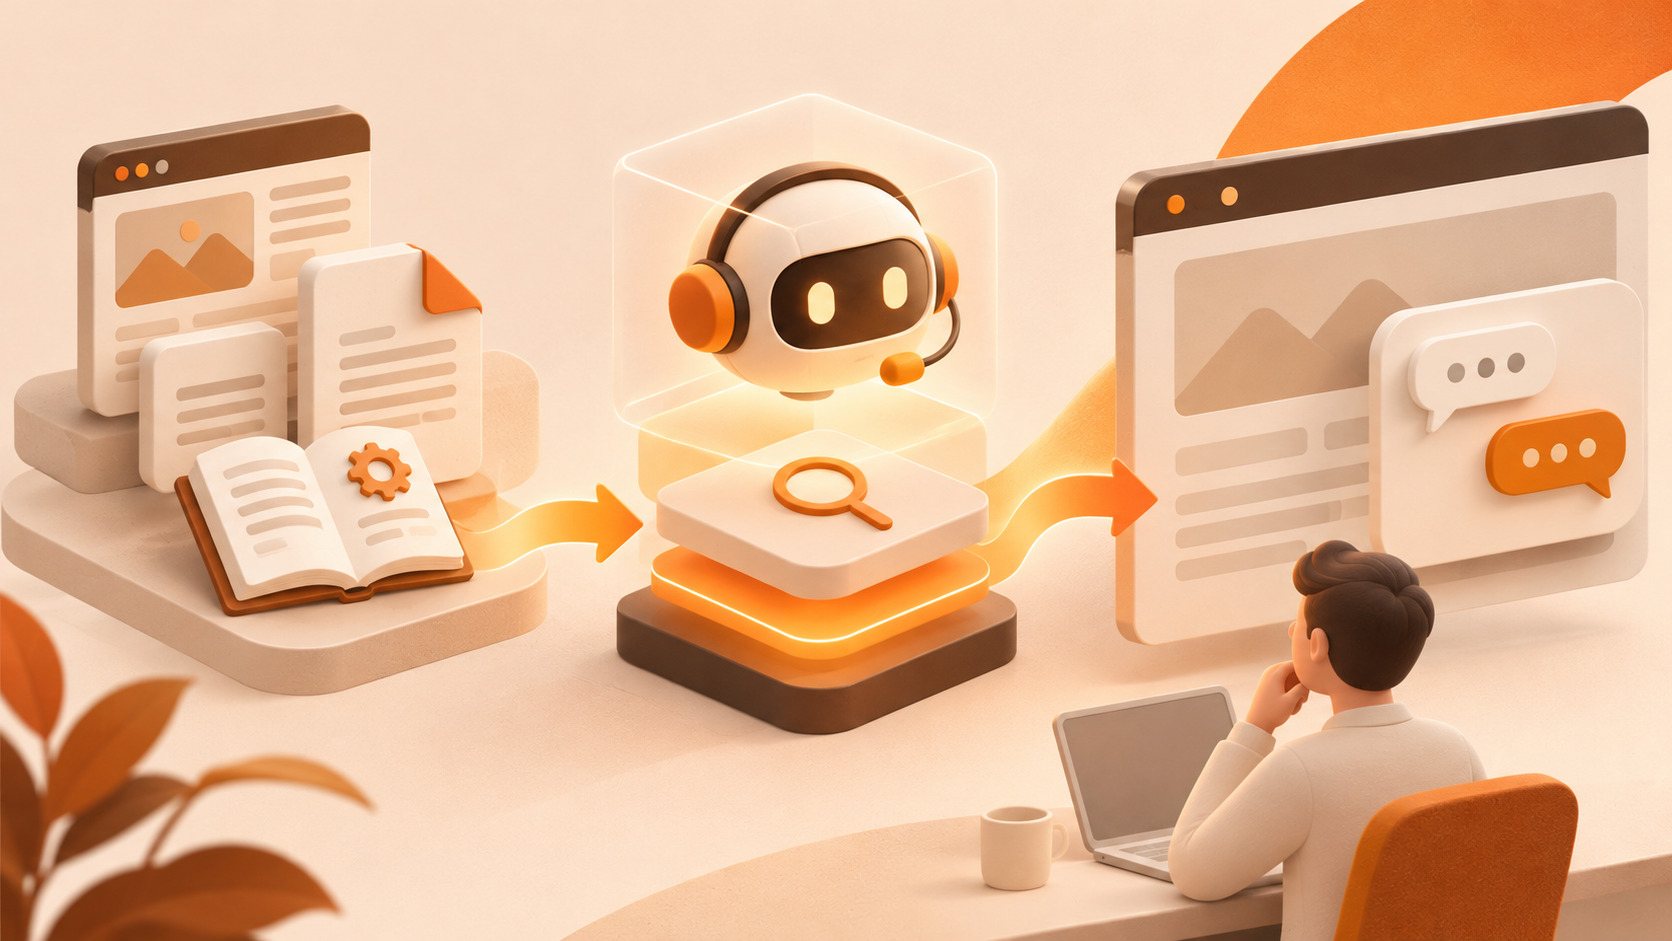
Suponha que uma empresa SaaS de dashboards de dados tenha acabado de lançar um novo site, com o produto em três formatos: versão gratuita, versão para equipes e implantação privada, e com a documentação espalhada entre a central de ajuda e manuais em PDF.
- Pergunta do usuário: um visitante digita na janela no canto inferior direito da página de preços: “Somos uma equipe de análise de 80 pessoas, os dados não podem sair da rede interna; como vocês cobram?”
- Recuperação: o sistema recupera conteúdos relevantes na central de ajuda, na descrição de implantação privada e no manual de preços em PDF.
- Organização da resposta: primeiro responde se o formato de implantação atende a “os dados não saem da rede interna”; depois explica as dimensões de precificação da solução privada, com tom contido e sem prometer valores específicos.
- Oferecimento de páginas relacionadas: anexa a página de descrição da implantação privada e a entrada para contato com vendas.
- Transferência para humano quando não for possível resolver: o usuário pergunta sobre cláusulas contratuais e prazo de implementação, acionando palavras-chave de alto risco; a conversa é transferida diretamente para um humano com um resumo.
- Consolidação: essa pergunta entra na lista de não resolvidas e a operação adiciona um FAQ “como a implantação privada é precificada”.
Em toda a cadeia, a IA não “adivinha”; cada passo pode ser rastreado até um documento.
O que a we0 pode assumir nessa cadeia e o que precisa ser construído internamente
Se o site da empresa ainda está em fase de construção, planejar junto a capacidade de atendimento pode economizar trabalho. A we0 se posiciona como um conjunto de capacidades de site voltado à entrega formal; sua lista oficial de capacidades inclui integração de capacidades de IA (geração de texto, imagem, vídeo e áudio, adequadas para expansão em produtos de conversa), CMS e back-end de gestão, sistema de autenticação, organização multilíngue e publicação online, e os cenários de aplicação mencionam explicitamente aplicações de atendimento inteligente e base de conhecimento (visão geral das funcionalidades da we0).
É preciso deixar claro o limite: essas são capacidades de base para criação de sites e integração de IA, não equivalem a um atendimento de base de conhecimento empresarial pronto para uso. Segmentação e indexação de documentos, estratégia de recuperação, filtragem do conhecimento por permissão de usuário, transferência para atendimento humano e integração com tickets geralmente ainda exigem desenvolvimento próprio com base na capacidade de geração de código full-stack, ou integração de sistemas de RAG e atendimento de terceiros. Ao avaliar, trate “conseguir gerar um site” e “conseguir operar um atendimento com base de conhecimento” como duas coisas, para evitar descobrir depois do lançamento que falta metade da cadeia.
Conformidade e limites de conteúdo: quais materiais não podem ser rastreados
Quanto mais amplas as fontes de conhecimento, mais atenção é preciso dar a como o conteúdo entra. Importe apenas conteúdo próprio público e permitido para rastreamento e materiais já autorizados; não obtenha conteúdo de terceiros contornando paywalls, restrições de login ou mecanismos anti-scraping. Um parecer de um consultor do Tribunal de Justiça da União Europeia oferece referência nesse sentido: quando um chatbot recupera e reutiliza em tempo real conteúdo de publicações jornalísticas em suas respostas, pode haver violação dos direitos do editor se o conteúdo tiver sido obtido ilicitamente ou se a formulação da resposta puder substituir quase integralmente o texto original; já um resumo factual com palavras próprias e link para o original apresenta risco significativamente menor (análise do caso).
Para o atendimento no site de uma empresa, esse princípio se traduz de forma simples: a base de conhecimento contém materiais próprios e conteúdo autorizado, as respostas priorizam resumos e fontes e não reproduzem integralmente conteúdo de terceiros.
Perguntas frequentes
A IA de atendimento consegue ler PDF e Word diretamente?
Sim. Tomando como exemplo plataformas comuns de criação de sites e atendimento, o upload de arquivos suporta formatos como pdf, doc, docx, txt, markdown e excel; após o upload, há um processo de análise e, quando a análise é concluída com sucesso, o arquivo passa a participar da recuperação (documentação do Atendimento ao Cliente com IA da Alibaba Cloud). PDFs digitalizados precisam primeiro ser convertidos em texto recuperável.
Os preços na base de conhecimento mudam com frequência; como garantir respostas corretas?
Informações de alta frequência de mudança, como preços e planos, devem ser transformadas separadamente em respostas padrão de FAQ e ter verificação mensal designada; não espalhe preços por vários PDFs, caso contrário o modelo recuperará versões diferentes.
A IA de atendimento pode vazar materiais internos para o cliente?
Depende de como o escopo de conhecimento é delimitado. Conhecimento público e materiais internos devem ficar em conjuntos de conhecimento diferentes; materiais internos devem ser abertos apenas para funções específicas já autenticadas, e não depender de um prompt pedindo ao modelo que “não conte”.
As respostas devem incluir links de origem?
Recomenda-se incluir. Isso aumenta a credibilidade e também permite que você confirme, ao revisar, em qual versão da documentação a resposta se baseou.
Quanto tempo leva para entrar no ar?
O tempo principal está na organização dos materiais e na amostragem do conjunto de testes, não na integração técnica. Lançar primeiro uma versão com 70% de cobertura e complementar FAQs semanalmente é mais realista do que buscar cobertura total de uma vez.
Ferramentas relacionadas
- Base de conhecimento e console de atendimento: gerenciar importação do site, upload de arquivos, FAQ e otimização de perguntas
- CMS e back-end de conteúdo: manter as versões da central de ajuda, documentação de produto e página de preços
- Ferramentas de análise do site: observar cliques e caminhos de conversão na entrada de conversa
- Sistema de tickets / IM: receber sessões humanas transferidas pela IA e resumos de conversa
- Serviços de RAG e recuperação vetorial: usar ao construir a camada de recuperação internamente
Links relacionados
- Documentação do Atendimento ao Cliente com IA da Alibaba Cloud
- Descrição de casos de uso do Cloudera RAG Studio
- Visão geral das funcionalidades da we0
- Análise do caso sobre chatbots de IA e direitos autorais de notícias
Resumo
Para integrar atendimento ao cliente com IA no site de uma empresa, a verdadeira engenharia não está na janela de chat, mas na base de conhecimento: primeiro, inventariar os materiais de produto em três categorias — páginas web, documentos e FAQ — e convergir versões; depois, usar RAG para estabelecer a cadeia “recuperação — geração — citação”; incorporar a janela ao site é apenas a última etapa. Após o lançamento, é preciso conter o risco de invenção limitando o escopo de resposta, priorizando FAQ, exigindo fontes e fazendo amostragem com um conjunto de testes; proteger as questões complexas com uma lista de transferência para humanos; e manter a base de conhecimento em crescimento com uma lista semanal de questões não resolvidas. Transformar essas ações em uma cadência fixa com responsáveis é o que faz o atendimento com IA realmente reduzir consultas repetitivas, em vez de apenas expressar respostas erradas com mais fluência.