curl -sL https://www.example.com/ | grep -o "[^"
curl -sL https://www.example.com/ | head -c 1200
Se a resposta contiver apenas `
` e várias tags de script, sem nome legível da empresa, nome do produto e parágrafos de texto, então o crawler de busca recebe essa casca vazia na primeira vez. A documentação de JavaScript SEO do Google explica a relação entre rastreamento e renderização: o conteúdo de scripts não é totalmente invisível, mas a renderização exige fila de rastreamento e recursos adicionais; quanto mais o conteúdo e os links dependem de scripts, maior a incerteza de leitura correta (veja [Noções básicas de JavaScript SEO do Google](https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics)).
**Correção**: faça o conteúdo crítico entrar no HTML inicial — renderização no servidor, geração estática ou, no mínimo, saída de título, corpo e links internos como tags reais. O critério é simples: desative o JavaScript do navegador e a página ainda precisa ser legível.
## Verificação 2: Title e Meta Description estão corretos?

O que mais falta nas páginas geradas por IA são os metadados, porque são totalmente invisíveis visualmente. Três erros frequentes:
- **Mesmo Title no site inteiro**: a variável de template não foi substituída e todas as páginas ficam “Início | Nome da Empresa”;
- **Description vazia**: o Google só pode extrair o corpo por conta própria e o resumo muitas vezes não tem informação útil;
- **Title longo demais**: títulos em chinês com mais de cerca de 30 caracteres são truncados no mobile e o argumento de venda é cortado.
```html
Construção de site institucional: processo completo da necessidade à publicação | Nome da marca
Forma de autoavaliação: selecione 5 páginas principais (início, produto, preços, casos, blog), confirme que cada Title é diferente e contém o tema da página; a Description é uma frase completa, não um amontoado de palavras-chave.
Verificação 3: sitemap.xml e robots.txt são realmente utilizáveis
Dois arquivos que dão entrada ao crawler no site e também os dois mais facilmente ignorados na criação com IA — porque não existem na interface.
# https://www.example.com/robots.txt
User-agent: *
Disallow: /admin
Disallow: /preview
Disallow: /api
Allow: /

Sitemap: https://www.example.com/sitemap.xml
    https://www.example.com/pricing
    2026-03-01
Revise três coisas principais: o domínio no sitemap deve ser o domínio oficial, não o de pré-visualização; caminhos com Disallow não podem aparecer ao mesmo tempo no sitemap; a linha Sitemap: deve ser um endereço absoluto.
Também é preciso entender o limite do robots.txt. Em seu guia de indexação, o Google lembra que o robots.txt controla o rastreamento, não é um meio confiável de impedir indexação: URLs bloqueadas pelo robots.txt ainda podem aparecer nos resultados de busca por causa de links externos; quando for necessário garantir que uma página não entre no índice, use noindex (meta tag robots ou cabeçalho de resposta X-Robots-Tag). O Google também adicionou, na atualização de documentação de outubro de 2026, uma seção “indexar apenas conteúdo voltado à busca”, recomendando definir como não indexadas, por padrão, páginas geradas usadas apenas para compartilhamento, colaboração ou saída de ferramentas, e monitorar anomalias de indexação pelos relatórios de indexação de páginas e de desempenho de busca no Search Console (detalhes em Leitura da atualização do guia de indexação do Google).
Verificação 4: o canonical aponta para esta página?
rel=canonical diz ao mecanismo de busca “dentro deste conjunto de URLs semelhantes, qual é a versão principal”. Na geração por IA, três tipos de erro são comuns:
- Todas as páginas apontam para a página inicial, o que equivale a dizer ao Google que cada página é uma cópia da inicial;
- Apontar para o domínio de pré-visualização ou teste, fazendo a página oficial ser tratada como cópia;
- Endereços com parâmetros e endereços limpos apontam uns para os outros, fazendo os sinais brigarem de um lado para o outro.
-
O correto é: o canonical usa endereço absoluto, https, e é exatamente igual à URL final que você quer indexada (com ou sem barra final, a regra deve ser uniforme no site inteiro); em sites multilíngues, cada versão de idioma aponta para si mesma e usa hreflang para estabelecer a correspondência, em vez de canonicalizar todas para a versão em inglês.
Verificação 5: os dados estruturados contêm informações erradas?

IA é muito boa em “completar” dados estruturados e também em inventar sem perceber: avaliações inexistentes, faixas de preço que não existem, ano de fundação fictício. Isso viola o requisito básico dos dados estruturados — os dados devem ser consistentes com o conteúdo visível da página.
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "Nome da marca",
  "url": "https://www.example.com/",
  "logo": "https://www.example.com/logo.png"
}
O princípio é preferir menos a excesso: escreva apenas campos visíveis na página; exclua ano de fundação, avaliações e status de estoque em que não houver certeza; antes de publicar, rode a ferramenta de teste de dados estruturados e confirme que não há erro de análise.
Verificação 6: formulários, pop-ups e interações podem bloquear o crawler
Formulários em si não afetam a indexação; o problema é que muitas vezes eles “substituem” o corpo do texto: a página inteira tem apenas um formulário de captação, o conteúdo fica atrás de login, a primeira tela abre um pop-up em tela cheia pedindo consentimento de cookies. Para o crawler, essas páginas carecem de texto utilizável para corresponder à intenção de busca.
Além disso, a criação com IA costuma gerar muitas páginas “descartáveis” — página de sucesso de envio de formulário, página de resultado de orçamento, link de compartilhamento. Se essas páginas forem indexadas, diluem a qualidade do site. Segundo a recomendação do Google, é mais seguro defini-las como noindex por padrão (leitura do guia de indexação); páginas de destino realmente voltadas à busca devem manter o corpo HTML completo e visível, em vez de depender de clique para expandir.
Crie um site de apresentacao e gere leads em minutos
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Verificação 7: a próxima edição com IA vai reverter as configurações de SEO?
Este é o risco mais subestimado na criação de sites com IA: a página é gerada continuamente; o Title, o canonical e as regras de robots corrigidos manualmente hoje podem ser sobrescritos amanhã por uma regeneração do tipo “ajuda a mudar as cores e, de passagem, otimiza o texto”.
Uma abordagem viável é restringir por processo, não por memória:
- Concentre configurações relacionadas a SEO em templates ou configurações globais, reduzindo a escrita manual página por página;
- Após cada regeneração, rode o checklist, cobrindo no mínimo início, página de produto e página de preços;
- Acompanhe crescimentos anormais no número de URLs: mudanças de template ou lançamentos de funcionalidades costumam gerar URLs em lote; o Google recomenda monitorar ao mesmo tempo a criação de conteúdo no lado da plataforma e as mudanças no volume indexado (mesma fonte);
- Antes de publicar, faça um “diff de configurações” fixo: compare Title, canonical, robots e sitemap com a versão publicada anteriormente.
Verificação 8: por que vale a pena investir nisso
SEO técnico não é um assunto de nicho. Segundo estatísticas da Mordor Intelligence, o mercado de serviços de SEO técnico foi de US$ 1,573 bilhão em 2025 e deve crescer de US$ 1,689 bilhão em 2026 para US$ 2,837 bilhões em 2031, com CAGR de cerca de 10,93% entre 2026 e 2031; a categoria de SEO técnico representou 32,41% em 2025, justamente porque renderização, estrutura do site, redirecionamentos, dados estruturados e desempenho de página determinam diretamente se o conteúdo pode ser descoberto e recuperado em larga escala. O relatório também aponta que o Google continua incluindo Core Web Vitals na avaliação de busca (dados em Relatório de mercado de Technical SEO Services). Em outras palavras, publicar a página é só o começo; ser rastreado, compreendido e citado é o ingresso na era da busca e da busca com IA.
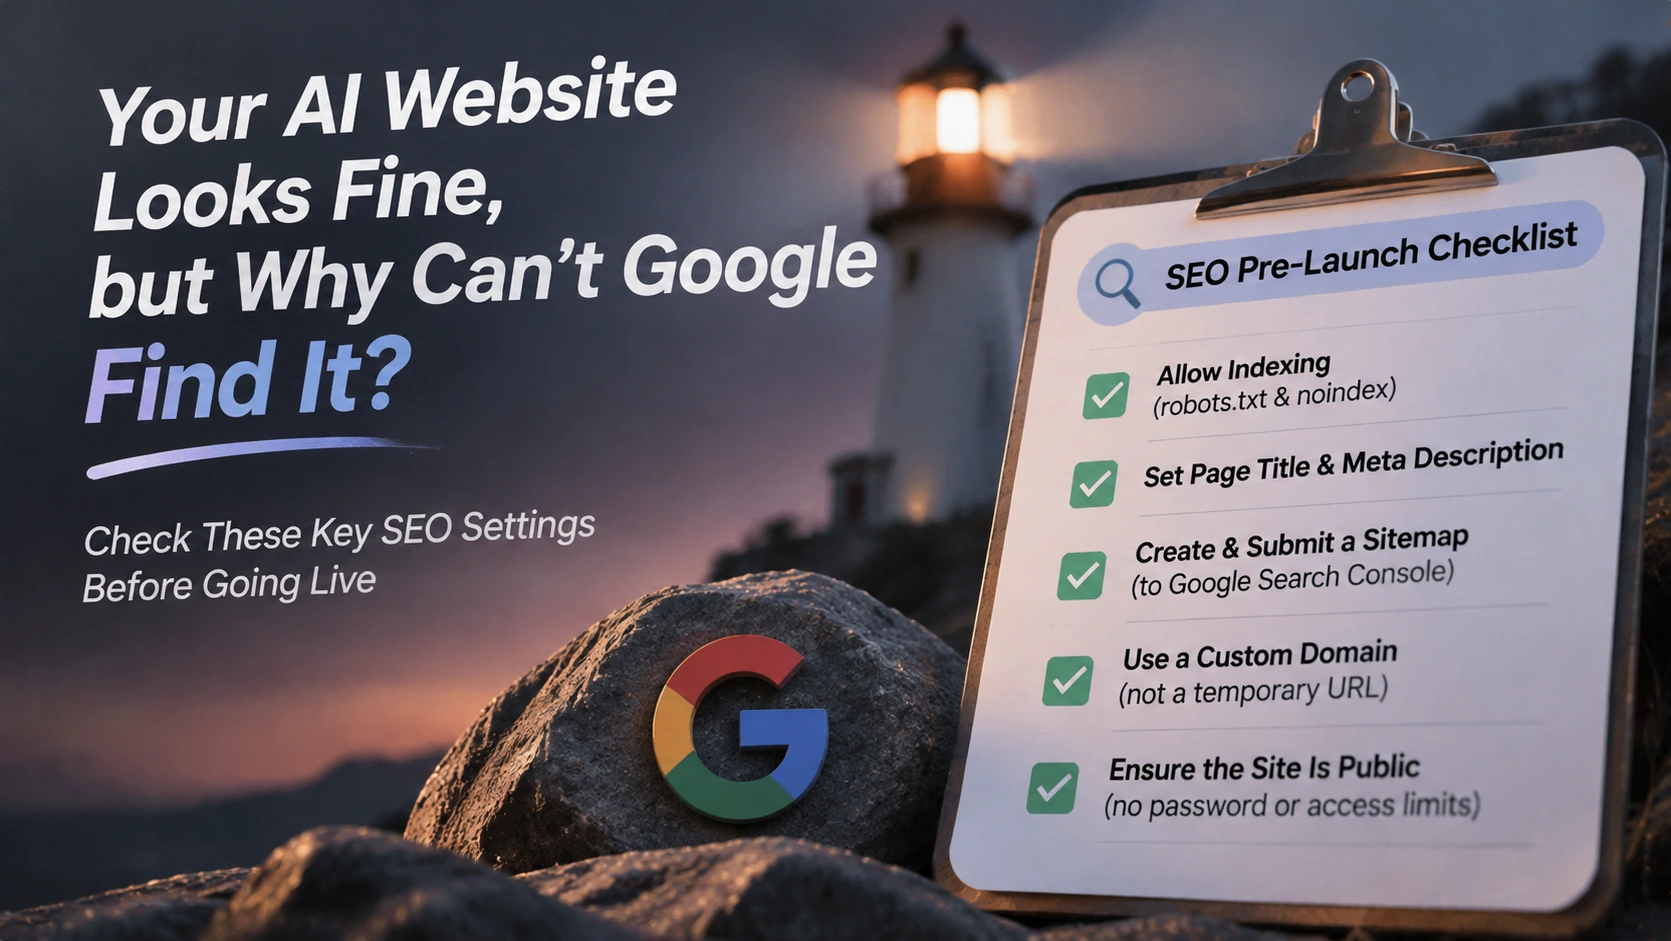
Checklist de 10 verificações de SEO antes de publicar um site criado com IA
| # | Item de verificação | Critério de aprovação |
|---|---|---|
| 1 | HTML inicial | Com JS desativado, título e corpo ainda são visíveis |
| 2 | Status HTTP | Páginas principais retornam 200; endereços antigos fazem 301 para o novo endereço |
| 3 | Title | Único por página, contém o termo do tema, comprimento controlado |
| 4 | Meta Description | Independente por página, é uma frase completa |
| 5 | robots.txt | Bloqueia apenas caminhos de admin e pré-visualização; Sitemap usa endereço absoluto |
| 6 | sitemap.xml | Contém apenas o domínio oficial e páginas indexáveis |
| 7 | canonical | Aponta para a própria URL oficial; regra de barra final uniforme no site |
| 8 | noindex | Site de pré-visualização, páginas de resultado e páginas de compartilhamento não indexados por padrão |
| 9 | Dados estruturados | Apenas campos visíveis na página, sem erros de análise |
| 10 | Interações e formulários | O corpo do texto não é ocupado por pop-up, login obrigatório ou formulário |
O valor desta tabela não está em “técnicas avançadas”, mas na repetibilidade: rodar antes de cada publicação resolve, em dez minutos, a maioria dos casos de “fiz certo, mas não encontro no Google”.
O que as empresas devem fazer agora
Se você está criando um site com ferramentas de IA, pode ajustar a ordem: primeiro gere estrutura e conteúdo, depois complemente metadados e regras de indexação e, por fim, faça uma verificação unificada antes de publicar. Plataformas de criação com IA como o We0 já colocam geração de páginas, back-office CMS, implantação de domínio e configuração de SEO/GEO na mesma cadeia (veja o site oficial do We0); a velocidade de geração não muda uma premissa: o mecanismo de busca só reconhece o que é efetivamente emitido no HTML, portanto o teste real após a publicação continua indispensável.
Recomendação de ações em três passos: primeiro use curl para ver o HTML inicial, depois confirme o status de rastreamento e indexação no Search Console e, por fim, transforme os 10 itens acima em uma etapa fixa antes da publicação e registre no documento de processo de lançamento da equipe.
FAQ
P: Sites gerados por IA não atendem naturalmente aos requisitos de SEO?
Não. A IA é apenas a forma de produção; o problema é que o processo de geração se concentra por padrão em “a página parece correta?” e não verifica “o que o mecanismo de busca leu?”. Desde que o HTML inicial contenha o texto do corpo e as regras de metadados e indexação estejam corretas, não há diferença essencial de desempenho de busca entre um site criado com IA e um site feito manualmente.
P: A página não aparece no Google. Isso significa que fui penalizado?
Na maioria dos casos, ainda não se trata de “penalização”, mas de página não rastreada ou não indexada. Verifique primeiro o status de indexação, depois se há bloqueio por robots.txt ou noindex e só então avalie qualidade de conteúdo e concorrência.
P: Apenas enviar o sitemap garante a indexação?
Não. O sitemap é uma pista de descoberta, não uma promessa de indexação; ele ajuda o crawler a saber mais rápido quais páginas existem, mas a indexação depende de acesso de rastreamento, qualidade do conteúdo e regras de indexação.
P: O Google sempre deixa de ler páginas renderizadas com JavaScript?
Não necessariamente, mas a incerteza é maior. A renderização exige recursos adicionais e, quanto mais a página depende de scripts, menor a probabilidade de o texto e os links da primeira tela serem lidos corretamente. Colocar o conteúdo principal no HTML inicial é o seguro de menor custo.
P: Quanto tempo leva para ver resultados?
Indexação e ranking não têm um prazo único; dependem da frequência de rastreamento, do tamanho do site e da concorrência. O que é certo: configurações erradas continuam valendo até que você as encontre e corrija.
Ferramentas relacionadas
- Google Search Console: ver relatórios de indexação de páginas e desempenho de busca
- Documentação de JavaScript SEO do Google: confirmar as regras reais de renderização e rastreamento
curl/ ferramentas de desenvolvedor do navegador: validar o HTML inicial e a legibilidade com JS desativado- Ferramenta de teste de dados estruturados: validar se o JSON-LD pode ser analisado
Links relacionados
- Noções básicas de JavaScript SEO do Google
- Leitura da atualização do guia de indexação do Google: páginas compartilháveis e conteúdo gerado
- Relatório de tamanho e tendências do mercado de Technical SEO Services
- Site oficial do We0
Resumo
A criação de sites com IA acelera a publicação, mas não muda a forma como os mecanismos de busca funcionam: eles leem HTML, cabeçalhos de resposta e estrutura de links, não a maquete que aparece na sua tela. Antes de publicar, revise sete pontos — HTML inicial, Title e Description, robots.txt e sitemap, canonical, noindex, dados estruturados, formulários e interações — e transforme essa revisão em processo. Assim, “site pronto, mas sem tráfego” deixa de ser a norma e passa a ser um problema diagnosticável.