O volume de pesquisa de palavras-chave responde a "quantas pessoas pesquisam com este conjunto de termos"; ele não responde "o que mais essa pessoa vai perguntar antes de tomar uma decisão". A busca por IA transforma a segunda questão em variável decisiva: quando um usuário faz uma pergunta com condições restritivas no ChatGPT, Perplexity, Gemini ou Google AI Mode, o mecanismo gera por conta própria múltiplas subconsultas para recuperar informações e depois monta os trechos recuperados em uma resposta com citações. O que determina se você será citado não é mais apenas estar ranqueado para uma palavra, mas se a página contém um trecho que possa ser extraído isoladamente e responda exatamente a uma subconsulta.
Portanto, a formulação mais precisa é: o volume de pesquisa continua sendo um sinal útil de escala de demanda, mas é um indicador de ponto de partida, não de ponto de chegada. A pesquisa de palavras-chave precisa incorporar três coisas — a cadeia completa de perguntas por trás dessa demanda, o formato de recuperação correspondente a cada pergunta e se a página possui blocos de resposta extraíveis.
Por que olhar apenas o volume de pesquisa deixa escapar a real intenção de compra
O fluxo tradicional é "palavra-chave principal → termos relacionados → conteúdo", que pressupõe que cada busca seja uma necessidade independente e com forma fixa. O comportamento do usuário já mudou: uma pergunta real frequentemente inclui simultaneamente orçamento, cenário, compatibilidade e modo de uso, por exemplo "um notebook de até 15 mil, que edite vídeo, tenha boa autonomia e seja fácil de levar em viagens". Essas condições, na busca por IA, são divididas em diferentes ramificações e recuperadas separadamente.
Tomemos como exemplo a compra B2B: por trás de "best CRM software" geralmente há uma sequência contínua de perguntas: qual é adequado para pequenas empresas? Suporta automação de e-mail? Integra com Shopify? Qual tem a menor mensalidade? O valor de recuperação dessas quatro perguntas pode ser maior que o da palavra original, mas o volume de pesquisa mensal costuma ser próximo de zero — poucas pessoas digitam a pergunta completa na caixa de busca, mas elas perguntam assim à IA.
Daí surgem duas lacunas. Primeiro, baixo volume de pesquisa não significa baixo valor comercial. Segundo, o volume de pesquisa não oferece nenhuma pista sobre o formato da resposta: ele não diz que necessidades comparativas exigem uma tabela, que necessidades processuais exigem passos numerados, que necessidades de definição exigem um trecho de trinta a cinquenta palavras que faça sentido sozinho. E são justamente esses formatos que determinam se o conteúdo pode ser recuperado.
O que é Query Fan-Out (fan-out de consultas)
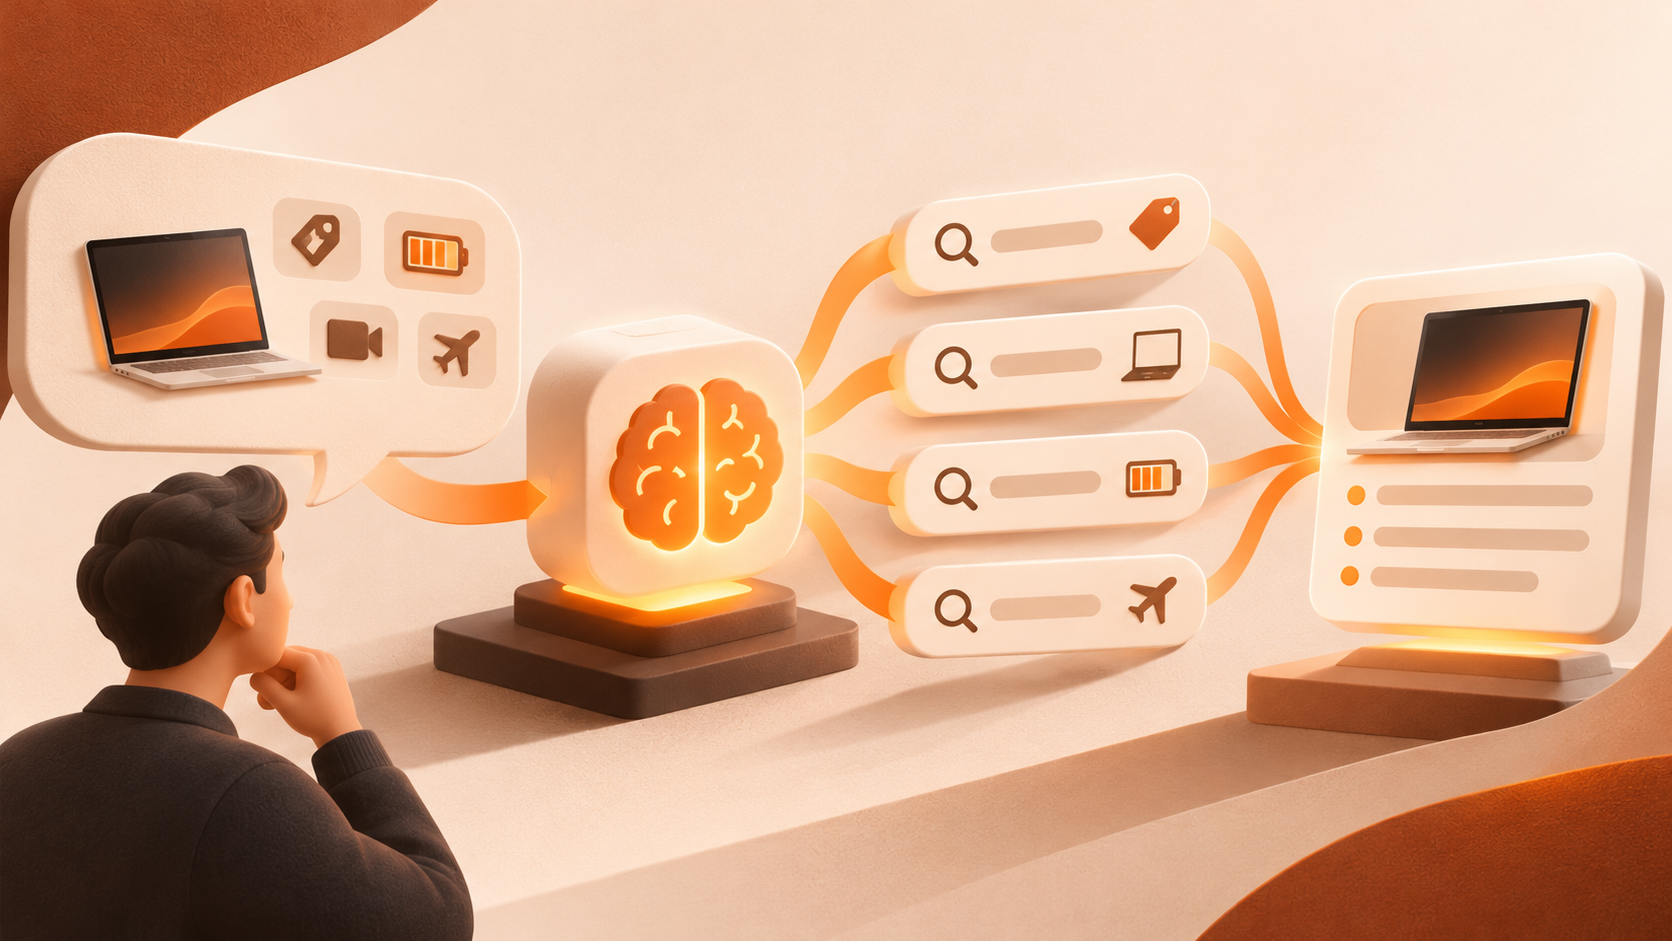
Query Fan-Out refere-se ao mecanismo em que o mecanismo de busca com IA divide uma pergunta em várias subconsultas geradas pelo próprio modelo, recupera em paralelo, pontua os trechos retornados e sintetiza uma resposta com citações. O Google explica na documentação de recursos de IA que experiências como AI Mode e AI Overviews podem usar essa técnica, apresentando "um conjunto mais amplo e diversificado de links úteis" do que a página de resultados convencional (Google Search Central).
Em termos de engenharia, geralmente são cinco etapas: identificar intenção e complexidade, gerar subconsultas, filtrar subconsultas altamente repetidas, recuperar em paralelo, sintetizar a resposta com citações. A terceira etapa é a mais facilmente ignorada: o sistema prefere cobertura em vez de repetição, e duas páginas com conteúdo semelhante geralmente não entram na recuperação ao mesmo tempo.
Em escala, observações públicas indicam aproximadamente: uma única pergunta no AI Mode gera cerca de 8–12 subconsultas paralelas (na prática, comumente 3–8); o ChatGPT faz em média 4,7 subconsultas por busca online; "centenas de buscas" aplica-se apenas a pipelines de múltiplas rodadas como o Deep Search, com limite de cerca de 20 rodadas. Mais importante é a forma das subconsultas — análises reversas mostram que elas têm em média 70–80 palavras, com complexidade cerca de 17–26 vezes maior que palavras-chave tradicionais de três ou quatro palavras (MaximusLabs). O mecanismo não busca com sua palavra-chave, mas com uma descrição completa que inclui contexto e cenário de uso.
O fan-out também não ocorre incondicionalmente. Patentes relacionadas vinculam a geração de subconsultas ao comprimento da entrada, frequência da consulta, qualidade dos resultados, número de tokens e carga do servidor. Perguntas curtas do tipo navegacional ou factual simples costumam executar apenas uma recuperação próxima à pergunta original; perguntas longas do tipo comparativo ou avaliativo é que desdobram a maior árvore de ramificações. O orçamento, portanto, deve ser priorizado em questões comerciais complexas.
A intenção de busca passa de "uma palavra" para "uma cadeia de perguntas"
As quatro categorias de intenção — navegacional, informacional, investigação comercial e transacional — continuam válidas, mas na busca por IA uma intenção principal desdobra-se em múltiplas camadas de subintenções. Tomemos como exemplo "How do I choose the best SEO tool for my business?": a intenção principal é escolher a ferramenta, mas as subintenções incluem: que tipo de ferramenta eu preciso? Qual o orçamento? Quais recursos são essenciais? Preciso de capacidade de SEO técnico? O que é adequado para iniciantes e para agências?
Aqui é preciso distinguir dois conceitos frequentemente confundidos: o agrupamento de palavras-chave agrupa termos semelhantes por intenção, semântica e sobreposição de SERP, resolvendo como organizar o conteúdo; o Query Fan-Out descreve como uma pergunta se fragmenta em múltiplos caminhos de recuperação, incluindo temas que o usuário nunca mencionou, resolvendo como a recuperação acontece (SEO for Today). O primeiro é método editorial, o segundo é mecanismo de engenharia, e não podem substituir um ao outro.
Tabela: oito tipos de subconsulta e os formatos de conteúdo necessários
Após classificar as ramificações do fan-out, uma pergunta geralmente gera oito tipos de subconsulta, cada uma exigindo um formato de trecho diferente. Esta tabela pode ser usada diretamente como checklist de conteúdo:
| Tipo de subconsulta | Exemplo | Formato de conteúdo necessário |
|---|---|---|
| Correspondência exata | best CRM software | Bloco de resposta que apresenta opções diretamente |
| Variante semântica | top CRM platforms | Reformular a mesma resposta com outra expressão do comprador |
| Navegacional | página de preços de um fornecedor | Página de produto ou preços rastreável e bem estruturada |
| Comparativo | A vs B for small business | Linhas de tabela com atributos claros |
| Definição | what is pipeline attribution | Definição curta de trinta a cinquenta palavras que faça sentido sozinha |
| Processual | how to migrate CRM data | Passos numerados, uma ação por passo |
| Lista | CRM tools for agencies | Lista escaneável com critérios de filtro |
| Cenário | CRM for a 3-person team | Frase qualificadora que nomeia tamanho da equipe e cenário de uso |
Páginas em prosa pura geralmente cobrem apenas dois ou três desses tipos: sem tabela, a ramificação comparativa não tem conteúdo para extrair; sem passos numerados, a ramificação processual fica vazia; se nunca se escreveu sobre tamanho de equipe, a ramificação de cenário não encontra correspondência. O formato aqui não é preferência de diagramação, mas a própria recuperabilidade.
De uma palavra-chave à cadeia completa de perguntas: método em cinco passos
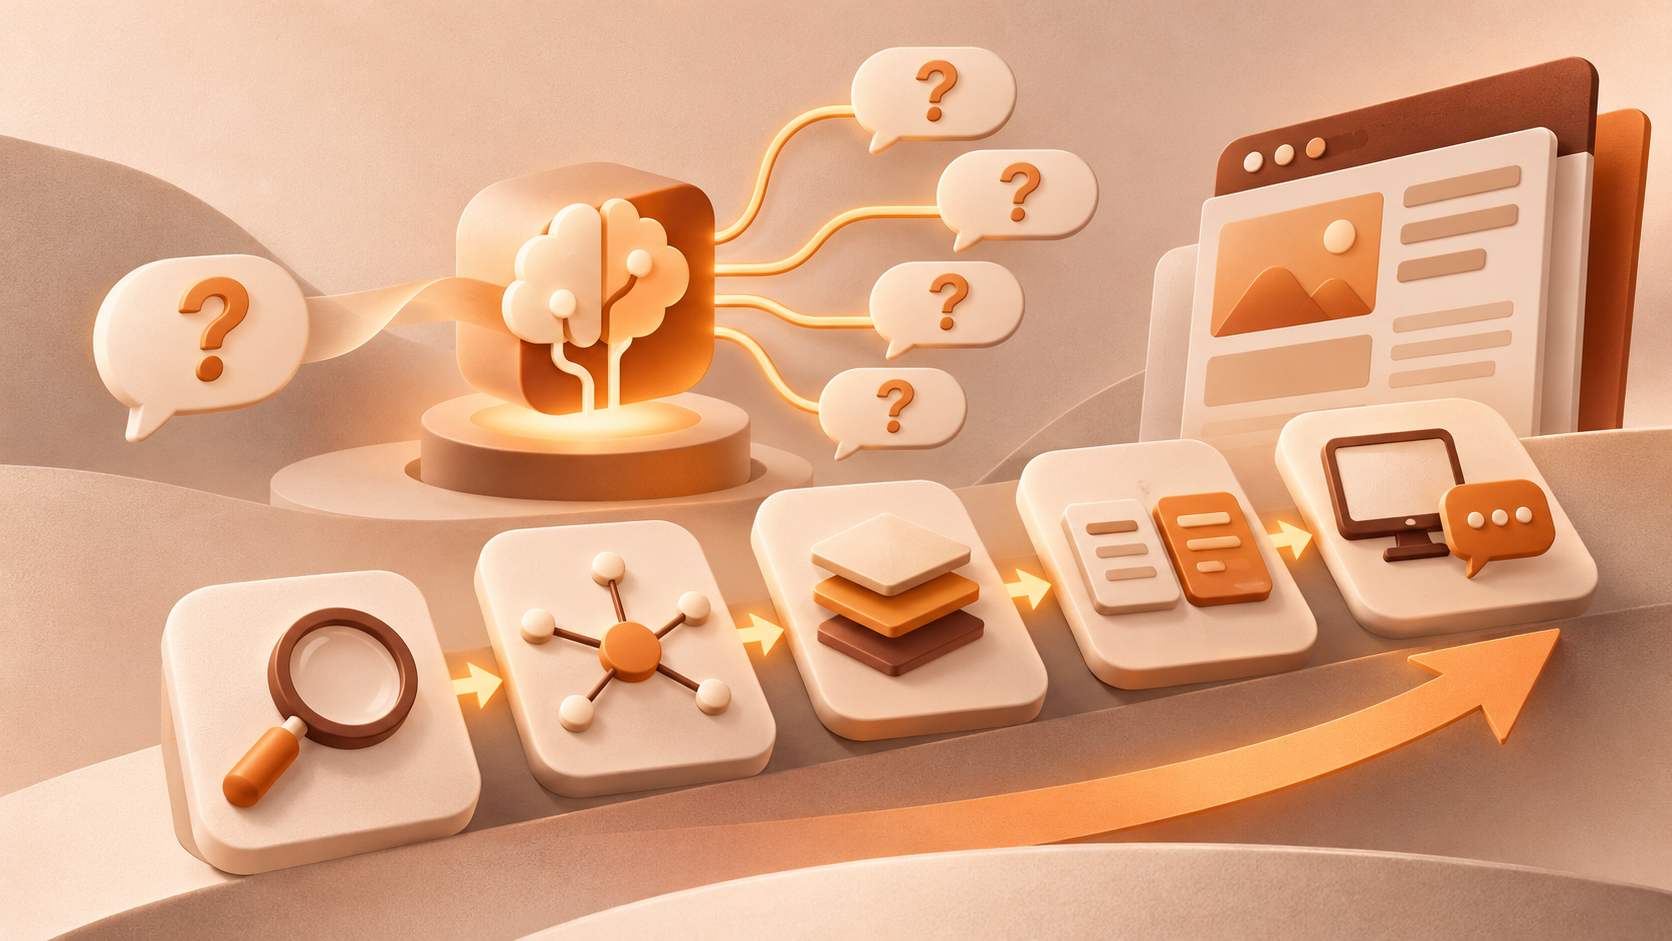
Primeiro passo: liste prompts-semente, não palavras-chave. Reúna 10–20 perguntas que um cliente ideal realmente faria antes de agendar uma demonstração, quanto mais coloquiais, melhor.
Segundo passo: coloque cada semente no Perplexity. A interface dele mostra a recuperação efetivamente executada, sendo hoje um dos poucos lugares onde é possível observar o comportamento de fan-out.
Terceiro passo: registre uma a uma as 5–8 perguntas relacionadas que ele traz, mantendo as palavras originais, sem reescrever como palavras-chave.
Quarto passo: use ferramentas de perguntas e respostas como AlsoAsked para cruzar a mesma lista de sementes e preencher ramificações que ficaram de fora.
Quinto passo: mapeie as subperguntas sobreviventes para H2 e H3 em páginas existentes. O princípio é "um cluster de perguntas por página", não "uma subconsulta por página": criar páginas rasas separadas para cada subconsulta dilui a autoridade e também tangencia a política do Google sobre abuso de conteúdo em escala (MaximusLabs).
É preciso deixar claro que a árvore real de ramificações é conversacional e personalizada, impossível de replicar completamente de fora. A cadeia de perguntas é uma aproximação reconstruída, adequada para planejamento de cobertura, não para ser reportada externamente como dado preciso.
Crie um site de apresentacao e gere leads em minutos
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Cluster de conteúdo: transformar a cadeia de perguntas em estrutura de três camadas
Na implementação, pode-se dividir em três camadas: a página pilar responde "qual é o quadro completo para tomar essa decisão"; as subpáginas absorvem subperguntas com demanda de busca independente, como comparação de determinado tipo de solução ou estrutura de preços de um setor; o bloco de FAQ absorve perguntas periféricas, como compatibilidade, reembolso, configuração mínima.
Para decidir se uma subpergunta deve ter página própria, use três verificações: ela seria perguntada isoladamente em uma conversa real? A tarefa de resposta dela é algo que a página pilar não consegue assumir sem sair do tema? Você consegue explicar em uma frase onde ela não se sobrepõe às páginas do mesmo nível? Só se as três passarem, crie uma nova página.
Ao mesmo tempo, é preciso ter consciência da diferença de prioridade no fundo do funil. O fan-out de perguntas de compra costuma se concentrar em preço, planos, limite gratuito, política de reembolso e comparação com concorrentes; páginas de comparação e de preços, portanto, entram mais facilmente no caminho de compra do que páginas de definição; perguntas de definição frequentemente são respondidas pelo próprio mecanismo, e vencê-las rende mais uma menção.
Como FAQ e página de produto devem dividir o trabalho
Os dois assumem tarefas de recuperação diferentes; misturá-los piora ambos. O objetivo da página de produto é deixar claro "se é adequado para mim": quem se aplica, que capacidades inclui, onde estão os limites, qual a estrutura de preços, como começar. Ela deve explicitar tamanho de equipe, cenário de uso, integrações e restrições, pois são exatamente essas as informações qualificadoras usadas pelas subconsultas de cenário para correspondência.
O objetivo do FAQ é eliminar atrito na decisão, respondendo perguntas periféricas que não entram no corpo principal, mas que o usuário certamente fará. Cada resposta deve fazer sentido fora de contexto: substitua pronomes por nomes de entidades, dê a conclusão primeiro e depois as condições, mantenha o comprimento em algumas dezenas de palavras.
A ordem estrutural dentro da página também é uma decisão de recuperação. Em observações de padrões de citação, cerca de 44% da cota de citações concentra-se nos primeiros 30% do corpo do texto, diminuindo gradualmente depois (MaximusLabs). Portanto, a resposta mais comercial deve aparecer no primeiro terço da página, e não no final.
É possível cobrir simultaneamente mecanismos de busca e busca conversacional?
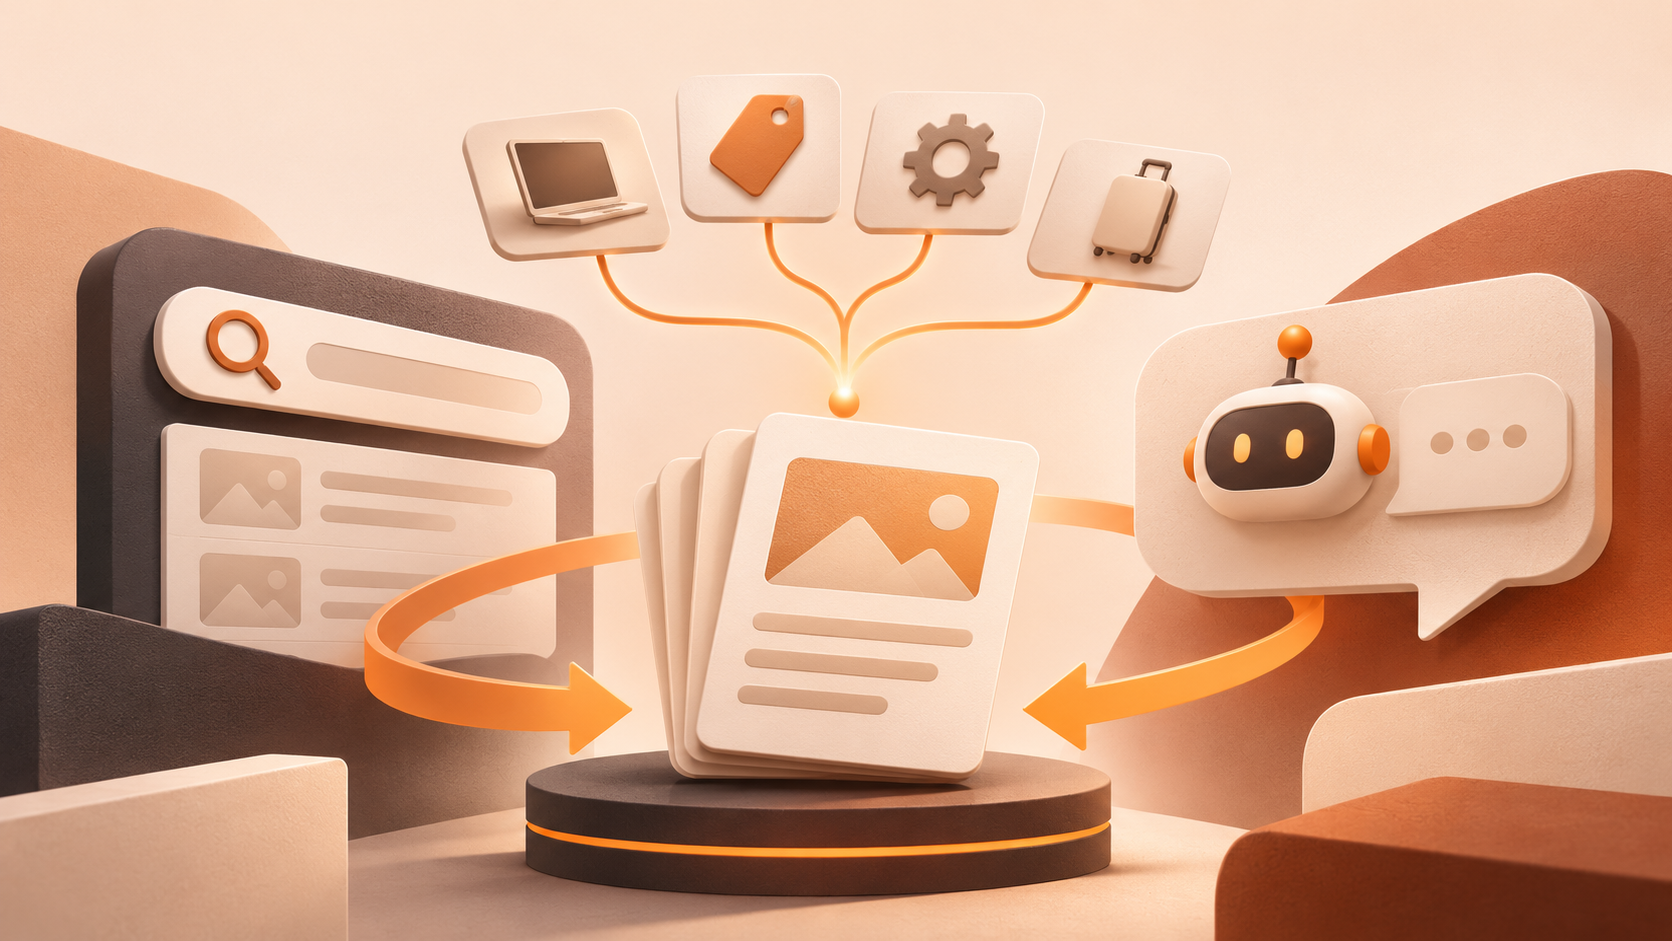
Na maioria dos casos, sim; a sobreposição é maior do que se imagina. As preferências de alguns dos principais pontos de entrada não conflitam: o AI Mode valoriza cobertura de subtemas e clareza dos trechos; o ChatGPT valoriza blocos de perguntas e respostas autossuficientes e sinais de especialização; o Perplexity valoriza atualidade e transparência das fontes; o modo de pesquisa do Claude valoriza profundidade e método. A interseção deles é: resposta antecipada, fonte visível, linguagem simples, corpo do texto com profundidade real.
Uma mudança direcional merece atenção: em observações públicas, a dependência das citações do AI Overview em relação aos 10 primeiros resultados orgânicos caiu de cerca de 76% para cerca de 38%, com outra parcela considerável de citações vindo de posições fora do top 100 (MaximusLabs). O significado não é "ranqueamento é inútil", mas "ranqueamento não é mais o único critério para citação" — o peso de o trecho poder ser extraído e responder diretamente à pergunta aumentou claramente.
O básico continua necessário: rastreabilidade técnica, estrutura de conteúdo, links internos e dados estruturados continuam sendo pré-requisitos para entrar nas experiências de busca por IA (Google Search Central).
O que as empresas devem fazer agora: checklist de seis itens
| Prioridade | Ação | Critério de conclusão |
|---|---|---|
| 1 | Substituir a lista de palavras-chave por 10–20 perguntas reais de clientes | Cada uma é uma pergunta coloquial completa |
| 2 | Rodar no Perplexity e registrar as perguntas subsequentes | Pelo menos 5 ramificações registradas por semente |
| 3 | Fazer autoavaliação de cobertura das oito subconsultas nas páginas comerciais centrais | Cobrir pelo menos seis das oito categorias |
| 4 | Adicionar um bloco de resposta independente sob cada H2 | Substituir pronomes por nomes de entidades, conclusão antes das condições |
| 5 | Mover os blocos mais comerciais para o primeiro terço | Aparecer dentro de uma tela após a primeira dobra |
| 6 | Atribuir uma única página de destino para cada cluster de perguntas | Não há duas páginas respondendo à mesma pergunta |
Ao mesmo tempo, mantenha parte do julgamento por volume de pesquisa: ele continua sendo um sinal de baixo custo para estimar escala de demanda, definir prioridades e avaliar sazonalidade. O que realmente deve ser abandonado é a regra linear "se o volume de pesquisa é alto, escreva; se é baixo, não escreva".
Como o we0 pode assumir essa cadeia
Para que a cadeia de perguntas se torne ativo de conteúdo, ela precisa finalmente aterrissar no site: estrutura de páginas, blocos de FAQ, tabelas comparativas, dados estruturados, versões multilíngues e ritmo de atualização subsequente. O caminho oferecido pelo we0.ai é colocar a criação do site e o crescimento de conteúdo no mesmo workspace: descrever a necessidade em linguagem natural, gerar páginas executáveis com colaboração de múltiplos agentes, ajustar no canvas visual e publicar em domínio próprio, depois manter o conteúdo continuamente pelo CMS e tratar as configurações de SEO e GEO no lado do site (we0.ai).
Para equipes que precisam validar rapidamente clusters de perguntas, o valor dessa integração não está em "quão rápido gera", mas em ir de uma frase de necessidade à publicação da página e à verificação de cobertura por cadeia de perguntas sem precisar transportar conteúdo e textos entre três ou quatro ferramentas.
FAQ
P: Ainda é preciso olhar o volume de pesquisa de palavras-chave?
Sim, mas para julgar escala de demanda e prioridade, não como única base para escolha de temas. O volume de pesquisa não reflete ramificações de subconsultas, formatos de resposta e níveis de intenção; esses três itens precisam ser complementados pela pesquisa de cadeia de perguntas.
P: Query Fan-Out e agrupamento de palavras-chave são a mesma coisa?
Não. O agrupamento de palavras-chave agrupa termos semelhantes por intenção e semântica, para organizar conteúdo; o fan-out de consultas é o mecanismo pelo qual o motor divide uma pergunta em múltiplas subconsultas recuperadas em paralelo, usado para explicar o comportamento de recuperação.
P: Como saber se minha página pode ser citada?
Comece pela extraibilidade: cada seção tem um bloco de resposta que faz sentido sozinho, nomeia entidades e cenários de aplicação, tem tabela ou passos, e a fonte é visível. Tudo isso pode ser verificado manualmente, sem depender de pontuações de terceiros.
P: E se uma equipe pequena não tiver orçamento para uma pesquisa completa?
Faça primeiro o ciclo mínimo: escolha 10 perguntas reais de clientes, rode a busca conversacional e registre as ramificações, complete as páginas comerciais centrais com tabelas, passos e blocos de resposta, e repita trimestralmente com data anotada, para distinguir se as mudanças vêm de ajustes de conteúdo ou de atualizações do motor.
Related Tools
- Documentação de recursos de IA do Google Search Central: confirmar o posicionamento oficial e os requisitos básicos.
- Perplexity: a interface mostra o processo de recuperação, adequado para observar o comportamento de fan-out.
- AlsoAsked: obter clusters de perguntas por palavra-chave e preencher ramificações que ficaram de fora.
- we0.ai: workspace integrado da criação do site à operação de conteúdo e configurações de SEO/GEO.
Related Links
- Google Search Central — AI features and your website
- MaximusLabs — What is Query Fan-Out?
- SEO for Today — Query Fan-Out: How AI Search Is Changing Keyword Research
- we0.ai — AI 智能建站与获客工作台
Summary
O volume de pesquisa não perdeu validade; ele apenas recuou da posição de "base para escolha de temas" para "referência de escala de demanda". O novo trabalho da pesquisa de palavras-chave é expandir uma palavra em uma cadeia completa de perguntas, preparar para cada pergunta um formato de resposta extraível e então alocar páginas por clusters de perguntas, não por palavras isoladas. Isso atende tanto os resultados de busca tradicionais quanto a busca conversacional que reescreve as próprias consultas. O critério de julgamento também muda: não é quantas buscas a palavra tem, mas se, quando o usuário encadear a quarta ou quinta pergunta, seu site ainda pode ser aquela resposta citada.