For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/amazon-s-1-8m-claude-overrun.md.
Agentes de IA podem falhar de maneiras que softwares comuns raramente apresentam: eles continuam tentando. Um funcionário humano que encontr...
Agentes de IA podem falhar de uma forma que o software comum raramente falha: eles tentam repetidamente.
Um funcionário humano que encontra um processo com falha eventualmente fica cansado, busca ajuda, vai para casa ou espera até a manhã seguinte para lidar com o problema.
Um agente autônomo pode continuar chamando modelos, lendo suas próprias saídas, tentando ferramentas novamente, reescrevendo planos e iniciando outro ciclo, por horas ou até dias.
Quando a tarefa é difícil, essa persistência é útil.
Quando a tarefa em si dá errado, essa persistência é cara.
De acordo com um relatório do Financial Times de julho de 2026, citando funcionários da Amazon e pessoas familiarizadas com projetos internos, um projeto da Amazon usando Claude Sonnet acumulou aproximadamente US$ 1,8 milhão em custos de IA ao tentar enriquecer informações de autores no site da Amazon.
Segundo o relatório, a fatura foi aproximadamente:
860% acima do orçamento do projeto
De acordo com o relatório, esse excedente não foi detectado por um período de:
cinco meses
E, apesar do enorme gasto, o projeto supostamente não foi implantado com sucesso.
Essa combinação torna o incidente mais significativo do que uma fatura anormalmente alta.
Ele revela um novo problema no software empresarial:
Pequeno erro de lógica
×
Tentativas autônomas repetidas
×
Cobrança por uso
×
Observabilidade fraca
=
Perda financeira significativa
Esse problema não é exclusivo do Claude, da Amazon ou de qualquer provedor de IA específico.
Sistemas de agentes convertem poder computacional em despesas operacionais variáveis. Quando são autorizados a operar de forma independente, o custo se torna parte do comportamento do aplicativo, e não mais uma simples assinatura de software.
Uma falha não produz mais apenas resultados incorretos.
Ela pode produzir resultados incorretos milhões de vezes enquanto continua gastando dinheiro.
A tarefa descrita no relatório do Financial Times parece comum.
A Amazon queria melhorar as informações dos autores em seu site.
Segundo o relatório, um fluxo de trabalho baseado em Claude Sonnet foi usado para ajudar a combinar ou gerar as informações de autor necessárias.
Em seguida, o projeto consumiu muito mais recursos de IA do que o esperado.
Funcionários da Amazon supostamente descreveram o custo final como aproximadamente:
US$ 1,8 milhão
Isso equivale a um estouro orçamentário estimado de:
860%
O detalhe mais notável pode ser o atraso na detecção.
O problema de custo supostamente permaneceu ativo ou não detectado por cerca de cinco meses.
Isso indica que a falha não foi apenas do modelo de IA.
Foi também uma falha de monitoramento e governança.
Se uma carga de trabalho empresarial pode gastar uma quantia de sete dígitos sem alertas claros, então o sistema carece de um ou mais controles que normalmente existem ao redor de outras infraestruturas de cobrança.
Esses controles podem incluir:
O Financial Times relatou que a Amazon também encontrou outros casos de custos de IA anormalmente altos, e que engenheiros estão desenvolvendo proteções automatizadas.
A Amazon disse à publicação que esses casos são lições isoladas, e não
uma representação de seu trabalho mais amplo em IA.
Essa distinção merece ser preservada.
O incidente de US$ 1,8 milhão foi, segundo o relato, uma falha de projeto interno.
Ele não prova que todo o programa de IA da Amazon é economicamente malsucedido.
O artigo original em chinês fez um cálculo exagerado.
Ele afirma que, ao preço de US$ 3 por milhão de tokens de entrada, US$ 1,8 milhão poderia comprar no máximo:
600 bilhões de tokens de entrada
A aritmética é simples:
US$ 1,8 milhão
÷
US$ 3 por milhão de tokens
=
600.000 milhões de tokens
=
600 bilhões de tokens
Mas isso não é uma medida do consumo real de tokens do projeto da Amazon.
É apenas um cálculo ilustrativo de limite máximo sob várias suposições irrealistas:
Os preços atuais da Anthropic também variam conforme a geração do Sonnet.
Em agosto de 2026, a tabela de preços da Anthropic é a seguinte:
| Modelo | Entrada padrão | Saída padrão |
|---|---|---|
| Claude Sonnet 5 | US$ 2/milhão de tokens | US$ 10/milhão de tokens |
| Claude Sonnet 4.6 | US$ 3/milhão de tokens | US$ 15/milhão de tokens |
| Claude Sonnet 4.5 | US$ 3/milhão de tokens | US$ 15/milhão de tokens |
*O relatório do Financial Times confirma o Claude Sonnet, mas os relatos públicos não fornecem detalhes de cobrança suficientes para reconstruir a versão exata do modelo, a proporção entrada/saída, o comportamento de cache ou o número real de tokens.
Portanto, a conclusão defensável é:
Segundo o relato, o projeto custou cerca de US$ 1,8 milhão; seu consumo exato de tokens não é conhecido pelo público.
Isso é importante porque, quando um valor em dólares é automaticamente convertido em tokens usando um único preço fixo, a análise de custos de IA empresarial se torna enganosa.
O software tradicional geralmente tem fatores de custo relativamente previsíveis.
As equipes podem estimar:
Os agentes de modelos de linguagem adicionam outra camada de complexidade.
Uma solicitação de usuário pode acionar:
1 chamada de modelo
Ou pode acionar:
200 chamadas de modelo
+ chamadas de ferramentas
+ tentativas repetidas
+ repetição de contexto
+ pesquisas na web
+ execução de código
O usuário pode ver apenas uma resposta final.
O medidor de custo vê toda a trilha do processo.
Os agentes tendem a reenviar grande parte do contexto de trabalho a cada etapa do raciocínio.
Portanto, um código extenso, documentos grandes, histórico de ferramentas ou conversas podem ser cobrados repetidamente.
O texto gerado anteriormente pelo agente frequentemente se torna o contexto da próxima chamada de modelo.
O sistema efetivamente gasta dinheiro primeiro para gerar informações e depois gasta novamente para lê-las.
Uma chamada de ferramenta com falha pode acionar:
Um loop de tentativas que parece inofensivo no nível do código pode gerar um consumo massivo de tokens.
aleatórios
Pesquisas sobre codificação com agentes descobriram que o uso de tokens para a mesma tarefa pode variar enormemente entre execuções.
Um estudo de 2026 com vários modelos de fronteira no SWE-bench Verified relatou diferenças de até cerca de 30 vezes na mesma tarefa entre execuções diferentes.
Mais tokens também nem sempre produzem melhores resultados.
Isso torna "estimar a fatura com base na dificuldade da tarefa" um método de orçamento não confiável.
O artigo original então passou do incidente de US$ 1,8 milhão para um ponto de vista mais amplo.
A Amazon não está recuando na IA.
Ela está aumentando seus investimentos.
O CEO Andy Jassy afirmou repetidamente que a IA generativa e os agentes remodelarão os produtos para clientes e o trabalho interno da Amazon.
Em junho de 2025, Jassy disse aos funcionários que a Amazon já tinha mais de:
1.000 serviços e aplicações de IA generativa
tanto já construídos quanto em andamento.
Ele também previu:
bilhões de agentes de IA
em empresas e setores diversos.
Jassy afirmou que os agentes podem executar tarefas como:
Ele também disse que a aplicação mais ampla da IA mudará a estrutura de funcionários da Amazon, podendo reduzir o número total de funcionários corporativos da empresa no longo prazo, à medida que a eficiência aumentar.
Portanto, este incidente de 1,8 milhões de dólares envolvendo Claude ocorreu dentro de uma empresa que deliberadamente promove mais automação, e não menos.
A escala do investimento em infraestrutura da Amazon é enorme.
No ciclo de resultados do segundo trimestre de 2026, Jassy elevou a previsão de despesas de capital da empresa para 2026 para aproximadamente:
220 mil milhões de dólares
Acima do plano anterior de cerca de 200 mil milhões de dólares.
A maior parte dessas despesas está relacionada com:
A carta anual da Amazon aos acionistas de 2025 já explicava que a empresa não fez a estimativa anterior de 200 mil milhões de dólares "por intuição".
Jassy afirmou que a AWS tem compromissos de clientes suficientes para justificar a racionalidade da maior parte da construção de infraestrutura.
Isto cria um contraste marcante:
A Amazon está a investir centenas de milhares de milhões de dólares
na expansão da capacidade de IA

enquanto também aprende
como impedir que uma única carga de trabalho de IA
desperdice milhões de dólares.
Estes dois problemas não são contraditórios.
Capacidade de infraestrutura e eficiência de cargas de trabalho são coisas distintas.
O artigo original aponta corretamente que os gastos da Amazon em IA e cloud não geram apenas custos.
Os resultados oficiais da Amazon para o segundo trimestre de 2026 mostram um forte crescimento da AWS.
No trimestre terminado a 30 de junho de 2026:
| Métrica | Segundo trimestre de 2026 |
|---|---|
| Vendas líquidas totais da Amazon | 200,6 mil milhões de dólares |
| Vendas líquidas da AWS | 42,2 mil milhões de dólares |
| Crescimento anual das vendas da AWS | 37% |
| Lucro operacional total da Amazon | 27,5 mil milhões de dólares |
| Lucro operacional da AWS | 16,6 mil milhões de dólares |
Assim, a AWS contribuiu com aproximadamente:
60% do lucro operacional da Amazon
representando também cerca de:
21% das vendas líquidas totais
nesse trimestre.
A Amazon também afirmou que a taxa de execução de receita anualizada dos seus negócios de IA e de chips já ultrapassou os 25 mil milhões de dólares.
Portanto, a empresa tem fortes razões económicas para continuar a promover a adoção de IA, ao mesmo tempo que melhora a disciplina de custos.
Os gastos com IA são apenas um aspeto do plano de automação da Amazon.
A empresa também está a reduzir postos de trabalho corporativos.
Em outubro de 2025, uma reportagem da Reuters afirmou que a Amazon planeava cortar até 30 mil postos de trabalho corporativos.
Jassy também disse aos funcionários que a adoção mais ampla de IA generativa pode significar menos empregos em certas categorias e mais noutras.
É importante notar que não se pode simplificar cada despedimento da Amazon como "a IA substituiu funcionários".
As reduções de força de trabalho em grandes empresas podem envolver:
O que é claro é que a própria Amazon espera que a IA mude as suas necessidades futuras de funcionários.
A fonte passa depois da automação de escritórios para armazéns e logística.
A reportagem, baseada em documentos internos da Amazon, descreve uma estratégia robótica ambiciosa.
Segundo a mesma, o objetivo é automatizar grande parte das operações de armazém nos próximos anos, o que pode permitir à Amazon evitar a contratação adicional de centenas de milhares de funcionários quando o volume de mercadorias crescer.
Uma estimativa amplamente divulgada afirma que a automação pode permitir à Amazon evitar:
a contratação adicional de cerca de 160 mil funcionários nos EUA até 2027
e mais de:
600 mil funcionários adicionais até cerca de 2033
em comparação com um caminho de crescimento menos automatizado.
Estes números baseiam-se em projeções internas noticiadas, e não num compromisso público da Amazon de despedir 600 mil funcionários existentes.
Esta distinção é importante.
"Evitar contratações futuras" e "eliminar postos existentes" são economicamente relacionados, mas não idênticos.
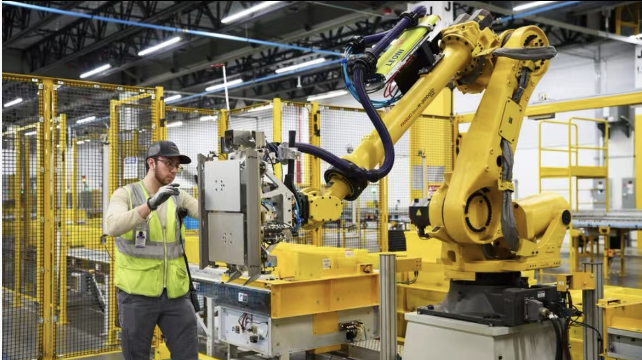
A Amazon sublinha publicamente que a robótica também pode criar funções diferentes nas seguintes áreas:
O impacto laboral de longo prazo continua a ser objeto de debate.
O economista Daron Acemoglu é um dos principais críticos, alertando que a automação agressiva por grandes empregadores pode transformar as empresas de criadoras de emprego em massa em entidades que eliminam ou evitam um grande número de postos de trabalho.
A segunda secção principal da fonte
afasta-se da Amazon para um comportamento mais amplo do Vale do Silício: tokenmaxxing (maximização do consumo de tokens).
Durante algum tempo, as empresas promoveram a adoção de IA de forma tão agressiva que o próprio volume de utilização se tornou um símbolo de estatuto.
Os gestores queriam que os funcionários:
Em algumas organizações, esse incentivo evoluiu para tabelas de classificação.
E quando uma métrica se torna visível, os funcionários aprendem a otimizar essa métrica.
Este é um caso clássico da lei de Goodhart:
Quando uma métrica se torna um objetivo, deixa de ser uma boa métrica.
A empresa quer uma aplicação produtiva da IA.
Mede o consumo de tokens, porque o consumo de tokens é fácil de contabilizar.
Os funcionários aumentaram então o consumo de tokens.
Os números subiram.
Mas a produção eficaz não aumentou necessariamente.
A Amazon tinha uma tabela de classificação interna não oficial chamada KiroRank.
Ela acompanhava ou classificava os funcionários com base na sua atividade envolvendo o Kiro (a ferramenta de desenvolvimento de IA da Amazon).
Segundo a Business Insider e o Financial Times, alguns funcionários começaram a executar tarefas de IA desnecessárias para melhorar as suas pontuações.
A Amazon acabou por desativar a tabela de classificação.
O vice-presidente sénior Dave Treadwell disse aos funcionários para não usarem IA pelo simples facto de a usar.
A Amazon passou a adotar métricas mais focadas na produção real, incluindo um indicador chamado deploys normalizados (normalized deployments).
A lição é simples:
Consumo de tokens
≠
Produtividade
Um programador que usa 100 milhões de tokens sem entregar nada não é automaticamente mais eficiente do que um que resolve um problema com 5 milhões de tokens.
Segundo relatos, a Meta também realizou experiências semelhantes.
Uma tabela de classificação interna criada por funcionários, chamada Claudeonomics, agregava o uso de IA de mais de 85 mil funcionários e mostrava os 250 principais utilizadores.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Nos relatos, surgiram títulos como:
Imortal de Sessão (Session Immortal).
De acordo com o The Information, funcionários da Meta consumiram dezenas de trilhões de tokens em um período contínuo de 30 dias.
Relatos posteriores situaram o total de 30 dias em cerca de:
73,7 trilhões de tokens
A Meta então passou a adotar controles de uso mais rígidos e criou um Gateway de IA (AI Gateway) centralizado para visibilidade de custos e gerenciamento de orçamento.
Esses dados são baseados em cobertura de relatos internos, não nas demonstrações financeiras públicas da Meta.
O artigo de origem também converteu os 73,7 trilhões de tokens em uma fatura hipotética de US$ 221 milhões por mês.
Esse número não deve ser considerado como o valor real da fatura da Meta.
Essencialmente, é:
73,7 trilhões de tokens
×
US$ 3 por milhão de tokens
≈
US$ 221 milhões
Isso pressupõe que cada token seja cobrado pelo preço de tabela de um token de entrada.
O uso real pode envolver modelos diferentes, tarifas empresariais negociadas, combinações de entrada/saída, cache, modelos internos e acordos de plataforma.
O fato útil é a escala de uso de tokens relatada — não a conversão simplificada de faturamento.
A Uber também enfrentou problemas orçamentários semelhantes.
Relatos de junho de 2026 afirmam que a empresa esgotou o orçamento anual de suas ferramentas de codificação com agentes inteligentes já no primeiro trimestre.
Quatro meses do ano.
Em seguida, a Uber introduziu limites padrão:
US$ 1.500 por funcionário
por mês
por ferramenta de codificação com IA
O limite se aplica separadamente às seguintes ferramentas:
Os funcionários podem visualizar seu próprio uso por meio de um painel interno e aprovar exceções se houver justificativa para gastos adicionais.
Essa abordagem se aproxima mais do FinOps tradicional em nuvem.
A questão mudou de:
Quanta IA os funcionários usaram?
Para:
Quanto custou esse fluxo de trabalho e o resultado valeu a pena?
Executivos da Uber sempre defenderam que a IA pode trazer ganhos significativos de eficiência.
A mudança não é de "usar IA" para "não usar IA".
É de consumo ilimitado para consumo gerenciado.
Os provedores de modelos também enfrentam essas questões econômicas internamente.
Em um evento empresarial em junho de 2026, Sam Altman afirmou que o maior usuário interno de tokens da OpenAI consome cerca de:
100 bilhões de tokens por mês
Ele comparou isso a cerca de seis anos e meio atrás, quando 100 mil tokens por mês já pareciam anormalmente altos.
O Business Insider também citou uma reportagem do The New York Times segundo a qual um funcionário da OpenAI usou cerca de:
210 bilhões de tokens em uma semana
Altman disse que os custos passaram de um problema que os clientes quase não mencionavam no início de 2026 para um:
"problema enorme"
naquele ano.
A ironia é evidente.
Os laboratórios de IA querem que os modelos fiquem mais baratos para que os clientes possam usar mais IA.
À medida que os modelos ficam mais baratos e os agentes se tornam mais autônomos, o crescimento do uso total pode superar a queda no preço unitário.
Isso é uma manifestação do efeito Jevons:
Custo unitário menor
→ Mais uso
→ Gasto total possivelmente maior
A governança de custos é difícil porque o uso de IA está espalhado por toda parte.
As empresas podem pagar por IA por meio de:
Um relatório para CFOs do The Wall Street Journal citou uma pesquisa que descobriu que apenas:
26% das empresas
têm visibilidade completa de seus custos de IA.
Isso significa que muitas empresas já estão tentando otimizar os gastos com IA antes de conseguir atribuir esses custos de forma confiável.
As equipes financeiras podem saber o total da fatura do fornecedor, mas não sabem:
Um sistema útil de custos de IA empresarial deve responder a perguntas em vários níveis.
Rastreie por:
Diferencie:
Relacione os custos a:
Monitore:
O objetivo não é apenas reduzir tokens.
É detectar tokens de baixo valor.
Um limite mensal em dólares é útil, mas incompleto.
Agentes de nível de produção geralmente devem ter vários limites simultaneamente.
Exemplo:
Por tarefa:
  Tempo máximo de execução: 30 minutos
  Número máximo de chamadas de modelo: 80
  Máximo de novas tentativas por ferramenta: 3
  Custo máximo: US$ 5

Por usuário:
  Orçamento diário: US$ 50

Por equipe:
  Orçamento mensal: US$ 25.000

Global:
  Alerta de anomalia quando o gasto por hora aumentar +100%
  Interruptor de emergência para desligamento total
Os valores específicos dependem do cenário de uso.
A arquitetura é a parte essencial.
Um sistema fora de controle deve colidir com várias barreiras independentes antes de causar uma surpresa de sete dígitos.
O software tradicional normalmente espera uma nova solicitação para continuar trabalhando.
Um agente pode criar a própria próxima ação.
Isso muda o modelo de risco.
Suponha que um agente receba uma instrução como:
Encontre o registro de autor correto e atualize o banco de dados.
Ele descobre que há uma correspondência ambígua.
Ele busca novamente.
Então pede ao modelo para comparar os candidatos.
Então ele tenta novamente uma API.
Então gera novas consultas de busca.
Então expande o contexto.
Então ele faz um loop.
Se o critério de sucesso não estiver bem definido, o sistema pode permanecer "ocupado" por muito tempo sem ficar mais correto.
Os agentes precisam de um conceito de:
parar
seja por motivos técnicos ou financeiros.
O texto original termina citando um famoso caso de fracasso de automação da era pré-IA: Knight Capital.
A analogia é útil porque o problema da Knight não tinha nada a ver com LLMs.
Foi uma falha em software automatizado, controle de implantação e limitação de perdas.
Em 1º de agosto de 2012, a Knight Capital implantou um novo software de negociação para o programa de liquidez de varejo da Bolsa de Valores de Nova York.
De acordo com a Securities and Exchange Commission (SEC) dos EUA, um erro de implantação deixou um código antigo ainda ativo em um servidor.
Quando o novo sistema entrou no ar, aquela funcionalidade adormecida começou a enviar ordens não intencionais ao mercado.
O sistema continuou operando por aproximadamente:
45 minutos
A SEC afirmou posteriormente que a Knight acumulou uma carteira não intencional de valores mobiliários de bilhões de dólares, com perdas superiores a:
US$ 460 milhões
O artigo original em chinês usava o número comumente citado de US$ 440 milhões. Os materiais de execução posteriores da SEC usam mais de US$ 460 milhões, portanto esta tradução adota o número do órgão regulador para garantir precisão.
As críticas da SEC não se resumem ao fato de o software ter uma falha.
Software sempre tem falhas.
As falhas mais graves incluem:
O sistema da Knight executa à velocidade da máquina.
Essa velocidade é
em circunstâncias normais, uma vantagem.
Durante uma falha, a mesma velocidade amplifica os danos.
O padrão básico é quase idêntico ao risco de custo de agente:
Automação funcionando normalmente
→ Velocidade é valor

Automação com falha
→ Velocidade amplifica perdas
O sistema da Knight gastava dinheiro diretamente por meio de negociações.
A maioria dos agentes empresariais não tem acesso a corretoras.
Mas eles têm um medidor.
Cada chamada de modelo pode gerar custo.
Cada ferramenta pode ter impacto downstream.
Certos agentes também podem ser autorizados a executar:
À medida que os sistemas de IA ganham mais permissões, seus modos de falha começam a se parecer cada vez menos com erros de chatbot e mais com perda de controle de automação.
É por isso que a governança de IA precisa cada vez mais aproveitar conceitos familiares de sistemas financeiros e infraestrutura de nuvem:
O texto original termina com o princípio correto.
A automação promete:
Essas vantagens são reais.
Mas os sistemas não amplificam seletivamente apenas o comportamento correto.
Eles também amplificam:
A automação mais perigosa não é necessariamente aquela que falha imediatamente.
É aquela que ainda parece produtiva enquanto falha rapidamente, repetidamente e de forma invisível.
O projeto de US$ 1,8 milhão da Amazon com Claude não é, segundo relatos, um motivo para parar de usar agentes.
É um motivo para parar de tratar o consumo de agentes como um experimento sem medição.
O ponto não é reduzir a fatura ao mínimo a qualquer custo.
É tornar a fatura explicável.
O Financial Times relatou que um projeto da Amazon usando Claude Sonnet acumulou cerca de US$ 1,8 milhão em custos, excedendo o orçamento em aproximadamente 860%, e o problema levou cerca de cinco meses para ser descoberto. O número vem de relatos internos de funcionários, não de um relatório público de incidentes da Amazon.
O projeto da Amazon realmente usou 600 bilhões de tokens?
Esse número é apenas um exemplo aritmético aproximado, baseado em US$ 1,8 milhão dividido pelo preço de US$ 3 por milhão de tokens de entrada. A contagem real de tokens do projeto, versão do modelo, combinação de entrada/saída, uso de cache e outras taxas não foram divulgadas publicamente.
A Anthropic atualmente lista o Claude Sonnet 5 a US$ 2 por milhão de tokens de entrada padrão e US$ 10 por milhão de tokens de saída. Os preços listados para Sonnet 4.6 e 4.5 são US$ 3 e US$ 15, respectivamente, sem incluir diferenças aplicáveis de cache, processamento em lote ou plataforma de nuvem.
Os agentes podem fazer várias chamadas de modelo para uma única solicitação de usuário, reproduzir grandes contextos, chamar ferramentas e repetir automaticamente operações com falha. Se o fluxo de trabalho entrar em loop ou não tiver condição de parada, os gastos podem continuar aumentando mesmo quando a tarefa não está mais gerando progresso válido.
KiroRank é, segundo relatos, um ranking interno informal relacionado ao uso da ferramenta de IA Kiro da Amazon pelos funcionários. De acordo com relatos, a Amazon o desativou depois que os funcionários começaram a otimizar exclusivamente essa métrica, e a liderança também instruiu os funcionários a não usar IA apenas para aumentar o uso.
Controles eficazes incluem: orçamentos em dólares por tarefa, limites no número de chamadas de modelo, limites de repetição, tempos limite, cotas por usuário e por equipe, alertas de anomalias, atribuição de uso e um botão de desligamento de emergência. A melhor métrica geralmente é o custo por resultado de negócio bem-sucedido, em vez do volume bruto de tokens.
A Knight Capital perdeu mais de US$ 460 milhões em cerca de 45 minutos depois que uma implantação de negociação automatizada falhou por falta de mecanismos de segurança adequados. O incidente ilustra o mesmo princípio geral: a automação aumenta a velocidade do trabalho eficaz, mas também aumenta a velocidade e a escala das falhas.
A redução de preço sozinha não é suficiente. Preços unitários mais baixos podem incentivar maior uso, especialmente quando os agentes operam de forma autônoma. As empresas ainda precisam de visibilidade, orçamentos, roteamento, cache e medição baseada em resultados.
levando a gastos fora de controle](https://www.ft.com/content/77baac40-d803-4084-94f3-a133653072cf): Relatório principal sobre o projeto Claude de US$ 1,8 milhão da Amazon e outros estouros de custos internos.
com/news/company-news/amazon-ceo-andy-jassy-on-generative-ai): Memorando oficial da Amazon, descrevendo mais de 1.000 serviços de IA generativa, bem como a expectativa de Jassy sobre bilhões de agentes no futuro.
Segundo relatos, um projeto da Amazon que usava Claude Sonnet acumulou uma conta de US$ 1,8 milhão, excedendo o orçamento em cerca de 860%, levou cinco meses para ser detectado e, no final, nunca chegou a ser implantado. O caso demonstra que, quando um agente pode consumir repetidamente recursos de IA cobrados por uso sem condições robustas de parada, um erro de software comum pode se tornar extraordinariamente caro.
A Amazon não está saindo do campo da IA. A AWS cresce rapidamente, a empresa prevê cerca de US$ 220 bilhões em despesas de capital em 2026, e Andy Jassy descreve um futuro com bilhões de agentes. Portanto, a resposta ao custo fora de controle tende a ser um reforço na governança de custos, e não uma redução da automação.
A mesma transformação é visível em todo o Vale do Silício. A Amazon desativou o KiroRank, a Meta migrou do tokenmaxxing para um sistema orçamentário, a Uber estabeleceu um limite mensal de US$ 1.500 por funcionário para cada ferramenta de codificação, e Sam Altman afirmou que, mesmo dentro da OpenAI, os custos de IA se tornaram uma grande preocupação.
O fracasso da Knight Capital oferece uma lição eterna: a automação não apenas amplifica a eficiência. Quando os controles são frágeis, ela amplifica os erros na mesma velocidade.
A métrica correta de IA empresarial não é "quantos tokens usamos?", mas sim "que resultados mensuráveis esses tokens produzem e, quando deixam de gerar valor, o que faz o sistema parar?"
Comece com uma frase e tenha um site completo em minutos.



