For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/anthropic-s-2021-roadmap-coding-agents-to-438c8006.md.
Um curto roteiro de pesquisa da Anthropic, de julho de 2021, descreve um assistente que poderia conversar com pessoas enquanto cria, edita e...
Um curto roteiro de pesquisa da Anthropic, de julho de 2021, descreve um assistente que poderia conversar com pessoas enquanto cria, edita e explica software. Lido hoje, é fácil reconhecer questões que ainda moldam os agentes de programação: como explorar um repositório, usar ferramentas, aprender com feedback e agir com segurança em um ambiente real.
A cópia publicamente vinculada é interessante por essas conexões, e não porque prove que uma versão finalizada do Claude Code existia cinco anos antes. Ela registra objetivos de pesquisa e divergências. Esse é um tipo de evidência diferente de um produto lançado, de um experimento concluído ou de uma declaração sobre a arquitetura atual dos modelos.
O objetivo de longo prazo do documento é uma AGI segura e benéfica. Sua prova de conceito proposta é um assistente geral que possa trabalhar com uma pessoa em software por meio de linguagem natural.
As tarefas descritas vão além de completar os próximos caracteres de código. Elas incluem responder a perguntas, escrever funções, localizar bugs, projetar APIs e discutir estilo e boas práticas. O estado final ambicioso é a amplitude de um colega de engenharia de software.
A redação também reconhece que a equipe não esperava alcançar esse objetivo imediatamente. Ela apresenta uma direção de pesquisa, razão pela qual o documento não deve ser descrito retroativamente como um plano de lançamento do Claude Code em 2021, com todos os recursos atuais já definidos.
A documentação atual do Claude Code permite comparar essa ambição ampla com um produto real. A continuidade temática é clara; o documento, por si só, não estabelece um histórico ininterrupto de implementação para cada recurso.
Os comentários revelam uma tensão prática entre criar algo útil imediatamente e demonstrar uma capacidade mais geral.
Tom Brown sugere a navegação em repositórios como um ponto de partida valioso. Nelson Elhage dá um exemplo concreto: encontrar definições de tipos em um projeto. Essas são necessidades comuns de desenvolvedores, especialmente ao entrar em uma base de código desconhecida.
Andy Jones contrapõe essa abordagem a uma demonstração que enfatiza depuração com printf e uso de editor. A busca em repositórios poderia ser um excelente primeiro recurso para um assistente de programação, enquanto essas outras ações poderiam oferecer uma demonstração mais convincente de que um modelo consegue usar ferramentas.
A resposta de Dario Amodei prioriza a demonstração de uso de ferramentas no curto prazo e o programador altamente capaz no longo prazo. Essa troca é útil porque mostra o sequenciamento como uma escolha explícita. Um marco inicial de pesquisa pode ser valioso mesmo quando ainda não é o produto completo mais útil.
A seção de pré-treinamento pede modelos sólidos de linguagem e código, conjuntos de dados orientados a código e avaliações que conectem capacidades a ajustes finos posteriores. Ela também discute a ciência de treinar modelos arbitrariamente grandes, incluindo 1T e maiores.
Esse é um objetivo de pesquisa declarado. Não é uma revelação de que algum modelo Claude atual tenha um trilhão de parâmetros, nem uma prova de que a equipe já tivesse treinado tal modelo em 2021.
A mesma seção considera contextos muito grandes ou uma forma equivalente de incorporar memória e experiência substanciais. Isso mantém abertos vários mecanismos possíveis, em vez de prescrever um único design atual de janela de contexto.
| Item do roteiro | O que ele sustenta | O que ele não estabelece |
|---|---|---|
| Um assistente geral de software | A colaboração em software era um objetivo inicial de pesquisa. | Uma versão finalizada do Claude Code em 2021. |
| Modelos de 1T de parâmetros ou mais | Escala muito grande fazia parte da agenda de pesquisa. | A quantidade de parâmetros de uma versão atual do Claude. |
| Contextos grandes ou memória equivalente | A equipe considerava experiência e memória estendidas. | Uma arquitetura fixa ou o limite exato de tokens atual. |
| Uso de ferramentas por meio de busca, depuração e edição | A agenda incluía atuar em ambientes de software. | Operação autônoma confiável e sem restrições. |
A seção sobre feedback humano e alinhamento inclui o estudo de como os julgamentos de modelos correspondem aos julgamentos humanos sobre comportamento e qualidade de amostras. Ela menciona explicitamente a autoavaliação e conecta a questão a viés, equidade e consequências sociais.
Essa é uma formulação inicial relevante para usar as próprias avaliações de um modelo como objeto de pesquisa. Ela não demonstra que esses julgamentos sejam automaticamente confiáveis ou que um modelo possa certificar com segurança a própria saída.
O documento também menciona computação em tempo de teste em uma discussão sobre treinamento de GAN ou discriminadores e leis de escala. Isso mostra que a equipe pensava em computação além do pré-treinamento. Não deve ser equiparado, sem ressalvas, a todas as técnicas posteriores de modelos de raciocínio, nem tratado como prova de que um sistema moderno de escalonamento em tempo de inferência já estava especificado.
A distinção fortalece a comparação histórica. O documento expõe questões de pesquisa relacionadas sem exigir que o leitor finja que vocabulário semelhante significa métodos idênticos ao longo de cinco anos.
Um dos comentários mais diretamente relevantes pergunta como implantar ferramentas sem sandbox de forma segura. Amodei esclarece a preocupação específica: ferramentas que executam código no momento da implantação.
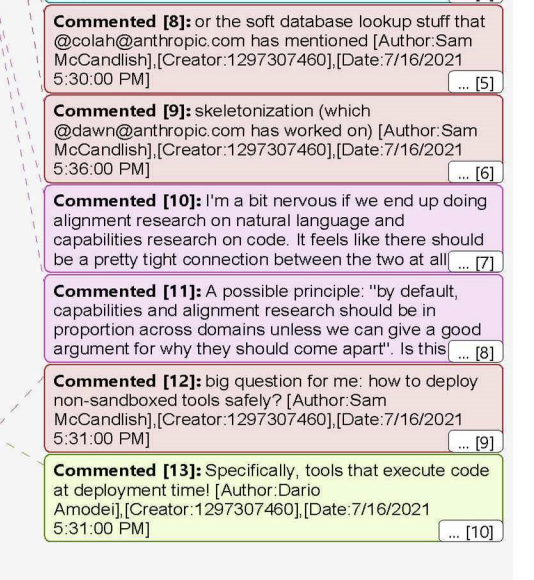
Fonte: a cópia do roteiro de julho de 2021, reproduzida pela QbitAI no BAAI Hub. Os comentários correspondentes estão visíveis no PDF vinculado, incluindo as páginas de comentários expandidos.
Essa preocupação continua compreensível no contexto de agentes. Um sistema que pode executar comandos ou editar arquivos pode alterar seu ambiente, portanto o comportamento seguro não pode ser avaliado apenas pela polidez ou plausibilidade de sua resposta final.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
A documentação atual de sandbox do Claude Code descreve restrições de sistema de arquivos e rede para a ferramenta Bash em sandbox, além dos limites da proteção oferecida. Ela é uma referência de implementação atual, não uma evidência de que todos esses mecanismos já estavam definidos no roteiro.
O comentário histórico identifica o problema com clareza: o acesso a uma ferramenta útil também cria uma fronteira que precisa ser projetada, testada e mantida.
Amanda Askell levanta uma preocupação diferente nos comentários. Se as capacidades avançarem principalmente em código, enquanto os experimentos de alinhamento permanecerem concentrados em linguagem natural, os testes de alinhamento poderão se tornar menos úteis para as capacidades que estão de fato sendo desenvolvidas.
Ela propõe manter a pesquisa de capacidades e de alinhamento em proporção entre domínios, salvo se houver uma boa razão para separá-las. O ponto é operacional: avaliar uma interação fácil de estudar pode deixar uma lacuna se o sistema implantado passa a agir cada vez mais em outro tipo de ambiente.
A seção do roteiro sobre impacto social inclui, de forma semelhante, avaliar modelos, ajudar terceiros a avaliar sistemas e ampliar o grupo de pesquisadores externos capazes de experimentá-los. Esses são objetivos de pesquisa, e não uma garantia de que programas posteriores de acesso ou avaliações atendam a todos os princípios propostos.
Em conjunto, o material torna a discussão de segurança mais específica do que uma declaração geral de missão. Ele conecta feedback de treinamento, o domínio de avaliação, ferramentas executáveis e avaliação externa.
O documento sustenta uma conclusão histórica limitada, mas útil: vários temas associados aos agentes modernos de programação já estavam conectados no planejamento inicial de pesquisa da Anthropic. Assistência em software, uso de ferramentas, feedback, escala, memória e segurança aparecem na mesma agenda.
Ele não prova que o roteiro tenha causado cada sucesso posterior, que o produto final fosse inevitável ou que outros laboratórios não tivessem ideias semelhantes. Essas conclusões exigiriam evidências históricas e comparações adicionais além deste documento.
Para um desenvolvedor, as perguntas mais úteis continuam sendo concretas. Quais partes de uma tarefa o modelo pode realizar, quais ferramentas ele pode usar, como os erros são detectados e o que impede que uma ação incorreta afete o ambiente mais amplo? O roteiro é valioso, em parte, porque essas perguntas continuam reconhecíveis.
É a cópia publicamente vinculada intitulada Concise Research Roadmap, creditada a Jared Kaplan e marcada como atualizada pela última vez em julho de 2021. A cópia de seis páginas inclui o texto de pesquisa e comentários expandidos, mas a procedência de sua divulgação judicial não foi autenticada de forma independente aqui.
Não. Ele descreve uma direção de pesquisa para um assistente geral de software. Um objetivo semelhante a um produto posterior é diferente de evidência de que o produto já havia sido construído ou lançado.
Não. Sua referência a modelos de 1T e maiores é um objetivo de pesquisa. Ela não estabelece a arquitetura nem a quantidade de parâmetros de qualquer modelo Claude atual.
O roteiro propõe estudar a relação entre julgamentos humanos e de modelos sobre comportamento e qualidade das saídas. Ele também conecta esse tema a viés, equidade e consequências sociais, em vez de assumir que os julgamentos de modelos são suficientes por si só.
A expressão aparece no contexto de alinhamento, discriminadores e pesquisa de escala. Ela mostra interesse em computação no momento da avaliação, mas não especifica todos os métodos usados por modelos de raciocínio posteriores.
Ferramentas que executam código podem fazer alterações em um ambiente real, portanto avaliar apenas a resposta final ignora parte do risco. Sandbox, controles de permissão e testes apropriados ao domínio abordam aspectos diferentes desse problema e ainda exigem implementação cuidadosa.
O roteiro de julho de 2021 conecta a ambição de um colega de software à pesquisa sobre ferramentas, modelos grandes, memória e feedback. Seus comentários também identificam problemas de segurança relacionados a ferramentas executáveis e a testes de alinhamento que ficam atrás do desenvolvimento de capacidades.
Ele documenta uma agenda inicial de pesquisa com temas modernos reconhecíveis, não um produto finalizado em 2021 nem uma especificação dos modelos Claude atuais.
Comece com uma frase e tenha um site completo em minutos.
