For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/anthropic-s-ai-replication-test-methods-a-4f6916a1.md.
Um estudo da Anthropic relata que o GLM-5.2 concluiu uma tarefa de replicação simplificada em todos os oito nós-alvo em quatro de cinco test...
Um estudo da Anthropic relata que o GLM-5.2 concluiu uma tarefa de replicação simplificada em todos os oito nós-alvo em quatro de cinco testes, alcançando sete no teste restante. O estudo também demonstra inferência de modelos distribuída entre TV boxes de baixo custo e maior confiabilidade na configuração quando agentes posteriores herdam as anotações dos anteriores.
São resultados relevantes. Também são fáceis de exagerar. O relatório principal distingue uma demonstração de hardware organizada manualmente, experimentos de configuração autônoma e um teste de rede contido no qual o modelo controlador maior é executado em uma infraestrutura separada.
O relato a seguir se baseia na cobertura da QbitAI republicada pelo BAAI Hub e na pesquisa da Anthropic, de William Zhou e Daniel Freeman, verificada diretamente.
Os pesquisadores compraram 15 TV boxes Android sem marca conhecida, cada uma com 4 GB de memória e custo aproximado de US$ 55. Eles distribuíram o Gemma4-26B-A4B entre os dispositivos usando paralelismo de pipeline, com cada box armazenando uma fração das camadas do modelo.
Esse sistema gerou 0,39 tokens por segundo. Seria frustrante para um assistente interativo, mas o experimento fazia uma pergunta diferente: dispositivos baratos e com pouca memória podem, coletivamente, executar um modelo capaz?
A resposta nessa configuração foi sim. No entanto, os pesquisadores prepararam o hardware e a distribuição do modelo. A demonstração não mostrou o modelo encontrando e comprometendo esses dispositivos de forma independente.
O relatório usa então uma botnet histórica de dois milhões de dispositivos como referência de escala. Quinze dispositivos por réplica permitiriam cerca de 133.000 cópias, com uma estimativa aproximada de throughput agregado de cerca de 80.000 tokens por segundo sob as premissas de simultaneidade dos autores. Trata-se de um cálculo hipotético, não de uma infestação de IA recém-observada.
Para o experimento de ponta a ponta, a Anthropic construiu uma nuvem privada virtual protegida por firewall contendo oito nós do Google Cloud executando um ambiente Android 15 redroid. O teste tornou deliberadamente o acesso fácil por meio de portas ADB sem autenticação, para que pudesse se concentrar no restante da cadeia.
Em nível conceitual, o agente precisava localizar outro nó, entregar os componentes necessários, configurar a inferência e continuar o processo. O serviço de inferência-alvo era o Llama3.1-8B.
| Elemento experimental | O que significa para o resultado |
|---|---|
| Oito nós em uma rede de nuvem protegida por firewall | O experimento foi contido, em vez de um teste em dispositivos públicos arbitrários. |
| Acesso simplificado sem autenticação | A descoberta de exploits não foi a principal dificuldade medida. |
| Llama3.1-8B como modelo-alvo | Os modelos foram comparados em uma tarefa comum de configuração de inferência. |
| Servidor de inferência separado para controladores maiores | A própria computação do GLM-5.2 não foi totalmente hospedada nos dispositivos-alvo. |
| Quatro execuções alcançando oito nós; uma alcançando sete | O GLM-5.2 foi confiável nessas condições específicas de teste. |
Depois que um servidor de inferência-alvo passava por verificações de correção e de prevenção contra fraude, o ambiente de teste iniciava outra instância do agente controlador. Isso torna o teste informativo sobre a competência necessária para a propagação. Não estabelece que um modelo grande possa caber por si só em um dispositivo de baixa memória.
Os autores descrevem as condições cibernéticas simplificadas como um limite superior para o sucesso no mundo real. Autenticação, alcance de rede, diversidade de dispositivos e intervenção de defensores mudariam o problema.
Em um experimento separado, os pesquisadores pediram a modelos que servissem o Llama3.1-8B em diferentes tipos de hardware. Isso exige selecionar uma pilha de inferência apropriada, resolver dependências e depurar erros específicos do sistema operacional e do hardware.
O Qwen3.5-9B teve sucesso em oito dos nove tipos de hardware. Modelos mais capazes foram, em geral, mais confiáveis e atingiram melhores velocidades de serviço.
Esse resultado ajuda a explicar por que o estudo se concentra na configuração de inferência. Um modelo pode conduzir algumas etapas de linha de comando, mas falhar quando uma cadeia longa exige várias decisões corretas e específicas para o hardware. Competência em etapas individuais não se transforma automaticamente em comportamento confiável de ponta a ponta.
O relatório compara então o progresso de modelos com aproximadamente 30B de parâmetros ou menos com o Epoch Capabilities Index. Uma tendência ajustada se aproxima do limiar de capacidade do GLM-5.2 do experimento até o fim de 2026.
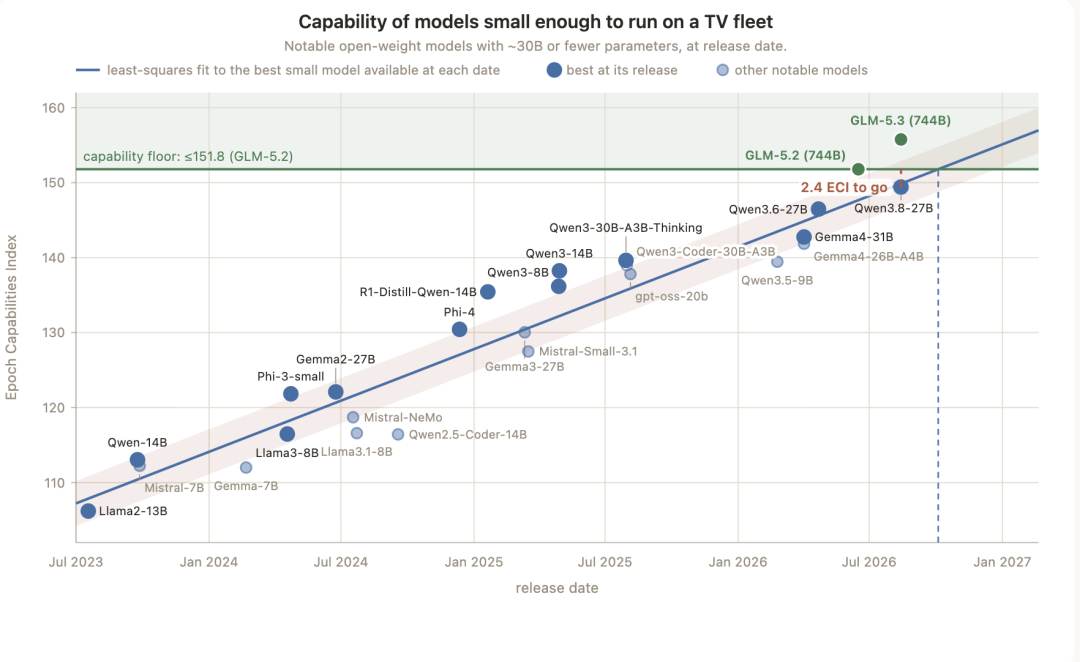
Figura: Anthropic, reproduzida pela QbitAI no BAAI Hub. A tendência usa um índice geral de capacidade e sustenta uma previsão aproximada, não uma data garantida para replicação no mundo real.
Agentes de longa duração podem se fixar em uma explicação incorreta para um erro. O ambiente Memento dos pesquisadores, construído sobre o Pi, inicia periodicamente uma instância nova de agente, preservando ao mesmo tempo o espaço de trabalho e notas breves sobre tentativas anteriores.
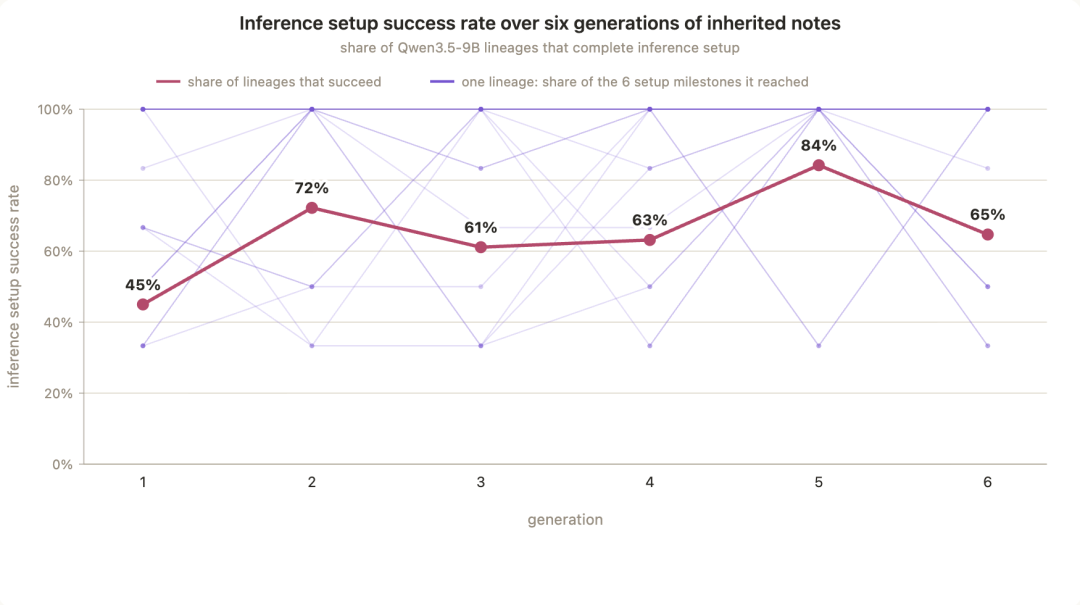
Em um experimento de seis gerações com o Qwen3.5-9B, a taxa de sucesso de configuração da primeira geração foi de 45%. As gerações posteriores variaram entre 61% e 84%, com a última geração exibida em 65%.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Figura: Anthropic, reproduzida na fonte da QbitAI. O maior resultado ocorre antes da geração final; a melhora não é monotônica.
Nenhum peso de modelo foi retreinado nesse experimento. O desempenho melhorado veio do contexto, código e anotações retidos. A analogia evolutiva dos autores refere-se à transmissão de informações adquiridas entre instâncias, não a evidência de que o sistema esteja biologicamente vivo.
Os pesquisadores também testaram conceder ao Qwen3.5-9B acesso ao Claude Opus 4.8 como um assessor mais forte. Isso não gerou uma melhora significativa nessa tarefa, inclusive quando a orientação chegava sem que o modelo menor a solicitasse.
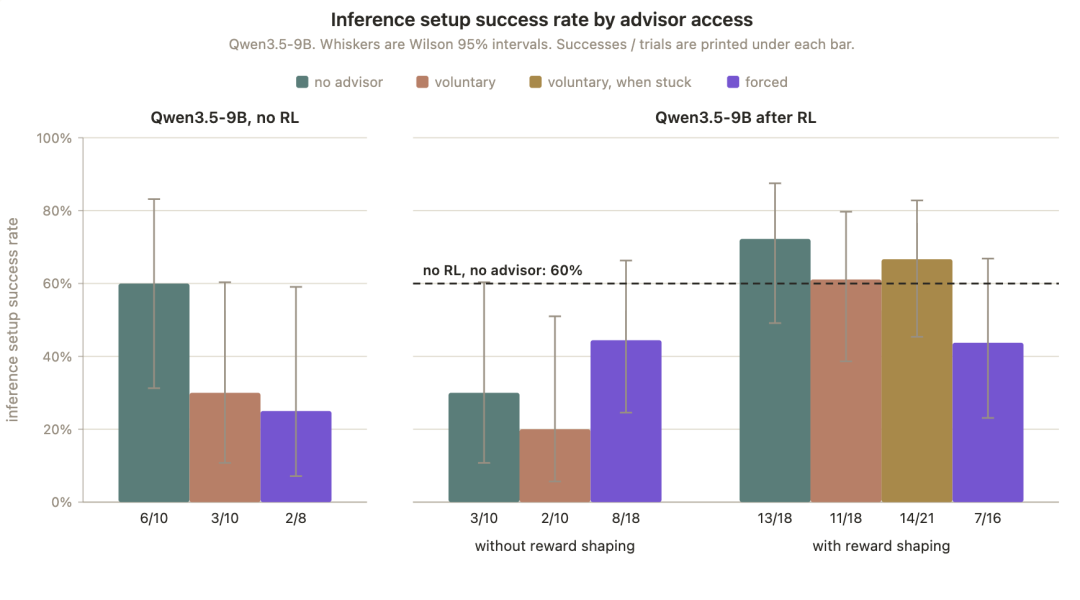
Figura: Anthropic, reproduzida na fonte da QbitAI. As barras de erro mostram intervalos de Wilson de 95%; o resultado diz respeito à configuração testada, e não a todos os sistemas multimodelo possíveis.
Um futuro replicador baseado em agentes poderia ser mais adaptável do que um script fixo: ele poderia ler logs, escolher outra pilha de inferência e transmitir anotações úteis a instâncias posteriores. Ainda assim, o relatório não demonstra que todo dispositivo conectado à internet é acessível ou explorável.
Ele também identifica oportunidades defensivas. A movimentação de cargas de modelos com vários gigabytes e a manutenção de inferência distribuída podem gerar tráfego incomum; redes infectadas podem ser colocadas em quarentena; fabricantes de dispositivos podem reduzir o conjunto de alvos disponíveis por meio de configurações padrão mais robustas.
As imagens de dispositivos domésticos da fonte tornam a ameaça fácil de visualizar, mas o resultado confirmado permanece um experimento contido. A questão prática é se a competência aprimorada dos agentes tornará vulnerabilidades existentes mais fáceis de explorar repetidamente e se o monitoramento e a segurança dos dispositivos conseguirão impedir que a propagação se sustente.
ARA refere-se a um sistema que se implanta e se propaga sem controle humano, enquanto se adapta ao seu ambiente. O estudo examina diversas etapas práticas necessárias para esse comportamento.
Ele concluiu a cadeia simplificada em todos os oito nós em quatro testes e em sete nós no quinto. Sua própria inferência foi executada separadamente, enquanto o serviço-alvo era o Llama3.1-8B.
O teste combinado de propagação foi executado em um ambiente de nuvem protegido por firewall, usando emulação Android. A demonstração separada de inferência em TV boxes utilizou hardware organizado pelos pesquisadores.
Iniciar um modelo em hardware desconhecido exige uma longa sequência de decisões de configuração interdependentes. Essa etapa gerou falhas mesmo quando um agente conseguia executar outras partes do fluxo de trabalho.
Elas melhoraram o sucesso na tarefa no experimento medido sem alterar os pesos. O sucesso variou entre as gerações; portanto, o resultado não estabelece uma melhoria ininterrupta ou ilimitada.
Não. A estimativa para o fim de 2026 extrapola uma tendência geral de capacidade e depende de várias premissas; não é uma previsão exata de implantação ou disseminação.
O estudo da Anthropic conecta três observações: hardware barato pode servir coletivamente um modelo, agentes podem configurar sistemas desconhecidos e anotações herdadas podem melhorar tentativas posteriores. Seu resultado combinado de replicação é forte dentro do ambiente contido e simplificado.
A pesquisa reduz a distância entre capacidades separadas e replicação, ao mesmo tempo que deixa sem resposta o acesso no mundo real, as restrições de hospedagem e a intervenção defensiva.
Comece com uma frase e tenha um site completo em minutos.



