For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/azure-maia-300-microsoft-s-2027-multi-gig-1e316d9a.md.
A Microsoft está levando seu programa de infraestrutura de IA personalizada para uma fase de implantação muito maior.
A Microsoft está levando seu programa de infraestrutura de IA personalizada para uma fase de implantação muito maior.
Em 12 de outubro de 2026, a empresa informou que planeja expandir a família Azure Maia para implantações multigigawatt a partir de 2027, com a Maia se tornando o principal sistema de inferência para os produtos e serviços da Microsoft.
O anúncio conecta duas gerações de hardware de IA projetado pela Microsoft.
A Maia 200 já está em produção e atendendo cargas de trabalho da Microsoft. A Maia 300, o próximo sistema, está programada para iniciar a implantação em produção em 2027 e foi projetada especificamente para raciocínio de contexto longo, conversas sensíveis à latência e cargas de trabalho sustentadas de agentes em múltiplas etapas.
O argumento central da Microsoft é que a eficiência de inferência não pode mais ser melhorada analisando apenas o chip.
A empresa está projetando em conjunto:
como um único sistema.
Essa abordagem em nível de sistema é o que a Microsoft pretende expandir para a faixa de múltiplos gigawatts.
Antes de discutir a Maia 300, o anúncio da Microsoft começa pela geração atual.
A Maia 200 não é mais apenas uma plataforma de desenvolvimento.
A Microsoft afirma que ela agora atende cargas de trabalho em produção, incluindo o Microsoft Copilot, além de dar suporte à equipe de IA da Microsoft no desenvolvimento de modelos de próxima geração.
A empresa informa que o GitHub Copilot e o Microsoft Foundry devem ser incluídos até o fim de 2026.
Nessas cargas de trabalho, a Maia 200 pode executar:
Isso é importante porque a Microsoft não apresenta a Maia como silício destinado a uma única família proprietária de modelos.
A arquitetura foi concebida para dar suporte a um portfólio heterogêneo de modelos no Azure e nos próprios serviços da Microsoft.
A Microsoft opera produtos de IA em uma escala enorme.
Isso proporciona às suas equipes de infraestrutura visibilidade direta sobre onde os modelos implantados consomem tempo, largura de banda de memória, capacidade de rede e energia.
Em vez de projetar primeiro um acelerador de uso geral e decidir depois como as aplicações devem utilizá-lo, a Microsoft afirma que seus grupos de hardware e software trabalham juntos com anos de antecedência.
O objetivo é antecipar requisitos futuros dos modelos e traduzi-los em escolhas de hardware, como:
Esse ciclo de feedback já está moldando a próxima geração.
A Microsoft afirma que a Maia 200 está sendo implantada nos seguintes locais:
Para recursos de IA integrados a produtos como Microsoft Teams, Copilot e Cowork, a Microsoft informa que a Maia 200 pode oferecer até 1,7× mais tokens por watt do que o que descreve como infraestrutura líder baseada em GPUs.
Essa é uma comparação reportada pela Microsoft, e não um benchmark independente publicado entre sistemas de terceiros padronizados.
A formulação importa.
Ela é evidência da experiência interna de produção da Microsoft, mas não deve ser interpretada como uma vantagem universal de 1,7× para todos os modelos, prompts, tamanhos de lote, metas de latência ou implantações de GPU.
A Microsoft afirma que a experiência em produção com a Maia 200 influenciou diretamente o projeto da Maia 300.
O sistema mais novo deve suportar uma gama mais ampla de cargas de trabalho, incluindo:
A restrição comum entre essas cargas de trabalho é a inferência.
Elas exigem que os modelos permaneçam responsivos enquanto processam contextos mais longos, mantêm mais estado e executam mais etapas.
A Microsoft descreve a Maia 300 como a terceira geração do seu programa Azure Maia.
O projeto prioriza a inferência.
Isso significa que a Microsoft está otimizando para as cargas de trabalho que espera que dominem os sistemas de IA implantados, e não apenas para o throughput de treinamento.
Essas cargas de trabalho incluem:
A métrica-alvo deixa de ser apenas FLOPS brutos.
Ela passa a ser quantos tokens úteis um datacenter consegue entregar dentro de restrições fixas de:
A Microsoft afirma que se espera que a Maia 300 ofereça 40% mais tokens por megawatt do que sistemas líderes baseados em GPU.
Esse número é uma expectativa da Microsoft para eficiência de implantação em nível de sistema, não um benchmark público e independente com uma metodologia completa de testes entre fornecedores.
Em um rack completo com 96 aceleradores, a Microsoft também afirma que a Maia 300 pode oferecer até 7× o throughput de tokens em escala de rack da Maia 200.
Esses dois números medem comparações diferentes:
| Afirmação | Comparação |
|---|---|
| 40% mais tokens por megawatt | Maia 300 vs. sistemas líderes baseados em GPU |
| Até 7× o throughput de tokens em escala de rack | Rack completo de 96 aceleradores Maia 300 vs. Maia 200 |
Eles não devem ser tratados como equivalentes.
Uma das principais ideias por trás da Maia 300 é que a movimentação de dados se tornou um grande gargalo.
Sistemas modernos de inferência movem repetidamente:
entre unidades de computação, memória e conexões de rede.
Cada movimentação consome latência e energia.
A resposta da Microsoft é uma evolução da Software Defined Locally Accessed Dataflow Architecture, ou SDLA, apresentada com a Maia 200.
O software controla onde os dados são posicionados e quando eles são movidos entre:
A Maia 300 estende essa ideia por uma arquitetura com múltiplos chiplets.
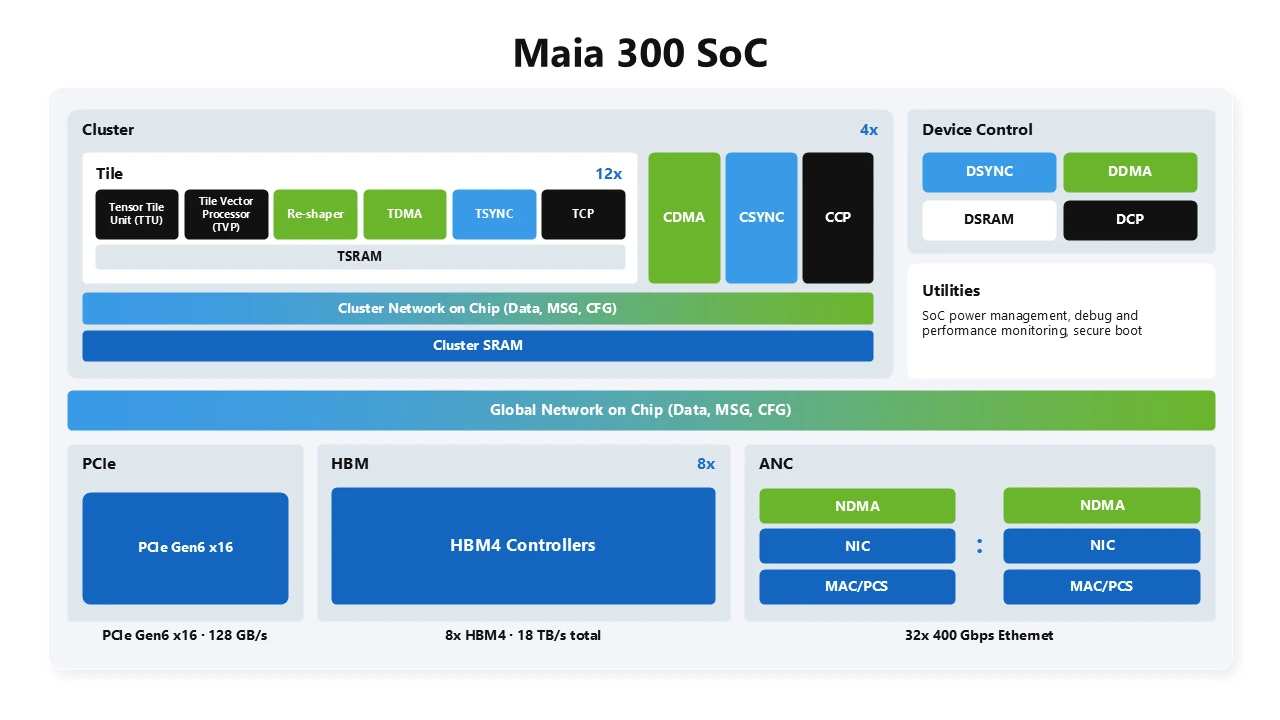
A Maia 300 deixa uma organização de memória mais uniforme para adotar uma arquitetura de memória não uniforme, orientada à localidade, entre chiplets.
O propósito é direto:
Manter os dados mais próximos da computação que os utiliza
→ mover menos bytes
→ reduzir latência e energia
→ melhorar a utilização
A arquitetura atribui ao software uma responsabilidade mais direta pelo controle da localidade.
Isso é especialmente importante para inferência de contexto longo e com alta carga de decodificação, em que a movimentação de estado do modelo e de cache KV pode dominar a carga de trabalho.
A memória é uma das maiores atualizações da Maia 300.
Cada acelerador utiliza oito pilhas HBM4, fornecendo:
A Microsoft informa que isso oferece aproximadamente:
O sistema também utiliza SRAM no chip como um espaço de trabalho gerenciado por software.
Isso pode reduzir a pressão sobre a HBM, mantendo dados reutilizados com frequência mais próximos da computação.
Para inferência, isso importa porque muitas cargas de trabalho são limitadas pela velocidade com que o estado pode ser fornecido aos mecanismos de computação, e não pela capacidade aritmética máxima desses mecanismos.
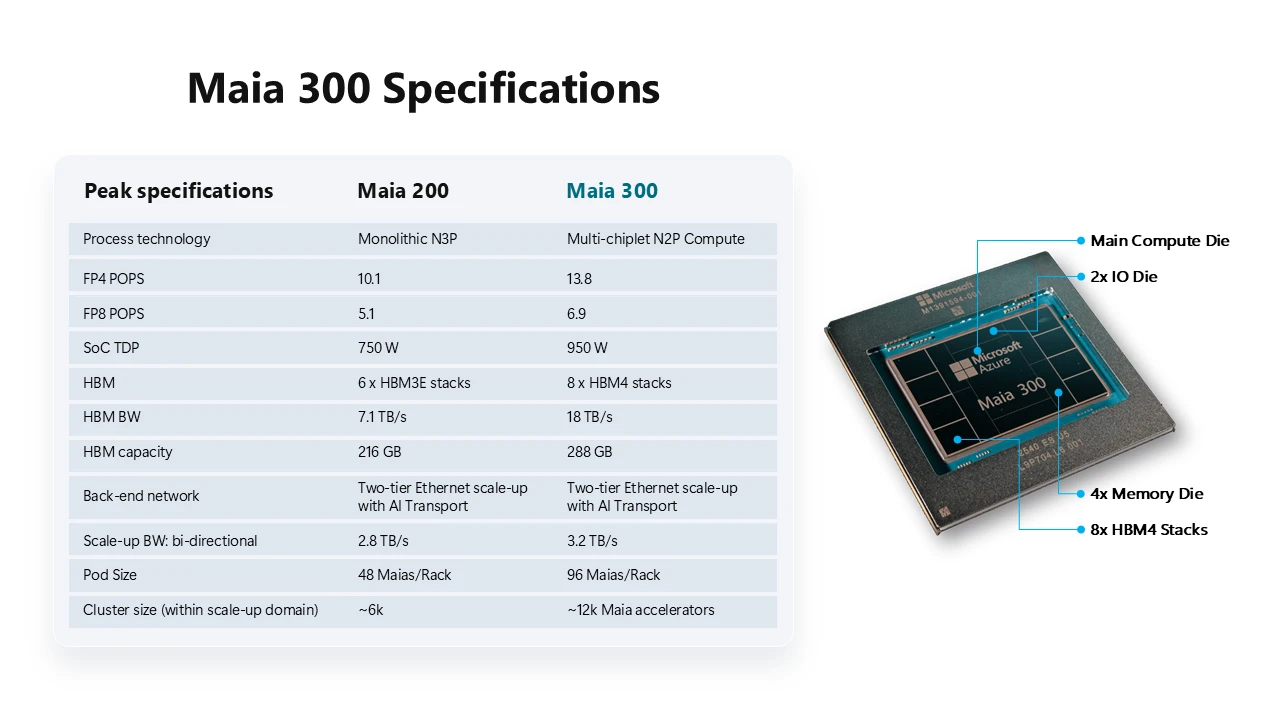
A Maia 300 não é um único die monolítico no mesmo sentido da Maia 200.
A Microsoft está separando as principais funções entre chiplets.
A arquitetura inclui funções distintas para:
Os chiplets de computação são fabricados no processo N2P da TSMC.
A justificativa é econômica, além de técnica.
A tecnologia de processo mais avançada pode ser concentrada onde oferece o maior benefício de desempenho por watt, enquanto outras funções podem usar projetos otimizados para largura de banda, conectividade ou custo.
A publicação da Microsoft sobre a arquitetura técnica afirma que a mudança contribui para:
em relação à Maia 200.
A Maia 300 também amplia o suporte à inferência de menor precisão.
A Microsoft destaca suporte aprimorado a MXFP4 e formatos de armazenamento abaixo de 3 bits em seu material técnico sobre arquitetura.
A menor precisão pode reduzir:
O benefício não se resume a números menores.
Se o modelo puder manter a qualidade exigida em menor precisão, a infraestrutura poderá suportar:
A Microsoft também afirma que o mecanismo vetorial adiciona otimizações no nível de instrução para kernels de inferência, como softmax e conversão de dados de baixa precisão.
Em grande escala, aceleradores só são úteis se conseguirem se comunicar com eficiência.
A Maia 300 estende seu modelo de fluxo de dados à própria rede.
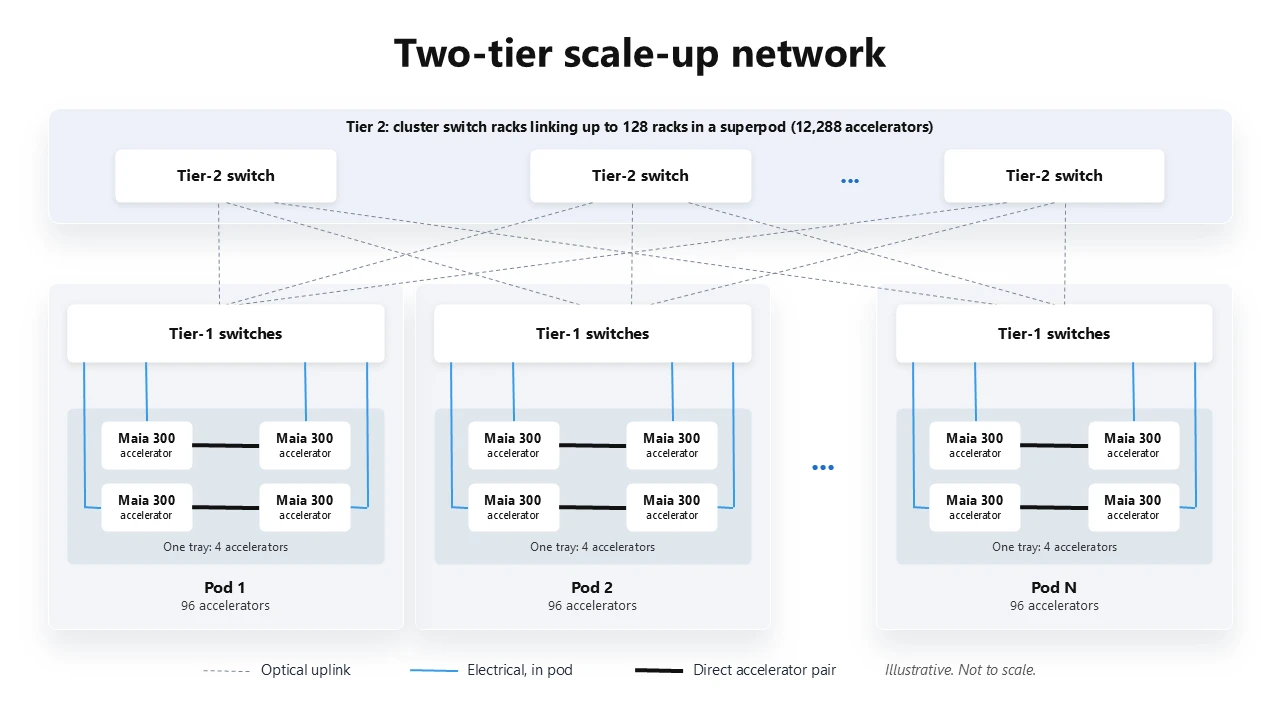
A Microsoft usa transporte de IA personalizado sobre infraestrutura baseada em Ethernet e uma topologia de scale-up em dois níveis.
Um único rack da Maia 300 contém:
96 aceleradores
Vários racks podem então ser conectados em um superpod.
A arquitetura técnica da Microsoft descreve um superpod máximo de:
128 racks
12.288 aceleradores Maia 300
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Dentro de um rack, conexões diretas conectam pares de aceleradores, enquanto caminhos elétricos comutados conectam o pod completo de 96 aceleradores.
A Microsoft afirma que manter o scale-up dentro do rack em meio elétrico ajuda a reduzir energia e custo.
Um segundo nível de rede utiliza conectividade óptica para abranger racks.
Isso permite que até 128 racks participem do mesmo domínio de scale-up.
O objetivo declarado da Microsoft é evitar expor semânticas de comunicação separadas para cada limite físico.
O mesmo modelo geral de comunicação abrange:
Isso dá aos agendadores e ao software mais flexibilidade para posicionar cargas de trabalho com paralelismo de tensor, pipeline e especialistas.
O rack da Maia 300 é uma parte importante do projeto do sistema.
Cada rack contém:
A comparação de arquitetura da Microsoft arredonda a capacidade HBM total para 27,7 TB em seu gráfico de racks.
A diferença é apenas o arredondamento de 96 × 288 GB.
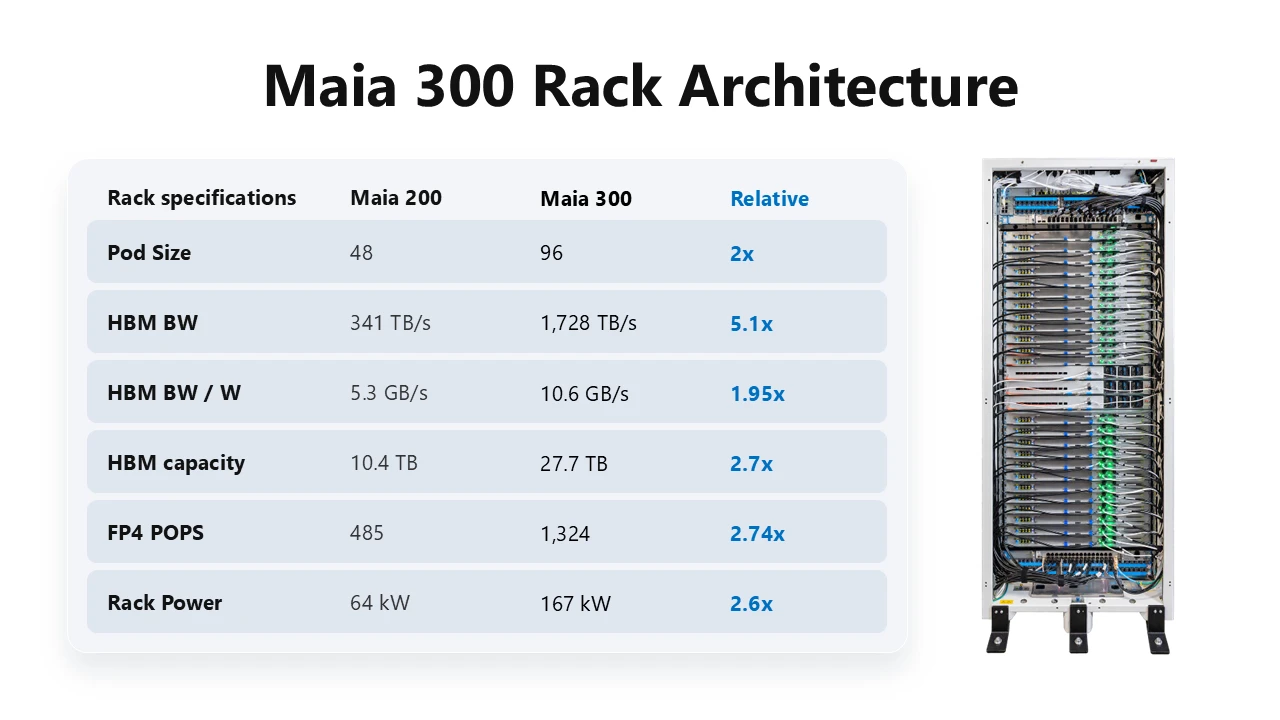
A densidade de aceleradores é o dobro da Maia 200.
A Microsoft integra computação host, memória, armazenamento, refrigeração e aceleradores em cada bandeja, em vez de exigir bandejas host separadas.
Isso libera espaço no rack e permite que o gerenciamento de energia e térmico seja tratado como um único sistema.
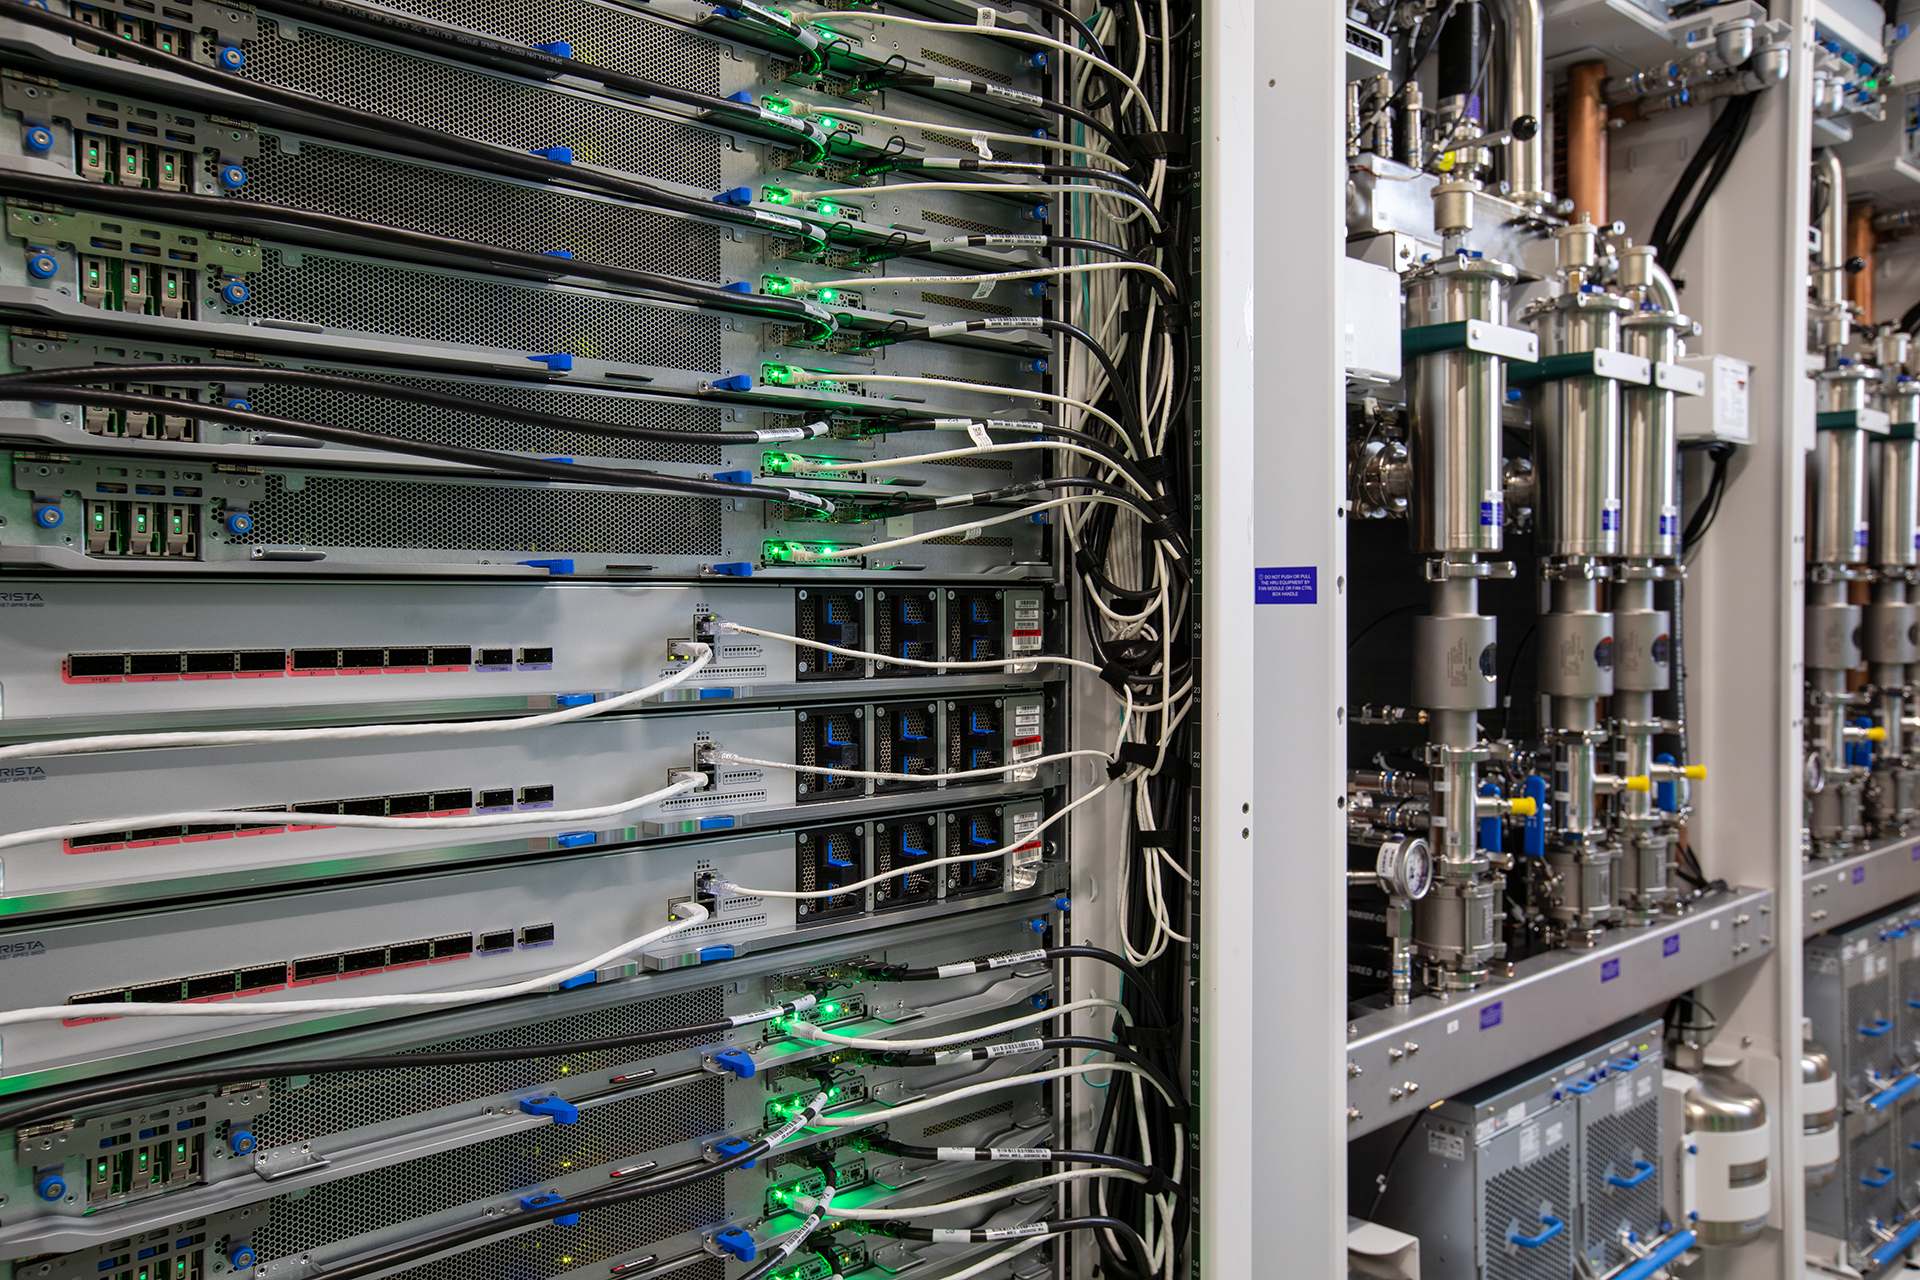
Um rack de IA de 167 kW cria um desafio considerável de gerenciamento térmico.
A Microsoft afirma que a refrigeração líquida remove mais de 80% da carga térmica do rack de componentes como:
A refrigeração a ar permanece para componentes como memória, armazenamento e outros sistemas de suporte.
O rack pode ser conectado diretamente à água da instalação onde essa infraestrutura existe.
Ele também pode usar uma unidade de troca de calor em instalações que, de outra forma, seriam refrigeradas a ar.
Essa flexibilidade importa para a escala de implantação.
A Microsoft não pode expandir a Maia apenas em datacenters construídos em torno de uma única configuração exata de refrigeração.
A tabela a seguir consolida as especificações publicadas pela Microsoft para a Maia 300 e sua comparação com a Maia 200.
| Especificação | Maia 200 | Maia 300 |
|---|---|---|
| Processo / abordagem de encapsulamento | N3P monolítico | Múltiplos chiplets, computação N2P |
| Pico FP4 | 10,1 POPS | 13,8 POPS |
| Pico FP8 | 5,1 POPS | 6,9 POPS |
| TDP do SoC | 750 W | 950 W |
| HBM | 6 × HBM3E | 8 × HBM4 |
| Capacidade HBM por acelerador | 216 GB | 288 GB |
| Largura de banda HBM por acelerador | 7,1 TB/s | 18 TB/s |
| Largura de banda bidirecional de scale-up | 2,8 TB/s | 3,2 TB/s |
| Aceleradores por rack | 48 | 96 |
| Capacidade HBM aproximada por rack | 10,4 TB | 27,7 TB |
| Potência do rack | 64 kW | 167 kW |
| Domínio máximo de scale-up publicado | ~6 mil aceleradores | ~12 mil aceleradores |
Essas são especificações de pico e de sistema publicadas pela Microsoft.
Elas não representam garantias no nível de aplicação.
O throughput real depende do modelo, da precisão, do tamanho do lote, da meta de latência, da estratégia de paralelismo, da pilha de software e da combinação de cargas de trabalho.
O número de destaque é o plano da Microsoft de levar o Azure Maia a implantações multigigawatt a partir de 2027.
Essa é uma declaração sobre escala de infraestrutura.
A Microsoft não divulgou um número total exato de gigawatts, um cronograma de implantação por implantação ou uma quantidade de aceleradores vinculada a essa declaração.
Também não deve ser interpretada como uma afirmação de que um único datacenter Maia 300 necessariamente consumirá múltiplos gigawatts.
Um programa em escala de gigawatts pode abranger:
O anúncio da empresa se concentra intencionalmente na estratégia de sistema, e não em um plano de construção instalação por instalação.
A infraestrutura de IA está cada vez mais limitada pela quantidade de computação útil que pode caber na energia disponível.
Um datacenter não pode adicionar aceleradores indefinidamente se também não puder fornecer:
É por isso que a Microsoft está enfatizando tokens por megawatt.
A métrica conecta a produção do serviço de modelos ao recurso escasso que determina cada vez mais a expansão de datacenters.
Um chip que é mais rápido, mas consome proporcionalmente mais energia, pode não resolver o problema real de implantação.
O objetivo é gerar mais produção útil de IA dentro do mesmo limite de infraestrutura.
O anúncio da Microsoft vai além de dizer que a Maia 300 será mais uma opção de acelerador.
A empresa afirma que a família Maia se tornará seu principal sistema de inferência para produtos e serviços da Microsoft à medida que a implantação for ampliada.
Isso torna a Maia estrategicamente importante em toda a pilha da Microsoft.
A empresa nomeia ou faz referência a cargas de trabalho que incluem:
Isso não significa que a Microsoft está abandonando GPUs ou outros aceleradores.
A Microsoft descreve explicitamente sua infraestrutura mais ampla como heterogênea e diversificada em modelos.
O programa Maia oferece à Microsoft outra opção de infraestrutura que ela pode otimizar de perto para seus próprios padrões de serviço.
A seção final do anúncio da Microsoft posiciona a Maia dentro do que a empresa chama de Frontier Transformation.
A ideia é que a infraestrutura de IA não deve ser otimizada como camadas isoladas.
A Microsoft quer conectar:
Silício
→ sistemas
→ datacenters
→ serviço de modelos
→ agentes
→ aplicações
Como a Microsoft opera todas essas camadas, ela pode usar o feedback de produção das aplicações para influenciar o hardware futuro.
O inverso também é verdadeiro.
Novas capacidades de hardware podem moldar o que modelos e agentes futuros poderão fazer economicamente em escala.
Esse é o propósito estratégico da Maia.
A empresa não está tentando provar que um chip substituirá todos os aceleradores.
Ela está construindo uma plataforma de inferência com projeto verticalmente integrado, que pode operar ao lado de outro hardware no Azure.
As especificações publicadas da Maia 300 são substanciais, mas a maior parte do sistema principal ainda está em pré-produção.
A implantação em produção começa em 2027.
Várias questões serão importantes quando o sistema chegar a cargas de trabalho reais.
A Microsoft espera 40% mais tokens por megawatt do que sistemas líderes baseados em GPU.
A questão útil será como isso se sustenta em diferentes modelos e metas de latência.
Silício personalizado só é bem-sucedido quando o compilador, os kernels, a observabilidade, as ferramentas de implantação e o suporte a modelos são maduros o suficiente para equipes de produção.
A Microsoft quer que a Maia ofereça suporte às famílias de modelos OpenAI, MAI e de código aberto.
A eficiência de produção em arquiteturas heterogêneas será um teste importante.
O domínio de scale-up com 12.288 aceleradores é arquitetonicamente significativo.
A utilização no mundo real, a recuperação de falhas, o agendamento e a comunicação entre racks determinarão quanto dessa escala teórica se traduz em capacidade útil.
Desempenho por watt é apenas uma parte do custo total.
Operadores de datacenter também se preocupam com:
A vantagem da Microsoft, se a estratégia funcionar, virá da otimização de todo o sistema, e não de um único número de benchmark.
O Azure Maia 300 é o sistema de inferência de IA personalizado de terceira geração da Microsoft. Ele combina um acelerador com múltiplos chiplets, memória HBM4, fluxo de dados definido por software, rede personalizada de scale-up baseada em Ethernet e uma arquitetura de rack com 96 aceleradores, projetada para inferência de IA em escala de nuvem.
A Microsoft afirma que a implantação em produção começará em 2027. A empresa também planeja iniciar a expansão da família Maia para implantações multigigawatt em 2027.
Significa que a Microsoft planeja infraestrutura Maia em uma escala de potência agregada medida em múltiplos gigawatts. A Microsoft não publicou um total exato, uma quantidade de aceleradores nem afirmou que um único datacenter consumirá múltiplos gigawatts; portanto, esses detalhes não devem ser inferidos apenas pelo título.
Cada acelerador Maia 300 possui oito pilhas HBM4 com 288 GB de capacidade e 18 TB/s de largura de banda HBM de pico. Um rack com 96 aceleradores contém aproximadamente 27,6–27,7 TB de HBM agregada.
A Microsoft especifica um limite de potência de 167 kW para um rack Maia 300 completo com 96 aceleradores. O SoC do acelerador tem um TDP de 950 W.
A Microsoft espera que a Maia 300 ofereça 40% mais tokens por megawatt do que sistemas líderes baseados em GPU, mas não publicou uma metodologia completa de benchmark independente entre fornecedores para essa afirmação. Portanto, o resultado deve ser tratado como uma expectativa de desempenho em nível de sistema da Microsoft, e não como uma conclusão universal de benchmark.
A Microsoft afirma que a Maia se tornará seu principal sistema de inferência para produtos e serviços da Microsoft, mas também descreve o Azure como uma plataforma aberta e heterogênea, com escolha de modelos e silício. A Maia faz parte dessa combinação mais ampla de infraestrutura, e não é evidência de que o Azure utilizará apenas silício da Microsoft.
A Microsoft afirma que a Maia 200 já atende o Microsoft Copilot e dá suporte ao desenvolvimento de modelos de próxima geração da equipe MAI. Espera-se que o GitHub Copilot e o Microsoft Foundry sejam incluídos até o fim de 2026.
A Microsoft está transformando o Azure Maia de um programa de aceleradores personalizados em uma plataforma de inferência em grande escala. A Maia 200 já executa cargas de trabalho em produção, enquanto a Maia 300 está programada para iniciar a implantação em 2027 e foi projetada em torno de inferência de contexto longo, com alta carga de decodificação e baseada em agentes.
As maiores mudanças estão no nível de sistema: 288 GB de HBM4 por acelerador, 18 TB/s de largura de banda de memória, um projeto N2P com múltiplos chiplets, 96 aceleradores por rack de 167 kW, uma malha de scale-up que alcança 12.288 aceleradores e refrigeração líquida que remove mais de 80% do calor do rack.
O objetivo da Microsoft é expandir a família Maia para implantações multigigawatt e torná-la o principal sistema de inferência por trás de seus próprios produtos e serviços, mantendo o Azure heterogêneo.
A história da Maia 300 tem menos a ver com um chip substituindo outro e mais com a Microsoft projetando todo o caminho, do silício ao datacenter e ao agente, em torno da economia da inferência de IA.
Comece com uma frase e tenha um site completo em minutos.



