O Assistente Wenxin da Baidu conquistou o primeiro lugar em mais um benchmark de estilo agente. Na avaliação de produto XClaw de agosto de 2...
O Assistente Wenxin da Baidu conquistou o primeiro lugar em mais um benchmark voltado para agentes.
Na avaliação de produto XClaw da SuperCLUE de agosto de 2026, o Assistente Wenxin obteve uma pontuação geral de 97,62, a maior pontuação no recorte publicado.
Suas pontuações por categoria foram:
| Capacidade | Pontuação |
|---|---|
| Codificação | 90,28 |
| Criação de conteúdo | 99,44 |
| Processamento de dados | 98,86 |
| Análise de pesquisa | 96,44 |
| Memória | 100,00 |
O resultado chegou menos de três semanas após outra forte exibição.
Em um recorte de julho do PinchBench v2, o agente de tarefas da Baidu — submetido como Orion Mission Mode — registrou uma melhor pontuação de 94,6% e uma pontuação média de 94,4%, colocando-se no topo daquele ranking.
Os dois benchmarks são diferentes. O SuperCLUE XClaw foca em produtos de agente chineses e entregas práticas em cinco dimensões de capacidade. O PinchBench v2, criado pela Kilo, é construído em torno de tarefas reais de computador e automação.
Juntos, eles apontam para a mesma mudança:
A avaliação de agentes está migrando de "O modelo consegue responder corretamente?" para "O sistema consegue concluir o trabalho e entregar algo utilizável?"
Um modelo de linguagem pode saber a resposta e ainda assim falhar como agente porque esquece requisitos, escolhe a ferramenta errada, lida mal com arquivos, para no meio de um fluxo de trabalho ou retorna o artefato errado.
Isso torna os últimos resultados do Wenxin mais sobre execução de tarefas do que sobre inteligência bruta do modelo de linguagem.
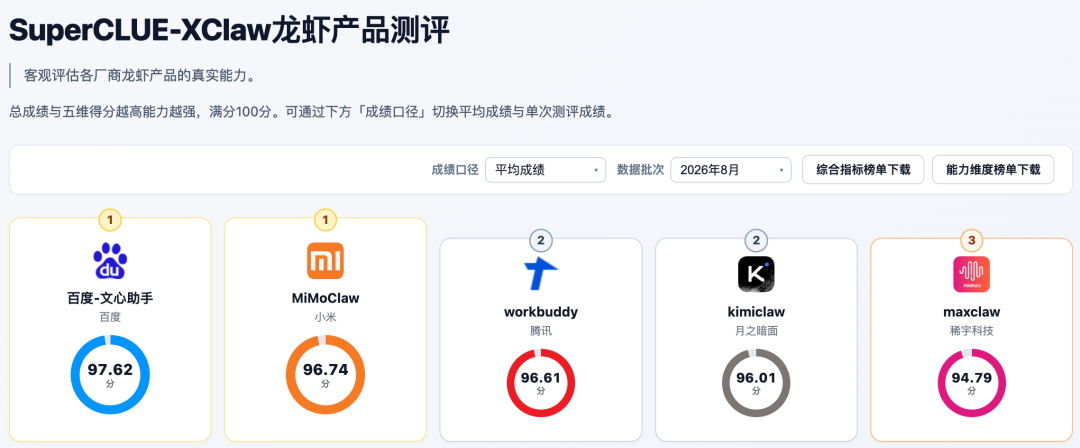
A SuperCLUE descreve o XClaw como uma avaliação orientada a produto para assistentes de IA estilo "Claw".
Em vez de depender principalmente de questões de múltipla escolha, o benchmark enfatiza entregas concluídas.
O recorte de agosto de 2026 classifica os principais produtos da seguinte forma:
| Classificação | Produto | Pontuação |
|---|---|---|
| 1 | Assistente Wenxin da Baidu | 97,62 |
| 2 | MiMoClaw | 96,74 |
| 3 | WorkBuddy | 96,61 |
| 4 | KimiClaw | 96,01 |
| 5 | MaxClaw | 94,79 |
O benchmark avalia cinco dimensões:
A lógica básica é direta: o agente recebe uma tarefa e deve produzir um artefato ou resultado final que possa ser efetivamente avaliado.
Isso faz com que o seguimento de instruções, o manuseio de arquivos, o uso de ferramentas e a execução de longo horizonte façam parte da pontuação.
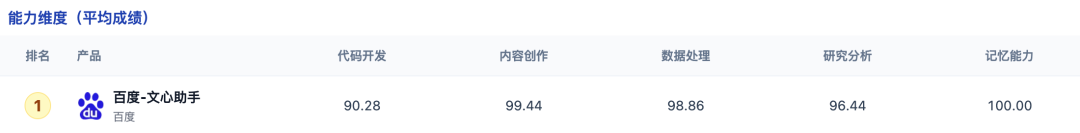
A pontuação de categoria mais impressionante é 100,00 em memória.
A memória é importante porque o trabalho real raramente cabe em um único prompt isolado.
Um usuário pode fornecer restrições no início de uma conversa e esperar que o agente as respeite muito mais tarde.
Por exemplo:
Turno 1:
Use apenas dados do 2º trimestre de 2026.

Turno 3:
Mantenha o relatório com menos de 10 páginas.

Turno 6:
Use a mesma segmentação de produtos da planilha.

Turno 10:
Gere o documento final em Word.
Um agente que esquece a primeira instrução pode produzir um entregável polido, porém inutilizável.
A memória, portanto, afeta:
Uma pontuação perfeita em uma categoria em um benchmark não significa que o produto nunca esquecerá informações em sessões reais arbitrárias. Isso mostra que o Wenxin teve um desempenho extremamente bom nas tarefas de memória incluídas nesta avaliação da XClaw.
O Assistente Wenxin recebeu 98,86 em processamento de dados.
A fonte descreve esta categoria como um teste para verificar se o sistema consegue interpretar campos, combinar informações, preservar precisão numérica e produzir saídas estruturadas.
Estas são tarefas enganosamente difíceis.
Um modelo de chat geral pode resumir bem uma planilha, mas ainda cometer um erro sutil em:
Para uso empresarial, um número incorreto pode invalidar um documento inteiro.
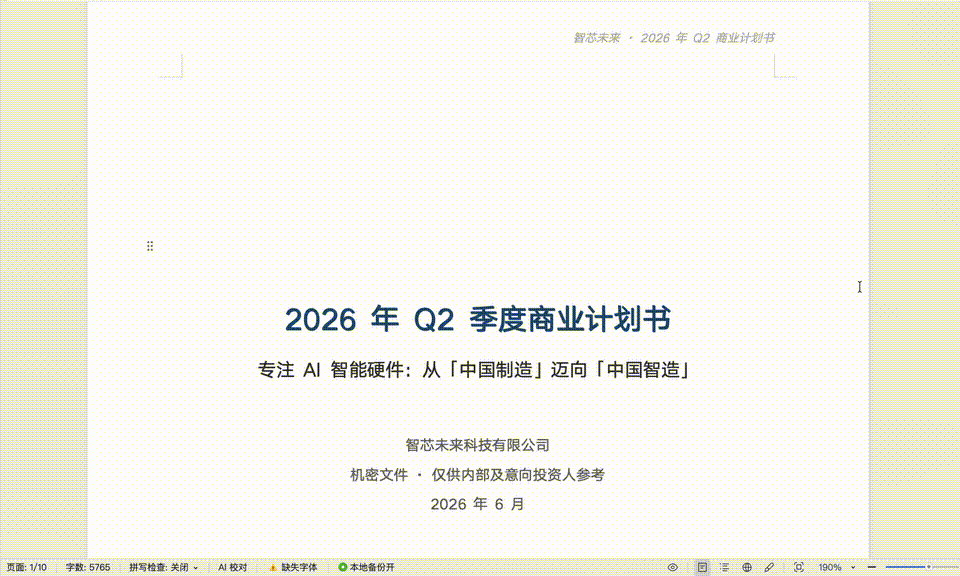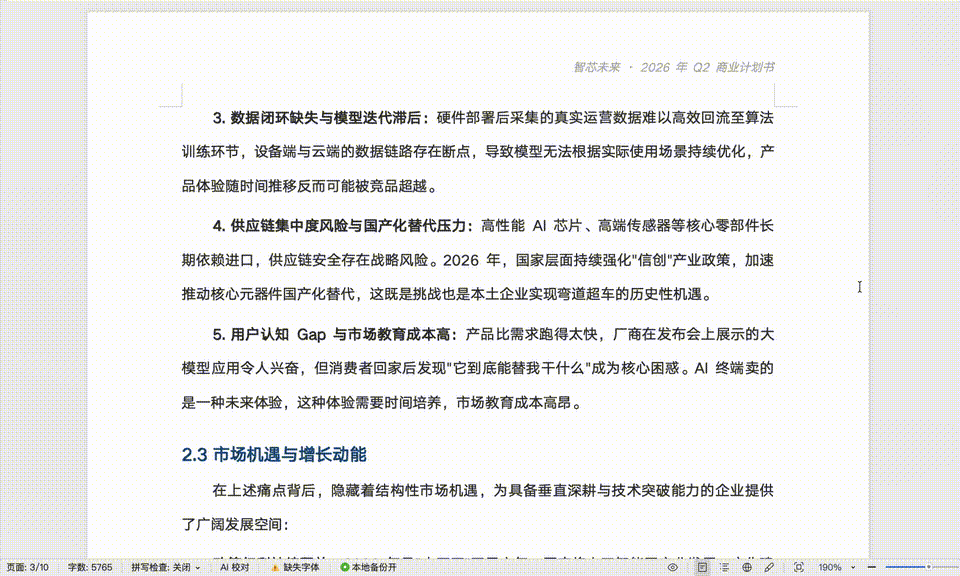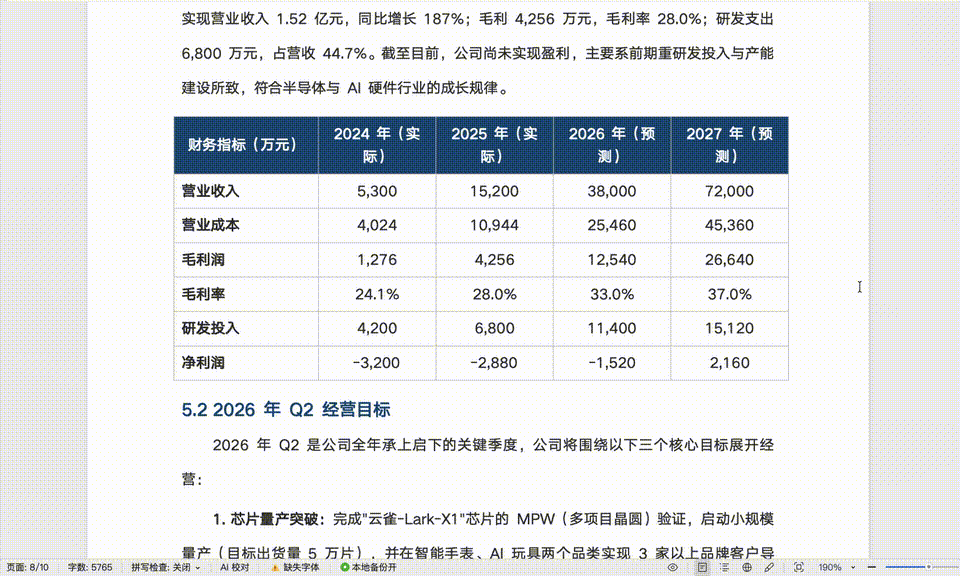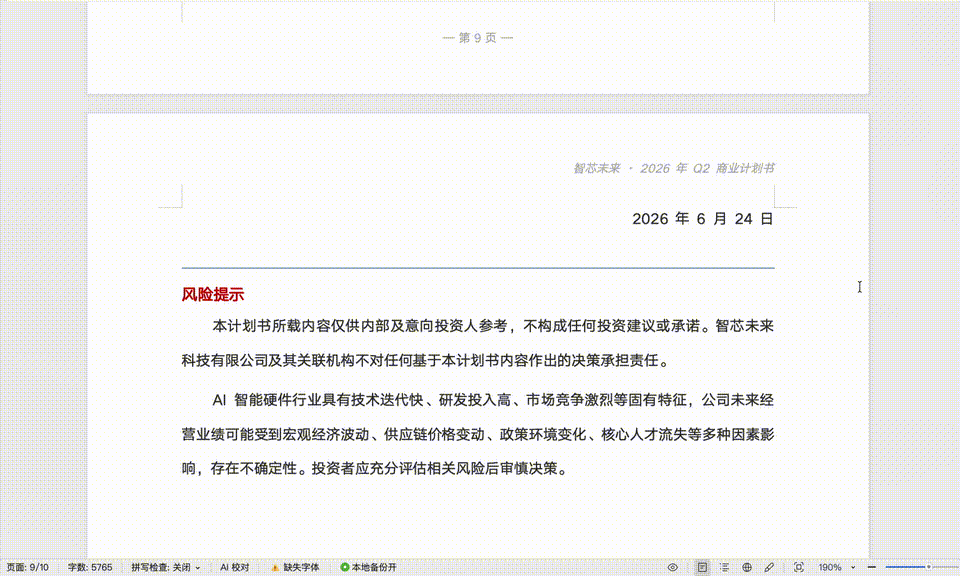
O publicador da fonte testou o Wenxin com um arquivo de informações de uma empresa e pediu que ele produzisse um plano de negócios do 2º trimestre de 2026 como documento Word.
De acordo com o registro do teste, o agente:
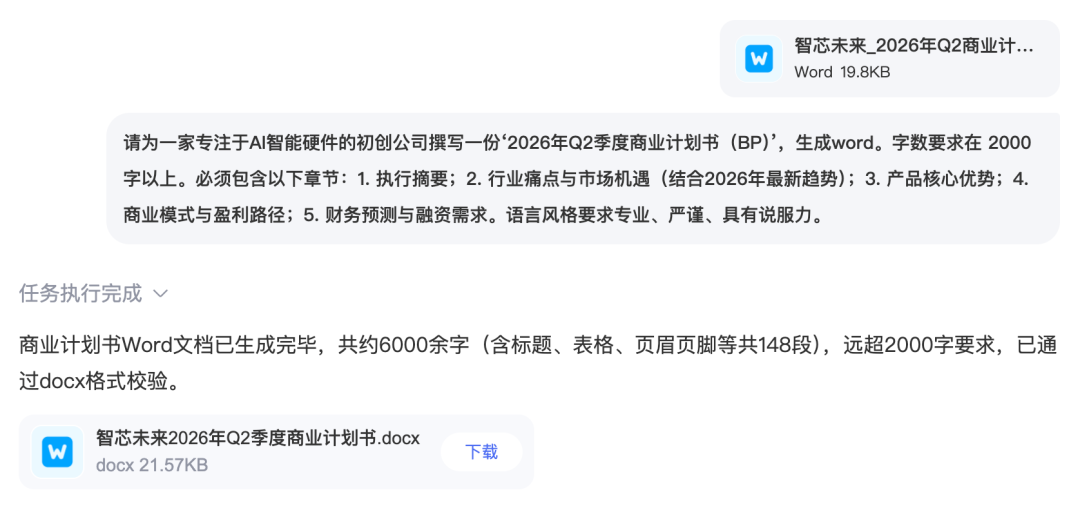
Isso mostra a diferença entre trabalho de chat e trabalho de agente.
Um modelo de chat pode escrever o plano dentro da conversa.
Um fluxo de trabalho de agente pode fazer isto:
Ler arquivo de origem
→ extrair informações estruturadas
→ redigir conteúdo
→ formatar documento Word
→ validar saída
→ retornar um arquivo
O artefato, não a resposta em prosa, torna-se o produto final.
O Wenxin obteve 99,44 em criação de conteúdo.
Em um benchmark de agentes, criação de conteúdo não é simplesmente escrita criativa.
O sistema pode precisar atender a múltiplas restrições ao mesmo tempo:
Um rascunho pode ser gramaticalmente correto e ainda assim falhar porque
ignora o formato solicitado.
É por isso que os benchmarks de produtos avaliam cada vez mais a conclusão, em vez de apenas a qualidade linguística.
A menor categoria XClaw do Wenxin foi codificação, com 90,28.
Ainda é uma pontuação forte, mas a diferença em relação à criação de conteúdo e ao processamento de dados é reveladora.
Agentes de codificação precisam gerenciar um ciclo operacional mais amplo:
Entender o requisito
→ escolher a stack
→ escrever arquivos
→ executar ou visualizar
→ inspecionar erros
→ corrigir
→ verificar a interação
→ empacotar o resultado
A fonte publicadora testou o produto com uma solicitação de uma frase para um simulador de Sistema Solar 3D.
O fluxo de trabalho relatado usou Three.js e retornou um aplicativo HTML de arquivo único com 31 KB.
O artigo também mostra uma página de ensino de simulação meteorológica gerada por um fluxo de trabalho web interativo semelhante.
Estes são demonstrações ilustrativas, e não itens oficiais do benchmark XClaw.
O Wenxin recebeu 96,44 em análise de pesquisa.
Uma tarefa de pesquisa séria pode envolver:
O artigo-fonte descreve dois casos de teste.
O publicador pediu ao Wenxin para pesquisar a conjectura tridimensional de Kakeya no contexto da medalhista Fields Hong Wang.
O comportamento relatado do agente foi:
O número de fontes não é uma métrica de qualidade por si só.
O que importa é se o agente final usa fontes autorizadas, atribui corretamente as afirmações, resolve conflitos, evita dados desatualizados e separa fatos de interpretação.
O publicador também pediu ao Wenxin para analisar as capacidades e preços dos principais modelos nacionais e internacionais do mês anterior.
O artigo diz que o agente:
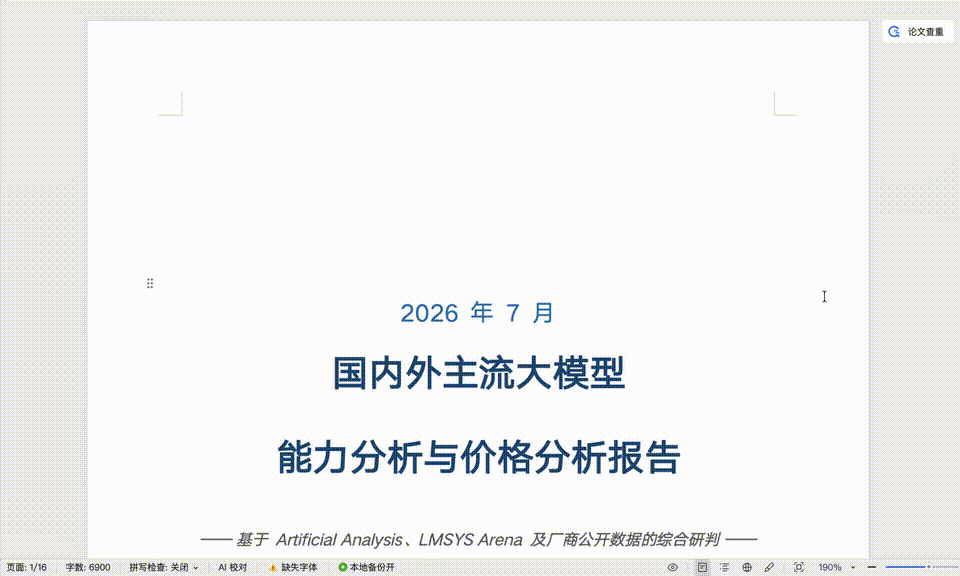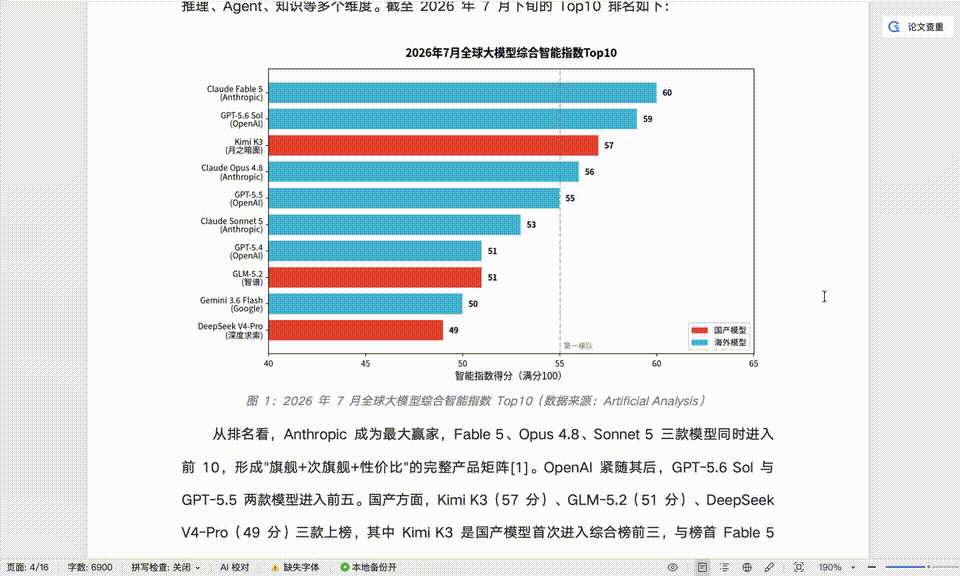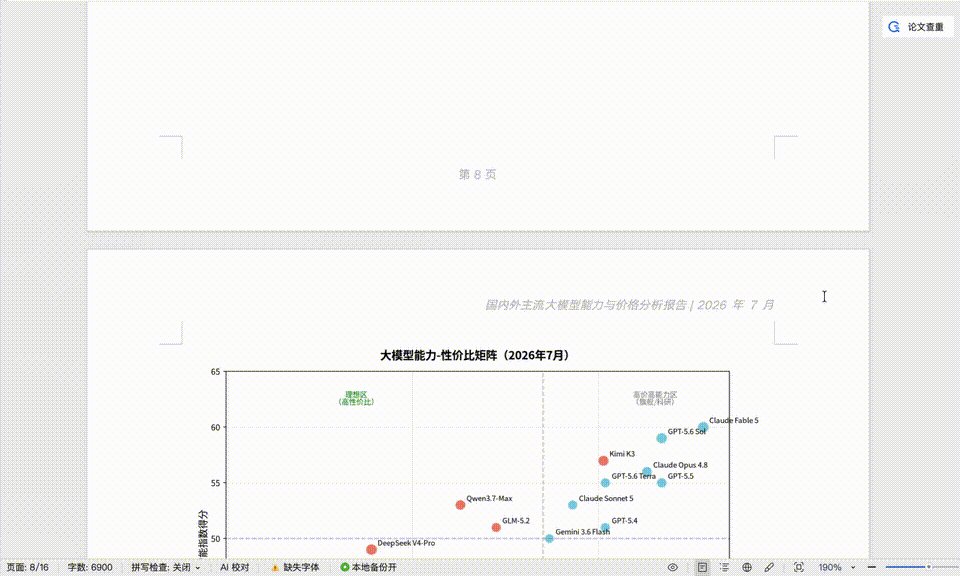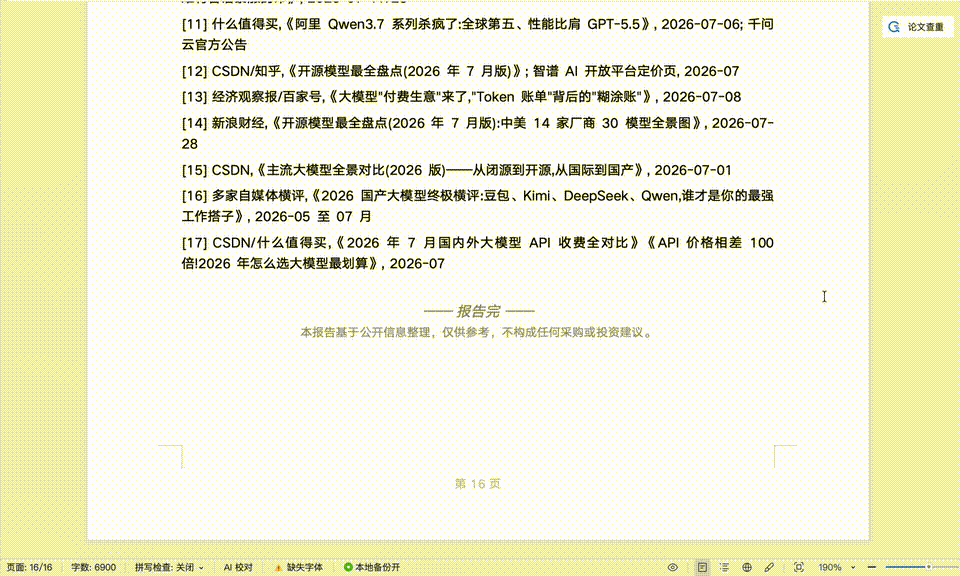
O ciclo de pesquisa útil é:
Buscar
→ identificar incertezas
→ buscar novamente
→ comparar fontes
→ resolver ou sinalizar divergências
→ escrever
Essa etapa extra de verificação é muitas vezes onde a qualidade da pesquisa melhora.
O resultado do SuperCLUE veio após uma primeira colocação em julho no PinchBench v2.
O PinchBench foi criado pela Kilo para avaliar agentes em fluxos de trabalho do mundo real, em vez de benchmarks tradicionais de perguntas e respostas.
A versão PinchBench 2.0 da Kilo expandiu o benchmark para 148 tarefas e adicionou regras mais rigorosas de avaliação e classificação.
No instantâneo do ranking de julho reproduzido pelo artigo de referência, o sistema da Baidu apareceu como:
Orion-Mission-Mode
com:
Melhor pontuação:    94,6%
Pontuação média: 94,4%
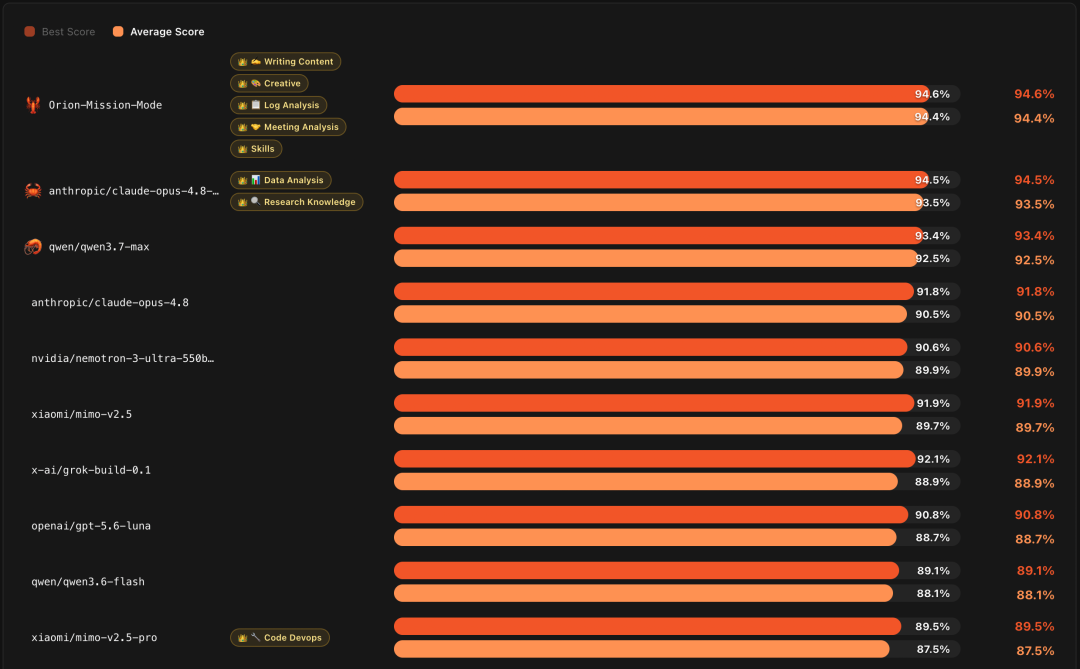
A captura de tela coloca o Orion Mission Mode à frente de sistemas baseados em modelos da Anthropic, Alibaba, NVIDIA, Xiaomi, xAI, OpenAI e outros naquele instantâneo específico.
A palavra importante é instantâneo.
Os rankings de agentes mudam rapidamente.
Modelos, estruturas, prompts, políticas de ferramentas e submissões de benchmark podem ser atualizados.
Um resultado de primeiro lugar em julho deve, portanto, ser citado com sua data, em vez de tratado como um ranking global permanente.
A Kilo descreve o PinchBench 2.0 como um benchmark de fluxos de trabalho de agentes do mundo real.
Ele contém tarefas que exigem que um sistema utilize ferramentas e conclua operações, em vez de simplesmente selecionar uma resposta.
O benchmark abrange categorias como:
O artigo de referência afirma que 59 entradas de modelos ou agentes estavam representadas no instantâneo do ranking.
Esse número pode mudar à medida que submissões são adicionadas ou atualizadas.
O benchmark em si é mais estável do que a população do ranking.
O lançamento oficial do PinchBench 2.0 descreve:
148 tarefas
A fonte e vários relatórios de julho descrevem a avaliação do Wenxin em 147 tarefas concluídas, ao mesmo tempo em que descrevem o PinchBench como um benchmark de 148 tarefas.
A interpretação mais segura é:
O PinchBench v2 contém 148 tarefas; a avaliação relatada do Orion Mission Mode pode ter produzido resultados pontuados em 147 delas naquele instantâneo.
Essa distinção é importante porque os relatórios de benchmark frequentemente misturam o tamanho do benchmark com o número de tarefas concluídas com sucesso.
execuções concluídas.
A fonte enfatiza que o Modo Missão Orion registrou:
94,6% melhor pontuação
94,4% pontuação média
A diferença de 0,2 ponto é pequena.
Isso sugere baixa variação entre as execuções relatadas.
No entanto, não deve ser interpretado como uma garantia universal de estabilidade.
A variância do benchmark pode depender de:
A lição prática é simplesmente que a execução relatada do PinchBench não foi construída em torno de um único resultado isolado de sorte.
Sua média permaneceu próxima da melhor pontuação.
Um dos pontos mais importantes no artigo de origem é que o benchmark avalia um produto ou sistema de agente, não um modelo de linguagem puro.
O agente de tarefas pode combinar:
Isso pode ser expresso como:
Resultado do agente
=
capacidade do modelo
+
ferramentas
+
memória
+
planejamento
+
busca
+
ambiente de execução
+
verificação
É por isso que se deve ter cuidado ao dizer:
“O Modelo X venceu o Modelo Y.”
O leaderboard pode, na verdade, comparar duas pilhas de agentes diferentes usando ferramentas e orquestrações distintas.
Uma descrição mais precisa é:
“O sistema de agente X pontuou acima do sistema de agente Y nesta configuração de benchmark.”
Essa formulação se torna cada vez mais importante à medida que os produtos de IA se transformam em sistemas de software complexos.
O artigo de origem enquadra 2026 como o ano em que o padrão para um produto de IA útil está mudando.
A interação mais antiga era assim:
Usuário pergunta
→ modelo responde
→ usuário executa o trabalho
O padrão emergente de agente é assim:
Usuário dá o objetivo
→ agente planeja
→ agente coleta contexto
→ agente chama ferramentas
→ agente cria arquivos
→ agente verifica resultados
→ agente entrega o artefato
Isso muda o que os usuários percebem.
Um modelo pode ser extremamente conhecedor, mas frustrante se não conseguir:
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
A nova condição de sucesso está mais próxima de:
A tarefa foi realmente concluída?
do que:
A resposta foi impressionante?
O artigo da BAAI mostra a opção “Tarefa” diretamente na interface do Wenxin.
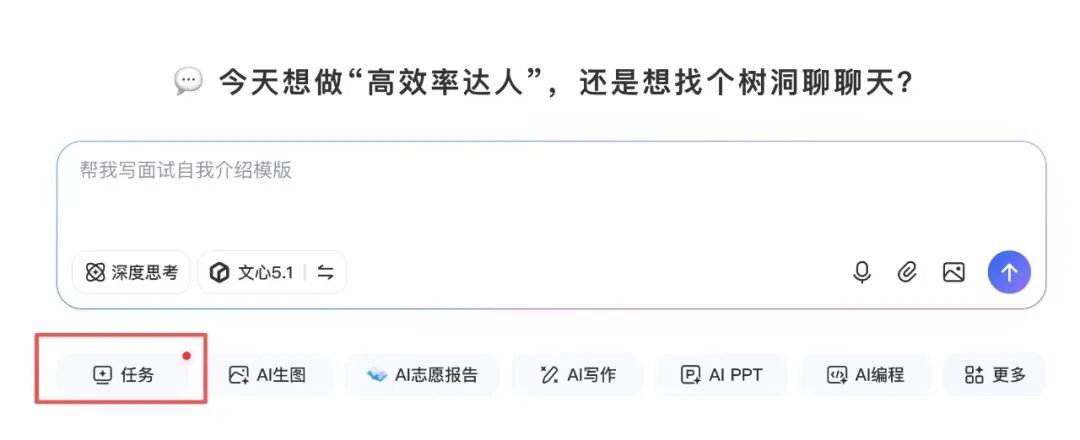
O site oficial do Wenxin da Baidu descreve o produto como um assistente de IA multimodal para:
Uso entre dispositivos.
O aplicativo Baidu também lista o Assistente Wenxin como um recurso integrado de IA para pesquisa aprofundada, busca, escrita, geração de imagens, geração de vídeos e assistência conversacional.
Isso confirma que a IA orientada a tarefas migrou para as superfícies de consumo mainstream da Baidu, em vez de permanecer apenas um experimento para desenvolvedores.
O artigo de origem destaca repetidamente um ponto comercial:
O Assistente Wenxin é gratuito e não tem paywall.
As páginas oficiais da Baidu para o Wenxin atualmente oferecem acesso gratuito ou experiência gratuita.
Isso é fácil de verificar.
A afirmação mais forte—permanentemente ilimitado para todos os recursos de agentes de tarefas—é mais difícil de verificar a partir de uma página oficial de política estável.
Produtos de IA podem introduzir:
Para publicação, a redação mais segura é:
O Assistente Wenxin está atualmente disponível para usuários individuais com opções de acesso gratuito, e a experiência de tarefa mostrada no artigo de origem não exigiu assinatura paga.
Não construa uma comparação de custo de longo prazo em torno de "ilimitado para sempre", a menos que a Baidu publique uma política específica garantindo isso.
A seção final do artigo de origem argumenta que o histórico de busca da Baidu lhe dá uma vantagem estrutural no design de agentes.
Há uma analogia real.
Um mecanismo de busca lida com algo como:
Consulta do usuário
→ compreensão da intenção
→ decomposição da consulta
→ recuperação
→ ranqueamento
→ agregação de resultados
→ resposta
Um agente lida com:
Objetivo do usuário
→ compreensão da intenção
→ decomposição da tarefa
→ seleção de ferramentas
→ execução
→ agregação de resultados
→ entrega
Os dois pipelines não são idênticos.
Um agente tem um espaço de ação muito maior e carrega maior risco de execução.
Mas várias capacidades técnicas se transferem naturalmente:
Isso é especialmente relevante para agentes de pesquisa.
Um sistema que já possui forte infraestrutura de busca pode construir fluxos de trabalho mais profundos sobre ela.
Considere uma solicitação de busca tradicional:
Encontre o voo mais barato de Pequim para Xangai.
Um sistema de busca pode precisar inferir:
Um agente que recebe:
Encontre o voo mais barato entre Pequim e Xangai e prepare um itinerário.
pode precisar adicionar:
A primeira metade do problema se assemelha à busca.
A segunda metade é orquestração de ações.
A experiência de busca fornece componentes úteis, mas a qualidade do agente ainda depende da camada de execução.
A fonte também conecta a pontuação de memória do Wenxin com a experiência da Baidu na compreensão de sessões de busca.
Há
alguma sobreposição conceitual.
Ambos os sistemas precisam inferir quais informações de interações anteriores continuam relevantes.
Uma sessão de busca pode conter:
Consulta 1: carros elétricos
Consulta 2: autonomia acima de 600 km
Consulta 3: abaixo de 250.000 RMB
O sistema deve entender que a terceira consulta ainda é sobre carros elétricos.
Um sistema de memória para agentes tem uma tarefa mais difícil.
Ele pode precisar lembrar:
A experiência em sessões de busca é útil, mas a memória persistente de agentes exige mecanismos adicionais de armazenamento, recuperação, privacidade e relevância.
Entre as cinco categorias do XClaw, a análise de pesquisa é o lugar mais claro onde a experiência de busca do Baidu pode ser transferida diretamente.
Um agente de pesquisa precisa de:
A documentação oficial do Qianfan AI Assistant do Baidu também descreve uma solução de agente empresarial que integra Busca do Baidu, Baidu Baike, busca de imagens, gerenciamento de conversas, gerenciamento de memória e capacidades de documentos.
Isso não prova que o produto de consumo Wenxin usa exatamente a mesma implementação.
Mas mostra que o Baidu está construindo uma stack comum de agentes em torno de busca, memória, ferramentas e recuperação multimodal em todo o seu portfólio de produtos.
Pontuações altas em benchmarks são evidências úteis.
Elas não são a avaliação completa.
Os rankings mudam.
Novos modelos e novas submissões de agentes podem ultrapassar o líder atual.
O XClaw agrega tarefas e categorias selecionadas.
O fluxo de trabalho real de um usuário pode ser muito diferente.
A pontuação pertence ao assistente completo ou à stack do agente.
Um agente que conclui tarefas com eficiência ainda pode fazer chamadas de ferramentas inseguras ou expor informações sensíveis em um ambiente diferente.
Agentes de pesquisa podem citar fontes fracas ou interpretar mal dados em mudança.
Preços e cotas de produto são políticas comerciais, não propriedades de benchmarks.
Um teste pessoal útil deve se assemelhar ao seu trabalho real.
Não faça apenas perguntas de curiosidades.
Dê ao agente uma tarefa completa.
Forneça cinco restrições no início de uma conversa longa.
Depois de várias trocas não relacionadas, peça um artefato final e verifique se todas as cinco foram preservadas.
Carregue:
Peça ao agente para combiná-los em um único relatório.
Verifique cada valor numérico de forma independente.
Escolha um tópico com informações em mudança.
Exija:
Criação
Peça um artefato em Word, PowerPoint, planilha ou HTML.
Avalie:
Peça um pequeno aplicativo interativo.
Verifique:
Dê uma tarefa que exija várias ferramentas.
Observe se o sistema:
Ao comparar o Wenxin com outros agentes, use uma tabela mais ampla do que "pontuação de benchmark".
| Dimensão | O que medir |
|---|---|
| Sucesso da tarefa | O trabalho solicitado foi concluído? |
| Memória | As restrições anteriores foram mantidas? |
| Precisão | Os números e afirmações estão corretos? |
| Qualidade da pesquisa | As fontes são autoritativas e atualizadas? |
| Confiabilidade das ferramentas | As chamadas de ferramentas são consistentemente bem-sucedidas? |
| Qualidade do artefato | Os arquivos são utilizáveis sem reparo manual? |
| Recuperação | O agente consegue corrigir etapas com falha? |
| Latência | Quanto tempo leva uma tarefa completa? |
| Custo | Quanto custa um resultado aceito? |
| Privacidade | Como os arquivos enviados e a memória são tratados? |
| Disponibilidade | Os recursos principais são gratuitos, limitados por cota ou pagos? |
Isso fornece um quadro mais realista do que uma única posição em um ranking.
O ponto mais forte do artigo original é mais amplo do que o Baidu.
A competição entre agentes está mudando a definição de qualidade em IA.
Para a primeira geração de chatbots, os usuários focavam na qualidade das respostas.
Para os agentes de tarefas atuais, as questões-chave estão se tornando:
É por isso que benchmarks como XClaw e PinchBench estão atraindo atenção.
Eles aproximam a avaliação do trabalho de produção real.
Ainda há uma longa distância entre um benchmark e uma implementação empresarial.
Mas a direção é útil:
Benchmark de conhecimento
→ benchmark de raciocínio
→ benchmark de uso de ferramentas
→ benchmark de tarefas ponta a ponta
→ resultado real de produção
O último passo é, em última análise, o que importa.
O relatório de agosto de 2026 do SuperCLUE XClaw dá ao Assistente Wenxin uma pontuação geral de 97,62, colocando-o em primeiro lugar entre os produtos exibidos. Suas pontuações por categoria foram 90,28 em codificação, 99,44 em criação de conteúdo, 98,86 em processamento de dados, 96,44 em análise de pesquisa e 100 em memória.
Significa que o Wenxin recebeu nota máxima nas tarefas de memória incluídas naquela avaliação do XClaw. Não significa que o assistente nunca possa esquecer o contexto em toda e qualquer conversa real possível.
O PinchBench v2 é um benchmark de agentes criado pela Kilo que avalia sistemas em tarefas reais de computador e fluxos de trabalho. A versão 2.0 contém 148 tarefas e é projetada para medir
execução de ponta a ponta em vez de simples resposta a perguntas.
Em um instantâneo de classificação de julho de 2026, o agente de tarefas da Baidu apareceu como Orion Mission Mode com uma melhor pontuação de 94,6% e uma pontuação média de 94,4%. As classificações mudam ao longo do tempo, portanto, a data do instantâneo deve ser incluída ao citar o resultado.
As páginas oficiais do Wenxin da Baidu atualmente oferecem opções de acesso gratuito ou experiência gratuita, e o artigo de origem afirma que os recursos de tarefas demonstrados estavam disponíveis sem assinatura paga. Uma garantia oficial estável de uso ilimitado permanente para todos os recursos não foi encontrada, portanto, as cotas atuais devem ser verificadas diretamente no produto.
O artigo de origem mostra sessões de teste em que o Wenxin gerou um plano de negócios formatado em Word e páginas HTML interativas. Esses exemplos demonstram o fluxo de trabalho de tarefas do produto, mas não são uma garantia de que cada prompt ou ambiente produzirá o mesmo resultado.
Busca e agentes compartilham capacidades como compreensão de intenção, decomposição de consultas, recuperação, ranqueamento, agregação de fontes e contexto de sessão. Os agentes adicionam uma camada de execução mais ampla, incluindo chamadas de ferramentas, criação de arquivos, memória, planejamento e ação.
Não no sentido estrito. Eles avaliam produtos ou sistemas de agentes que podem combinar modelos com ferramentas, memória, busca, prompts, orquestração e ambientes de execução. Portanto, suas pontuações devem ser atribuídas à configuração completa do agente.
O Assistente Wenxin da Baidu ficou em primeiro lugar no snapshot de agosto de 2026 do SuperCLUE XClaw, com 97,62 pontos, incluindo uma pontuação perfeita de 100 em memória e notas acima de 96 em processamento de dados, criação de conteúdo e análise de pesquisa.
Esse resultado segue um snapshot do ranking PinchBench v2 de julho, no qual o Modo Missão Orion da Baidu registrou 94,6% de melhor pontuação e 94,4% de pontuação média. Os benchmarks usam tarefas diferentes, mas ambos enfatizam a conclusão real de tarefas, em vez de simples respostas a perguntas.
A principal conclusão não é que um assistente "venceu" permanentemente a corrida de agentes. Os rankings de agentes mudam rapidamente, e os sistemas avaliados incluem modelos, ferramentas, busca, memória, prompts e orquestração.
O que os dois resultados mostram é que a avaliação de IA está caminhando para um padrão mais prático: não se o modelo parece inteligente, mas se o agente consegue concluir o trabalho e entregar um resultado utilizável.
Comece com uma frase e tenha um site completo em minutos.



