Nome: Implantação - Ambiente de Produção Descrição: Validar e implantar o aplicativo no ambiente de produção. --- 1. Leia o checklist.md. 2....
checklist.md.scripts/verify-release.sh.O mecanismo importante é a divulgação progressiva.
O Claude vê uma descrição curta que o ajuda a decidir se uma determinada habilidade é relevante. O corpo completo da habilidade e os arquivos de suporte são carregados somente quando o processo é necessário.
Mukta compara isso a uma estante de livros.
Uma pessoa não precisa memorizar todos os livros antes de iniciar uma conversa. Ela só precisa saber qual livro pode conter informações relevantes e retirá-lo da estante no momento adequado.
As habilidades ajudam a resolver o problema do "arquivo de contexto em crescimento contínuo":
CLAUDE.md.A documentação oficial de habilidades da Anthropic sugere criar habilidades quando as equipes repetidamente colam as mesmas instruções, listas de verificação ou processos de várias etapas nas conversas, ou quando uma seção do CLAUDE.md evoluiu de um fato conciso para um processo.
As habilidades são reutilizáveis, mas ainda é necessário que alguém decida:
Os agentes podem ajudar a escrever e manter habilidades, mas o sistema ainda depende parcialmente da gestão humana.
Isso leva à quarta abordagem.
Mukta descreve a memória baseada em arquivos como o padrão que a Anthropic atualmente prefere em muitos sistemas de memória de agentes.
A justificativa é bastante pragmática.
Os agentes já são bons em:
grepEm vez de inventar uma interface de memória altamente especializada, as equipes podem organizar a memória como arquivos e fornecer aos agentes ferramentas comuns de sistema de arquivos.
Um possível layout é o seguinte:
memory/
├── organization/
│   ├── principles.md
│   ├── terminology.md
│   └── security-policy.md
├── teams/
│   ├── engineering/
│   │   ├── architecture.md
│   │   └── release-process.md
│   └── support/
│       ├── escalation-rules.md
│       └── response-style.md
├── projects/
│   └── billing-redesign/
│       ├── decisions.md
│       ├── known-issues.md
│       └── current-status.md
└── agents/
    └── agent-104/
        └── scratchpad.md
Esse layout suporta diferentes níveis de memória:
Ele também incorpora a divulgação progressiva.
O agente pode pesquisar nos diretórios e carregar apenas os arquivos relevantes para a tarefa atual.
A interface estilo sistema de arquivos não exige que toda memória empresarial exista como arquivos não gerenciados em um laptop.
A implementação subjacente ainda pode usar:
O ponto essencial é que o agente recebe uma abstração simples e navegável.
Na sessão de perguntas e respostas, um participante perguntou se isso equivalia a reinventar o banco de dados.
Mukta reconheceu que essa arquitetura retorna a princípios familiares de engenharia de software. Uma vez que as equipes entendem quais comportamentos devem ser determinísticos, elas podem movê-los para uma estrutura de controle, em vez de deixar o modelo improvisar a cada vez.
Uma pasta cheia de arquivos Markdown pode funcionar para um único usuário.
Mas quando milhares de agentes podem atualizar a memória organizacional compartilhada, isso se torna perigoso.
Mukta destacou quatro princípios de produção:
Cada atualização de memória deve ter um histórico.
Metadados úteis incluem:
Entradas de memória sem rastreabilidade de origem são difíceis de confiar.
Suponha que um agente adicione:
- Implantações de produção às sextas-feiras não exigem aprovação.
Sem origem, revisor e histórico de revisão, outro agente pode tratar essa declaração como autoritativa.
O controle de versão suporta:
Um sistema de memória versionado deve ser capaz de responder facilmente:
Qual interação deu origem a essa regra?
Dois agentes podem ler a mesma memória às 10:00.
O agente A grava uma atualização às 10:02.
O agente B, sem saber dessa alteração, grava sua própria versão às 10:03 e exclui acidentalmente a atualização do agente A.
Mukta descreveu um padrão de concorrência baseado em hash:
Agente lê a memória e registra o hash A
        ↓
Agente elabora a atualização
        ↓
Agente lê a memória novamente e registra o hash B
        ↓
Se hash A == hash B:
    Confirma a atualização
Caso contrário:
    Recarrega, rebaseia e tenta novamente
Isso é controle de concorrência otimista.
O modelo pode decidir qual alteração propor, mas a estrutura de controle deve impedir, de forma determinística, que gravações desatualizadas substituam versões mais recentes.
Nem todo agente deve ter permissão para editar toda memória.
Um modelo de permissão razoável pode ser:
| Escopo da memória | Acesso típico |
|---|---|
| Princípios organizacionais | A maioria dos agentes somente leitura; gravação apenas por processo de aprovação |
| Políticas de segurança | Agentes relevantes somente leitura; gravação restrita a controle humano |
| Processos da equipe | Equipe somente leitura; mantenedores designados gravam |
| Decisões do projeto | Agentes do projeto somente leitura; edições propostas exigem aprovação |
| Área de rascunho do agente | Agente individual leitura e escrita |
| Preferências do usuário | Acesso por agentes no escopo do usuário |
| Contexto sensível do cliente | Acesso estrito baseado em papéis |
Um agente não deve ser capaz de transformar uma observação incerta em uma regra organizacional abrangente.
Os limites de permissão também precisam ser aplicados ao Dreaming. As tarefas de integração só podem receber registros de conversa e memórias que sua identidade tenha autorização para acessar.
A memória pode se tornar um dos ativos de IA mais valiosos de uma organização.
Ela contém:
Mukta acredita que as equipes devem evitar projetar esse ativo para funcionar apenas dentro de um único produto.
Um sistema de memória portátil deve ter:
A portabilidade permite que o mesmo contexto bem organizado suporte:
Mesmo ferramentas de memória bem projetadas têm duas limitações estruturais.
O agente precisa concluir a tarefa e organizar a memória ao mesmo tempo.
Escrever na memória consome recursos que poderiam ser usados para o objetivo atual.
O agente pode:
Limitação dois: o agente só vê uma sessão
Um agente pode notar que um comando falhou uma vez.
Ele não consegue ver que o mesmo comando falhou em outras 300 sessões.
Um agente de suporte pode ver um cliente confuso sobre uma política.
Ele não consegue ver que a mesma confusão se repete em toda a região.
Um mecanismo de aprendizado em todo o sistema requer um processo com visibilidade mais ampla.
Esse processo é o que a Anthropic chama de "Sonho" (Dreaming).
O Sonho é um processo assíncrono que revisa o histórico do agente após a conclusão do trabalho normal.
Nas notas de versão atuais da API da Anthropic, o recurso de "Sonho" para agentes hospedados da Claude é descrito como uma prévia de pesquisa.
Um "Sonho" lê:
Em seguida, ele cria um armazenamento de memória de saída reorganizado, no qual é possível:
Isso não é um re-treinamento do modelo.
Os pesos do modelo subjacente não mudam.
A melhoria vem da alteração do contexto persistido, para que sessões futuras possam recuperar esse conteúdo.
Mukta usou uma escola para explicar a diferença entre memória comum e "Sonho".
Imagine:
Um professor pode ajudar um aluno a corrigir um erro.
O coordenador pedagógico pode notar que todos os alunos de geografia cometem o mesmo erro no mesmo tópico, porque esse conteúdo simplesmente não está incluído no currículo.
A correção no nível do sistema não é corrigir prova por prova.
É atualizar o currículo.
Termos no contexto dos agentes:
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Isso permite que o sistema aprenda com padrões que um único agente não consegue perceber.
O pipeline simplificado do processamento do Sonho é o seguinte:
Fluxograma TD
    A[Armazenamento de memória existente] --> D[Orquestrador do Sonho]
    B[Registros de sessão] --> D
    C[Chamadas de ferramentas e metadados] --> D
    D --> E1[Agente revisor 1]
    D --> E2[Agente revisor 2]
    D --> E3[Agente revisor 3]
    E1 --> F[Aggregador de padrões]
    E2 --> F
    E3 --> F
    F --> G[Mudanças de memória propostas]
    G --> H{Aprovação humana}
    H -->|Aceito| I[Armazenamento de memória atualizado]
    H -->|Rejeitado| J[Preservar memória existente]
O processo de revisão pode examinar conteúdos que vão além das mensagens do usuário e do assistente.
Evidências úteis incluem:
O agente do Sonho então procura padrões como:
Mukta mencionou que o design da Anthropic pode incluir exemplos de registros de sessão relevantes e estatísticas que mostram a frequência do padrão.
Essas evidências ajudam os humanos a julgar se a mudança de memória proposta é razoável.
O processo do Sonho tem amplo acesso e pode afetar o comportamento futuro de todo um cluster de agentes.
Isso torna atualizações automáticas e sem supervisão arriscadas.
Um fluxo de trabalho mais seguro é:
Por exemplo:
## Atualização de memória proposta

**Alvo:** `teams/engineering/test-process.md`

**Problema observado:**
Os agentes usaram o comando de teste unitário para executar testes de integração em 18 das 63 sessões relevantes.

**Evidências:**
Sessões `s-102`, `s-111`, `s-118`, `s-124`, ……

**Adição proposta:**
- Usar `npm run test:integration` para todos os testes que exigem contêiner de banco de dados.
- Não usar `npm test` para arquivos em `tests/integration/`.

**Confiança:** Alta

**Decisão humana:** Pendente
Isso preserva a supervisão humana e permite que o cluster de agentes realize a maior parte do trabalho analítico.
O processamento do Sonho exige chamadas adicionais de modelo.
À primeira vista, isso parece um custo desnecessário.
Mukta acredita que um armazenamento de memória mais limpo reduz o custo total, porque os agentes futuros têm mais probabilidade de concluir a tarefa corretamente na primeira tentativa.
Na primeira tentativa.
Uma comparação econômica útil é:
Custo de sonhar
vs.
Custo de falhas repetidas, tentativas, retrabalho e contextos excessivamente longos
As economias potenciais podem vir de:
A Anthropic ainda não publicou um benchmark genérico que indique quanto cada organização pode economizar. O valor específico depende:
O "Sonho" tende a gerar retorno quando um grande número de agentes executa trabalhos relacionados e encontra repetidamente os mesmos padrões.
Uma equipe não precisa esperar pela integração completa da plataforma para testar esse conceito.
Uma versão manual pode ser executada uma vez por semana.
Coletar apenas os registros de conversa que os revisores têm permissão de ver.
Organizar por:
Incluir:
CLAUDE.mdO prompt pode ser assim:
Revise esses registros de sessão autorizados e os arquivos de memória atuais.

Identifique falhas recorrentes, correções repetidas do usuário, instruções desatualizadas,
processos ausentes e entradas duplicadas.

Para cada alteração proposta:
1. Aponte o arquivo de destino.
2. Forneça os IDs das sessões de suporte.
3.

Explique a frequência com que esse padrão ocorre.
4. Elabore a modificação mínima eficaz.
5. Não edite os arquivos diretamente.
Rejeite as seguintes modificações:
Use controle de versão e inclua as evidências da origem no registro de commit ou auditoria.
Acompanhe se as mesmas falhas diminuem nas sessões seguintes.
Sem medição, "sonhar" se torna um trabalho de geração de documentos, e não um sistema de aprendizado.
A memória responde a:
O que o agente deve lembrar do trabalho anterior?
A engenharia de estrutura em grafo responde a uma pergunta diferente:
Quais partes da tarefa atual realmente dependem umas das outras?
O artigo de origem do BAAI conecta o tópico da memória a um guia de engenharia de grafos que circula na comunidade de desenvolvimento de IA.
O argumento central desse guia é que muitos "fluxos de trabalho" já são, essencialmente, grafos — só que mal projetados.
Fluxos de trabalho escritos como listas tendem a ser artificialmente transformados em processos seriais:
Pesquisa
    ↓
Resumo
    ↓
Comparação
    ↓
Verificação de fatos
    ↓
Redação
Algumas dessas etapas podem, de fato, depender da saída da anterior.
Outras podem estar esperando desnecessariamente.
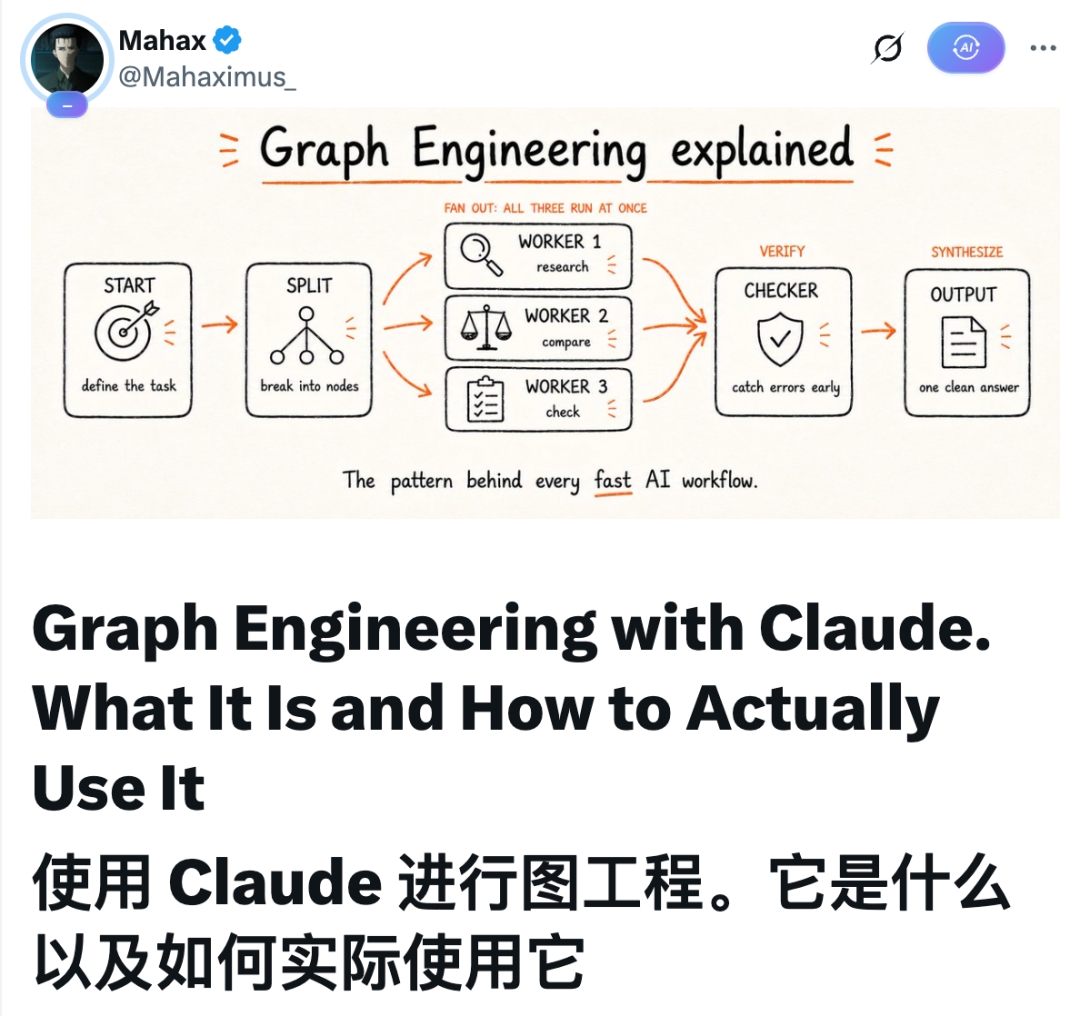
No grafo de fluxo de trabalho:
Por exemplo:
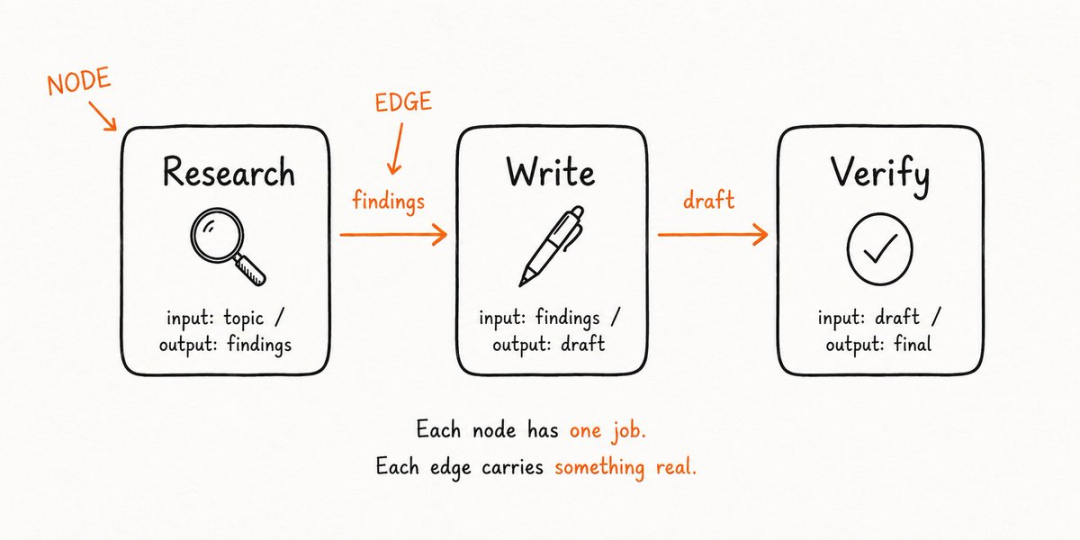
O nó de pesquisa produz os resultados da pesquisa.
O nó de redação consome esses resultados e produz um rascunho.
O nó de verificação consome o rascunho e produz um resultado revisado.
Essas setas fazem sentido porque cada nó downstream precisa da saída do nó upstream.
O guia comunitário de grafos propõe um teste simples para cada seta:
A próxima tarefa realmente precisa da saída da tarefa anterior?
Se a resposta for não, essa dependência é uma pseudo-dependência.
Considere o seguinte fluxo de trabalho:
Pesquisar concorrente A
    ↓
Pesquisar concorrente B
    ↓
Pesquisar concorrente C
    ↓
Escrever relatório comparativo
Pesquisar o concorrente B geralmente não precisa da saída da pesquisa do concorrente A.
Pesquisar o concorrente C geralmente não precisa da saída da pesquisa do concorrente B.
Essas tarefas podem ser executadas em paralelo:
flowchart TD
    A[Definir critérios de comparação] --> B1[Pesquisar concorrente A]
    A --> B2[Pesquisar concorrente B]
    A --> B3[Pesquisar concorrente C]
    B1 --> C[Escrever relatório comparativo]
    B2 --> C
    B3 --> C
Remover pseudo-arestas reduz o tempo de espera.
Se as três tarefas de pesquisa levarem 10, 12 e 15 minutos, respectivamente:
O grafo não torna nenhum agente individual mais rápido.
O que ele muda é o agendamento.
Depois de remover as pseudo-arestas, uma forma comum aparece:
Isso é geralmente chamado de losango.
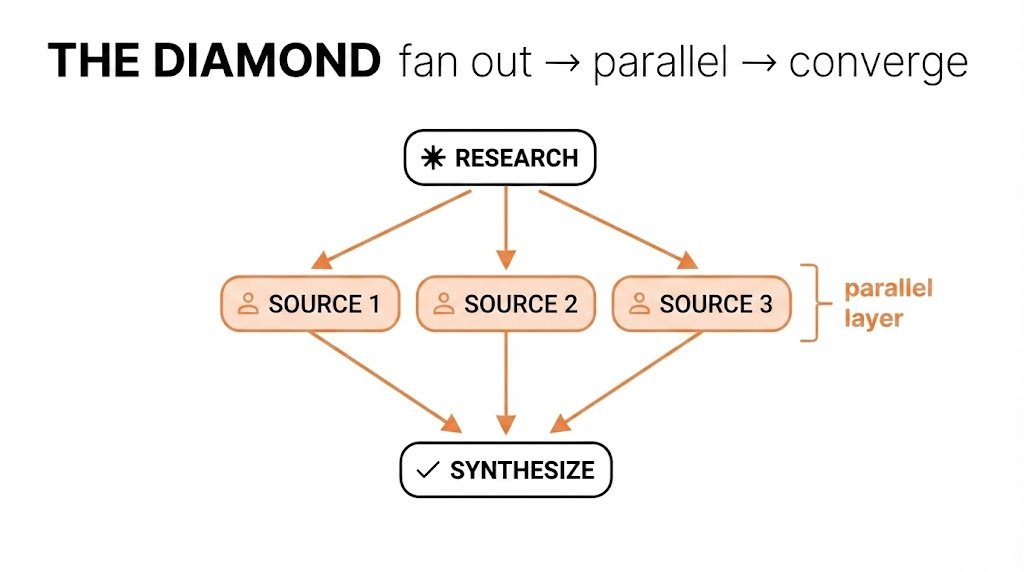
Um exemplo de pesquisa poderia ser assim:
flowchart TD
    A[Pergunta de pesquisa] --> B1[Dados de mercado]
    A --> B2[Evidências de clientes]
    A --> B3[Análise de concorrentes]
    B1 --> C[Verificador]
    B2 --> C
    B3 --> C
    C --> D[Síntese final]
O tempo total é determinado principalmente pelo ramo mais lento, e não pela soma de todos os ramos.
O paralelismo introduz um novo risco.
Um thread de trabalho pode produzir uma saída fraca, desatualizada ou sem suporte.
Se o sistema mesclar tudo sem validação, um ramo ruim pode contaminar a resposta final.
Por isso, o guia de grafos coloca um verificador antes da síntese.
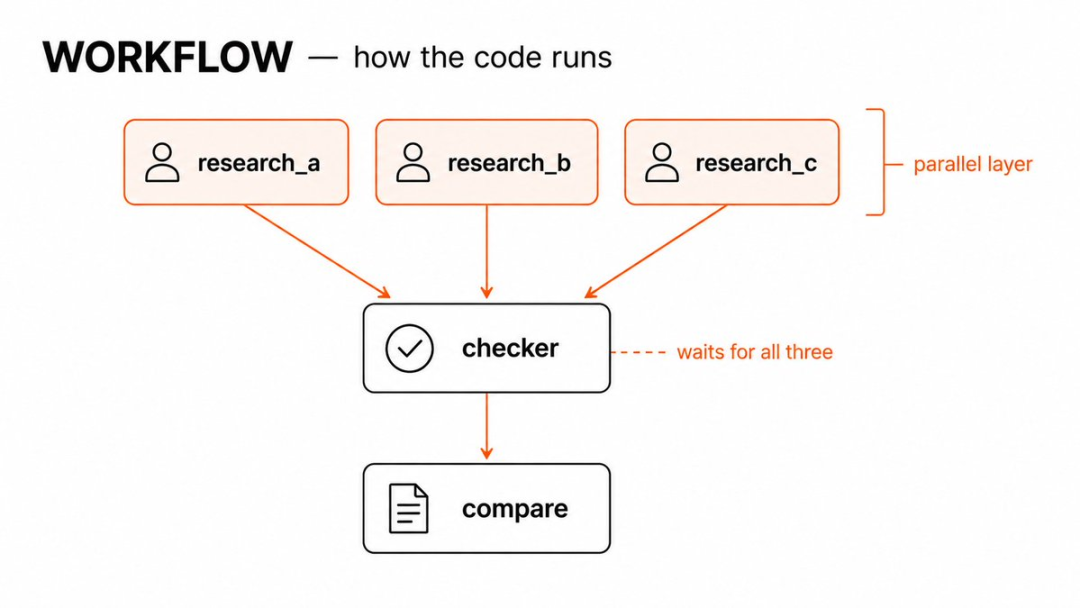
Um verificador pode perguntar:
O resultado está em conformidade com o formato solicitado?
Um verificador útil deve ter critérios de aceite claros.
Por exemplo:
Comece com uma frase e tenha um site completo em minutos.



