For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/claude-code-language-migration-workflow-anthropic.md.
Alterar a linguagem principal de uma base de código madura e em produção era um tipo de projeto que as equipes adiavam por anos. O trabalho ...
Alterar a linguagem principal de uma base de código madura em produção costumava ser o tipo de projeto que as equipes adiavam por anos. Esse trabalho é caro, arriscado e difícil de estimar. Uma migração poderia consumir vários trimestres de engenharia, com duas implementações divergindo gradualmente e, no final, alcançando apenas uma consistência comportamental incompleta.
Um projeto interno recente da Anthropic mostra que isso está começando a mudar.
Em julho de 2026, a Anthropic publicou um relatório prático detalhando como seus desenvolvedores usaram Claude Code, Claude Fable 5, Claude Opus 4.8 e um fluxo de trabalho multiagente dinâmico para migrar dez pacotes de código em cerca de um mês. Esses pacotes variavam de dezenas de milhares a centenas de milhares de linhas de código.
Dois casos se destacaram particularmente:
O insight importante não é que modelos de IA podem traduzir arquivos rapidamente, mas que um sistema de migração bem projetado pode gerar, revisar, testar, rejeitar e regenerar código repetidamente com intervenção humana mínima.
A Anthropic resume sua filosofia assim: o trabalho principal do desenvolvedor não é corrigir manualmente cada erro gerado, mas sim melhorar o processo que continuamente produz esses erros.
Bun é um toolkit JavaScript e TypeScript completo, incluindo runtime, gerenciador de pacotes, bundler, executor de testes e outras ferramentas de desenvolvimento. Sua implementação original dependia fortemente de Zig e integrava-se com uma grande quantidade de código C e C++.
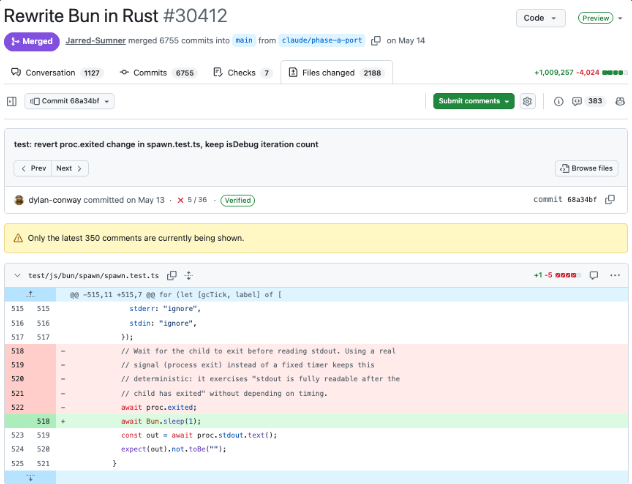
Jarred Sumner usou cerca de 50 fluxos de trabalho dinâmicos do Claude Code em 11 dias para concluir a migração para Rust. O pull request mesclado continha mais de um milhão de linhas de código novo e milhares de commits.
Antes da mesclagem, o conjunto de testes de integração contínua existente da Bun passou em todas as plataformas suportadas. A Anthropic relatou posteriormente 19 regressões após a mesclagem, todas corrigidas em seguida.
Esta migração não foi um redesign do zero. O objetivo era manter a arquitetura e o comportamento existentes da Bun enquanto substituía a linguagem de implementação. Isso reduziu as variáveis em jogo: o projeto poderia focar em semântica de linguagem, ownership, segurança de memória e compatibilidade, em vez de reconstruir o produto do zero.
O relatório oficial da Bun explica por que Rust era atraente. Muitos problemas recorrentes de estabilidade envolviam gerenciamento de ciclo de vida, caminhos de limpeza esquecidos, uso após liberação, condições de corrida e risco de double free. Em Rust seguro, muitos desses problemas se tornam erros de compilação, em vez de problemas descobertos apenas através de falhas em produção, fuzzing ou revisão manual.
O projeto de Mike Krieger seguiu um caminho diferente. Em vez de preservar ao máximo a estrutura de arquivos original, esta migração envolveu mais redesign arquitetural.
O resultado foi a geração de aproximadamente 165.000 linhas de código TypeScript em um fim de semana. O processo supostamente usou:
A justificativa de negócios era clara. Esta ferramenta interna baseada em Python era distribuída como um único binário, mas gerar esse binário levava cerca de oito minutos por plataforma, totalizando aproximadamente 30 minutos para toda a matriz de lançamento.
Após a migração, a compilação levou cerca de dois segundos, a velocidade de inicialização aumentou seis vezes e a equipe pôde eliminar um pipeline de deploy separado.
Migrações de linguagem ainda exigem uma verdadeira justificativa de engenharia ou negócios. Geração de código mais rápida não significa que cada reescrita é justificada.
As equipes geralmente reconsideram a escolha da linguagem quando o ambiente desde a criação do sistema mudou. Gatilhos típicos incluem:
O uso inicial de Zig pela Bun fazia sentido. Para um fundador construindo sozinho um runtime muito amplo antes do surgimento de agentes de codificação contemporâneos, a linguagem fornecia controle de baixo nível que ajudou Jarred Sumner a avançar rapidamente.
Anos depois, Bun tornou-se uma ferramenta de produção amplamente usada com uma superfície de manutenção muito maior. O custo de bugs recorrentes relacionados à memória aumentou, e o Claude Code tornou a portabilidade mecânica viável o suficiente para ser testada.
Portanto, a decisão não foi "Zig é ruim e Rust é bom", mas sim que a escala atual da Bun, suas necessidades operacionais e as ferramentas disponíveis mudaram as compensações.
Migrações de linguagem assistidas por IA ainda podem ser caras.
A Anthropic relatou que o projeto Bun consumiu aproximadamente:
| Categoria de uso | Quantidade reportada |
|---|---|
| Tokens de entrada não armazenados em cache | 5,9 bilhões |
| Tokens de saída | 690 milhões |
| Equivalente estimado de preço de API | Cerca de US$ 165.000 |
A parte principal da migração Python para TypeScript de Mike Krieger usou cerca de 27 milhões de tokens.
Esses números são muito menores que o custo de engenharia de migrações tradicionais de vários anos, mas não são insignificantes. As equipes também devem considerar:
A redução de custos torna mais projetos financeiramente viáveis, mas não elimina a necessidade de um business case.
Grandes migrações de linguagem possuem várias características que as tornam particularmente adequadas para trabalho com agentes de codificação colaborativos.
Migrações geralmente envolvem centenas ou milhares de arquivos, módulos, pacotes ou bibliotecas, que podem ser processados independentemente, desde que suas dependências sejam compreendidas.
Agentes podem traduzir unidades independentes em paralelo, em vez de esperar por um único fluxo de implementação central. O desafio muda de velocidade de digitação para orquestração, consistência e validação.
Muitas tarefas de software começam com requisitos incompletos. Migrações de linguagem começam com algo muito mais poderoso: a implementação original.
O código-fonte existente define fluxo de controle, estruturas de dados, casos limite, comportamento de erros, APIs públicas e tratamento específico de plataforma. Quando as regras de migração não são claras, os agentes podem consultar o original a qualquer momento.
Agentes têm melhor desempenho quando sucesso e falha podem ser verificados mecanicamente.
Compiladores, suítes de teste, scripts de consistência, benchmarks ou comparação de saída determinística fornecem a única fonte de verdade para o workflow. O sistema não precisa perguntar a revisores se a nova implementação "parece correta"; ele repetidamente compara o comportamento com a implementação original.
Erros de compilador, falhas, testes quebrados e diferenças de saída descrevem naturalmente o trabalho restante.
O sistema de migração não precisa que humanos escrevam listas de tarefas item por item.
Cada item de verificação com falha pode ser categorizado e atribuído a um agente de correção.
Quando o mesmo problema aparece em vários arquivos, corrigir manualmente um por um não é a abordagem correta.
A melhor solução é atualizar a regra de migração que causou o erro e, em seguida, regenerar apenas as unidades afetadas. Isso transforma um defeito encontrado em uma melhoria permanente no processo.
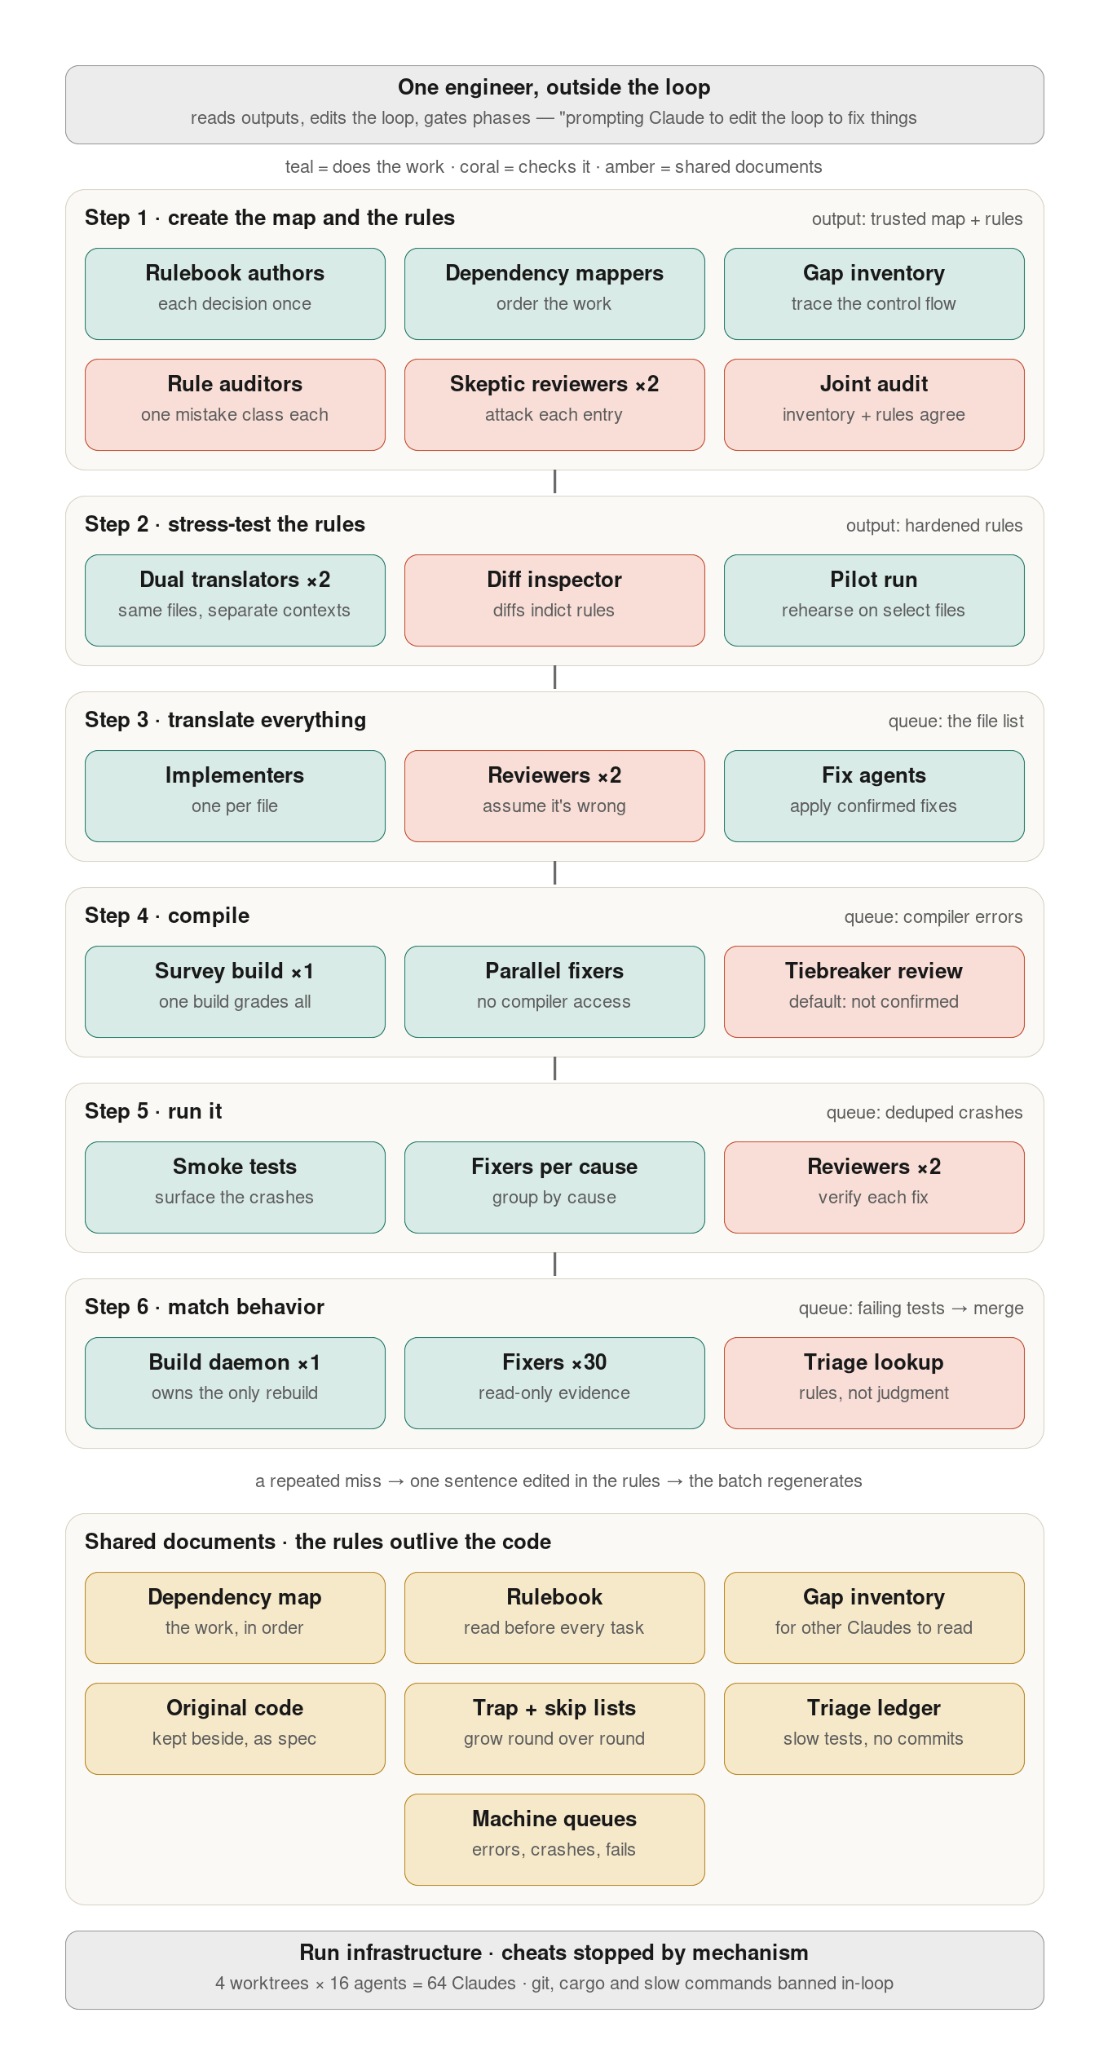
Antes de traduzir o código de produção, é necessário criar um sistema de validação que possa avaliar a implementação antiga e a nova em condições equivalentes.
Sem um avaliador confiável, o projeto não terá uma definição de conclusão confiável.
Suítes de teste escritas na linguagem de origem podem depender de funções privadas, classes internas ou detalhes de implementação que não existem na linguagem de destino. Esses testes nem sempre podem ser migrados diretamente.
A Anthropic sugere três etapas para preparar o sistema avaliador.
Separe os testes que expressam comportamento externo daqueles que dependem de detalhes internos de implementação.
Testes externos geralmente envolvem comportamento de linha de comando, APIs públicas, arquivos, rede, saída observável ou cenários completos de aplicação. Esses conteúdos são mais portáveis entre diferentes linguagens.
Converta testes orientados a comportamento em asserções que possam ser executadas em ambas as versões.
Use revisores adversariais independentes para garantir que os testes reescritos não sejam mais fracos que a versão original. Testes que passam com mais facilidade podem ocultar problemas de compatibilidade.
Execute o sistema de julgamento na implementação original e confirme que ele passa.
Em seguida, quebre o programa intencionalmente e confirme que o sistema de julgamento falha. Se um sistema de validação não consegue detectar defeitos conhecidos, ele não está pronto para supervisionar a migração.
Mike Krieger não construiu do zero uma suíte de testes completamente portável. Sua equipe criou um framework de testes de consistência cobrindo sete cenários reais e tratou qualquer diferença entre Python e TypeScript como um defeito.
A primeira etapa estabelece a base que todos os agentes subsequentes utilizarão.
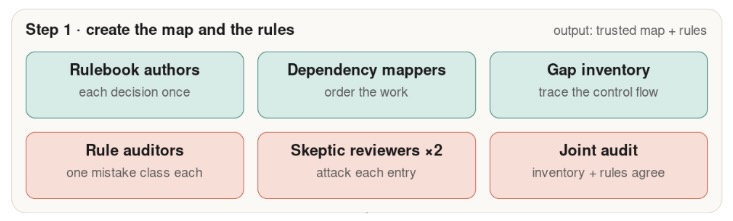
O manual de regras descreve como a linguagem de origem deve ser mapeada para a linguagem de destino.
Seu formato depende da estratégia de migração.
Para migrações que preservam a estrutura, o manual de regras pode conter:
Para redesenho, o manual de regras se aproxima mais de um documento de arquitetura. Ele define novos limites de componentes, interfaces, contratos de dados e decisões de design que os agentes de implementação devem seguir.
A ordem é importante. O manual de regras deve ser escrito antes da lista de lacunas, pois a lista de lacunas registra tudo o que as regras padrão não conseguem tratar com segurança.
O trabalho paralelo só é seguro quando o fluxo de trabalho entende quais unidades dependem umas das outras.
O gráfico de dependências ajuda a determinar:
Algumas linguagens expõem informações de dependência por meio de manifestos de pacote ou metadados de módulo. Sistemas mais antigos em C, C++ e Python podem exigir scripts de análise determinística para descobrir o gráfico de dependências.
Claude Code pode ajudar a criar e executar esse script, mas o gráfico gerado deve ser produzido por meios mecânicos, não apenas por suposições baseadas na saída do modelo.
A lista de lacunas captura diferenças que não podem ser tratadas por tradução direta.
Para uma migração de Zig para Rust, lacunas importantes incluem propriedade e ciclo de vida da memória. Zig permite que algumas responsabilidades de limpeza sejam
comunicadas por convenção ou anotações, enquanto Rust exige que as restrições de propriedade sejam expressas no sistema de tipos.
Para um trabalho de migração de Python para TypeScript, a definição de interface é uma lacuna importante. Python geralmente aceita objetos com base no comportamento em tempo de execução, enquanto TypeScript exige contratos explícitos antes que o código possa ser compilado com segurança.
A lista deve ser tratada como um artefato atualizado dinamicamente. Novas lacunas surgem continuamente durante os processos de tradução, compilação e teste de conformidade.
Não aplique imediatamente o novo manual de regras a milhares de arquivos.
Primeiro, realize uma migração pequena e, em seguida, descarte deliberadamente os resultados.
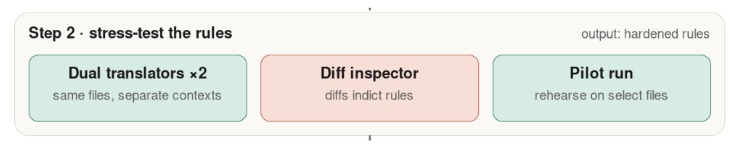
Para o Bun, o teste envolveu um pequeno número de arquivos:
Antes de aplicar a todos os 1.448 arquivos Zig, esse trabalho expôs dois problemas graves.
Migrações que preservam a estrutura tornam essa comparação relativamente fácil, pois duas implementações do mesmo arquivo podem ser revisadas lado a lado.
Para redesenho, o teste de estresse deve ser direcionado ao documento de arquitetura. Agentes adversariais podem atacar suas suposições e, em seguida, uma execução ponta a ponta única expõe interfaces ausentes e ordens irrealistas.
O objetivo é melhorar o manual de regras, não acumular código de produção. Depois de capturar as fraquezas, descarte os arquivos gerados.
Depois que as regras passam pelo teste de estresse, o trabalho de tradução pode ser expandido para todo o repositório.
com/cms-assets/image/2026/07/26354d74-9a83-4821-b425-a17b95bb4e0e-677c6dd7-8531-47f9-93ce-bf7d7df38679.jpeg)
A Anthropic descreve um ciclo repetitivo com três papéis:
O trabalho de implementação geralmente pode usar modelos menores e mais baratos. Os modelos mais fortes devem ser reservados para revisores, redatores de regras, decisões de arquitetura e disputas que exigem julgamento mais amplo.
Scripts em lote devem decidir o que está concluído verificando o sistema de arquivos ou outro estado determinístico.
Por exemplo, um arquivo fonte pode ser considerado traduzido quando o arquivo de destino correspondente existe no diretório esperado e passou pelos portões de revisão necessários.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Reconstruir a fila a partir do disco torna o processo recuperável. Se um agente parar, a máquina reiniciar ou um lote falhar, o orquestrador pode reconstruir o trabalho restante sem depender da memória volátil da conversa.
Quando o agente implementador não consegue concluir a tradução com confiança, deve deixar uma marcação pesquisável, como:
TODO(port): Explicar por que esta parte precisa de tratamento manual ou processamento posterior
A forma específica da marcação pode variar, mas deve incluir o motivo. Isso cria uma fila estruturada para as fases de compilação e correção.
O agente implementador não deve revisar a si mesmo.
A Anthropic e a Bun adotaram revisão adversária em janelas de contexto independentes. O revisor recebe o código alterado e é instruído a assumir que a implementação contém falhas.
Dois revisores podem verificar o mesmo lote de forma independente. Se houver conflito de conclusões, um terceiro agente pode julgar.
Essa separação reduz a tendência do agente de escrita de defender suas próprias escolhas e torna a execução autônoma de longa duração mais confiável.
Quando um revisor encontra repetidamente o mesmo defeito, o manual de regras deve ser atualizado e os lotes afetados regenerados.
Corrigir manualmente centenas de arquivos gerados leva a inconsistências e permite que o modo de falha original persista. Corrigir a regra de geração impede que o problema se repita em lotes subsequentes.
As três fases finais compartilham o mesmo ciclo básico: produzir falhas objetivas, classificar, atribuir um corretor, revisar a correção e repetir.
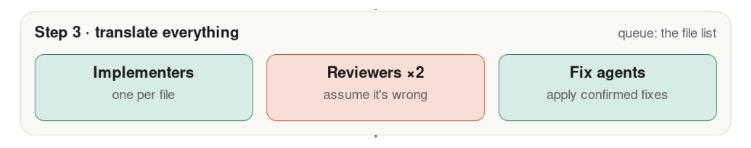
A compilação transforma erros em nível de linguagem em uma fila determinística.
Se a compilação faz parte de cada ciclo de tradução depende do custo.
O compilador TypeScript de Mike Krieger verifica uma unidade em segundos, portanto é executado com frequência durante a implementação. A construção Rust da Bun leva mais tempo, então Jarred Sumner manteve o Cargo fora do ciclo de tradução em nível de arquivo e compilou lotes maiores separadamente.
Para construções caras, use um único orquestrador ou um daemon de construção. O agente de correção escreve patches, permitindo que apenas o daemon reconstrua. Isso evita que dezenas de agentes iniciem a mesma operação cara simultaneamente.
Falhas do compilador em nível de sistema merecem atenção especial. Milhares de erros semelhantes podem indicar uma regra de dependência ausente, uma estratégia de limite de módulo incorreta ou um mapeamento de linguagem problemático, em vez de milhares de descuidos não relacionados.
Após a compilação do código, execute testes mínimos que exponham travamentos e falhas graves de tempo de execução.
Os resultados dos testes de fumaça fornecem outra fonte de verdade mecânica. Agrupe falhas por causa raiz, em vez de atribuir um agente para cada mensagem de erro sem análise.
Categorias úteis podem incluir:
Os revisores adversários devem verificar as correções de causa raiz propostas, especialmente quando uma única alteração afeta vários arquivos.
A fase final precisa comparar o novo programa com o original.
Execute conjuntos de testes portáteis ou estruturas de validação de paridade em ambas as implementações. Qualquer diferença inexplicável deve ser tratada como um defeito de migração, a menos que a equipe a aceite intencionalmente como uma mudança de produto.
O agente de correção pode verificar:
Para processos de reconstrução demorados, use um daemon de construção para processar patches em lote, compilar de uma só vez, executar apenas os testes afetados e retornar os resultados à fila.
Quando o mesmo padrão de falha aparece em vários testes, a medida corretiva deve ser adiantada. Atualize o manual de regras e regenere os arquivos sob regras incorretas.
A falta de um conjunto de testes não significa que a migração não possa ser concluída.
O aplicativo original pode ser usado como implementação de referência para construir uma estrutura de validação de paridade de comportamento em torno de cenários reais de usuário.
O fluxo de trabalho de Mike Krieger executou sete cenários nas versões Python e TypeScript, comparou as saídas e atribuiu cada caso de falha a um ciclo de correção dedicado. Depois, Claude projetou testes ponta a ponta adicionais, executando testes por quatro noites consecutivas.
Mesmo que a equipe precise construir um novo mecanismo de arbitragem em torno do código original, o código original continua sendo o único padrão de referência.
A Anthropic alerta para não tratar seu fluxo como um modelo universal. Cada base de código tem diferentes custos de construção, semânticas de linguagem, qualidade de teste, restrições de plataforma e compensações aceitáveis.
No entanto, as práticas a seguir são consistentes em vários projetos.
Falhas individuais pertencem ao ciclo de correção.
O esforço humano deve se concentrar em defeitos recorrentes, regras ausentes, limites de tarefa irracionais, elos de verificação fracos e gargalos no sistema de orquestração.
O revisor deve tentar ativamente provar que o código está errado.
Isso não significa ambiguidade ou julgamento pessimista. A conclusão da revisão deve apontar defeitos específicos, regras violadas, suposições inválidas ou incompatibilidades de comportamento.
Compiladores, casos de teste, scripts determinísticos, benchmarks e diffs de saída devem se tornar critérios de aceitação de resultados.
As opiniões do modelo são valiosas para pesquisa e revisão, mas não devem substituir a verificação objetiva—sempre que a verificação objetiva for viável.
O trabalho de tradução em larga escala geralmente é repetitivo e pode ser tratado por modelos menores.
Os modelos mais fortes devem ser usados para:
Isso reduz o custo do token sem remover o raciocínio forte das decisões de maior risco.
O manual de regras, o gráfico de dependências, a estratégia de validação e os testes de estresse exigem a participação humana mais cuidadosa.
Uma vez que essas bases estejam sólidas, o restante do trabalho se torna processamento de fila. Bases fracas tornam cada etapa subsequente mais cara.
O processo de migração deve ser capaz de se recuperar de interrupções sem reconstruir o estado por meio do histórico do chat.
Armazene o progresso em arquivos, commits, listas, bancos de dados ou outros artefatos determinísticos. "Concluído" deve ter um significado legível por máquina.
Compilação, testes de integração, criação de pacotes e benchmarks completos podem se tornar gargalos.
Execute essas operações por meio de um serviço ou daemon controlado para que agentes paralelos não desperdicem recursos ou corrompam o estado compartilhado.
A versão Rust da Bun já está em produção, embora ainda existam compensações de engenharia nos resultados.
A Anthropic relata que cerca de 4% do código Rust ainda reside em blocos unsafe, principalmente envolvendo operações curtas de ponteiro nas fronteiras com C e C++. O Rust não eliminou todos os problemas de baixo nível, mas os restringiu mais a regiões explícitas.
As melhorias relatadas incluem:
| Métrica | Resultado |
|---|
| Uso de memória em 2000 reconstruções repetidas | Reduzido de 6745 MB para 609 MB |
| Tamanho do binário no Linux e Windows | Reduzido em 19% |
| Desempenho em cargas de trabalho reais selecionadas | Melhoria de 2% a 5% |
| Vazamentos de memória detectáveis | Corrigidos |
| Problemas de regressão relatados pela Anthropic | 19, posteriormente corrigidos |
Esses resultados são mais importantes do que a contagem bruta de linhas de código. Uma migração bem-sucedida não é medida pela velocidade com que o agente gera código, mas pela compatibilidade, capacidade de manutenção, melhorias operacionais e pela capacidade de continuar desenvolvendo o produto após a migração.
Antes de iniciar uma migração assistida por IA em larga escala, responda às seguintes perguntas.
Se o sistema original estiver mudando rapidamente, será difícil medir a consistência. Considere congelar interfaces selecionadas ou priorizar a migração de módulos estáveis.
Defina verificações de compilador, testes, cenários, benchmarks e comparações de saída que determinem a conclusão.
Metas vagas como "fazê-lo se comportar de forma consistente" não são suficientes.
A portabilidade direta facilita a comparação e a paralelização. Redesenhar pode gerar uma arquitetura melhor, mas envolve mais julgamento e exige revisões de design mais rigorosas.
Avalie os seguintes custos:
Projete o orquestrador em torno do recurso compartilhado mais caro.
Defina os seguintes limites:
O fluxo de trabalho do Bun encontrou agentes interferindo uns com os outros através de comandos como git stash e git reset. As regras de orquestração foram atualizadas para proibir operações inseguras no repositório compartilhado e limitar os agentes a commits controlados em nível de arquivo.
Até que haja evidências que apoiem a mesclagem, a migração deve permanecer descartável.
Use branches isolados, builds reproduzíveis, pontos de verificação e processos claros para abandonar ou regenerar o trabalho quando as regras estiverem erradas.
A migração de código assistida por IA usa agentes de codificação, sob um fluxo de trabalho controlado, para realizar a tradução, revisão, compilação, teste e correção da base de código. O modelo não substitui a validação; compiladores, testes, verificações de consistência e regras definidas por humanos continuam sendo a autoridade final.
Jarred Sumner concluiu a portabilidade para Rust usando o fluxo de trabalho dinâmico do Claude Code, e o pull request do GitHub foi mesclado em maio de 2026. A conta oficial do Bun afirmou que o trabalho levou cerca de 11 dias, contando com implementação paralela, revisão adversarial e o conjunto de testes independente de linguagem já existente no projeto.
O pull request mesclado mostra mais de um milhão de novas linhas de código, juntamente com linhas excluídas e modificadas. Apenas a contagem de linhas não mede qualidade, portanto, os indicadores mais importantes são os resultados da compilação, testes entre plataformas, comportamento, uso de memória, tamanho do binário e o tratamento de regressões após a mesclagem.
Com base em 5,9 bilhões de tokens de entrada não armazenados em cache e 690 milhões de tokens de saída, a Anthropic estima o custo da API em cerca de 165 mil dólares. O custo real da organização pode variar devido a acordos de preços, infraestrutura interna, horas de trabalho humano, uso de CI e correções pós-mesclagem.
Um manual de regras de migração é um conjunto de políticas legíveis por máquina ou por agente que descrevem como os padrões da linguagem de origem mapeiam para a implementação de destino. Abrange tipos, propriedade, erros, interfaces, nomenclatura, casos não suportados, decisões de arquitetura e outras regras que os agentes de implementação devem seguir consistentemente.
Agentes de implementação têm contexto e inércia que podem torná-los tendenciosos a aceitar suas próprias soluções. Um revisor adversarial trabalha em um contexto independente e é instruído a encontrar falhas, violações de regras e diferenças de comportamento, em vez de ajudar a mesclar o código.
É possível, mas a equipe deve estabelecer outro árbitro objetivo. Uma plataforma de teste de consistência pode executar cenários reais em ambas as implementações e comparar as saídas, enquanto novos testes de ponta a ponta podem expor falhas que as verificações de tradução estática ignoram.
Não. A migração ainda requer benefícios mensuráveis, uma implementação de referência estável, validação objetiva, orçamento suficiente e um plano de reversão aceitável. Sistemas com testes fracos, comportamento não documentado, requisitos em rápida mudança ou restrições críticas de segurança podem precisar de muita preparação, ou ser inviáveis com as capacidades atuais de IA.
O trabalho de preparação necessário antes que o agente possa ajudar de forma responsável.
As práticas recentes de migração da Anthropic mostram que projetos de transposição de linguagem podem ser reestruturados em torno de workflows de agentes, em vez de depender de reescritas manuais longas e únicas. Tanto a migração do Bun de Zig para Rust quanto o projeto da Anthropic de Python para TypeScript dependem de implementação paralela, revisão adversarial, verificação determinística e regeneração repetida.
A parte reutilizável é o fluxo: construir um avaliador, definir regras, mapear dependências, estressar os métodos, traduzir em lotes retomáveis, compilar, executar e comparar comportamentos. Quando o mesmo defeito aparece repetidamente, corrija a regra ou o workflow que o gerou, em vez de corrigir manualmente cada saída.
Essa abordagem ainda exige orçamento considerável, testes robustos, permissões controladas e julgamento humano no nível da arquitetura. Ela reduz os custos de migração, mas não elimina o trabalho de engenharia.
Responsabilidade.
O ponto central é simples: uma migração confiável de IA vem de ciclos de produção verificáveis, não de um único prompt que pede ao modelo para reescrever toda a base de código.
Comece com uma frase e tenha um site completo em minutos.



