For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/claude-distillation-defenses-and-preserve-b64c5fd8.md.
A Anthropic afirma que novas proteções reduziram em aproximadamente 90–99% a quantidade de raciocínio do Claude coletada por destiladores em...
A Anthropic afirma que novas proteções reduziram em aproximadamente 90–99% a quantidade de raciocínio do Claude coletada por destiladores em sua própria plataforma. Sua atualização de 12 de outubro descreve três camadas de defesa: restrições à reutilização de raciocínio protegido, classificadores de extração mais robustos e controles de conta que tornam tentativas repetidas mais caras.
Há também uma consequência prática para desenvolvedores comuns. Algumas integrações precisam mudar a forma como reproduzem o histórico de conversas, e algumas solicitações bloqueadas antes de o Claude responder agora são cobradas. Entender esses custos exige separar os resultados antiabuso da empresa das regras de API que os aplicativos de fato encontram.
A destilação treina um modelo usando as saídas de outro modelo. Ela também é uma técnica legítima: desenvolvedores podem destilar seus próprios modelos ou usar dados para os quais têm permissão. O relatório da Anthropic se concentra em campanhas de extração não autorizada, frequentemente envolvendo contas fraudulentas, em vez de tratar toda destilação como abuso.
Nesse contexto, respostas finais são dados de treinamento úteis, mas o raciocínio detalhado pode ser ainda mais útil. Uma transcrição de raciocínio revela decisões intermediárias, abordagens tentadas e correções que um modelo aluno precisaria inferir de outra forma.
A Anthropic ilustra a diferença com um experimento que treinou um modelo Claude pré-treinado com transcrições do Claude Opus 4.8. As pontuações resultantes no SWE-bench Verified foram:
| Material de treinamento | Pontuação reportada no SWE-bench Verified |
|---|---|
| Transcrições com raciocínio completo | 80,4% |
| Transcrições com raciocínio resumido | 71,8% |
Essa é uma diferença de 8,6 pontos percentuais nesse experimento. Ela sustenta o valor das transcrições de raciocínio para essa configuração de treinamento; não estabelece uma vantagem universal da mesma magnitude entre modelos ou tarefas.
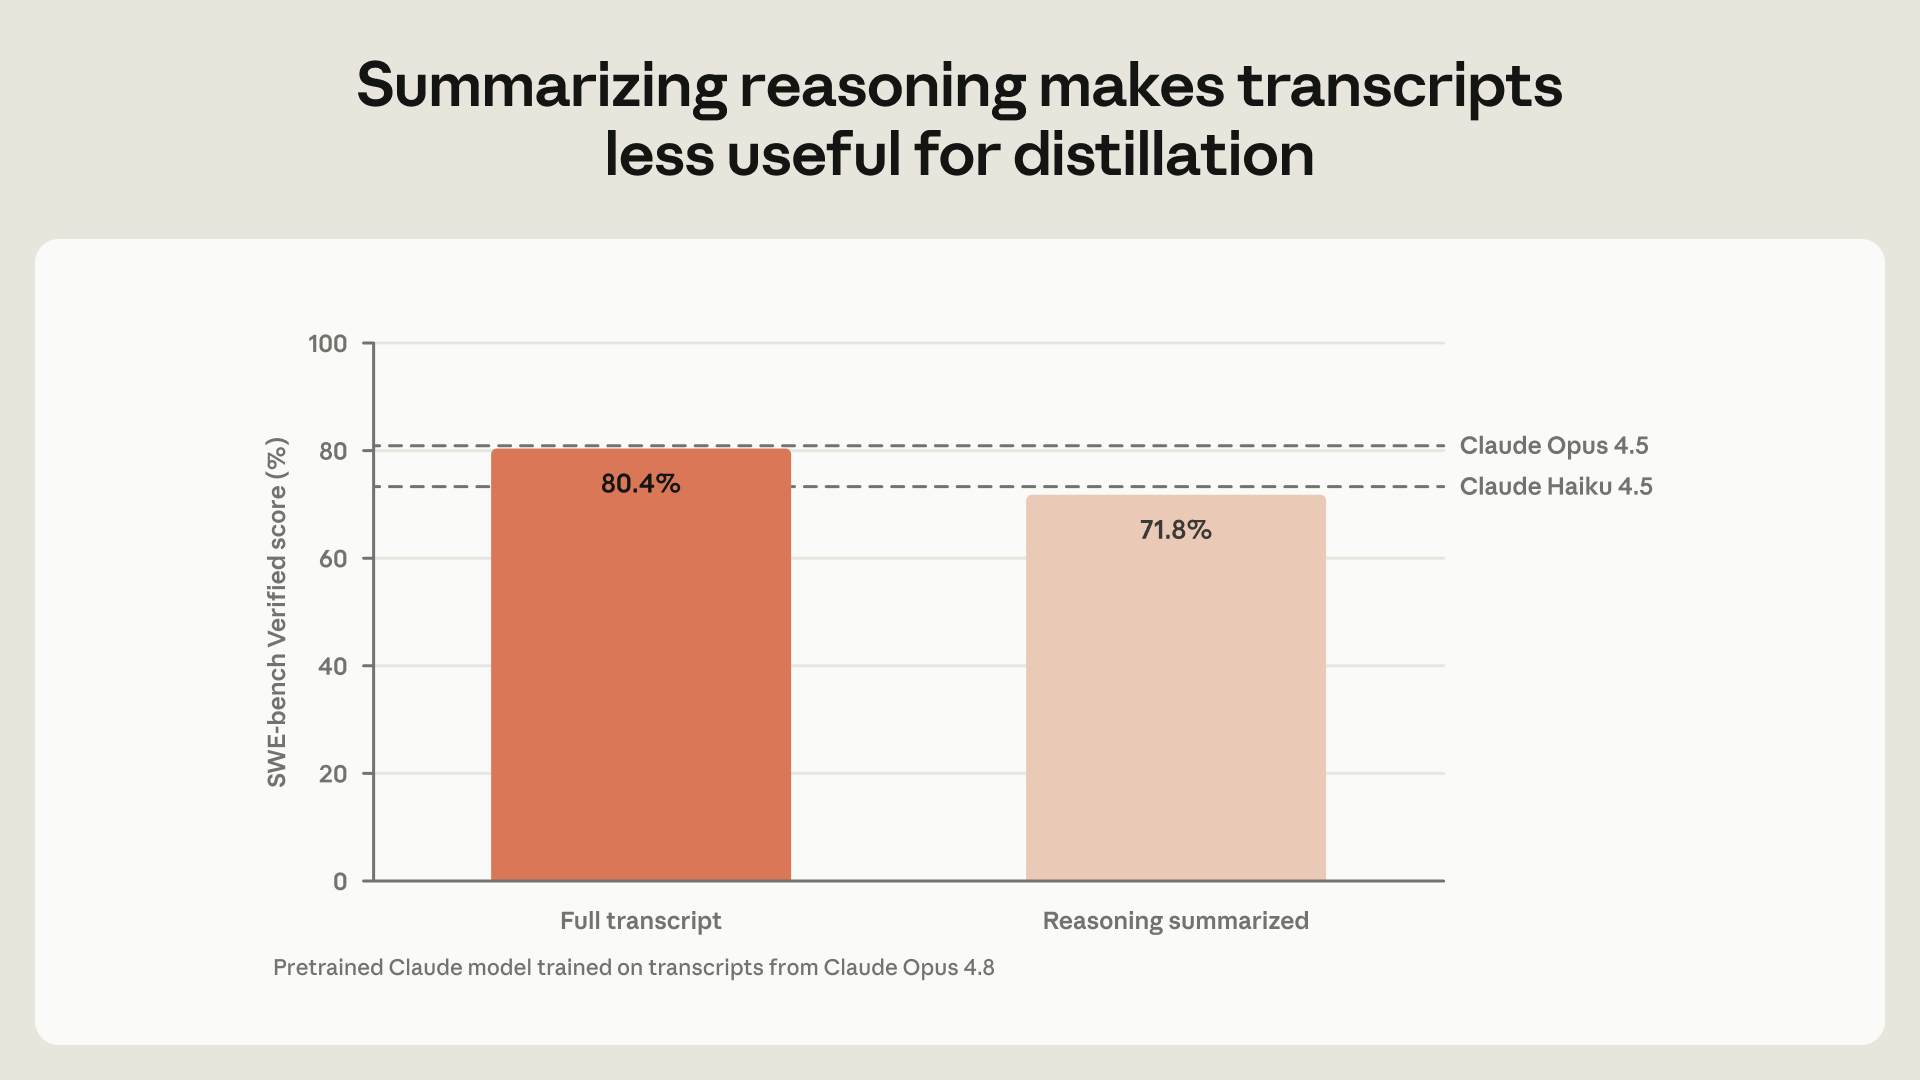
Fonte: Anthropic. As barras descrevem o modelo aluno treinado com transcrições do Opus 4.8, não uma comparação direta de benchmark entre os modelos de produção mostrados como linhas de referência.
Exibir resumos reduz a coleta passiva, mas cria um incentivo para obter o raciocínio oculto por meio de solicitações de acompanhamento. A Anthropic afirma que um laboratório testou 12.000 solicitações de extração diferentes. Ela também descreve redes de proxy que distribuem a atividade por um grande número de contas, incluindo uma rede relatada anteriormente que gerenciava mais de 20.000 contas fraudulentas ao mesmo tempo.
Em tarefas longas, um modelo pode precisar continuar a partir de um raciocínio produzido em um turno anterior. A API pode preservar blocos de pensamento protegidos para essa finalidade sem expor o raciocínio subjacente como texto comum legível pelo usuário.
Isso cria um problema de controle de acesso. Segundo a Anthropic, atacantes tentaram mover raciocínios entre conversas, modelos ou contas para encontrar um contexto no qual ele pudesse ser revelado. Portanto, proteger o bloco exige controlar sua reutilização, bem como sua exibição.
A Anthropic introduziu o pensamento preservado com Claude Fable 5.1 e Claude Opus 5.5. A documentação atual descreve duas verificações centrais:
A verificação de prefixo é aplicada por padrão a contas criadas em ou após 31 de agosto de 2026 às 00:00 UTC. Contas mais antigas podem aderir à aplicação por meio de controles documentados. A verificação de compatibilidade de modelo se aplica a todas as contas.
O anúncio da pesquisa também descreve restrições por organização para o raciocínio do Sonnet 5.5. A documentação atual da API fornece a regra mais específica: os blocos de pensamento do Sonnet 5.5 e do Haiku 5.5 funcionam apenas na conta que os produziu ou em uma conta vinculada, quando a aplicação documentada se aplica. Desenvolvedores devem usar essa documentação de compatibilidade ao implementar roteamento ou alterações de conta.
Comportamentos comuns de aplicativos podem alterar um prefixo protegido: reconstruir um prompt de sistema com um novo carimbo de data e hora, editar uma saída de ferramenta antiga, alterar descrições de ferramentas ou resumir turnos anteriores enquanto mantém blocos de pensamento posteriores.
Por padrão, um prefixo inválido pode gerar um 400 invalid_request_error. Os controles beta documentados também permitem definir thinking.block_binding.prefix_mismatch_behavior como drop_block; nesse caso, blocos de pensamento inválidos e os blocos de pensamento subsequentes são descartados para aquela solicitação. Isso mantém a solicitação em execução, mas não repara a mutação do histórico.
Mantenha estável o histórico reproduzido e acrescente novas informações usando padrões compatíveis. Alterar o texto visível de uma conversa e continuar reutilizando todo o seu antigo raciocínio protegido não é mais uma suposição segura.
A segunda camada da Anthropic usa um sistema de classificadores em duas etapas informado por sua pesquisa sobre Constitutional Classifiers. Ela testa tentativas de extração com equipes vermelhas internas e externas e, em seguida, atualiza as defesas quando uma técnica tem sucesso.
A empresa afirma que as salvaguardas resultantes contra destilação têm uma taxa de falsos positivos inferior a 0,1% em sua avaliação. Ela compara sua robustez com as defesas contra assistência para armas biológicas. Essa é uma avaliação da empresa sob suas condições de teste, não uma garantia de que a solicitação legítima de um usuário específico jamais será recusada.
O sistema também muda ao longo do tempo. A Anthropic descreve ter corrigido técnicas que buscavam revelar raciocínio protegido por meio de tradução ou saída especialmente formatada. A alegação publicada é que o classificador detecta as técnicas de extração descritas em seu relatório de setembro nos modelos abrangidos pelo sistema.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
A terceira camada atua sobre comportamentos repetidos. Contas que persistem em tentativas de extração podem receber limites de uso mais rígidos, e contas associadas podem ser banidas. A Anthropic relata ter banido dezenas de milhares de contas, por vezes em até duas horas após o início de uma campanha.
A partir de 24 de setembro, a Anthropic também voltou a cobrar por solicitações bloqueadas antes de uma resposta do modelo em categorias selecionadas de salvaguarda com taxas reportadas de falsos positivos inferiores a 0,1%, incluindo destilação. A fonte também identifica as categorias de uso indevido biológico e desenvolvimento de modelos de fronteira. Essa política não deve ser generalizada para toda solicitação recusada ou todo tipo de filtro de segurança.
A Anthropic estima que os tokens de raciocínio extraídos em sua própria plataforma caíram por um fator de 10–100 após a introdução do classificador, junto das mudanças de pensamento preservado. Em alguns dias, houve poucos tokens extraídos demais para que a empresa pudesse medir.
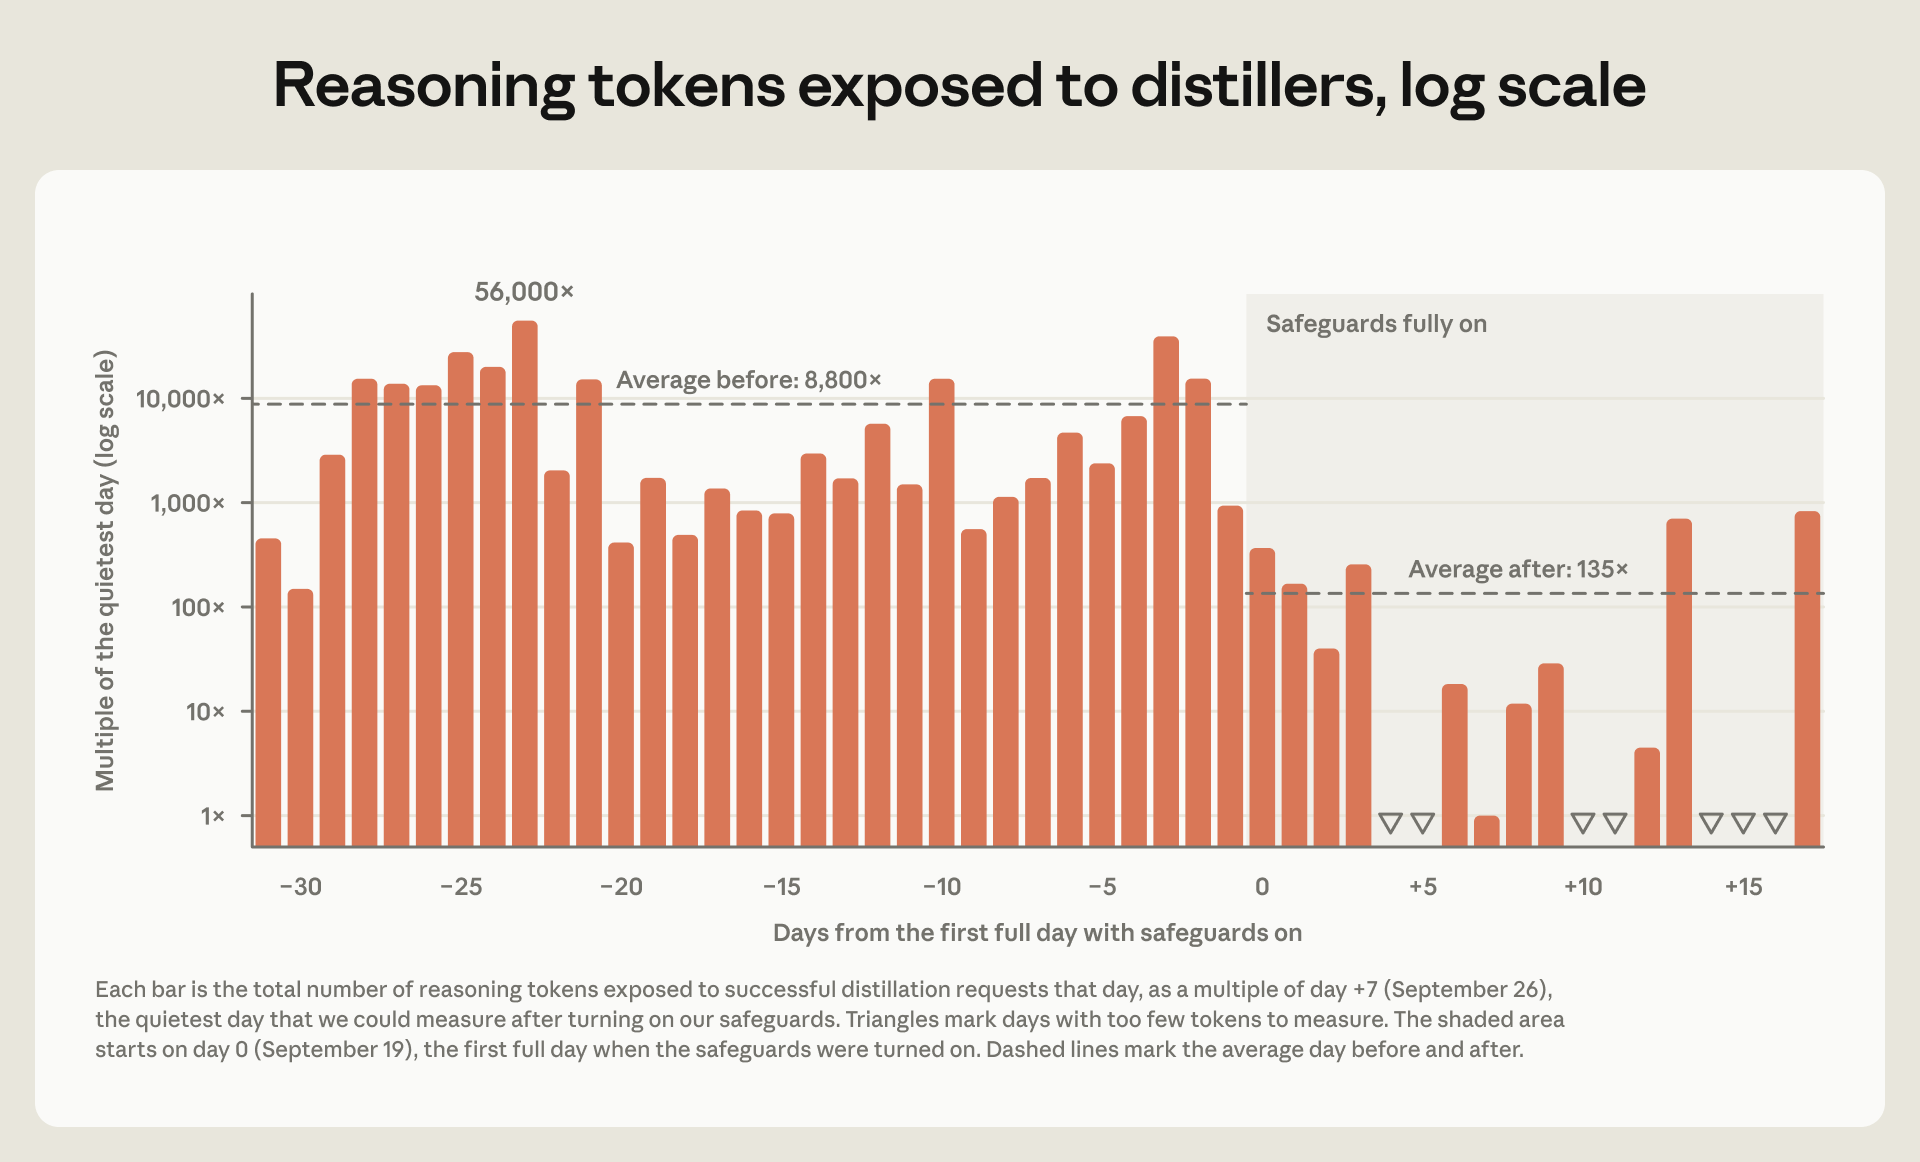
Fonte: Anthropic. O eixo vertical é logarítmico e normalizado para um dia de baixa extração, não uma contagem absoluta de tokens. Triângulos apontando para baixo indicam dias com tokens insuficientes para medição.
O escopo importa. Esses números descrevem a estimativa da Anthropic para sua própria plataforma; eles não medem toda a atividade de destilação em provedores de inferência de terceiros. A empresa também afirma que ainda não observou uma tentativa altamente sofisticada e persistente de derrotar as defesas totalmente implementadas e não sabe por quanto tempo os ganhos durarão.
A Anthropic reconhece que as mudanças não foram completamente transparentes para usuários comuns. Integrações podem precisar de atualizações, solicitações benignas podem ser classificadas incorretamente e esses bloqueios equivocados agora podem gerar cobranças nas categorias afetadas.
A perda de pensamento reutilizável tem outro custo: o modelo pode precisar reconstruir o trabalho. Em um benchmark de programação com múltiplos turnos descrito na documentação da API, descartar o pensamento uma vez por sessão aumentou os tokens de saída em 20,1% no esforço máximo. Trata-se de uma estimativa específica de carga de trabalho com amplas margens de erro, não de uma sobretaxa padrão ou previsão para todos os aplicativos.
Para um desenvolvedor, a distinção útil é entre um bloco de entrada ilegível ou descartado e uma saída recém-gerada. O bloco descartado em si não é cobrado, enquanto a reconstrução do raciocínio pode gerar tokens adicionais de saída. Monitorar incompatibilidades de prefixo e testar as próprias cargas de trabalho do aplicativo é mais informativo do que supor que uma nova tentativa bem-sucedida não tem custo.
No uso da Anthropic, é uma campanha não autorizada para coletar saídas ou raciocínio protegido do Claude a fim de treinar outro modelo. A destilação em si é uma técnica padrão de aprendizado de máquina e pode ser legítima quando o desenvolvedor possui os direitos e a autorização necessários.
Não. A Anthropic relata uma redução estimada de 90–99% no raciocínio coletado em sua própria plataforma após implementar as proteções. Esse número não cobre todos os provedores, todos os ataques ou todos os métodos futuros de extração.
Não, desde que o aplicativo siga as regras documentadas para reproduzir o pensamento e preservar o prefixo da conversa. Os problemas surgem quando o contexto anterior muda enquanto o aplicativo continua enviando blocos de pensamento vinculados ao contexto original.
Somente quando as regras documentadas de compatibilidade de modelo permitem. Um modelo que não consegue ler um bloco é executado sem esse bloco; portanto, mudar para um modelo mais barato não preserva necessariamente o raciocínio do modelo anterior.
Sim. A Anthropic afirma que categorias selecionadas de salvaguarda voltaram a ser cobradas em 24 de setembro, mesmo quando a solicitação é bloqueada antes de o Claude responder. O relatório reconhece explicitamente que um falso positivo nessas categorias pode afetar um cliente legítimo.
Não. Esse foi o aumento reportado ao descartar o pensamento uma vez por sessão, no esforço máximo, em um teste específico de programação com múltiplos turnos. O efeito depende do esforço, do histórico da conversa, da tarefa e da frequência com que a integração descarta blocos.
As novas defesas da Anthropic combinam restrições ao raciocínio protegido, classificadores de extração e aplicação de regras contra abuso repetido. A empresa relata uma redução substancial no raciocínio coletado em sua própria plataforma, ao mesmo tempo que reconhece que os atacantes podem se adaptar.
Para desenvolvedores da API Claude, o trabalho imediato consiste em manter um histórico de conversa válido e entender os custos de solicitações bloqueadas ou de pensamento descartado. Os ganhos de segurança reportados são substanciais, mas integrações estáveis e testes específicos por carga de trabalho continuam sendo importantes.
Comece com uma frase e tenha um site completo em minutos.



