For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/claude-haiku-5-vs-gpt-6-luna-benchmarks-p-ec36c306.md.
A Anthropic lançou o **Claude Haiku 5.5**, e esta não é uma atualização rotineira de um modelo pequeno.

A Anthropic lançou o Claude Haiku 5.5, e esta não é uma atualização rotineira de um modelo pequeno.
O novo Haiku avança muito além do Haiku 4.5 em uso de computador, programação, trabalho profissional e tarefas de agentes que usam muitas ferramentas, ao mesmo tempo que reduz drasticamente o preço destacado da API.
Nas comparações de lançamento da própria Anthropic, o Haiku 5.5 também supera o GPT-6 Luna em vários resultados de benchmark, incluindo GDPval-AA v2.1, OSWorld 2.1, Terminal-Bench 4.0, FrontierCode 1.1 e Chartography.
Isso faz do Haiku 5.5 uma nova opção relevante para cargas de trabalho de alto volume, como:
Mas o lançamento também vem acompanhado de ressalvas importantes.
A precificação muda no limite de 100 mil tokens no prompt, o tokenizador usa mais tokens para o mesmo texto e a atualização de uma integração existente com o Haiku 4.5 exige várias mudanças na API.
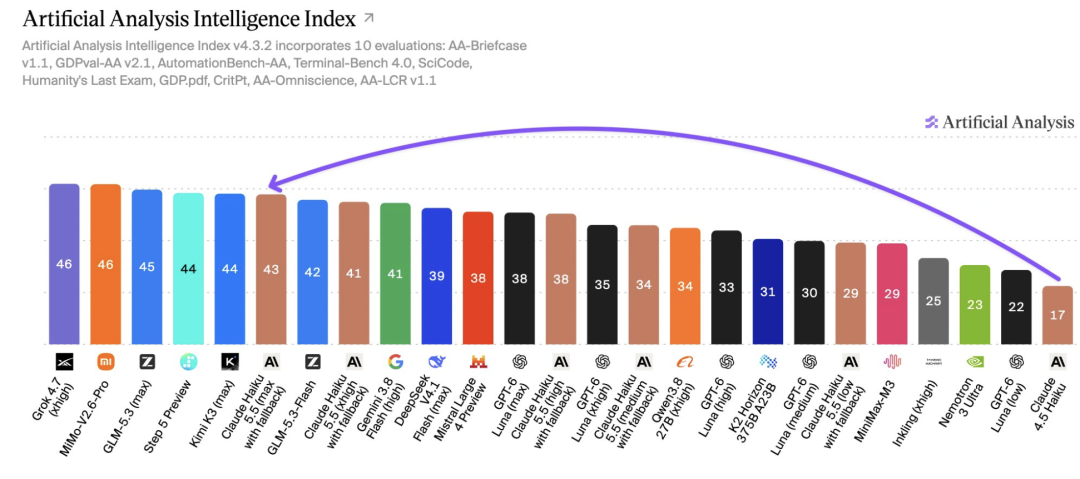
A Anthropic posiciona o Haiku 5.5 como seu modelo pequeno mais barato, rápido e capaz até o momento.
A tabela oficial de benchmarks deixa claro qual é o concorrente pretendido: o GPT-6 Luna aparece diretamente ao lado do Haiku 5.5.
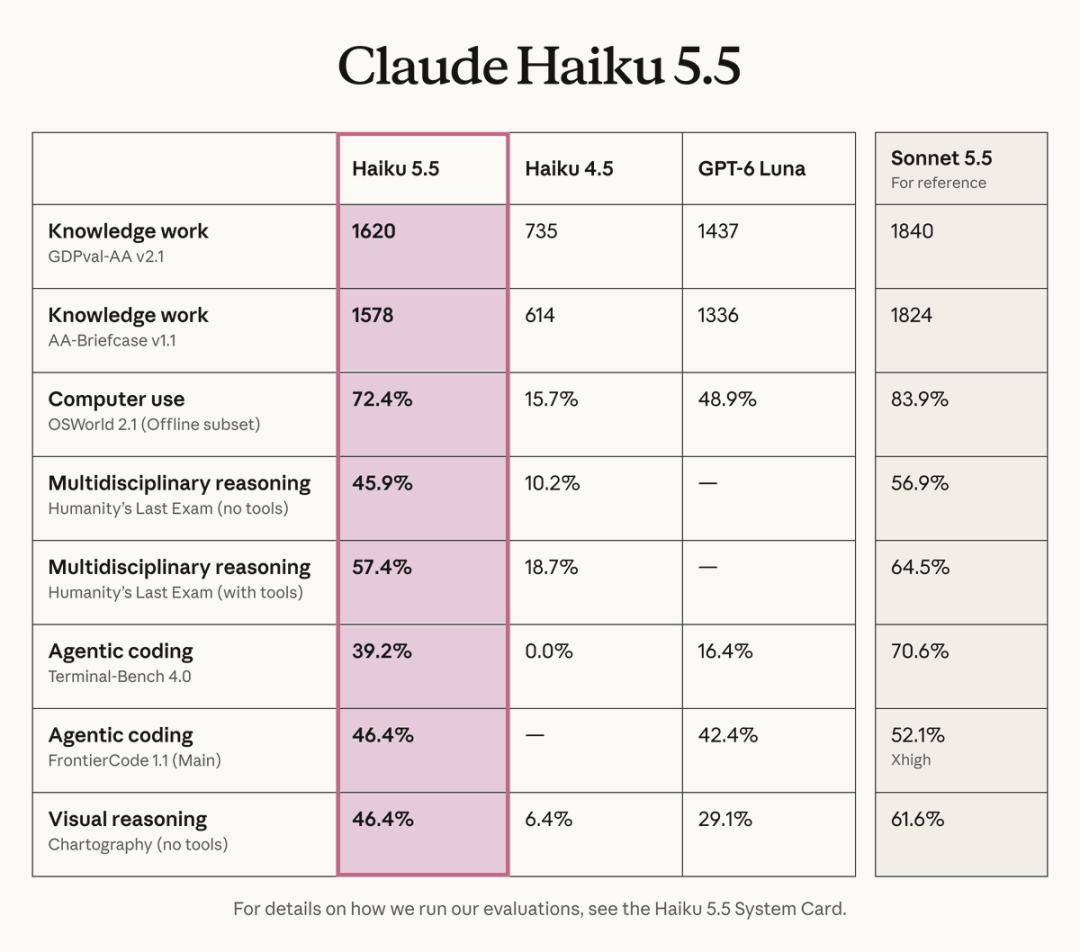
Os resultados do lançamento incluem:
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1, subconjunto offline | 72,4% | 15,7% | 48,9% | 83,9% |
| Humanity’s Last Exam, sem ferramentas | 45,9% | 10,2% | — | 56,9% |
| Humanity’s Last Exam, com ferramentas | 57,4% | 18,7% | — | 64,5% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 16,4% | 70,6% |
| FrontierCode 1.1 (Principal) | 46,4% | — | 42,4% | 52,1% |
| Chartography, sem ferramentas | 46,4% | 6,4% | 29,1% | 61,6% |
A conclusão não é que o Haiku 5.5 tenha substituído repentinamente todos os modelos maiores.
A questão é que a menor categoria do Claude se tornou muito mais capaz nos tipos de tarefa que antes exigiam um modelo maior.
Para prompts de até 100 mil tokens, a Anthropic cobra:
Entrada do Haiku 5.5:  US$ 0,10 / 1 milhão de tokens
Saída do Haiku 5.5:   US$ 0,50 / 1 milhão de tokens
Leitura de cache:      US$ 0,01 / 1 milhão de tokens
Gravação de cache:     US$ 0,125 / 1 milhão de tokens
A precificação padrão atual da OpenAI para o GPT-6 Luna é:
Entrada do GPT-6 Luna:          US$ 0,10 / 1 milhão de tokens
Entrada em cache do GPT-6 Luna: US$ 0,01 / 1 milhão de tokens
Gravação de cache do GPT-6 Luna: US$ 0,125 / 1 milhão de tokens
Saída do GPT-6 Luna:            US$ 0,50 / 1 milhão de tokens
Assim, para trabalhos padrão de API com contexto curto, os dois modelos ficam praticamente alinhados nas taxas principais por token.
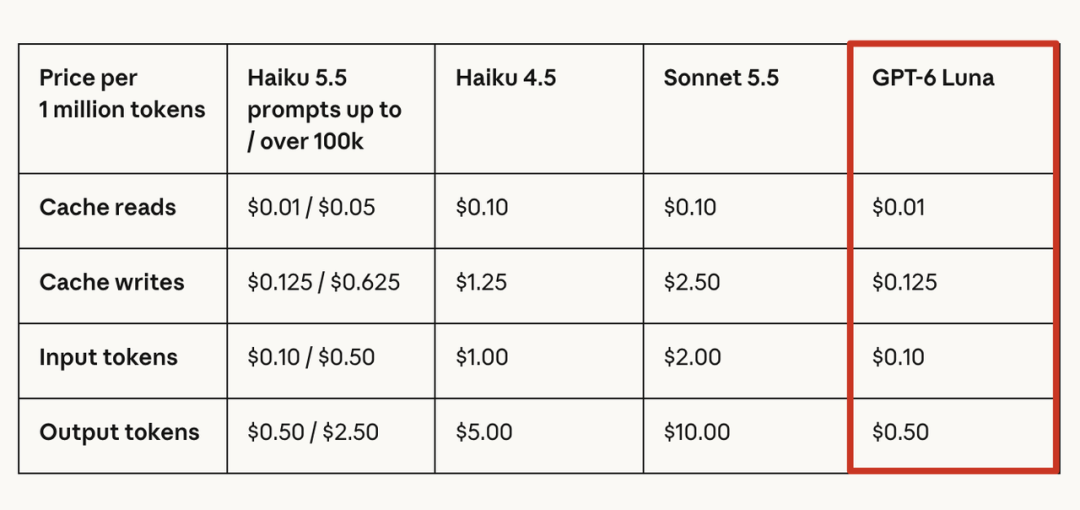
O Haiku 5.5 usa dois níveis de preço.
| Tipo de token | Prompt ≤100 mil | Prompt >100 mil |
|---|---|---|
| Leitura de cache | US$ 0,01/M | US$ 0,05/M |
| Gravação de cache | US$ 0,125/M | US$ 0,625/M |
| Entrada | US$ 0,10/M | US$ 0,50/M |
| Saída | US$ 0,50/M | US$ 2,50/M |
A Anthropic afirma que os prompts de até 100 mil tokens representavam cerca de 90% das solicitações do Haiku 4.5, razão pela qual o nível mais baixo cobre a maioria do tráfego esperado.
Para prompts acima de 100 mil tokens, o Haiku 5.5 ainda é mais barato que o Haiku 4.5, mas o desconto é menor.
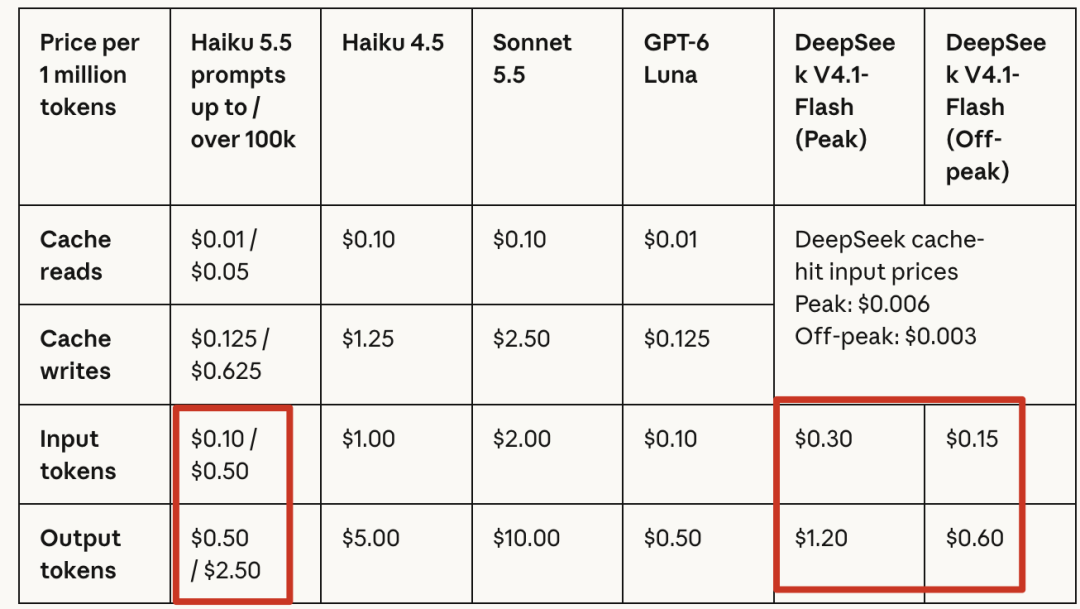
O artigo de origem compara o Haiku 5.5 com o DeepSeek-V4.1-Flash.
A precificação oficial do DeepSeek atualmente usa tarifas de pico e fora de pico.
Para entrada sem acerto de cache e saída:
| Modelo | Entrada / 1 milhão | Saída / 1 milhão |
|---|---|---|
| Haiku 5.5, prompt ≤100 mil | US$ 0,10 | US$ 0,50 |
| DeepSeek-V4.1-Flash, fora de pico | US$ 0,15 | US$ 0,60 |
| DeepSeek-V4.1-Flash, pico | US$ 0,30 | US$ 1,20 |
O DeepSeek continua mais barato na entrada com acerto de cache, especialmente fora do horário de pico, portanto o custo total ainda depende da estrutura da carga de trabalho.
A geração anterior do Haiku não era competitiva em tarefas exigentes de uso de computador.
O Haiku 5.5 muda isso de forma significativa.
O resultado do subconjunto offline do OSWorld 2.1 divulgado pela Anthropic sobe de 15,7% no Haiku 4.5 para 72,4% no Haiku 5.5 com esforço máximo.
O artigo de origem também realizou um teste prático: pediu ao Haiku 5.5 para adicionar dados de preços do GPT-6 e do DeepSeek à tabela da página de lançamento do Haiku.
Em vez de editar manualmente elementos HTML individuais pela interface, o modelo abriu o console do navegador e inseriu as alterações por meio de um script.
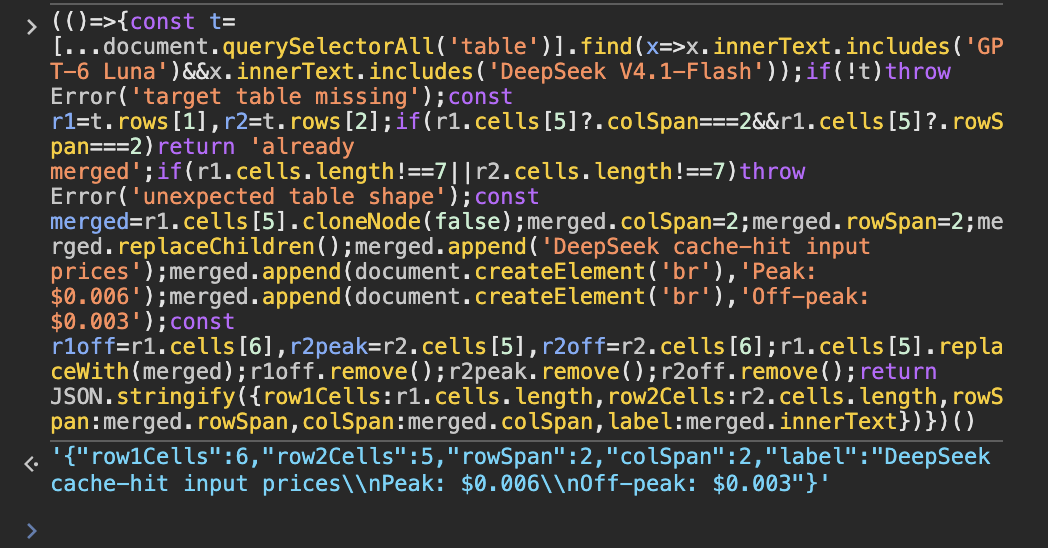
Esse comportamento é útil porque agentes de uso de computador nem sempre precisam imitar literalmente os movimentos do mouse humano.
Se o ambiente do navegador oferecer um caminho de execução mais direto, usar um script pode ser mais rápido e confiável do que clicar em cada célula.
O Haiku 5.5 é o primeiro modelo da categoria Haiku com controle de esforço ajustável.
O modelo oferece um espectro que vai de um comportamento mais barato e rápido a um raciocínio mais caro e deliberado.
O gráfico de lançamento da Anthropic mostra uma curva clara de precisão versus custo no OSWorld.
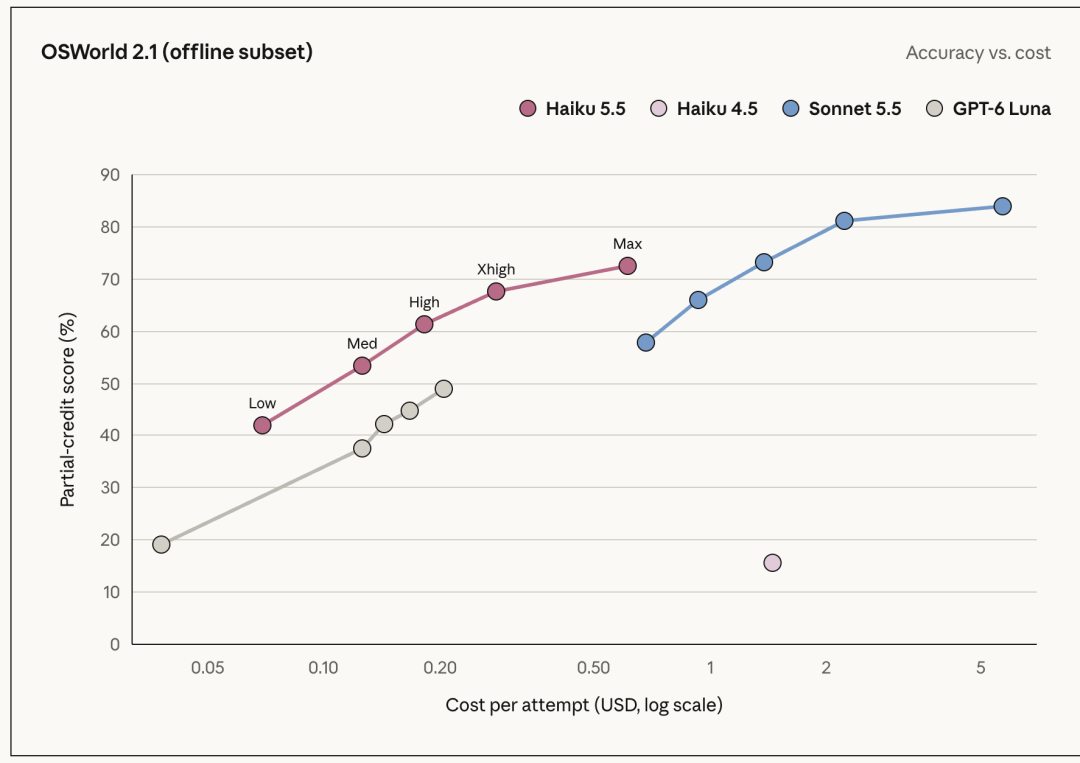
O artigo de origem destaca dois pontos dessa curva:
O custo exato de uma tarefa em produção varia conforme o tamanho do prompt, o tamanho da saída, o uso de cache e o uso de ferramentas, mas o padrão geral é importante.
Agora é possível ajustar o Haiku conforme o trabalho, em vez de tratar modelo pequeno como um único nível fixo de capacidade.
O GDPval-AA v2.1 mede trabalho profissional do mundo real em 44 ocupações.
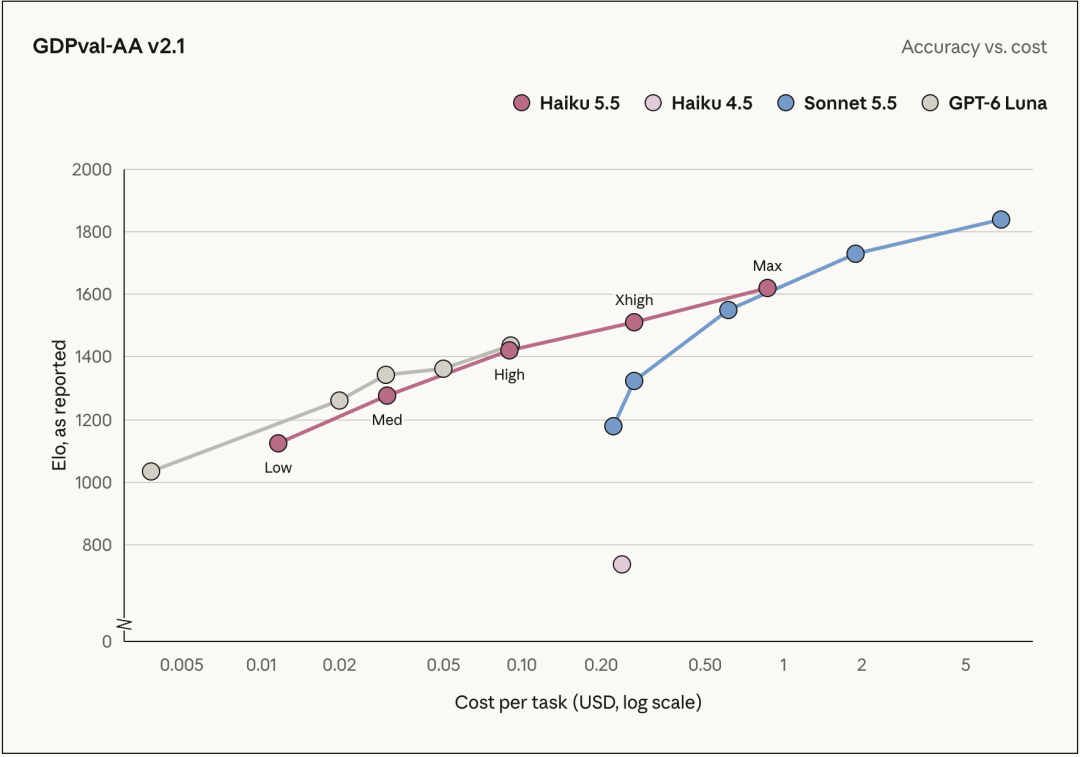
Com esforço máximo, a Anthropic informa um Elo de 1620 para o Haiku 5.5, em comparação com 735 para o Haiku 4.5.
Mais uma vez, o Sonnet 5.5 continua mais forte, mas a distância entre pequeno e útil para uso profissional diminuiu drasticamente.
O Haiku 5.5 introduz um tokenizador mais recente, compartilhado com gerações mais novas do Claude.
Isso é importante porque o mesmo texto não produz a mesma quantidade de tokens que produzia no Haiku 4.5.
O guia de migração da Anthropic afirma que o mesmo texto de entrada produz aproximadamente 30% mais tokens no Haiku 5.5 do que no Haiku 4.5, embora o aumento exato dependa do conteúdo.
O impacto pode ser maior ou menor conforme a carga de trabalho, e vale especialmente a pena medir novamente código, tabelas e textos em idiomas diferentes do inglês.
Isso significa que a comparação a seguir é simples demais:
Preço antigo de entrada: US$ 1,00
Novo preço de entrada: US$ 0,10
Portanto, toda tarefa é exatamente 90% mais barata
O cálculo mais adequado é:
custo real da tarefa
= nova quantidade de tokens
× novo preço por token
+ custo de cache
+ custo de saída
+ custo de ferramentas
A própria Anthropic afirma que, depois de considerar as mudanças no tokenizador, o Haiku 5.5 custa em média cerca de 75% menos que o Haiku 4.5, e não uma redução uniforme de 90% para todas as tarefas.
A Artificial Analysis também mostra por que a eficiência em tokens importa ao comparar modelos econômicos.
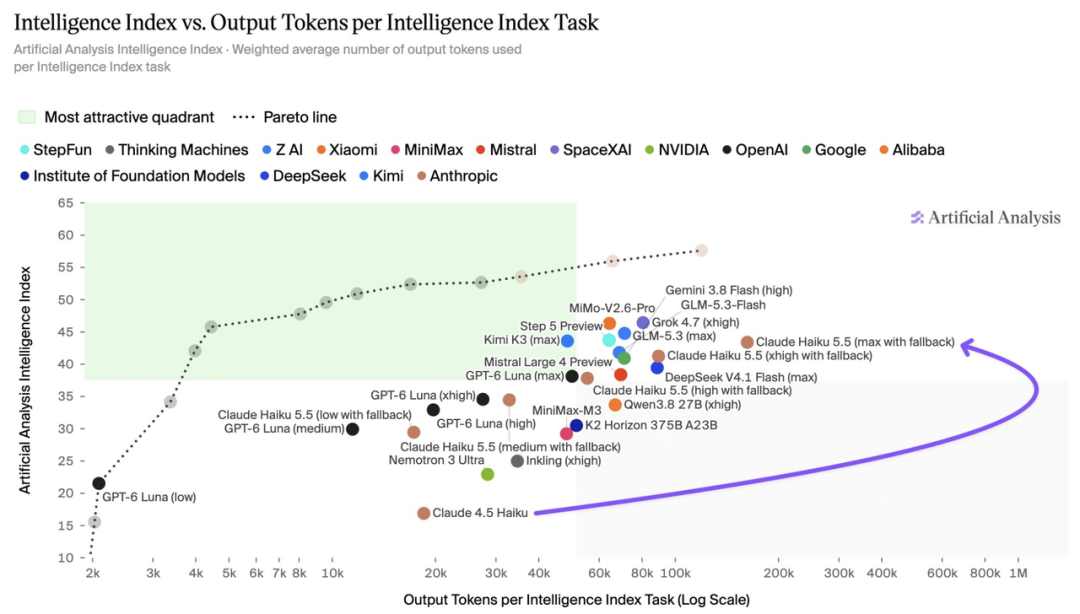
Um modelo pode ter um preço baixo por token e ainda assim usar muitos mais tokens de saída para concluir uma tarefa.
Para sistemas em produção, o custo por tarefa concluída é mais útil do que o preço por milhão de tokens isoladamente.
O artigo de origem deixa esse ponto claro: o modelo pequeno continua sendo um modelo pequeno.
O Haiku 5.5 é muito mais forte que o Haiku 4.5, mas programação autônoma complexa continua sendo uma tarefa para modelos maiores.
O Terminal-Bench 4.0 mostra a diferença:
Haiku 5.5:  39,2%
Sonnet 5.5: 70,6%
A Anthropic recomenda explicitamente o Sonnet 5.5 ou o Opus 5.5 para programação agentiva complexa.
O Haiku 5.5 é mais adequado para tarefas que já têm escopo bem definido:
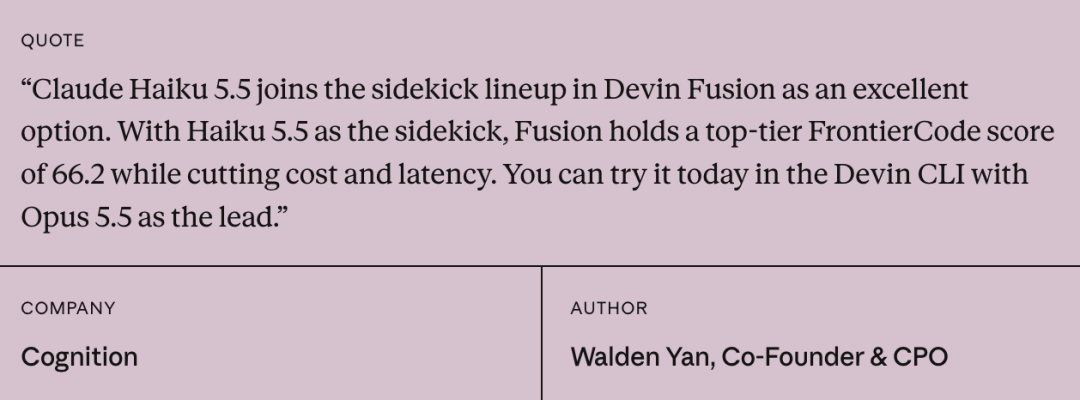
A Cognition já usa essa estrutura no Devin Fusion.
A página de lançamento afirma que o Opus 5.5 pode atuar como líder enquanto o Haiku 5.5 trabalha como apoio.
Essa combinação alcançou uma pontuação de 66,2 no FrontierCode na configuração divulgada pela Cognition, ao mesmo tempo que reduziu custo e latência.
O padrão é direto:
Opus / Sonnet
→ planejamento, decomposição e decisões difíceis

Haiku 5.5
→ subtarefas restritas, execução paralela, consultas rápidas e resumos
Essa provavelmente é uma forma mais realista de usar o Haiku 5.5 do que tentar substituir um modelo maior em todos os cenários.
Se uma aplicação já usa o Haiku 4.5, a Anthropic alerta que várias mudanças podem interromper solicitações existentes.
O ID oficial do modelo agora é:
claude-haiku-5-5
Mas a migração tem vários requisitos adicionais.
Uma solicitação do Haiku 4.5 como esta não é mais válida:
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
{
  "thinking": {
    "type": "enabled",
    "budget_tokens": 8000
  }
}
O Haiku 5.5 usa raciocínio adaptativo e controles de esforço:
{
  "thinking": {
    "type": "adaptive"
  },
  "output_config": {
    "effort": "medium"
  }
}
Uma solicitação que envia o formato antigo de budget_tokens retorna um erro 400.
O raciocínio adaptativo também é ativado por padrão, portanto as aplicações não devem presumir que o primeiro bloco de conteúdo da resposta seja sempre o texto normal da resposta.
Analise os blocos por type.
max_tokensComo o novo tokenizador contabiliza o mesmo texto como uma quantidade maior de tokens, os valores antigos de max_tokens podem não deixar espaço suficiente para uma saída equivalente.
Conte novamente os prompts usando claude-haiku-5-5, em vez de reutilizar as estimativas de tokens do Haiku 4.5.
O Haiku 5.5 não aceita configurações arbitrárias de amostragem da mesma forma que o Haiku 4.5.
A Anthropic recomenda omitir:
temperature
top_p
top_k
Valores diferentes do padrão podem gerar erros 400, e top_k não é aceito.
As aplicações que usavam parâmetros de amostragem para obter variação criativa devem transferir esse controle para os prompts ou para outra estratégia no nível da aplicação.
O Haiku 4.5 podia continuar a partir de uma mensagem final do assistente em algumas configurações.
O Haiku 5.5 rejeita o preenchimento do assistente.
Se você usava anteriormente um prefixo como:
{"result":
para forçar a saída em JSON, migre para saídas estruturadas ou para um esquema de ferramenta.
Para integrações com a Claude API e o Google Cloud, a antiga declaração de uso de computador:
computer_20250124
deve ser alterada para:
computer_toolset_20260801
O novo conjunto de ferramentas tem uma estrutura de eventos diferente, portanto o ciclo do agente deve despachar corretamente os blocos de uso de ferramentas retornados e preservar toolset_name nos resultados.
O Haiku 5.5 também é compatível com o conjunto de ferramentas de uso de navegador da Anthropic para tarefas em páginas da web nas plataformas compatíveis.
Antes de colocar o Haiku 5.5 em produção, verifique pelo menos estes itens:
claude-haiku-5-5.budget_tokens por raciocínio adaptativo e esforço.type, em vez de presumir que o bloco zero contém o texto da resposta.computer_toolset_20260801 quando necessário.refusal.A Anthropic também oferece um comando automatizado de migração no Claude Code:
/claude-api migrate this project to claude-haiku-5-5
A ferramenta pode aplicar alterações no ID do modelo e detectar vários padrões incompatíveis de solicitação, mas ainda é recomendável fazer uma verificação manual.
O Haiku 5.5 não foi a única mudança de preço anunciada pela Anthropic.
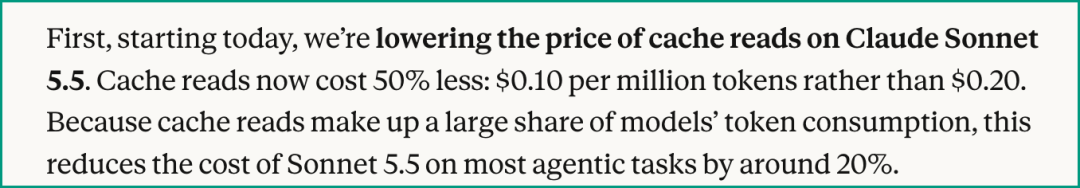
O preço de leitura de cache do Sonnet 5.5 caiu de:
US$ 0,20 / 1 milhão de tokens
para:
US$ 0,10 / 1 milhão de tokens
A Anthropic afirma que as leituras de cache representam uma parcela significativa do consumo de tokens em muitos fluxos de trabalho com agentes, portanto essa mudança reduz o custo da maioria das tarefas agentivas do Sonnet 5.5 em aproximadamente 20%.
Isso torna uma arquitetura com vários modelos mais atraente:
Sonnet 5.5
→ planejamento e execução mais complexa

Haiku 5.5
→ subtarefas de alto volume e baixo custo
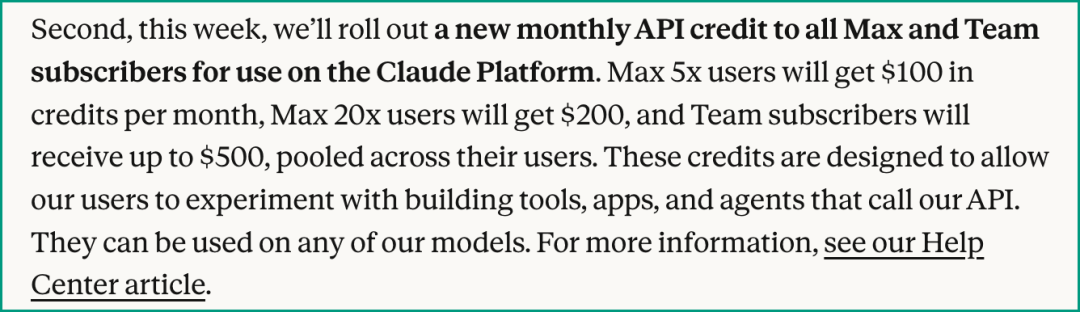
A Anthropic também introduziu créditos mensais da Claude Platform para assinantes Max e Team elegíveis.
Os valores oficiais atuais dos créditos são:
| Plano | Crédito mensal de API |
|---|---|
| Max 5x | US$ 100 |
| Max 20x | US$ 200 |
| Assento Team Standard | US$ 20 por assento |
| Assento Team Premium | US$ 100 por assento |
| Máximo compartilhado do Team | US$ 500 |
Os créditos podem ser usados em cargas de trabalho da Claude Platform, como:
Eles não aumentam os limites de uso da assinatura Claude ou Claude Code do usuário e não cobrem sessões interativas normais do Claude Code quando essas sessões são cobradas pelo plano de assinatura.
Os créditos estão vinculados a uma única organização do Claude Console e não são acumulados indefinidamente.
O artigo de origem termina com uma comparação mais descontraída.
Enquanto a Anthropic anunciava modelos mais baratos, leituras de cache do Sonnet mais baratas e créditos mensais para a API, Thibault Sottiaux, responsável pelo Codex e pelo ChatGPT Work na OpenAI, anunciou outra redefinição acumulável para contas pagas, ao mesmo tempo que celebrava 40 milhões de usuários ativos no Codex e no ChatGPT Work.
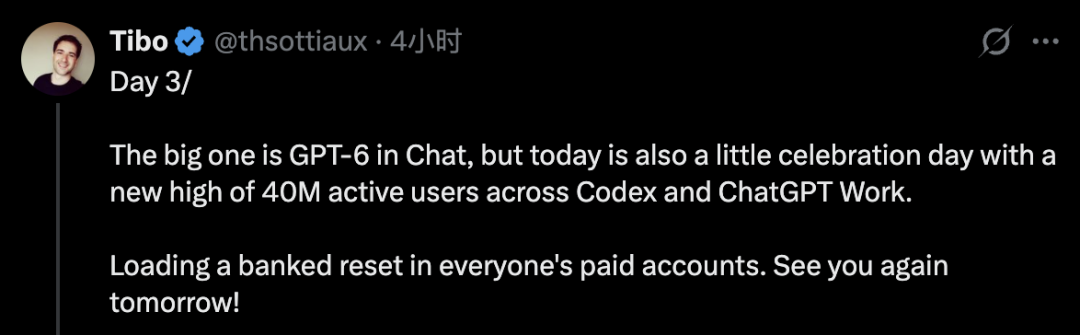
Uma redefinição acumulável é diferente de uma redução permanente de preço.
Trata-se de uma redefinição adicional de uso que usuários elegíveis podem guardar e resgatar, e não de uma mudança no preço contínuo por token do modelo.
A comparação, portanto, é mais retórica que técnica:
Lançamento da Anthropic:
novo modelo pequeno + menor preço de cache + créditos mensais para a API

Atualização da OpenAI:
redefinição adicional de uso acumulável para contas pagas do Codex / Work
Ambas são tentativas de dar aos usuários intensivos mais espaço para experimentar, mas funcionam por mecanismos diferentes.
O lançamento torna o Haiku muito mais útil, mas seu papel ideal continua relativamente claro.
Use o Haiku 5.5 para:
Prefira um modelo Claude maior para:
O modelo mais barato nem sempre é a forma mais barata de concluir um trabalho.
Para sistemas em produção, meça:
custo por tarefa bem-sucedida
=
entrada + cache + saída + uso de ferramentas + novas tentativas + falhas
Essa métrica dirá mais do que o preço destacado de entrada de um modelo.
O Claude Haiku 5.5 é o mais recente modelo pequeno da Anthropic, lançado para cargas de trabalho de alto volume, sensíveis a custo e sensíveis à latência. Ele também é o primeiro modelo Haiku com esforço ajustável e é significativamente mais forte que o Haiku 4.5 em avaliações de programação, uso de computador e trabalho profissional.
Para prompts de até 100 mil tokens, ele custa US$ 0,10 por milhão de tokens de entrada e US$ 0,50 por milhão de tokens de saída. Para prompts acima de 100 mil, as tarifas sobem para US$ 0,50 na entrada e US$ 2,50 na saída por milhão de tokens, com preços separados para leitura e gravação de cache.
Para a precificação padrão por token em contextos curtos, as taxas destacadas de entrada, entrada em cache, gravação de cache e saída são praticamente equivalentes. O preço do Haiku 5.5 aumenta acima do limite de 100 mil tokens no prompt, portanto as cargas de trabalho com contexto longo devem ser comparadas separadamente.
Não. Os próprios resultados da Anthropic no Terminal-Bench 4.0 mostram 70,6% para o Sonnet 5.5 contra 39,2% para o Haiku 5.5. O Haiku é mais indicado para tarefas restritas, repetíveis e de alto volume, além de trabalhos de subagentes, enquanto o Sonnet e o Opus continuam mais adequados para programação autônoma complexa.
O Haiku 5.5 usa um tokenizador mais recente. O guia de migração da Anthropic afirma que o mesmo texto produz, em média, cerca de 30% mais tokens no Haiku 5.5 que no Haiku 4.5, embora o aumento exato dependa do conteúdo.
Sim. As mudanças importantes incluem raciocínio adaptativo em vez de budget_tokens manual, comportamento revisado dos parâmetros de amostragem, remoção do preenchimento do assistente, um novo conjunto de ferramentas de uso de computador e a necessidade de analisar os blocos de resposta por type. A Anthropic oferece um guia oficial de migração e um comando de migração no Claude Code.
Na Claude API, o ID do modelo é claude-haiku-5-5. A Anthropic documenta IDs correspondentes para Amazon Bedrock, Google Cloud, Microsoft Foundry e Claude Platform na AWS.
Assinantes Max e Team elegíveis podem obter créditos mensais da Claude Platform. O Max 5x recebe US$ 100, o Max 20x recebe US$ 200, e os créditos Team são calculados conforme o tipo de assento, com limite compartilhado de US$ 500 por mês.
O Claude Haiku 5.5 é uma grande atualização da categoria de modelos pequenos da Anthropic. Ele supera o Haiku 4.5 por uma ampla margem em uso de computador, trabalho profissional, programação e raciocínio, ao mesmo tempo que iguala os preços destacados da API do GPT-6 Luna em contextos curtos e supera o Luna em várias comparações de benchmark publicadas pela Anthropic.
O preço mais baixo é real, mas as equipes de produção não devem ignorar o novo tokenizador nem o limite de preço para prompts de 100 mil tokens. O mesmo texto pode consumir cerca de 30% mais tokens que no Haiku 4.5, e prompts longos usam o nível de preço mais alto.
A migração também inclui mudanças realmente incompatíveis: o raciocínio adaptativo substitui os orçamentos manuais de raciocínio, os controles personalizados de amostragem são limitados, o preenchimento do assistente foi removido e as integrações de uso de computador precisam do conjunto de ferramentas mais recente. As aplicações existentes com Haiku 4.5 devem seguir o guia de migração, em vez de alterar apenas o nome do modelo.
O Haiku 5.5 deve ser entendido como um modelo de execução rápido e econômico para escala e subagentes — não como um substituto universal do Sonnet ou do Opus em trabalhos complexos e de longo horizonte.
Comece com uma frase e tenha um site completo em minutos.



