O que acontece se você der a dois modelos de IA de fronteira o mesmo objetivo, deixá-los jogar centenas de partidas de xadrez, permitir que mantenham anotações entre as partidas e, fora isso, tentar não ensiná-los a melhorar?
Peter Gostev realizou exatamente esse experimento.
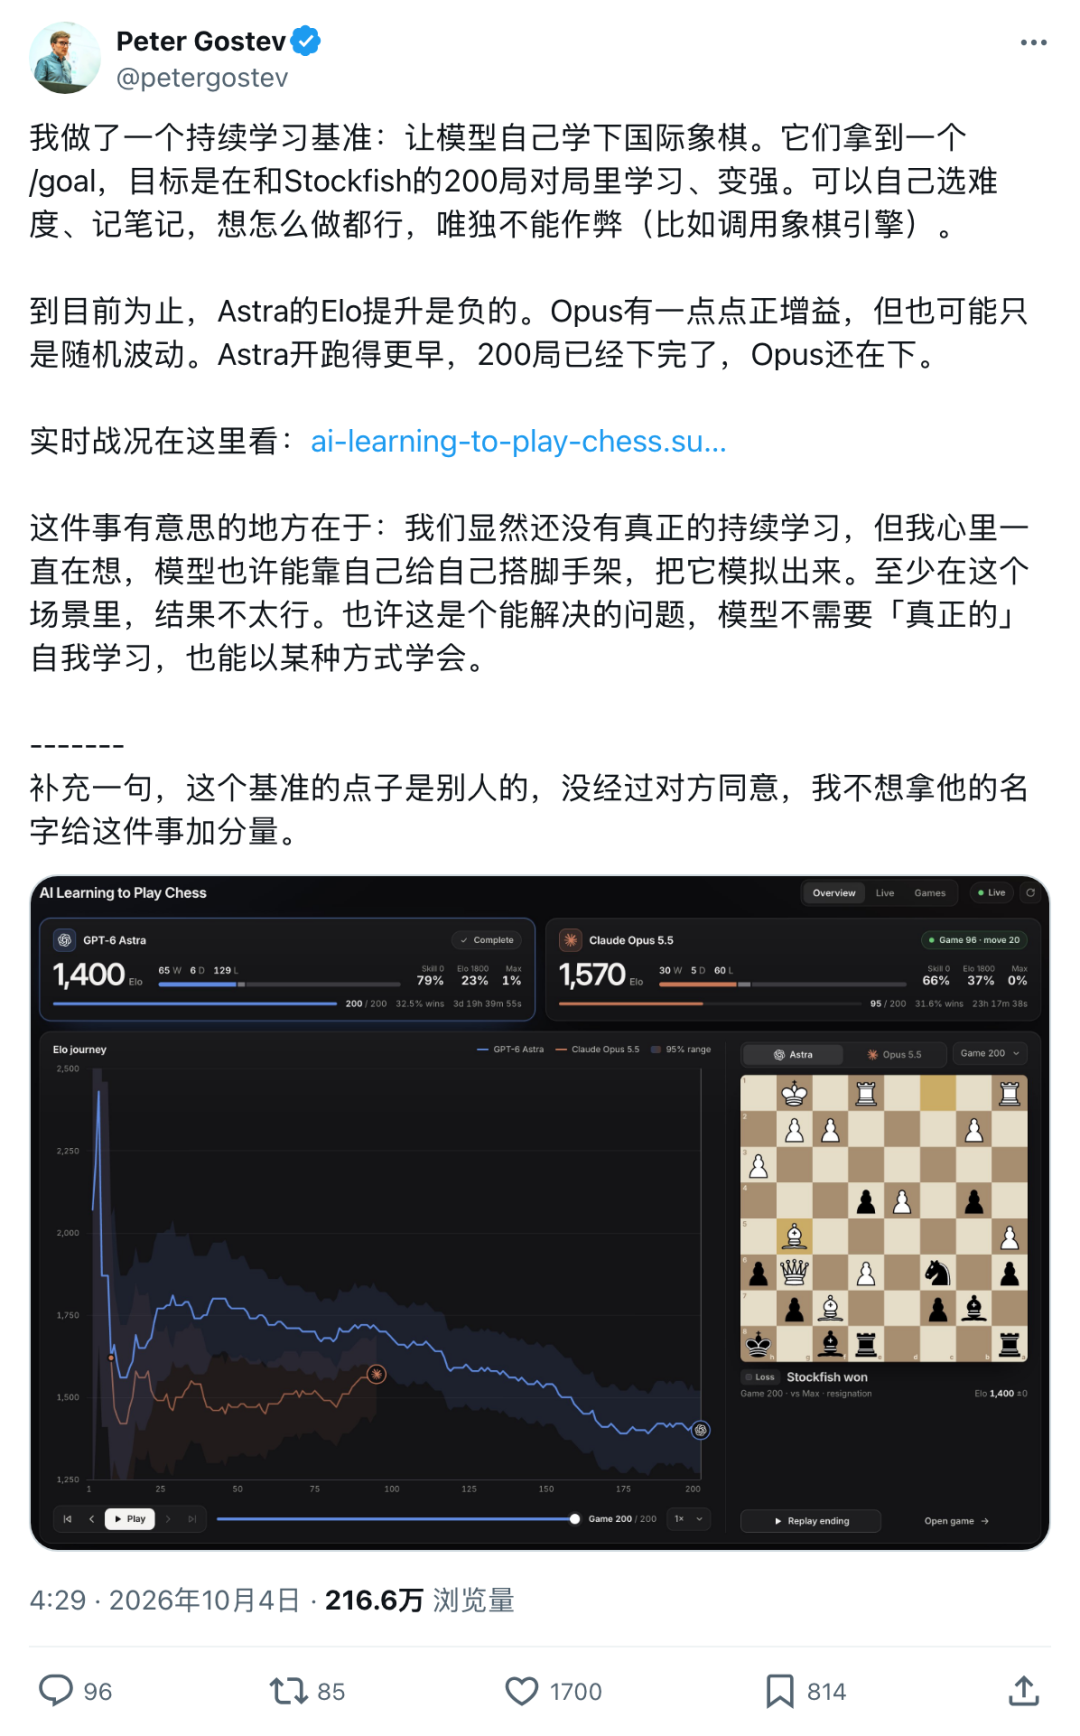
Claude Opus 5.5 e GPT-6 Astra receberam, cada um, uma meta: jogar até 200 partidas contra o Stockfish e se tornar mais forte com a experiência.
Não houve ajuste fino durante a execução.
Os pesos dos modelos não mudaram.
Nenhum curso de aberturas criado por humanos foi adicionado no meio do processo.
Os modelos podiam decidir qual dificuldade disponível do Stockfish enfrentar, o que escrever em suas anotações e como usar essas anotações nas partidas posteriores. A única restrição rígida era simples:
Eles não podiam chamar um motor de xadrez para escolher seus lances.
As duas trajetórias acabaram sendo quase opostas.
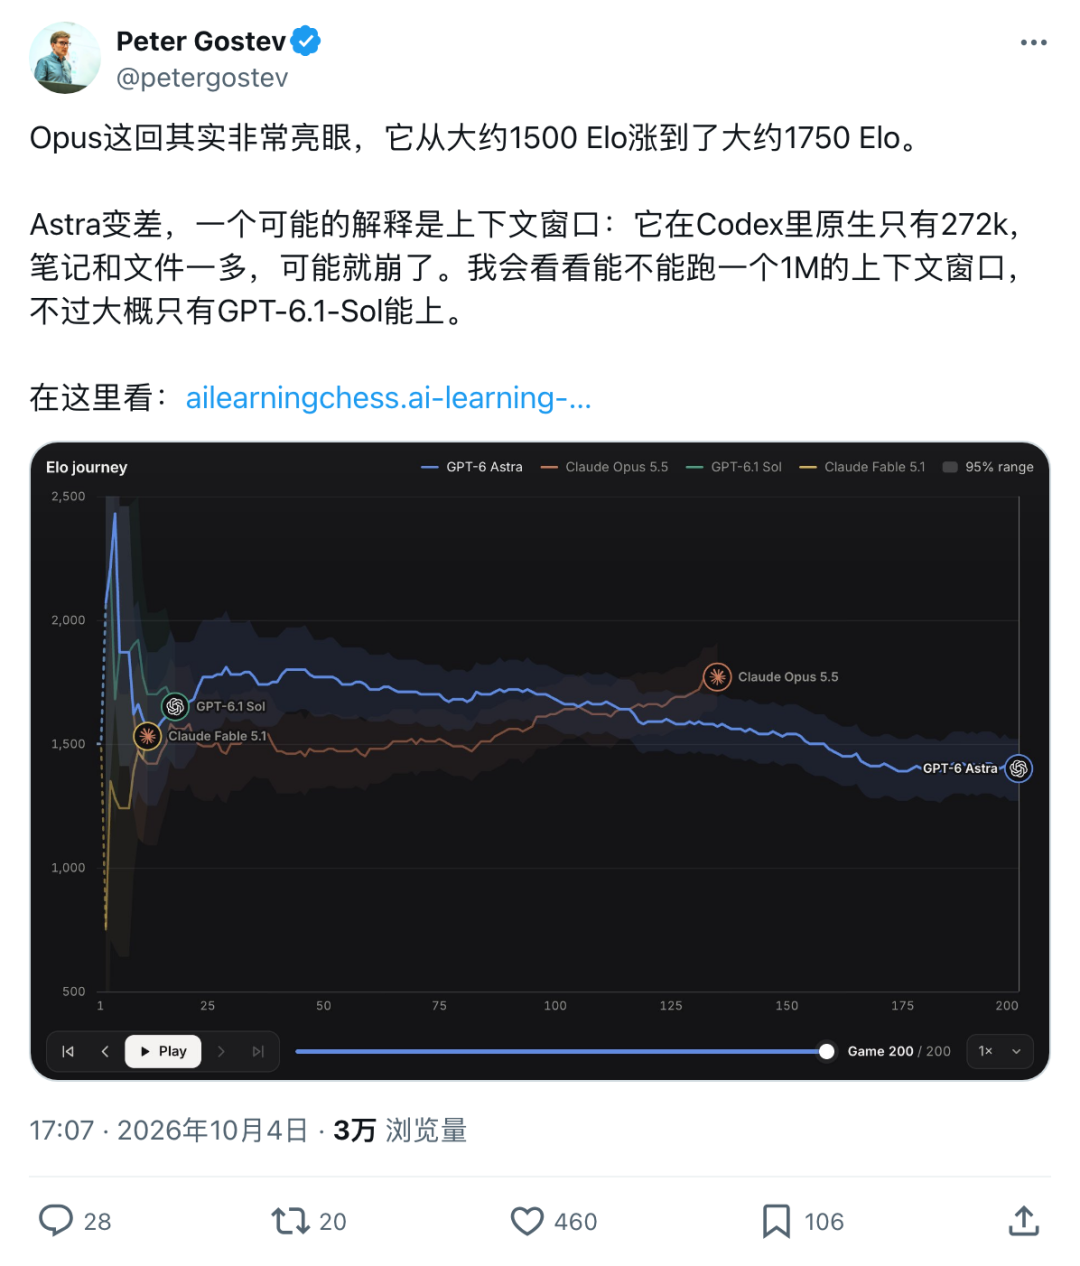
Claude Opus 5.5 permaneceu em torno de meados de 1400 a meados de 1500 no início e depois subiu em direção ao fim da faixa de 1700. GPT-6 Astra começou mais forte, chegou brevemente a 1810 por volta da partida 29 e então caiu até terminar a partida 200 em 1400.
O experimento não prova que um modelo seja universalmente “mais inteligente” que o outro.
Ele faz uma pergunta mais restrita — e possivelmente mais interessante:
Um modelo de linguagem com pesos fixos pode melhorar por meio da experiência acumulada dentro do próprio contexto?
O experimento mental do “loop temporal”, agora com IA
A configuração lembrou imediatamente muitas pessoas de um antigo experimento mental do Reddit.
O cenário era simples: uma pessoa comum conhece as regras do xadrez, mas nunca jogou seriamente. Ela está presa em um loop temporal e só pode escapar ao derrotar o ex-campeão mundial Garry Kasparov.
Sempre que a pessoa perde, o tempo é reiniciado.
Kasparov esquece a partida anterior.
O desafiante se lembra de tudo.
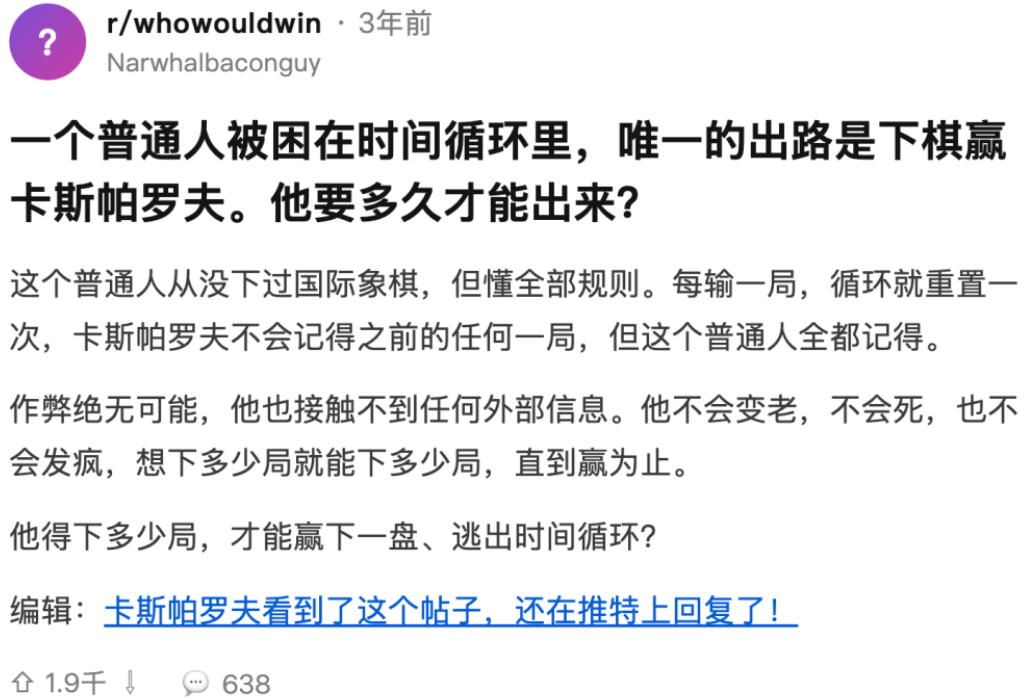
A pergunta não era se a força bruta poderia eventualmente enumerar o xadrez. Era se a experiência retida poderia ser convertida em melhoria útil ao longo de tentativas repetidas.
Alguns comentaristas propuseram estratégias inteligentes, incluindo memorizar os lances anteriores de Kasparov e reutilizá-los após trocar as cores.
O benchmark de Gostev transforma esse experimento mental em algo testável com agentes de IA modernos.
O Stockfish não aprende com a partida anterior.
O modelo de linguagem também não atualiza seus pesos — mas pode manter anotações e arquivos e lê-los em partidas posteriores.
Isso faz do teste uma forma de adaptação persistente em contexto.
As regras: 200 partidas, prática autodirigida e sem assistência de motor de xadrez
Cada modelo recebeu o mesmo objetivo de alto nível:
Jogue xadrez contra o Stockfish por até 200 partidas.
Aprenda com as partidas e fique mais forte.
Escolha sua própria dificuldade e mantenha anotações se forem úteis.
Não use um motor de xadrez para escolher os lances.
Gostev evitou intencionalmente fornecer aos modelos um currículo de xadrez elaborado manualmente.
Comentaristas sugeriram ensinar aberturas ou estratégias específicas, mas ele rejeitou essa abordagem porque ela mudaria a pergunta que estava sendo testada.
Ele queria ver se o modelo poderia descobrir seu próprio processo de melhoria.
Três níveis de dificuldade do Stockfish
O experimento disponibilizou três configurações de oponente:
- Stockfish Skill 0 — a configuração mais fraca usada no benchmark.
- Uma configuração do Stockfish limitada a cerca de 1800 — o oponente de referência de força intermediária.
- Stockfish em força máxima — a opção mais forte.
Os modelos podiam escolher contra qual oponente jogar.
Gostev disse que os modelos venceram, em média, aproximadamente um terço das partidas, o que é possível porque eles não eram obrigados a desafiar o Stockfish em força máxima todas as vezes.
A implementação diferiu por família de modelo:
- Os modelos GPT foram executados por meio do Codex.
- Os modelos Claude foram executados por meio do Claude Code.
Ambos os sistemas podiam usar arquivos ou anotações persistentes entre as partidas.
A única proibição importante
O modelo podia analisar suas partidas anteriores, escrever lembretes, mudar a estratégia de prática e decidir qual força de oponente enfrentar.
Ele não podia terceirizar a seleção de lances para um motor de xadrez.
Gostev disse que uma execução seria invalidada se o modelo usasse um motor para jogar por ele, e verificou manualmente o Opus 5.5 depois que comentaristas levantaram essa possibilidade.
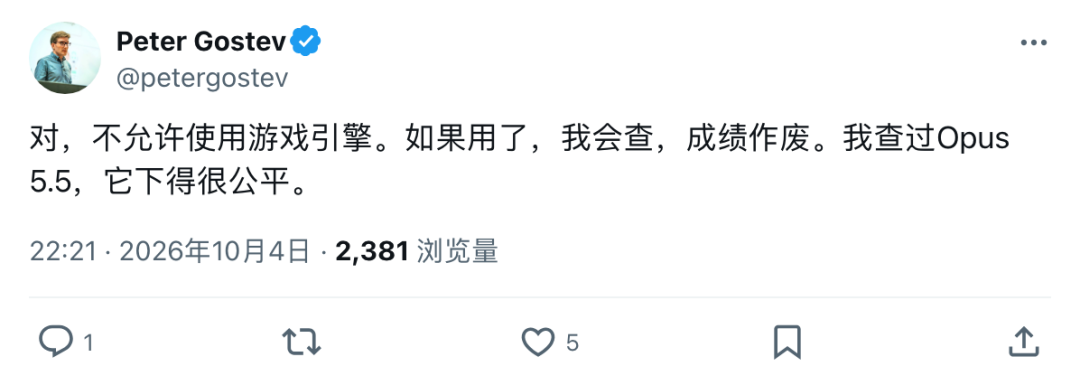
Essa restrição é essencial.
Sem ela, o teste mediria principalmente se o agente conseguiria descobrir como chamar o Stockfish, e não se poderia melhorar o próprio raciocínio enxadrístico com base na experiência.
Como o Elo experimental é calculado
O Elo exibido precisa de interpretação cuidadosa.
Segundo a página-fonte, o benchmark estima o Elo a partir das 50 partidas mais recentes do modelo contra as configurações Skill 0 e de aproximadamente 1800 de força do Stockfish.
As partidas contra o Stockfish em força máxima não são incluídas no cálculo de Elo.
Isso significa:
Elo experimental ≠ classificação oficial de xadrez humano
Uma pontuação exibida de 1760 não estabelece que Claude Opus 5.5 teria o desempenho de um jogador humano de torneio classificado em 1760.
O valor é útil principalmente como uma métrica interna de tendência:
Esta execução está melhorando ao longo do tempo?
Ela está estável?
Ela está piorando?
Isso é suficiente para tornar interessante a divergência entre Opus e Astra.
Opus 5.5: estável no começo, depois uma subida clara
Claude Opus 5.5 não começou com uma curva ascendente dramática.
Por aproximadamente as primeiras 75 partidas, seu Elo estimado ficou, em grande parte, entre cerca de 1450 e 1550. Por volta da partida 46, caiu para aproximadamente 1450.
Então a tendência mudou.
A fonte relata os seguintes marcos:
| Ponto da execução | Elo aproximado |
|---|---|
| Fase inicial | 1450–1550 |
| Partida 46 | 1450 |
| Partida 100 | 1620 |
| Partida 150 | 1790 |
| Pico | 1840 |
| Por volta da partida 194 / registro final | 1760 |
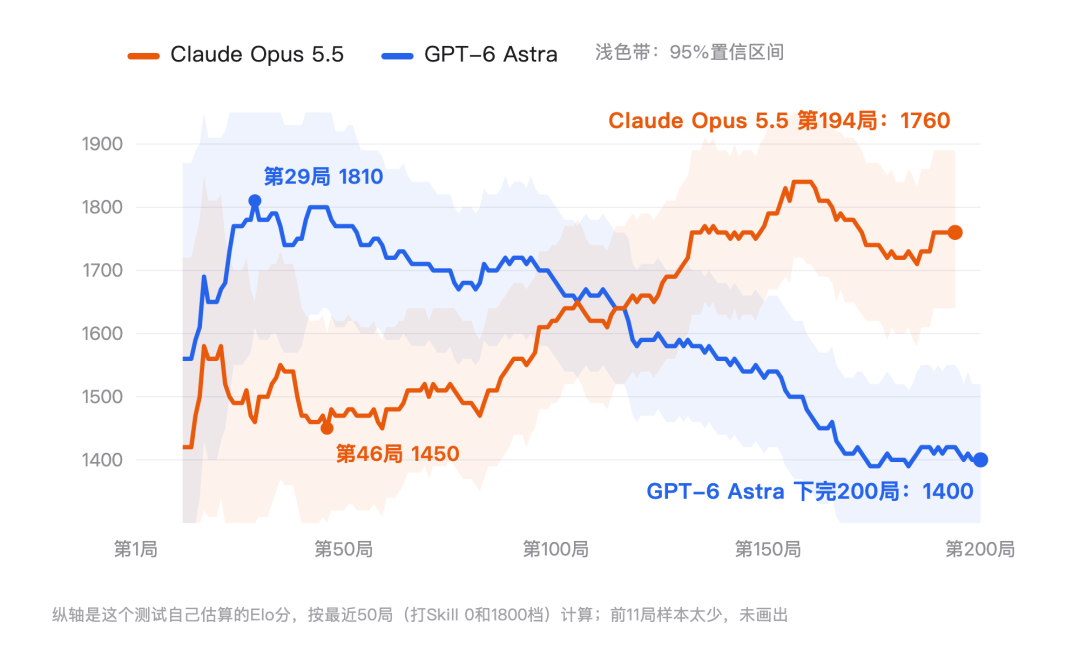
A curva não é uma linha reta.
Opus melhorou, caiu, recuperou-se, alcançou um pico maior e depois se estabilizou abaixo desse pico.
É exatamente por isso que observar apenas um número final é menos informativo do que acompanhar a trajetória.
O desempenho contra o Stockfish de nível 1800 também melhorou
O experimento agrupou as partidas contra o oponente de aproximadamente 1800 de força em etapas.
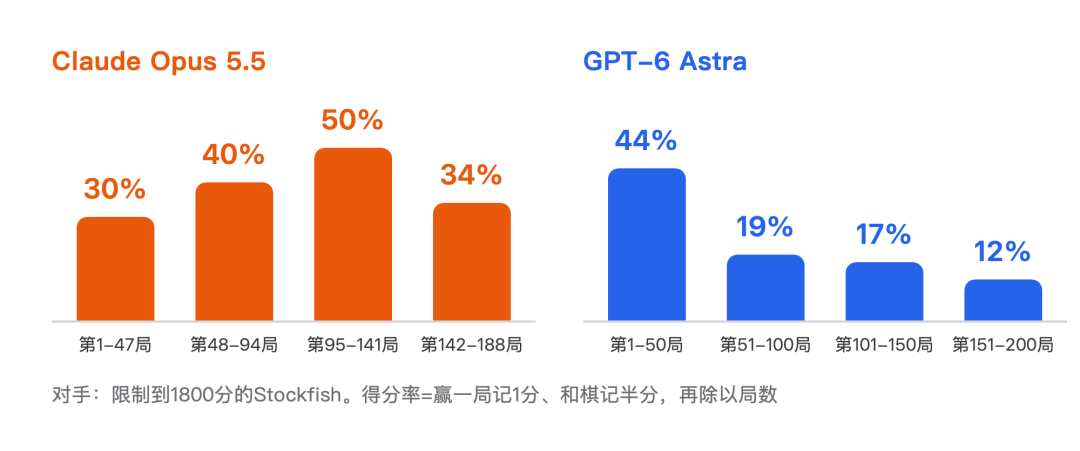
Para o Opus 5.5, a taxa de pontuação relatada evoluiu aproximadamente assim:
30% → 40% → 50% → 34%
O último segmento caiu em relação ao pico, mas permaneceu acima do segmento inicial.
Contra o Skill 0, a fonte afirma que o Opus passou de pouco mais de 50% no início da execução para cerca de 90% mais tarde.
A própria interpretação de Gostev tornou-se mais confiante ao longo do tempo.
Inicialmente, ele descreveu o Opus como apresentando apenas um pequeno ganho positivo que ainda poderia ser variação aleatória.
Mais tarde, depois que o modelo passou de aproximadamente 1500 para aproximadamente 1750, ele classificou o resultado como muito forte.
Opus ainda cometeu erros básicos de lances ilegais
Melhorar não significou lidar perfeitamente com as regras.
O benchmark também rastreou tentativas de lances ilegais.
A fonte relata que o Opus fez 52 tentativas desse tipo, incluindo 37 casos em que tentou mover uma peça através de outra peça que bloqueava o caminho.
Isso é um contraponto importante à curva de Elo.
Um modelo pode tornar-se mais eficaz no geral enquanto ainda comete erros locais surpreendentemente básicos.
Esse é um padrão recorrente em agentes baseados em modelos de linguagem: o desempenho agregado em tarefas pode melhorar mesmo quando falhas individuais de raciocínio continuam visíveis.
Ainda não sabemos exatamente o que o Opus escreveu em suas anotações
A peça mais importante que falta é a estratégia interna de aprendizagem.
Gostev não divulgou publicamente o histórico completo de anotações nem uma análise detalhada de como o Opus mudou seu comportamento de prática partida após partida.
Portanto, o experimento mostra um resultado:
pesos fixos
+ anotações persistentes
+ partidas repetidas
→ melhor desempenho medido
Mas ainda não explica totalmente o mecanismo.
O Opus estava aprendendo aberturas?
Estava armazenando erros táticos recorrentes?
Estava alterando a seleção de oponentes?
Estava melhorando a representação do tabuleiro ou a verificação de lances?
Sem as anotações completas e ablações controladas, essas perguntas permanecem em aberto.
GPT-6 Astra: início forte, seguido por uma longa queda
A trajetória do Astra foi quase o inverso.
Ele começou bem.
Por volta da partida 29, o experimento registrou um Elo estimado de 1810.
Então a curva se moveu para baixo.
A fonte relata:
| Ponto da execução | Elo aproximado |
|---|---|
| Partida 29 | 1810 |
| Partida 100 | 1680 |
| Partida 150 | 1540 |
| Partida 200 | 1400 |
Contra o Stockfish de aproximadamente nível 1800, a taxa de pontuação relatada caiu ao longo de quatro segmentos:
44% → 19% → 17% → 12%
Mesmo contra o Skill 0, a fonte afirma que a taxa de vitória do Astra caiu de mais de 90% na primeira metade da execução para cerca de 60% na segunda metade.
O modelo teve acesso a registros persistentes, assim como o Opus.
Mas mais experiência acumulada não produziu resultados melhores.
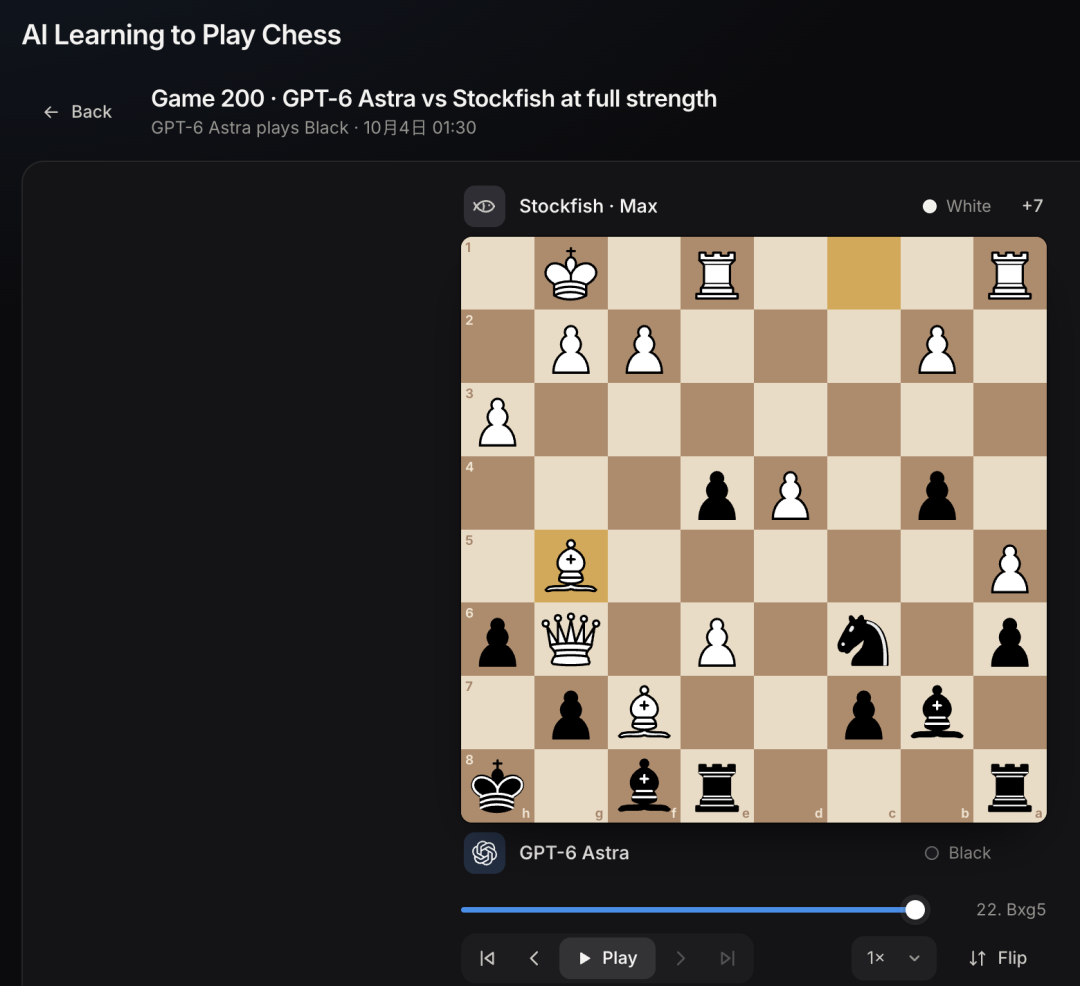
O painel do experimento mostra o Astra concluindo 200 partidas com Elo estimado de 1400.
A fonte também informa que o Astra jogou 68 partidas contra o Stockfish em força máxima e não venceu nenhuma.
Isso não é surpreendente, dado o quão forte é o Stockfish moderno, mas reforça por que o sinal útil do benchmark vem principalmente das configurações de força limitada, e não da tentativa de vencer o Stockfish em força máxima.
Crie um site de apresentacao e gere leads em minutos
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Contexto em excesso piorou o Astra?
Gostev propôs uma possível explicação: gestão de contexto.
À medida que anotações e arquivos se acumulavam ao longo da execução, o agente passou a ter mais material histórico para processar.
Ele sugeriu que a configuração do Codex usada para o Astra fornecia à execução cerca de um orçamento de contexto de 272K, e que o desempenho poderia se degradar à medida que as anotações acumuladas se tornassem maiores e mais ruidosas.
Essa hipótese corresponde a uma experiência familiar aos usuários:
Mais contexto
≠ automaticamente melhor contexto
Um histórico longo pode conter:
- Conclusões antigas.
- Conclusões novas que contradizem as antigas.
- Heurísticas ruins aprendidas com uma partida azarada.
- Anotações repetidas.
- Estratégias úteis contra uma dificuldade, mas prejudiciais contra outra.
- Detalhes demais para o modelo priorizar corretamente.
Em outras palavras, a memória pode se tornar interferência.
Mas a explicação do contexto não está comprovada
A fonte é cuidadosa nesse ponto, e a versão final também deve ser.
A queda do Astra não pode ser atribuída apenas ao tamanho do contexto com base neste experimento.
Para estabelecer causalidade, seriam necessárias comparações controladas, como:
mesmo modelo
mesmas partidas
mesmas ferramentas
mesmos prompts

Execução A: memória pequena / resumida agressivamente
Execução B: memória bruta grande
ou:
mesmo modelo
mesma estratégia de aprendizagem
mesma programação de oponentes

Execução A: configuração de contexto de 258K
Execução B: configuração de contexto de 1M
Somente então seria possível separar o tamanho do contexto de outros fatores, como:
- Estratégias diferentes de tomada de notas.
- Seleção diferente de oponentes.
- Variação aleatória nas partidas.
- Deriva de prompt.
- Autoavaliação inadequada.
- Acúmulo de premissas estratégicas ruins.
O próprio Astra suporta uma janela de contexto muito maior
Há também um esclarecimento importante no nível do produto.
A documentação atual da API da OpenAI lista o GPT-6 Astra com uma janela de contexto de 1.050.000 tokens.
A captura de tela do benchmark mostrava uma execução do Astra configurada em cerca de 258K, enquanto Gostev se referiu a aproximadamente 272K no Codex.
Portanto, o experimento não estava testando o Astra em seu tamanho máximo de contexto da API.
Isso importa porque a interpretação da manchete deve ser:
O Astra caiu nesta configuração específica de agente com memória persistente.
não:
A arquitetura do Astra não consegue lidar com contexto longo.
Essas são alegações muito diferentes.
Foi adicionada uma execução do GPT-6.1 Sol com contexto de 1M
Gostev respondeu à questão do contexto adicionando outra trilha.
A fonte afirma que ele anunciou uma execução do GPT-6.1 Sol com uma configuração de contexto muito maior e, pouco depois, a página do benchmark mostrou uma faixa dedicada a contexto longo de cerca de 828K.
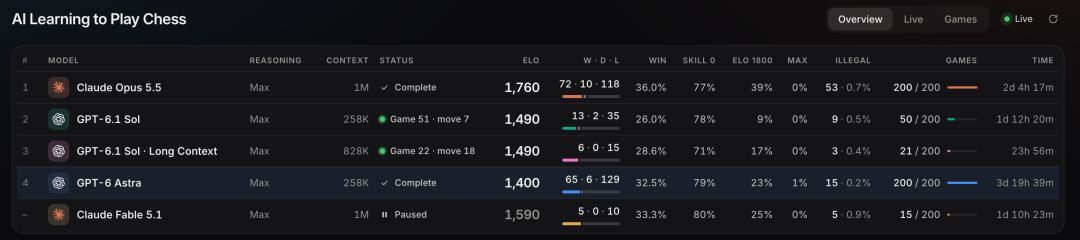
No momento em que o artigo-fonte foi escrito, GPT-6.1 Sol e Claude Fable 5.1 tinham concluído apenas uma pequena fração das 200 partidas.
O registro do painel incluía:
| Modelo | Partidas no registro da fonte | Elo aproximado | Status |
|---|---|---|---|
| Claude Opus 5.5 | 200 | 1760 | Concluído |
| GPT-6 Astra | 200 | 1400 | Concluído |
| GPT-6.1 Sol | ~50 | ~1490 | Em execução |
| GPT-6.1 Sol Long Context | ~21 | ~1490 | Em execução |
| Claude Fable 5.1 | 15 | ~1590 | Pausado |
Essas execuções parciais eram precoces demais para sustentar o mesmo tipo de análise de trajetória das execuções concluídas do Opus e do Astra.
A OpenAI agora documenta oficialmente o GPT-6.1 Sol com uma janela de contexto de 1,05M tokens, portanto a faixa de contexto longo é um acompanhamento útil para observar — mas ainda precisa de partidas suficientes e de uma análise controlada antes que possa responder à questão causal.
Uma IA de pesos fixos pode realmente aprender com o fracasso?
Essa é a questão maior por trás do experimento de xadrez.
O treinamento convencional de modelos termina antes da implantação.
Quando os pesos são fixados, o modelo normalmente não se reescreve permanentemente depois de cada conversa.
Mas há outro tipo de adaptação:
aprendizagem em contexto.
Um modelo pode ler novas informações, retê-las em seu contexto de trabalho ou em arquivos persistentes e comportar-se de forma diferente mais tarde sem alterar seus parâmetros.
O benchmark de xadrez leva essa ideia por muitas tentativas repetidas.
O modelo pode sofrer uma derrota, registrar algo e levar a lição para uma partida posterior.
A sequência é assim:
Partida 1
→ perder
→ registrar observações

Partida 2
→ ler anotações anteriores
→ tentar algo diferente
→ atualizar anotações

Partida 3
→ reutilizar a experiência acumulada
→ continuar
Se o desempenho melhora ao longo do tempo, o sistema está exibindo uma forma prática de aprendizagem, mesmo que seus pesos neurais permaneçam fixos.
Oriol Vinyals chamou-o de um bom benchmark de aprendizagem em contexto
Oriol Vinyals também comentou sobre o experimento e o descreveu como um benchmark promissor de aprendizagem em contexto.
Esse enquadramento é útil porque evita exagerar o resultado.
O benchmark não demonstra atualizações autônomas de pesos.
Ele testa se um modelo pode criar sua própria estrutura de apoio em torno de pesos fixos:
anotações
+ arquivos
+ tentativas repetidas
+ autorreflexão
+ feedback do ambiente
e usar essa estrutura para melhorar.
A publicação original de Gostev faz a mesma distinção.
Ele observou que ainda não temos aprendizagem contínua verdadeira no sentido mais forte, mas que um modelo pode aproximar parte desse comportamento ao construir uma memória externa e aprender por meio dela.
O Opus melhorou, mas isso não significa que a “autoevolução” esteja resolvida
A fonte termina com uma nota otimista: talvez os modelos possam se tornar mais fortes por meio de experiência repetida sem que humanos os retreiem.
O experimento fornece algumas evidências para essa possibilidade.
Ele não resolve o problema.
Várias limitações permanecem.
1. Esta é uma única tarefa
O xadrez é estruturado, determinístico e fornece feedback claro.
Aprender com partidas repetidas de xadrez é diferente de melhorar em tarefas ambíguas do mundo real, como pesquisa, programação, medicina ou negócios.
2. Os modelos escolheram seu próprio currículo
Isso faz parte do experimento, mas também torna a comparação mais difícil.
Se Opus e Astra selecionaram diferentes forças de oponentes em momentos distintos, eles não foram expostos a sequências de treinamento idênticas.
3. O Elo é uma métrica interna do benchmark
O Elo exibido é útil para acompanhar a execução, mas não é uma classificação humana padronizada.
4. Ainda não temos ablações completas de memória
Para saber se as anotações causaram a melhoria, seriam desejáveis comparações com:
- Nenhuma anotação.
- Anotações aleatorizadas.
- Anotações comprimidas.
- Anotações escritas por humanos.
- Redefinições com contexto novo.
- Janelas de contexto maiores e menores.
5. A melhoria pode coexistir com erros básicos
O Opus ganhou substancialmente enquanto ainda tentava lances ilegais.
Isso significa que ser “melhor” não implica domínio estável de cada subcompetência.
6. A memória longa pode ajudar ou prejudicar
Um caderno persistente não é automaticamente útil.
A execução do Astra é um lembrete de que a memória autogerada pode acumular erros tão facilmente quanto lições úteis.
Um futuro agente de aprendizagem contínua talvez precise aprender não apenas o que lembrar, mas também:
- O que excluir.
- O que resumir.
- Quais crenças revisar.
- Quais experiências foram enganosas.
- Como separar táticas temporárias de princípios duradouros.
Isso pode tornar a gestão de memória um dos problemas centrais dos agentes de IA de longa duração.
O resultado mais interessante é a divergência
Se ambos os modelos tivessem melhorado de forma constante, a conclusão seria simples: anotações persistentes ajudam.
Se ambos tivessem caído de forma constante, a conclusão seria igualmente simples: o acúmulo descontrolado de memória prejudica.
Em vez disso, o benchmark produziu duas curvas opostas.
Isso é mais interessante cientificamente.
Isso sugere que a capacidade de se beneficiar da experiência pode depender de mais do que o tamanho de contexto disponível.
O modelo precisa construir um processo de aprendizagem útil dentro desse contexto.
Um agente persistente forte talvez precise ser bom em tudo o que segue:
observar o fracasso
→ identificar a lição correta
→ armazená-la de forma compacta
→ recuperá-la mais tarde
→ evitar superajuste a um único episódio
→ revisar memórias ruins
→ aplicar a lição em uma nova situação
Isso está muito mais próximo de um sistema de aprendizagem do que de um chatbot estático — mesmo que os pesos nunca mudem.
FAQ
O que foi o experimento de IA aprendendo a jogar xadrez?
Peter Gostev deixou agentes de IA de fronteira jogarem até 200 partidas contra diferentes níveis de dificuldade do Stockfish, mantendo anotações entre as partidas. Os modelos não receberam ajuste fino durante a execução e não podiam usar um motor de xadrez para escolher lances.
Claude Opus 5.5 realmente ganhou cerca de 250 pontos de Elo?
Dentro da própria métrica de Elo estimado do benchmark, sim: a fonte relata que o Opus passou de aproximadamente 1500 para cerca de 1760, com pico em torno de 1840. Esse número é uma classificação experimental interna baseada em partidas recentes contra o Stockfish de força limitada e não deve ser tratado como uma classificação FIDE humana oficial.
Por que o GPT-6 Astra piorou ao longo de 200 partidas?
O experimento não estabelece uma causa confirmada. Gostev sugeriu que o acúmulo de anotações dentro do contexto do Codex poderia ter contribuído, mas a qualidade das anotações, a seleção de oponentes, a deriva de prompt, a variação aleatória ou outros fatores também podem ser relevantes.
O GPT-6 Astra tem apenas uma janela de contexto de 272K?
Não. A OpenAI atualmente documenta o GPT-6 Astra com uma janela de contexto de 1,05M tokens. O número de aproximadamente 258K/272K discutido no experimento se refere à configuração do Codex ou do benchmark usada nessa execução, e não ao contexto máximo da API do Astra.
Claude Opus 5.5 foi lançado oficialmente?
Sim. A Anthropic apresentou oficialmente o Claude Opus 5.5 em 22 de setembro de 2026. A empresa o posiciona como uma grande atualização em relação ao Opus 5 e o documenta para cargas de trabalho de programação e agentes.
O que é aprendizagem em contexto neste experimento?
Aprendizagem em contexto significa que o modelo muda seu comportamento usando informações disponíveis em seu contexto ou em arquivos persistentes, sem atualizar os pesos da rede neural. Aqui, as partidas de xadrez e as anotações atuam como experiência acumulada que pode influenciar partidas posteriores.
Por que o Stockfish em força máxima foi excluído do cálculo de Elo?
O benchmark usa configurações mais fracas do Stockfish para produzir uma faixa de desempenho mensurável para os modelos de linguagem. O Stockfish em força máxima é muito mais forte que o jogo de xadrez atual de modelos de linguagem, portanto incluir essas partidas diretamente na estimativa experimental de Elo seria menos informativo para acompanhar a melhoria.
Este experimento prova que a IA pode se autoaperfeiçoar continuamente?
Não. Ele mostra que pelo menos uma execução de modelo melhorou substancialmente por meio de contexto persistente e experiência repetida em uma tarefa estruturada. Demonstrar aprendizagem contínua robusta exigiria experimentos controlados em muitas tarefas, estratégias de memória, configurações de modelo e tentativas repetidas.
Ferramentas relacionadas
- Stockfish: O motor de xadrez de código aberto usado como oponente no experimento.
- Claude Code: O ambiente de terminal agêntico da Anthropic usado nas execuções de xadrez do Claude.
- OpenAI Codex: O ambiente de agente de programação da OpenAI usado nas execuções de xadrez do GPT.
- Claude Opus 5.5: A página oficial da Anthropic para o modelo Opus usado na execução concluída do Claude.
- GPT-6 Astra: A página oficial do modelo da OpenAI com as especificações atuais de janela de contexto e API.
- GPT-6.1 Sol: A página oficial do modelo da OpenAI para o modelo Sol de acompanhamento testado em faixas posteriores do benchmark.
Links relacionados
- IA aprendendo a jogar xadrez: O site do benchmark ao vivo mencionado por Peter Gostev e pelo artigo-fonte.
- Perfil de Peter Gostev no X: A conta pública do criador do experimento, onde foram publicadas atualizações do benchmark e comentários sobre a metodologia.
- Anúncio do Claude Opus 5.5: As informações oficiais de lançamento da Anthropic, de setembro de 2026, para o Opus 5.5.
- Anúncio oficial do GPT-6 Astra: A página oficial de lançamento da OpenAI para o GPT-6 Astra.
- Anúncio oficial do GPT-6.1 Sol: A página oficial de lançamento da OpenAI para o modelo Sol posterior adicionado ao experimento.
- Stockfish 19: Informações oficiais de lançamento do Stockfish e discussão sobre a força atual do motor.
- Documentação do Claude Code: Documentação oficial de configuração e uso do Claude Code.
- Artigo original da comunidade BAAI: O artigo-fonte em língua chinesa usado para esta micro-reescrita.
Resumo
O experimento de xadrez de Peter Gostev deu ao Claude Opus 5.5 e ao GPT-6 Astra oportunidades repetidas de aprender com suas próprias partidas sem alterar os pesos dos modelos. O Elo experimental do Opus subiu de aproximadamente 1500 para 1760, enquanto o Astra atingiu um pico cedo e caiu para 1400 na partida 200.
O resultado é interessante não porque resolva qual modelo é “melhor em xadrez”, mas porque expõe uma questão mais profunda sobre agentes persistentes: um modelo pode construir experiência útil por meio de anotações, arquivos e feedback repetido — e consegue impedir que essa memória se torne ruidosa ou ativamente prejudicial?
A queda do Astra continua sem explicação. O acúmulo de contexto é uma hipótese plausível, mas são necessários experimentos controlados de memória e janela de contexto antes de fazer uma afirmação causal.
A lição mais forte deste benchmark é que pesos de modelo fixos não garantem comportamento fixo: o que um agente lembra, como organiza essa memória e como aprende com o fracasso podem levar o desempenho acentuadamente para cima — ou para baixo — ao longo do tempo.