A Anthropic afirmou que Claude Sonnet 5.5 e Haiku 5.5 sucederiam o Opus 5.5 "nas próximas semanas".
O Sonnet 5.5 chegou apenas seis dias depois.
O novo modelo Claude de categoria intermediária não é simplesmente uma versão menor do Opus 5.5. Em alguns benchmarks de programação, ele obtém pontuações mais altas.
O exemplo mais chamativo é o Terminal-Bench 4.0:
Claude Sonnet 5.5: 70.6%
Claude Opus 5.5:   66.4%
Claude Sonnet 5:   10.3%
No trabalho profissional mais amplo, porém, o Opus 5.5 ainda mantém uma vantagem estreita.
A Anthropic informa:
GDPval-AA v2.1
Opus 5.5:   1846 Elo
Sonnet 5.5: 1844 Elo

OSWorld 2.1
Opus 5.5:   81.8%
Sonnet 5.5: 80.1%
Isso torna o Sonnet 5.5 excepcionalmente próximo do modelo topo de linha da Anthropic em várias tarefas mensuráveis, mantendo a faixa de preço mais baixa do Sonnet.
Mas a distinção entre os modelos continua sendo importante.
A Anthropic afirma que o Opus 5.5 permanece claramente mais forte em trabalhos complexos e abertos que exigem julgamento contínuo por longos períodos. O Sonnet 5.5 é direcionado mais diretamente a tarefas cotidianas bem delimitadas, como:
- Programação
- Correção de bugs
- Revisão de código
- Documentos
- Apresentações
- Planilhas
- Tarefas estruturadas de agentes
- Fluxos de trabalho iterativos rápidos
Portanto, a conclusão útil não é que o Sonnet 5.5 tenha "substituído" o Opus.
A conclusão é que a diferença de desempenho ficou muito menor em muitas cargas de trabalho rotineiras e intensivas em programação.
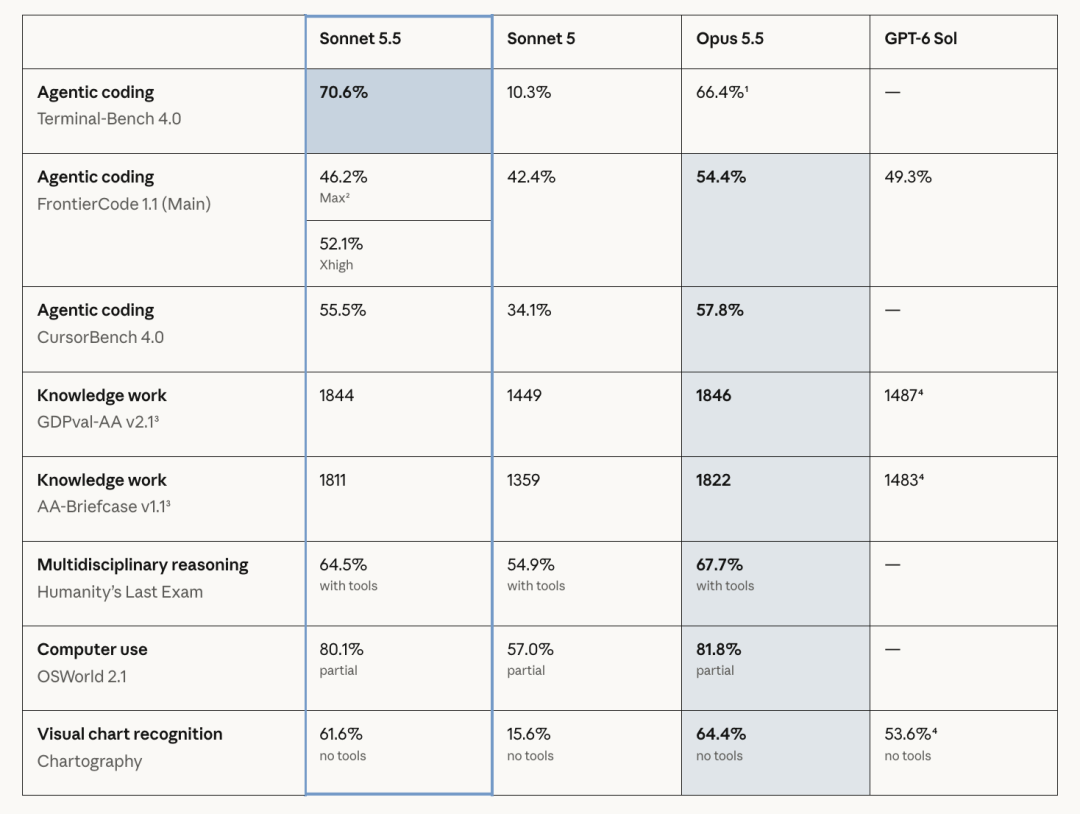
O artigo original descreve o Sonnet 5.5 como o "copo médio" perseguindo o "copo grande".
Essa metáfora se encaixa surpreendentemente bem na tabela de benchmarks.
| Avaliação | Sonnet 5.5 | Opus 5.5 | Sonnet 5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4% | 10.3% | — |
| FrontierCode 1.1 Main | 52.1% em Xhigh | 54.4% | 42.4% | até 52.1% |
| CursorBench 4.0 | 55.5% | 57.8% | 34.1% | — |
| GDPval-AA v2.1 | 1844 | 1846 | 1449 | 1487 |
| Humanity's Last Exam | 64.5% | 67.7% | 54.9% | — |
| OSWorld 2.1 | 80.1% | 81.8% | 57.0% | — |
| Chartography | 61.6% | 64.4% | 15.6% | 53.6% |
A tabela mostra o padrão real.
O Sonnet 5.5 vence diretamente um benchmark importante de programação, chega muito perto em vários outros, mas não supera universalmente o Opus 5.5.
A própria Anthropic faz a mesma distinção: as pontuações de benchmark são apenas uma perspectiva sobre a qualidade do modelo, e o Opus continua mais forte quando uma tarefa é ambígua, aberta ou exige julgamento contínuo por mais tempo.
O Sonnet 5.5 usa ferramentas com mais eficiência
A atualização não diz respeito apenas às pontuações brutas.
Os primeiros testadores também perceberam que o Sonnet 5.5 mudou a forma como trabalha.
Em comparação com o Sonnet 5, o modelo está mais disposto a agrupar chamadas de ferramentas quando as tarefas podem ser executadas em paralelo, em vez de processar tudo uma ação por vez.
O feedback de clientes da Anthropic inclui uma avaliação de programação na qual o Sonnet 5.5 usou:
~1/3 menos chamadas de ferramentas
~1/2 da quantidade de execuções de shell
para concluir o mesmo tipo de tarefa.
Isso é importante para sistemas de agentes porque cada chamada adicional de ferramenta pode acrescentar:
- Latência
- Consumo de tokens
- Custo de infraestrutura
- Risco de falha
- Estado adicional para gerenciar
Um modelo que chega à mesma resposta com menos interações com ferramentas pode ser significativamente mais barato, mesmo que seu preço nominal por token não mude.
Base44: resultados semelhantes com metade das iterações
A Base44 testou o Sonnet 5.5 em 118 tarefas reais de criação de aplicações.
O resultado relatado foi especialmente prático.
O Sonnet 5.5 produziu aplicações com pontuações no mesmo nível do Opus 5, mas exigiu:
Sonnet 5.5:
3.6 iterações por criação, em média

Opus 5:
7.7 iterações por criação, em média
A Base44 também afirmou que o Sonnet 5.5 teve o menor número de chamadas de ferramentas malsucedidas entre todos os modelos da comparação.
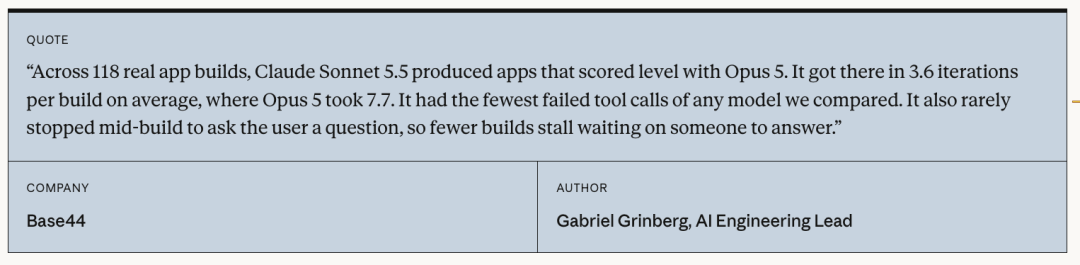
Este é um lembrete útil de que o "custo do modelo" não é apenas:
preço dos tokens de entrada
+
preço dos tokens de saída
Em fluxos de trabalho reais com agentes, o custo total também depende de:
número de iterações
quantidade de chamadas de ferramentas
ações malsucedidas
tentativas novamente
interrupções humanas
tempo até o resultado aceito
Se um modelo conclui o trabalho com metade das iterações, a diferença de custo efetiva pode ser muito maior do que a sugerida pela tabela de preços da API.
A Epic Games colocou o modelo em bases de código extensas
A Epic Games testou o Sonnet 5.5 em sistemas de software muito maiores.
De acordo com o feedback de clientes publicado pela Anthropic, o modelo lidou com dezenas de milhares de linhas de código de sistemas de gameplay em tarefas como:
- Auditorias de design de sistemas
- Revisões de fluxo de dados
- Tarefas de programação com duração de várias horas
A Epic Games afirmou que o modelo alcançou um nível de qualidade normalmente esperado de um modelo de categoria superior, exigindo menos instruções prescritivas.
Esse é exatamente o tipo de carga de trabalho em que um modelo menor pode se tornar valioso.
Um desenvolvedor ainda pode querer usar o Opus 5.5 para definir a arquitetura ou resolver os problemas ambíguos mais difíceis, mas o Sonnet 5.5 pode assumir uma parcela muito maior do trabalho de implementação e revisão a um custo menor.
A Unity contabiliza uma tarefa somente quando o projeto é executado
A Unity usou um padrão de conclusão mais rigoroso.
Em vez de aceitar um patch de código simplesmente porque o modelo informou que estava concluído, a Unity reabriu o projeto e verificou se o resultado realmente funcionava em tempo de execução.
Nessa avaliação, o Sonnet 5.5 concluiu:
90%
das tarefas no benchmark de várias etapas de Editor e programação da Unity.
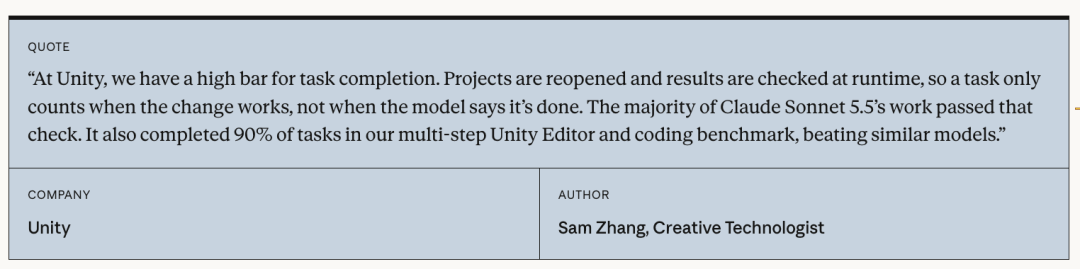
Esse tipo de teste é mais informativo do que avaliar apenas a qualidade da geração de código.
Um patch pode parecer correto e ainda falhar devido a:
- Dependências ausentes
- Estado incorreto do projeto
- Erros de compilação
- Suposições de tempo de execução
- Erros no uso de ferramentas
- Alterações fora do escopo solicitado
O benchmark da Unity tenta medir a tarefa real de ponta a ponta, e não apenas a resposta textual.
O Sonnet 5.5 consegue concluir Pokémon Red a partir de capturas de tela
A Anthropic também continuou uma de suas demonstrações recorrentes de longo horizonte.
O Sonnet 5.5 se tornou o primeiro modelo Sonnet da família Claude a vencer Pokémon Red trabalhando apenas a partir de capturas de tela.
Esse teste não é diretamente útil como benchmark de programação.
Seu valor é diferente.
O jogo exige que o modelo:
- Interprete o estado visual
- Lembre-se de objetivos de longo prazo
- Planeje ao longo de muitas etapas
- Recupere-se de erros
- Continue agindo durante um horizonte longo
Essas mesmas propriedades são importantes em agentes de uso de computador e fluxos de trabalho de software de longa duração.
O design e o trabalho de escritório também melhoraram
O artigo original destaca que o Sonnet 5.5 não é apenas mais capaz em código.
A Anthropic também o posiciona para documentos refinados, apresentações, planilhas e trabalhos visuais.
O modelo foi projetado para seguir convenções visuais existentes, em vez de criar cada artefato do zero.
Por exemplo, ao receber um modelo de apresentação existente, ele pode continuar usando o mesmo:
- Layout
- Espaçamento
- Hierarquia visual
- Convenções de estilo
- Linguagem de design
A Anthropic afirma que isso reduz a quantidade de ajustes manuais necessários após a geração.
Isso torna o Sonnet 5.5 especialmente relevante para fluxos de trabalho empresariais em que a tarefa é bem definida, mas ainda exige consistência visual.
O preço da API não aumentou
Apesar do salto de desempenho, o Sonnet 5.5 mantém o mesmo preço básico de API do Sonnet 5.
A Anthropic informa atualmente:
| Tipo de token | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Entrada | US$ 2 / 1M | US$ 4 / 1M |
| Saída | US$ 10 / 1M | US$ 20 / 1M |
| Leitura do cache | US$ 0,20 / 1M | US$ 0,20 / 1M |
| Gravação no cache | US$ 2,50 / 1M | US$ 5 / 1M |
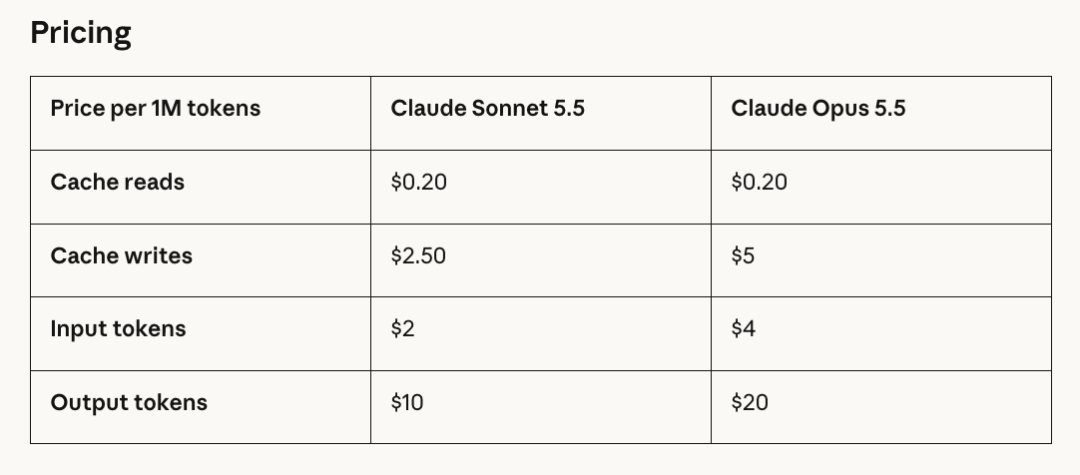
No nível do preço de tabela, os tokens padrão de entrada e saída do Sonnet 5.5 custam exatamente metade dos tokens do Opus 5.5.
Mas a Anthropic agora enfatiza mais outro indicador:
Custo por tarefa concluída.
O custo por tarefa é menor mesmo com os preços dos tokens inalterados
A Anthropic afirma que o Sonnet 5.5 gera saída mais de 30% mais rápido do que o Sonnet 5.
A empresa também afirma que o modelo normalmente precisa de menos tokens e menos etapas para concluir o mesmo trabalho.
Como resultado, a Anthropic informa que o Sonnet 5.5 pode custar:
até 30% menos por tarefa
do que o Sonnet 5 na maioria das cargas de trabalho.
É por isso que analisar apenas a tarifa de US$ 2 / US$ 10 deixa de considerar parte da atualização.
Crie um site de apresentacao e gere leads em minutos
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
A tarifa nominal permaneceu igual.
A quantidade de trabalho do modelo necessária para concluir uma tarefa diminuiu.
Terminal-Bench: esforço médio pode superar o Sonnet 5 por uma fração do custo
A Anthropic agora oferece vários níveis de esforço.
Um esforço maior permite que o modelo raciocine por mais tempo e verifique uma quantidade maior de trabalho.
Um esforço menor torna o modelo mais rápido e barato.
No Claude Code e nos aplicativos para consumidores da Anthropic, o esforço padrão é Médio. Na Claude Platform, o padrão é Alto.
No Terminal-Bench 4.0, o gráfico de custo e desempenho da Anthropic mostra que o Sonnet 5.5 com esforço Médio já supera o melhor resultado do Sonnet 5, custando aproximadamente um décimo por tentativa.
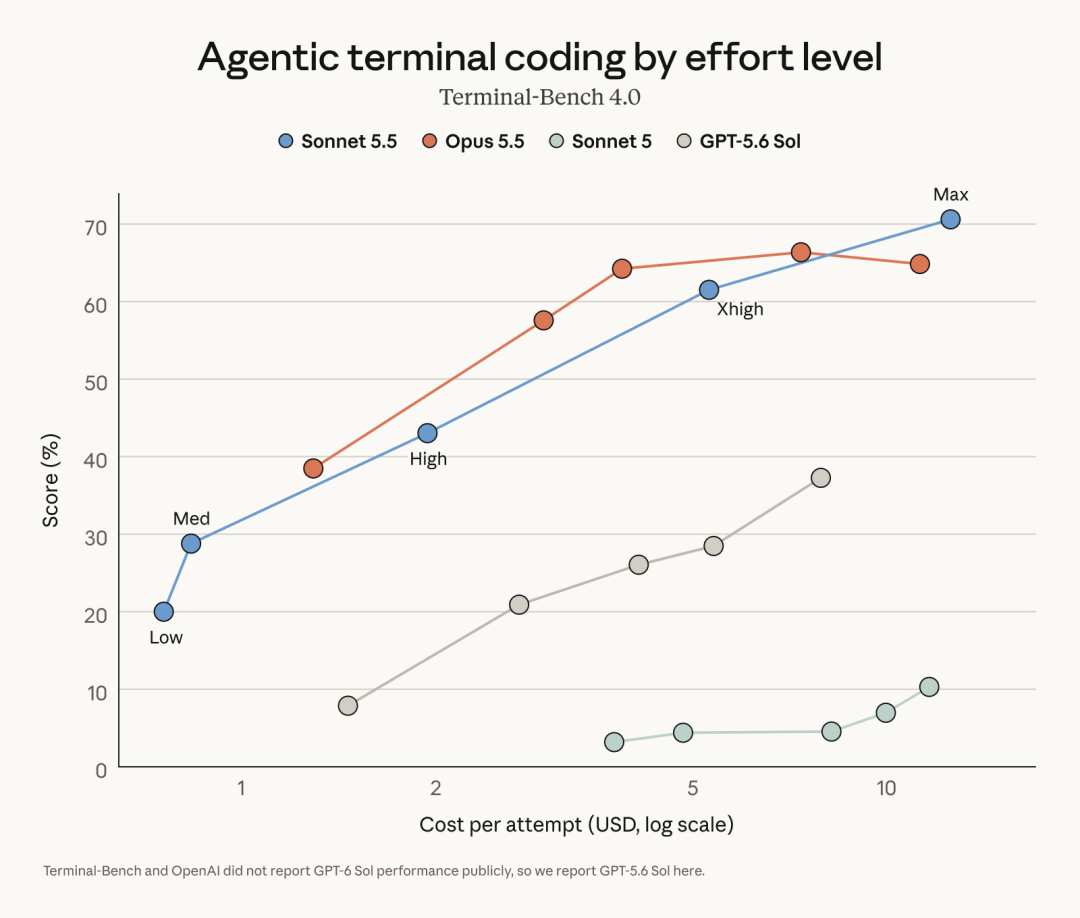
A conclusão importante não é que o nível Médio seja sempre a configuração certa.
É que agora um desenvolvedor pode ajustar qualidade e custo de forma mais direta.
Para programação rotineira, um nível de esforço menor pode ser suficiente.
Para tarefas difíceis, aumentar o esforço dá ao Sonnet mais tempo para raciocinar.
O CursorBench mostra um padrão semelhante
O CursorBench 4.0 avalia o trabalho de programação com base em sessões reais do Cursor.
O Sonnet 5.5 alcança:
55.5%
contra:
57.8%
do Opus 5.5.
O gráfico de custos da Anthropic mostra que, mesmo com um nível de esforço relativamente baixo, o Sonnet 5.5 pode superar a pontuação mais alta do Sonnet 5 por cerca de um décimo do custo por tarefa.
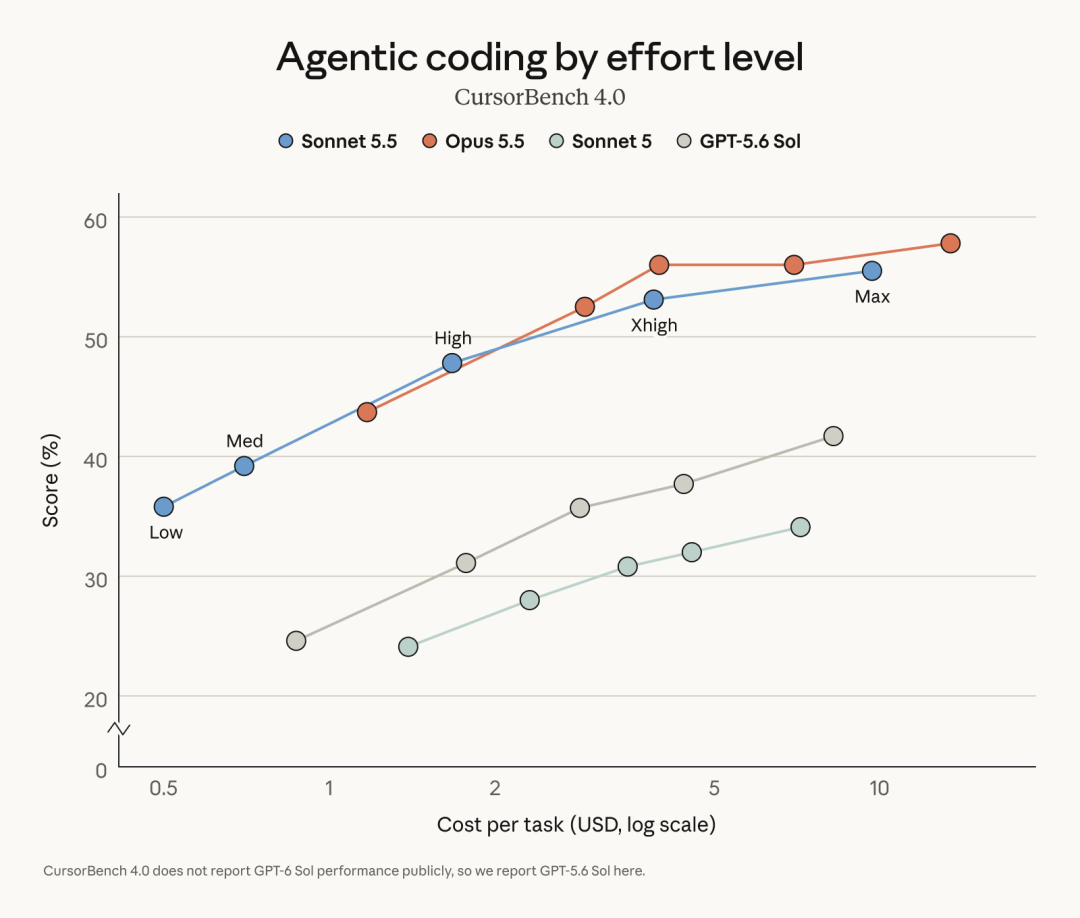
É nesse ponto que o novo Sonnet se torna especialmente atraente.
A diferença absoluta de benchmark em relação ao Opus pode ser pequena o suficiente para que o modelo de menor custo seja frequentemente a melhor escolha de produção para programação em alto volume.
O FrontierCode coloca o Sonnet 5.5 frente a frente com o GPT-6 Sol
O artigo original dá atenção especial ao FrontierCode 1.1 porque a comparação inclui o GPT-6 Sol.
O gráfico publicado pela Anthropic mostra que o Sonnet 5.5 alcança sua melhor pontuação no FrontierCode com nível de esforço Xhigh, enquanto diferentes configurações de esforço do GPT-6 Sol ficam em uma faixa de pontuação semelhante.
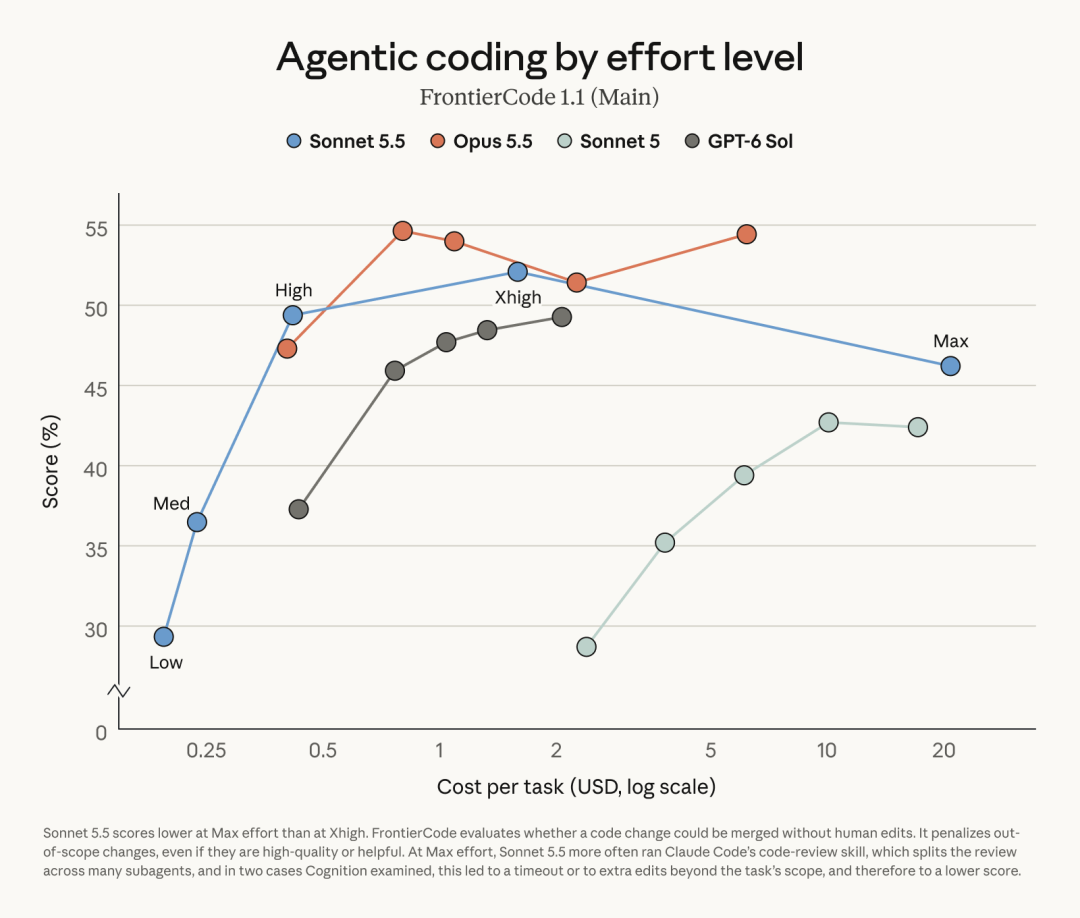
Com esforço Alto, o Sonnet 5.5 já está aproximadamente na faixa de pontuação das configurações mais fortes testadas do GPT-6 Sol, enquanto a Anthropic estima um custo por tarefa substancialmente menor.
O artigo original resume a diferença aproximadamente assim:
Custo da tarefa do Sonnet 5.5:
~1/5 do GPT-6 Sol
para o ponto comparável destacado no gráfico da Anthropic.
Esse número deve ser interpretado como uma comparação de custo por tarefa específica do benchmark, e não como uma proporção universal de preços de API.
Os modelos:
- Têm estruturas de preços diferentes
- Usam quantidades diferentes de raciocínio
- Produzem volumes diferentes de tokens
- Podem precisar de quantidades diferentes de novas tentativas
- Estão sendo comparados em configurações específicas de esforço
Portanto, é mais seguro dizer que o gráfico de benchmark da Anthropic mostra o Sonnet 5.5 alcançando qualidade semelhante no FrontierCode com um custo de tarefa medido muito menor nessa configuração.
Isso não significa que toda carga de trabalho do Sonnet custe exatamente 80% menos do que a do GPT-6 Sol.
O Sonnet 5.5 não substitui o Opus 5.5
As manchetes dos benchmarks tornam tentador concluir que o modelo Sonnet mais barato tornou o Opus desnecessário.
A Anthropic rejeita explicitamente essa interpretação.
Seus próprios testes e o feedback de clientes ainda consideram o Opus 5.5 claramente mais forte em trabalhos que exigem:
- Raciocínio aberto
- Julgamento contínuo por mais tempo
- Planejamento mais ambíguo
- Decisões de arquitetura
- Pesquisas complexas
- Decisões de alto risco em várias etapas
Uma estratégia prática de roteamento de modelos, portanto, se parece mais com:
Opus 5.5
→ arquitetura
→ planejamento difícil
→ pesquisa ambígua
→ tarefas de maior complexidade

Sonnet 5.5
→ implementação
→ correção de bugs
→ revisões
→ tarefas rotineiras de agentes
→ documentos e trabalho de escritório
→ programação em alto volume
Um cliente da Anthropic descreveu a relação de forma semelhante: deixe o Opus definir a arquitetura e depois deixe o Sonnet implementá-la.
Essa provavelmente é a maneira mais útil de compreender a família 5.5.
As salvaguardas de segurança aumentaram junto com a capacidade de programação
O artigo original se concentra principalmente em desempenho e custo, mas vale observar um detalhe oficial.
A Anthropic afirma que a capacidade de cibersegurança do Sonnet 5.5 melhorou o suficiente para que ele seja o primeiro modelo Sonnet lançado com salvaguardas cibernéticas e mecanismos de fallback semelhantes aos usados nos modelos mais capazes da Anthropic.
A Anthropic também afirma que as salvaguardas têm como alvo um conjunto restrito de solicitações de alto risco e não foram projetadas para interferir no desenvolvimento rotineiro de software.
Isso é importante porque um desempenho mais forte em programação e no uso de ferramentas também pode aumentar a capacidade de segurança de uso dual.
O Sonnet 5.5 está disponível nas plataformas Claude
A Anthropic afirma que o Sonnet 5.5 está disponível por meio de:
- Claude.ai
- Claude Code
- Claude Platform / API
- Amazon Web Services
- Google Cloud
- Microsoft Foundry
O ID do modelo na API é:
claude-sonnet-5-5
A Anthropic também oferece retenção zero de dados para o Sonnet 5.5 em configurações elegíveis da API.
Para equipes que migram do Sonnet 5, a Anthropic recomenda revisar os novos controles de esforço e considerar a configuração de raciocínio, em vez de presumir que toda configuração de tempo de execução antiga deva ser copiada sem alterações.
O Haiku 5.5 vem em seguida
O artigo de origem termina olhando para o próximo integrante da família Claude 5.5.
A Anthropic afirma que o Haiku 5.5 chegará nas próximas semanas.
Seu posicionamento já está claro:
alto throughput
+
cargas de trabalho sensíveis a custos
Se o Sonnet 5.5 é o modelo de trabalho rápido e generalista, e o Opus 5.5 é o modelo para julgamentos difíceis e abertos, espera-se que o Haiku 5.5 avance ainda mais na economia de implantação em alto volume.
A direção da família Claude 5.5 está ficando clara.
A Anthropic não está competindo apenas em pontuações brutas de benchmark.
Cada vez mais, a empresa apresenta os modelos com base em:
qualidade
+
velocidade
+
custo por tarefa concluída
Para desenvolvedores, essa pode ser uma métrica de implantação mais útil do que a pontuação de benchmark isolada.
Perguntas frequentes
O que é o Claude Sonnet 5.5?
O Claude Sonnet 5.5 é o modelo Sonnet mais recente da Anthropic e o segundo lançamento da família Claude 5.5. Ele foi projetado como um complemento mais rápido e de menor custo ao Opus 5.5 para programação, agentes, trabalho de conhecimento, documentos, apresentações e outras tarefas bem delimitadas.
O Sonnet 5.5 é melhor do que o Opus 5.5?
Em alguns benchmarks, sim. O Sonnet 5.5 alcança 70,6% no Terminal-Bench 4.0, contra 66,4% do Opus 5.5, mas o Opus ainda lidera na maioria das avaliações mais amplas e permanece mais forte em trabalhos complexos e abertos que exigem julgamento contínuo.
Quanto custa o Claude Sonnet 5.5?
A Anthropic lista o preço padrão da API em US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. As leituras do cache custam US$ 0,20 por milhão de tokens e as gravações no cache custam US$ 2,50 por milhão de tokens.
O Sonnet 5.5 é mais barato do que o Sonnet 5?
Os preços dos tokens são os mesmos, mas a Anthropic afirma que o Sonnet 5.5 normalmente usa menos tokens e conclui o trabalho com mais eficiência. Em seus testes, isso reduz o custo por tarefa em até 30% para muitas cargas de trabalho.
Quanto mais rápido é o Sonnet 5.5?
A Anthropic afirma que a geração de saída é mais de 30% mais rápida do que no Sonnet 5. Testadores externos também relatam menos chamadas de ferramentas, menos execuções de shell e menos iterações em muitas tarefas de programação.
Como o Sonnet 5.5 se compara ao GPT-6 Sol?
O gráfico de custo e desempenho do FrontierCode da Anthropic mostra que o Sonnet 5.5 alcança uma faixa de qualidade semelhante à de configurações testadas do GPT-6 Sol com um custo de tarefa medido substancialmente menor nesse benchmark. Isso não representa uma proporção universal de custos e não deve ser interpretado como prova de que o Sonnet supera o GPT em todas as cargas de trabalho de programação ou raciocínio.
Qual ID de modelo os desenvolvedores devem usar?
O ID oficial do modelo na API Claude é:
claude-sonnet-5-5
A Anthropic afirma que o modelo também está disponível por meio da AWS, do Google Cloud e do Microsoft Foundry.
Quando o Claude Haiku 5.5 será lançado?
A Anthropic afirma que o Haiku 5.5 chegará nas próximas semanas. Ele é posicionado para aplicações de alto throughput e sensíveis a custos.
Ferramentas relacionadas
- Claude: interface para consumidores da Anthropic para trabalhar com modelos Claude.
- Claude Code: ambiente de programação agentivo da Anthropic para desenvolvimento de software em escala de repositório.
- Claude API: documentação oficial da API para integrar o
claude-sonnet-5-5a aplicações. - Amazon Bedrock: plataforma da AWS que oferece modelos Claude para aplicações empresariais.
- Google Vertex AI: plataforma do Google Cloud que fornece acesso a modelos Claude.
- Microsoft Foundry: plataforma de desenvolvimento de IA da Microsoft com disponibilidade de modelos Claude.
Links relacionados
- Artigo original no BAAI Hub: artigo do QbitAI em chinês adaptado e verificado nesta publicação.
- Anthropic — Introducing Claude Sonnet 5.5: anúncio principal com benchmarks, avaliações de clientes, preços, gráficos de custo por tarefa e observações de segurança.
- Página de produto do Claude Sonnet: visão geral oficial dos casos de uso, da disponibilidade e dos preços do Sonnet 5.5.
- Claude Opus 5.5: anúncio oficial do Opus 5.5 para comparação com o modelo topo de linha da Anthropic.
- Documentação da API da Anthropic: documentação oficial da API e orientações de integração de modelos.
- Preços da Anthropic: informações atuais sobre preços dos modelos Claude e dos planos de produto.
Resumo
O Claude Sonnet 5.5 reduz a diferença entre os modelos intermediário e topo de linha da Anthropic mais do que o nome pode sugerir. Ele supera o Opus 5.5 no Terminal-Bench 4.0, fica a apenas dois pontos Elo no GDPval-AA e quase iguala o Opus no OSWorld e no CursorBench.
A história mais importante para a implantação é a eficiência. O Sonnet 5.5 mantém os mesmos preços de US$ 2 / US$ 10 por token do Sonnet 5, mas a Anthropic afirma que ele é mais de 30% mais rápido e pode reduzir em até 30% o custo por tarefa concluída. Testadores externos também relatam menos chamadas de ferramentas, menos execuções de shell e uma quantidade significativamente menor de iterações.
O Opus 5.5 continua sendo a escolha mais forte para trabalhos difíceis e abertos que exigem julgamento contínuo. O Sonnet 5.5 é melhor entendido como o modelo de trabalho para alto volume que agora alcança qualidade de nível topo de linha em um número crescente de tarefas bem delimitadas.
A atualização mais importante do Sonnet 5.5 não é uma única vitória em benchmark — é o quanto o modelo se aproxima da qualidade topo de linha mantendo o preço do Sonnet e um custo muito menor por tarefa concluída.