Durante a maior parte da era da computação, a tendência de desenvolvimento parecia óbvia: o desempenho dos chips continuava a melhorar, a in...
Durante a maior parte da era da computação, a direção do desenvolvimento parecia óbvia: os chips ficavam cada vez mais potentes, a infraestrutura de nuvem se expandia continuamente e o preço efetivo da computação só caía.
A IA pode quebrar esse padrão.
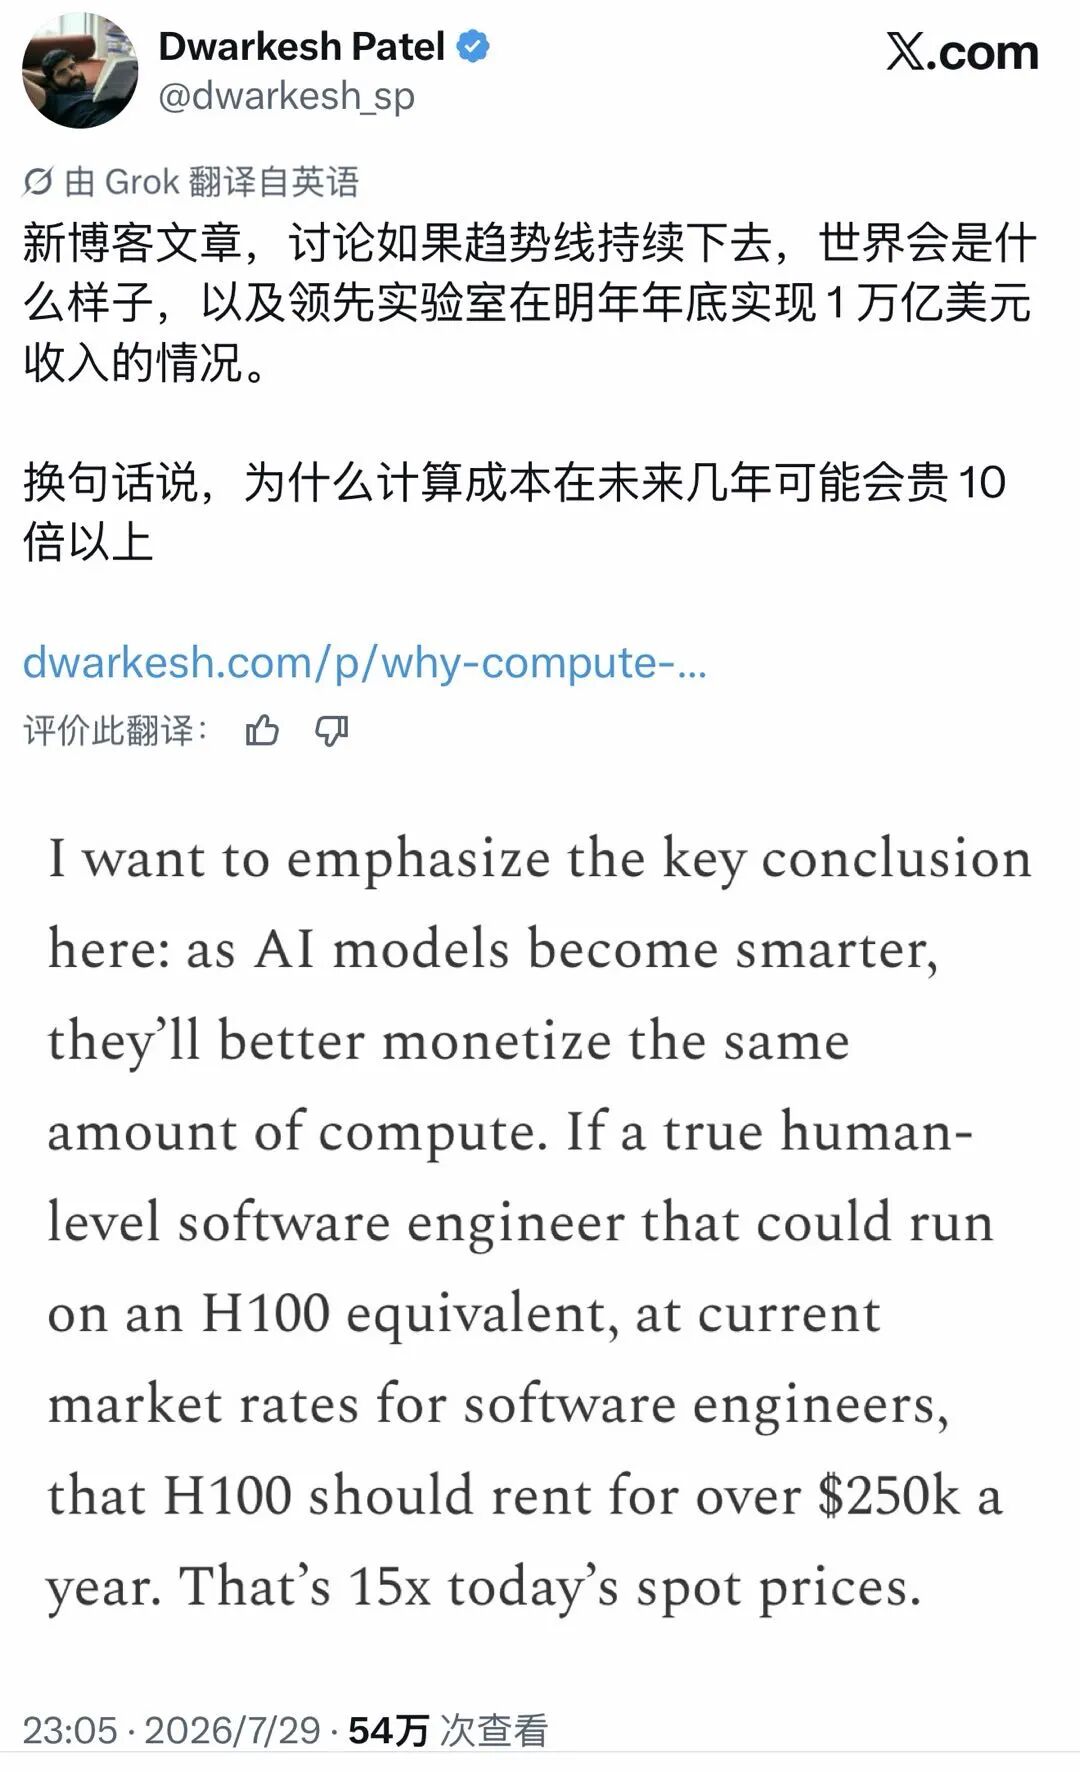
Em um artigo publicado em 29 de julho de 2026, o entrevistador de tecnologia e escritor Dwarkesh Patel apresentou um cenário deliberadamente agressivo: a capacidade da IA de fronteira de transformar computação em valor econômico aumenta drasticamente, enquanto a expansão da oferta física de computação avançada cresce muito mais devagar.
Nesse cenário, o preço de mercado da computação de IA de alto nível pode subir 10 vezes ou mais, antes de finalmente retornar à trajetória de longo prazo de queda de custos.
O argumento começa com uma comparação provocativa.
Se um agente de IA rodando em uma capacidade equivalente a uma NVIDIA H100 pudesse realizar o trabalho de um engenheiro de software bem remunerado, por que o preço de aluguel dessa GPU ainda seria determinado principalmente pela depreciação de hardware e pela competição na nuvem?
Por que seu preço não se aproximaria mais do valor econômico do trabalho humano que ela substitui ou potencializa?
O artigo original expande esse experimento mental em previsões mais amplas sobre laboratórios de IA, data centers, capacidade de semicondutores avançados e a possibilidade de o mundo estar entrando em um período de inflação severa de computação.
Desde o início, há vários limites importantes a serem esclarecidos:
Dadas as premissas acima, este experimento mental é valioso porque levanta uma questão que a indústria frequentemente evita:
O que acontece quando o valor econômico criado pela IA cresce mais rápido do que a capacidade do mundo de construir a infraestrutura necessária para sustentá-la?
O argumento começa mudando a unidade de comparação.
Hoje, a computação é normalmente precificada como infraestrutura:
A pergunta de Patel é: o que acontece quando o mesmo hardware se torna o contêiner de força de trabalho autônoma?
Imagine um engenheiro de software de IA capaz de:
Se esse agente precisar de aproximadamente uma H100 equivalente durante a execução, a GPU não é mais apenas um
componente de servidor. Ela faz parte de um sistema de produção digital.
Patel usa como referência o valor de mercado de US$ 250 mil por ano para um engenheiro de software sênior do Vale do Silício.
Em seguida, compara esse valor à estimativa de aluguel à vista anualizado de uma H100, de aproximadamente US$ 16 mil.
A lacuna implícita é:
250.000 / 16.000 ≈ 15,6 vezes
Neste experimento mental simplificado, uma GPU capaz de abrigar uma força de trabalho digital equivalente parece severamente subvalorizada em relação ao valor do trabalho que pode gerar.
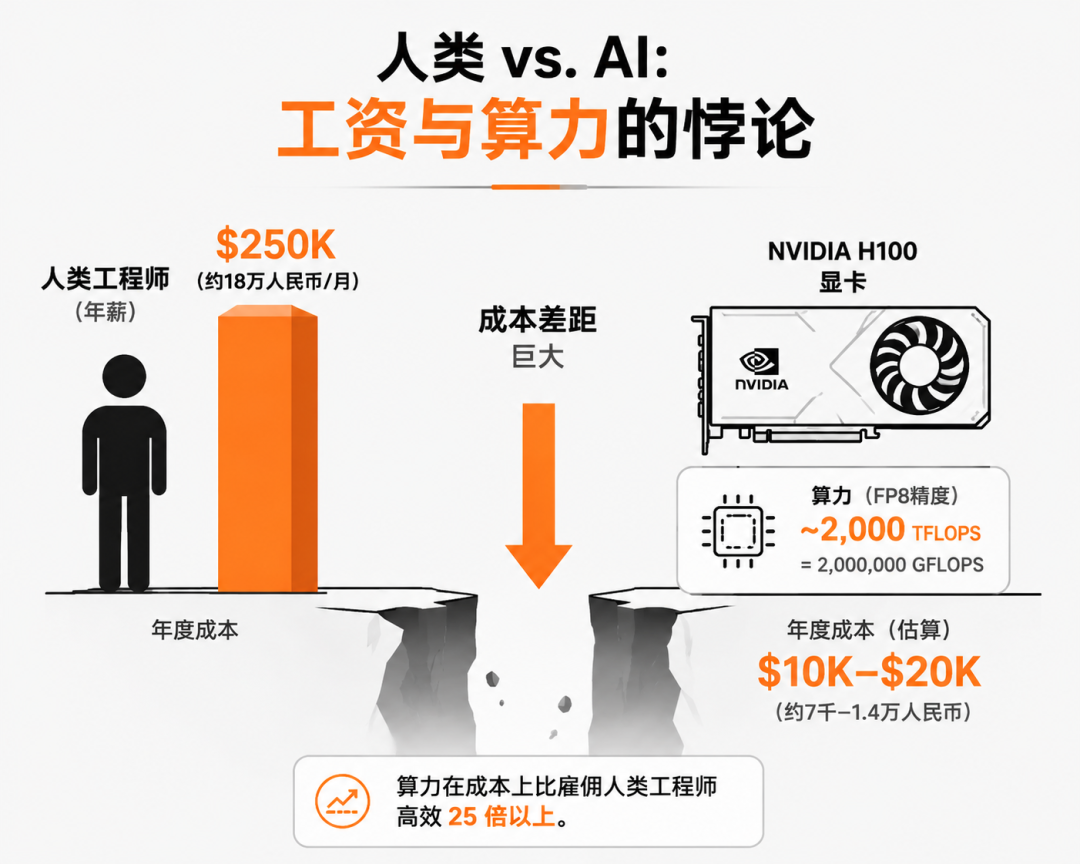
Este cálculo não é uma previsão direta de que cada H100 será alugada por US$ 250 mil.
Ele ignora vários fatores importantes:
O ponto mais estrito de Patel é que, quando a computação pode produzir resultados mais valiosos, a disposição a pagar pela computação pode aumentar drasticamente.
Uma objeção natural é que adicionar milhões de engenheiros de software de IA reduziria o valor de mercado do trabalho de engenharia de software.
Se o software se torna abundante, um engenheiro digital pode não valer mais US$ 250 mil.
Patel reconhece essa possibilidade, mas argumenta que ela não acontece automaticamente.
O raciocínio econômico padrão geralmente rejeita a ideia de que "a quantidade de trabalho útil é fixa". Trabalhadores qualificados adicionais podem criar novos produtos, novas empresas, novas especialidades e nova demanda.
Nessa visão, um grande aumento de trabalhadores capazes não apenas divide o trabalho existente entre mais participantes — ele expande o que é economicamente possível.
A IA pode trazer um choque de oferta de trabalho anormalmente rápido, então comparações históricas podem não se aplicar. Ainda assim, Patel argumenta que é razoável esperar que o valor marginal da computação de IA permaneça alto à medida que novos softwares e serviços se tornam viáveis.
Um contraponto útil na discussão abaixo do artigo de Patel é que a comparação de valor do trabalho é mais forte quando a tarefa inteira pode ser realizada em ambiente digital.
A engenharia de software se aproxima desse ideal:
Quando gargalos físicos dominam, a comparação fica mais fraca.
Um sistema de IA
pode projetar rapidamente um medicamento, mas os ensaios clínicos ainda exigem pacientes, regulamentação, fabricação e tempo. Pode otimizar uma fábrica, mas construção, licenciamento, cadeia de suprimentos e equipamentos ainda estão sujeitos a condições físicas.
Nessas áreas, a inteligência pode deixar de ser o gargalo principal antes que a capacidade computacional possa capturar plenamente o valor do trabalho humano substituído.
A segunda parte do argumento passa de uma GPU individual para as finanças dos laboratórios de IA de fronteira.
A Anthropic é o principal exemplo, devido ao seu crescimento recente excepcionalmente rápido de receita.
Os dados reportados oficialmente pela Anthropic incluem:
Esses são dados de receita anualizada, não receita auditada de ano completo.
Eles descrevem a taxa de crescimento implícita na receita em um dado momento.
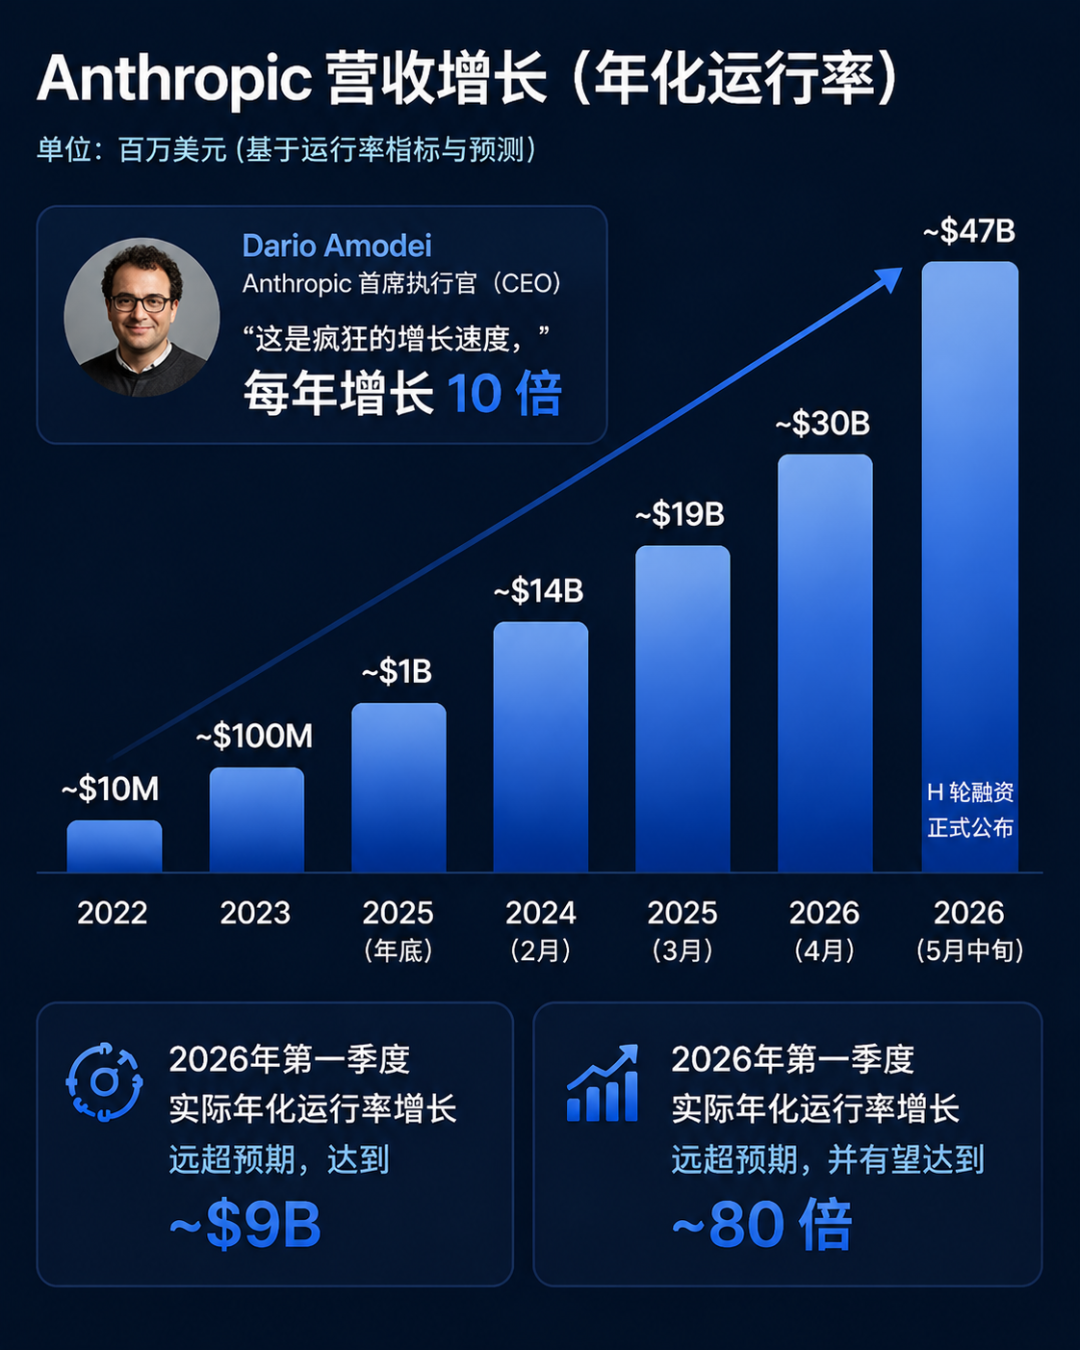
O ponto de partida de Patel é uma observação: a receita da Anthropic cresceu cerca de uma ordem de magnitude em termos anuais.
Em seguida, ele construiu um cenário deliberadamente extremo de projeção:
Patel deixa claro que essa trajetória não é uma continuação inevitável e não tem razão profunda. Ela depende das futuras capacidades de IA, taxa de adoção de produtos, precificação e concorrência.
O objetivo do cenário não é afirmar que a Anthropic previu 1 trilhão de dólares em receita, mas sim questionar: se uma empresa de IA realmente crescer nesse ritmo, quais outras condições precisariam ser atendidas?
Patel compara um hipotético crescimento de receita de 10 vezes com a estimativa de expansão anual de 3 vezes na capacidade computacional de IA.
A Epoch AI estima que o estoque global de capacidade computacional de IA em 2025, medido em equivalente H100, cresceu cerca de duas vezes (ou seja, triplicou), embora a organização também destaque que as estimativas em nível de empresa e relacionadas ao futuro ainda apresentam incertezas.
A incompatibilidade resultante é de aproximadamente:
Crescimento da demanda de negócios de IA: 10 vezes
Crescimento da capacidade computacional física: 3 vezes
Diferença: cerca de 3,3 vezes
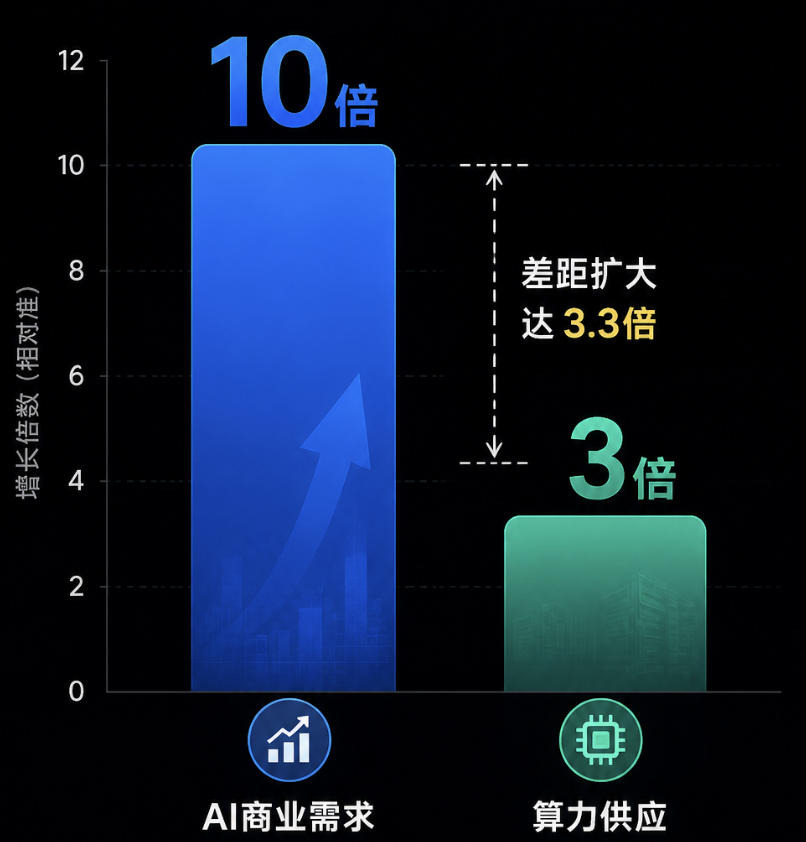
Se a receita de um laboratório de ponta crescer muito mais rápido do que sua capacidade computacional disponível, então alguma combinação das três coisas a seguir inevitavelmente mudará:
serviços de inferência geradores de receita, em vez de pesquisa e treinamento.
Patel acredita que, em certa medida, essas três coisas já estão mudando.
Provedores de modelos investem altos custos fixos para treinar modelos e depois vendem as capacidades já aprendidas a diversos clientes.
Isso cria potenciais economias de escala.
As mesmas capacidades já treinadas podem ser vendidas através dos seguintes canais:
O custo marginal de uma solicitação adicional pode ser muito menor do que o valor criado por essa solicitação.
Patel aponta que as margens de lucro de inferência dos laboratórios líderes já melhoraram significativamente. No entanto, seus dados específicos sobre as margens do serviço de inferência Fable da Anthropic são apresentados claramente como estimativas aproximadas, e não como divulgações corporativas auditadas.
Margens altas podem absorver parte da lacuna entre o crescimento da receita e o crescimento da capacidade computacional.
O desafio está na escala.
No cenário de 1 trilhão de dólares de Patel, se preços e alocação de capacidade não forem ajustados adequadamente, as margens precisariam subir para níveis altos, em torno de 95%. Ele acredita que esse nível é excepcionalmente alto, mesmo para plataformas tecnológicas líderes.
A margem exata necessária depende de muitas variáveis, mas o ponto central permanece: apenas as margens podem não ser suficientes para reconciliar a demanda explosiva com a infraestrutura limitada.
A segunda opção é alocar uma proporção maior da capacidade computacional para o atendimento ao cliente.
A Epoch AI estima que a OpenAI gastou cerca de 1,8 bilhão de dólares em capacidade de inferência em 2024, enquanto os gastos com capacidade de P&D foram de cerca de 5 bilhões de dólares. Com base nisso, estima-se que os gastos com inferência representaram cerca de um quarto dos gastos totais reportados com capacidade computacional.
À medida que o uso comercial se expande, a proporção de inferência pode aumentar ainda mais.
Isso ajuda a sustentar a receita, mas os laboratórios de ponta enfrentam um dilema estratégico.
Os serviços de inferência pagam as contas atuais.
O treinamento e a experimentação produzem os modelos que podem definir a próxima geração de produtos.
Um laboratório que aloca a maior parte de sua capacidade computacional para atender modelos atuais pode gerar receita mais direta, mas terá menos infraestrutura disponível para:
Patel descreve um efeito de volante do Vale do Silício: a receita atual de inferência ajuda a sustentar o financiamento, o financiamento compra mais capacidade computacional, a capacidade treina modelos mais fortes, e modelos mais fortes geram mais receita.
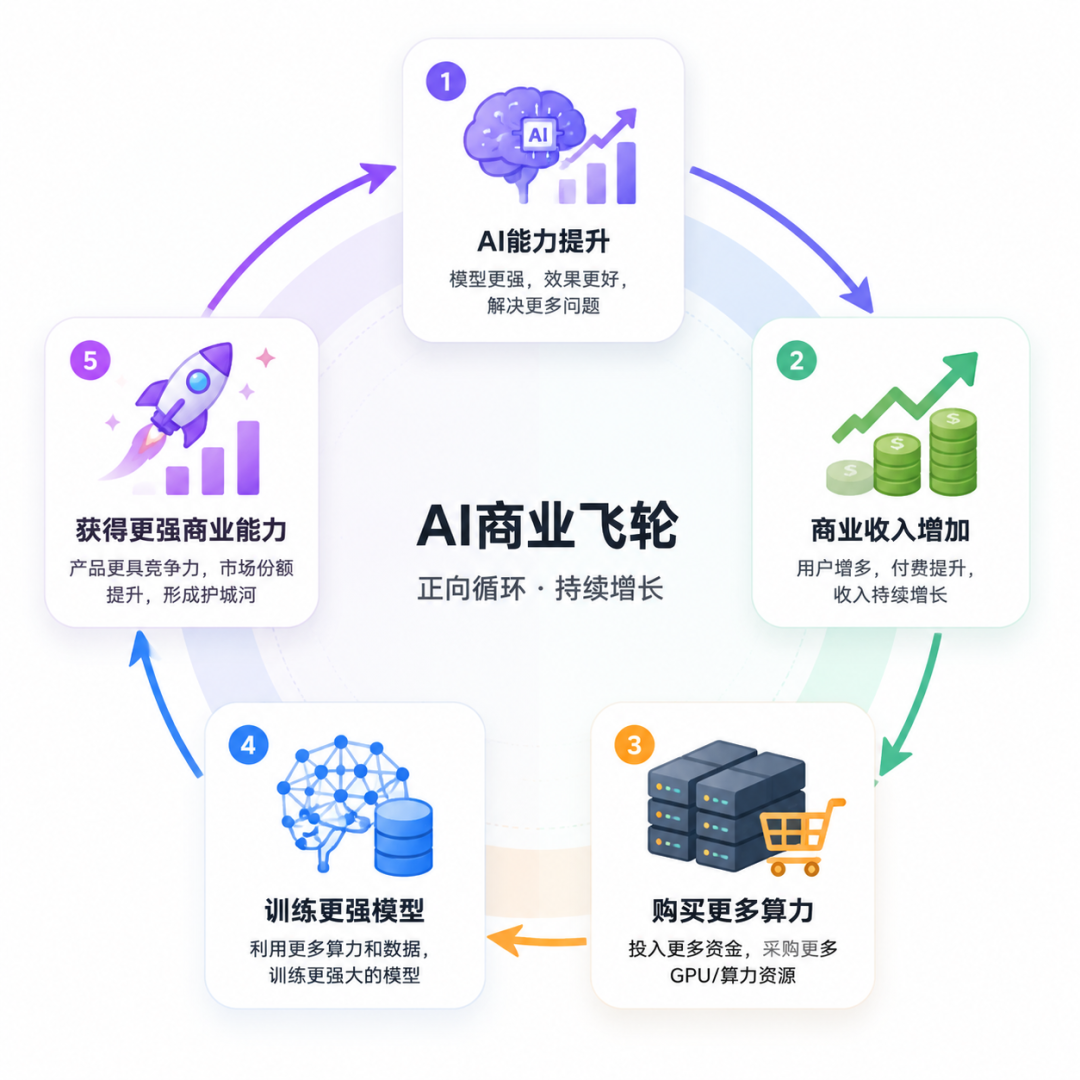
Esses laboratórios geralmente não consideram os modelos atuais como o ponto final. Eles esperam que os sistemas de ponta atuais sejam rapidamente superados.
Isso os torna relutantes em se transformar completamente em provedores de serviços em nuvem de alta margem que atendem a uma geração estática de modelos.
sobe
O ajuste restante é o preço.
Se os laboratórios de IA e seus clientes podem criar mais valor econômico por unidade de capacidade computacional, eles têm condições de fazer lances mais agressivos pela infraestrutura escassa.
Isso não significa que o preço por hora de GPU aumente igualmente em todos os casos.
Os laboratórios de ponta precisam de um tipo especializado de capacidade computacional:
Instâncias de leilão do mercado aberto não substituem completamente um contrato de infraestrutura seguro, plurianual e de múltiplos gigawatts.
Contratos recentes refletem o prêmio pela capacidade imediata.
A Anthropic confirmou oficialmente o acordo com a SpaceXAI para obter acesso ao Colossus 1 e, posteriormente, afirmou ter expandido a capacidade no Colossus 1 e no Colossus 2.
A SpaceXAI descreve o Colossus 1 como contendo mais de 220 mil GPUs NVIDIA, incluindo sistemas H100, H200 e GB200.
A Axios relatou que a Anthropic concordou em pagar cerca de 1,25 bilhão de dólares por mês até 2029 por esse acordo.
Um documento regulatório posteriormente relatado pela TechCrunch mostrou que a Google pagará à SpaceX cerca de 920 milhões de dólares por mês entre outubro de 2026 e junho de 2029 para obter acesso a cerca de 110 mil GPUs e componentes relacionados.
Esses não são contratos comuns de compra em nuvem sob demanda.
Eles refletem o valor de obter rapidamente infraestrutura de grande escala disponível em um momento em que a construção de novos data centers, interconexões de rede elétrica e entrega de chips podem levar anos.
Patel estima que o preço implícito por hora de GPU no acordo da Google é cerca de duas vezes o preço atual de mercado à vista do hardware híbrido relevante.
Essa comparação é aproximada porque o contrato inclui mais do que apenas GPUs nuas, e a combinação de hardware abrange aceleradores de diferentes gerações.
O artigo original usa uma analogia industrial.
Na era da internet, as empresas disputavam:
现货算力对前沿工作负载存在多个劣势:
因此,训练前沿模型或运行前沿服务的实验室,与那些运行短期批处理任务的买家相比,会更加看重有保障的算力。
这也有助于解释,为什么即使在公共云报价看起来更便宜的情况下,合同制算力依然可以享有溢价。
帕特尔的核心论点在于:算力供给无法对重大需求冲击作出足够快速的反应。
他将年度算力增长概括为三个广义乘数的乘积:
年度AI算力增长 ≈
1.4× 硬件改进
× 1.2× 新建晶圆产能
× 1.8× 领先制程晶圆向AI的重新分配
≈ 3.0×
这些数字是估算值,而非不变的物理常数。
它们旨在说明近期增长的主要来源。
半导体技术的进步,提升了每瓦功耗、每颗芯片和每美元投入所交付的有效计算量。
潜在收益来自:
但进步并非没有上限。
每一代新制程都变得更加困难、更加昂贵。功耗密度、漏电、良率、内存搬运和封装,日益成为实际性能的决定因素。
AI系统还可以通过模型和软件层面的改进来提升效率,这可能在某种程度上抵消硬件短缺的影响。因此,任何对算力价格的预测,都取决于效率提升与需求增长之间的相对速度。
新的半导体产能需要数年时间,才能完成规划、融资、建设、设备安装、验证和产能爬坡。
供应链高度依赖专用系统,其中包括极紫外光刻设备。
先进的晶圆厂还需要:
帕特尔认为,至少到本十年末,EUV设备的可用性都会制约产能的快速扩张。
更高的价格可以刺激投资,但无法在短期内造就一座完全验证合格的领先制程工厂。
近期AI芯片增长中,有很大一部分来自将先进制造产能从其他产品转移过来。
智能手机、个人电脑、网络芯片和其他设备,都在争夺同一批领先制程和封装资源。
帕特尔引用了一项估算,即到2027年底,AI在台积电N3产能中的占比可能从约60%上升至86%。
这是供给模型的估算,而非台积电公开的产能指引。
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
其含义很直白:只有在非AI需求仍然占据可被转移的产能时,重新分配这一杠杆才有效。
一旦AI已经消耗了相关节点的大部分产能,这一增长杠杆就会大大削弱。
即使晶圆供给扩大,整个系统仍可能受到以下因素的制约:
因此,算力供给是一条链路,而非单一工厂的产出。
有效产能受制于最慢的关键环节。
消息源随后提出了一个反直觉的论点:如果算力变得更昂贵,买家未必会转向较弱的模型。
他们甚至可能更加偏好最强的模型。
帕特尔将此与阿尔钦–艾伦效应联系起来。
当固定成本被加到不同质量的商品上时,高端版本可能变得相对更具吸引力,因为质量溢价在总价格中所占的比重变小了。
假设底层算力成本为每小时20美元。
一个强模型在一小时内完成任务,并带有5美元的模型溢价:
强模型:
20美元算力 + 5美元溢价 = 25美元
一个弱模型没有溢价,但由于重试和低效推理,需要两小时:
弱模型:
2 × 20美元算力 = 40美元
表面上免费的模型,按每完成一项任务计算反而更贵。
关键指标不是每Token的价格或模型许可费,而是每成功结果的成本。
更强大的模型可以通过以下方式降低成本:
如果算力便宜,低效尝试的代价或许可以承受。
如果算力昂贵,浪费算力就变得更加肉痛。
能够从每一稀缺的GPU小时中提取出最大有用产出的实验室,或许能够收取可观的溢价。
源文章最激进的版本宣称平庸的模型可能没有未来。
这个结论过于宽泛。
较小和专用的模型在以下情况下仍能保持吸引力:
一个轻量级分类器不需要成为前沿的编程智能体。
阿尔钦–艾伦论证适用于两种模型消耗相似的昂贵基础设施、而较弱模型需要显著更多工作量才能达到相同结果的情况。
当较小的模型对该任务而言确实更高效时,该论证的力度就会减弱。
帕特尔认为,算力价格上涨可能将产能从低价值用途中转移出去。
如果一块GPU可以运行一个产生高价值软件或商业产出的智能体,那么将同一硬件用于一次性媒体内容的机会成本就会高得多。
这可能影响以下应用:
市场不一定消灭内容本身。
它可能转而将这些内容推向:
关键在于资源配置。
前沿计算将倾向于流向支付意愿最高的工作负载。
来源文章也提出了几个反对意见。
这些意见很重要,因为关于资源永久稀缺的预测常常被证明是错误的。
25万美元工程师的对比假设GPU能够获取接近工程师当前经济价值的收益。
这一假设可能因以下原因而失效:
有评论者指出,数字工人的初始价值可能很高,但一旦AI劳动力变得充裕,最终可能稳定在5万美元左右。
在这种假设下,计算的价值仍可能上升,但不一定会涨15倍。
Token价格并不等同于计算价格。
模型和服务系统持续通过以下方式改进:
Cache
No futuro, respostas de vídeo ou chat de baixo valor podem exigir apenas uma fração do poder computacional atual.
Mesmo que o custo computacional de agentes de fronteira se torne caro, os serviços gerais de IA podem continuar reduzindo preços, pois migram para modelos e hardware mais eficientes.
Modelos de pesos abertos podem pressionar os preços das APIs de fronteira.
Se vários modelos oferecem capacidades semelhantes, os usuários podem alternar entre as seguintes opções:
Isso limita a capacidade de um laboratório individual obter margens de lucro extremamente altas.
A escassez computacional ainda pode elevar os custos da infraestrutura subjacente, mas a concorrência entre modelos determina quanto valor o laboratório consegue reter.
A resposta clássica à escassez é o investimento.
Preços computacionais mais altos incentivam:
Patel também concorda que o poder computacional acabará se tornando barato novamente.
Seu argumento se concentra no período de transição atual, em que o crescimento da demanda pode superar a resposta da infraestrutura física de longo ciclo.
A fonte compara as previsões computacionais com a famosa aposta entre o biólogo Paul Ehrlich e o economista Julian Simon.
Em 1980, Ehrlich selecionou uma cesta de cinco metais, apostando que seus preços reais subiriam na década seguinte.
Em 1990, o preço ajustado pela inflação da cesta já havia caído, e Ehrlich pagou a aposta a Simon.
Essa aposta é frequentemente usada para argumentar que as previsões de escassez subestimam a inovação, a substituição e a resposta da oferta.
A interpretação histórica é
mais complexa. A análise aponta que diferentes décadas iniciais poderiam produzir vencedores diferentes.
Patel reconhece que seu argumento computacional se assemelha a previsões de escassez que frequentemente se mostraram erradas.
Ele acredita que o poder computacional pode diferir da extração de metais, pois tem menor elasticidade de oferta no curto prazo:
Portanto, a divergência é principalmente uma questão de tempo.
Antes que a demanda por IA supere a construção atual, os sinais de preço e a inovação podem expandir a oferta computacional efetiva?
Em vez de tratar "10x" como uma previsão fixa, o argumento pode ser convertido em um conjunto de variáveis mensuráveis.
Um aumento de 10x nos preços é mais provável quando:
É menos provável quando:
Mesmo que os custos computacionais não aumentem 10x, o argumento ainda tem implicações práticas.
Acompanhar:
Se um modelo mais barato falha repetidamente, ele não é realmente barato.
Reserve os modelos de fronteira caros para tarefas que realmente se beneficiam deles.
Use modelos menores para:
Apenas encaminhe casos difíceis para escalonamento.
Evite vincular todo o produto a um único modelo ou provedor de GPU.
Abstrações úteis incluem:
Loops de agentes de longa duração podem desperdiçar poder computacional com contexto repetido e saídas de ferramentas excessivamente grandes.
Direções de melhoria:
Empresas com demanda previsível podem se beneficiar de:
A estratégia correta depende da utilização. Hardware reservado é caro quando fica ocioso.
O argumento também desloca o foco dos benchmarks de modelos para a infraestrutura.
Áreas importantes incluem:
Se a inteligência se tornar um insumo econômico primário, o controle dessas camadas se tornará estrategicamente significativo.
O resultado pode ser a centralização.
Laboratórios com os melhores modelos e as receitas mais fortes podem dar lances mais altos do que novos entrantes por recursos computacionais escassos. Esses recursos ajudam a melhorar seus modelos, o que fortalece a receita, tornando o próximo lance ainda mais fácil.
Este é um ciclo de reforço:
Melhores modelos
    ↓
Produtos mais valiosos
    ↓
Mais receita
    ↓
Mais acesso a recursos computacionais
    ↓
Mais treinamento e inferência
    ↓
Melhores modelos
O risco é que a produção de inteligência possa se concentrar em poucas empresas capazes de arcar com investimentos massivos em infraestrutura.
Patel argumenta que modelos de IA mais inteligentes podem gerar mais receita por unidade de computação, enquanto a oferta real de computação avançada cresce muito mais lentamente. Se a demanda e a disposição a pagar crescerem mais rápido que a oferta de chips, energia e data centers, os preços de mercado podem subir drasticamente.
Não. A Anthropic reporta oficialmente receita anualizada superior a US$ 47 bilhões em maio de 2026. Os números de US$ 100 a 150 bilhões para o final do ano e US$ 1 trilhão no ano seguinte são suposições no experimento mental de Patel, não orientações da empresa.
Essa comparação explora como o poder computacional poderia ser precificado se um sistema equivalente ao H100 pudesse hospedar um agente de IA que realizasse o trabalho de um engenheiro bem pago. É uma referência de valor hipotética, não evidência de que um agente atual substitui um engenheiro por H100.
A Epoch AI estima que o poder computacional global de IA em 2025 cresceu cerca de 3x em equivalente H100. O crescimento futuro é incerto, dependendo do desempenho dos chips, fabricação, empacotamento, energia, construção e gastos de capital.
Laboratórios de fronteira precisam de clusters seguros, confiáveis, em grande escala, com rede de alta velocidade e desempenho previsível, além de disponibilidade de longo prazo. Instâncias spot públicas não equivalem a implantações dedicadas de vários anos contendo centenas de milhares de aceleradores coordenados.
Não. Quando o modelo mais forte alcança o mesmo resultado com menos tokens, menos tentativas ou menos tempo, o preço alto o favorece. Mas para cargas de trabalho de nicho, baixa latência, privadas ou de borda, modelos menores e dedicados ainda podem ser mais econômicos.
Patel não defende que o poder computacional permaneça caro permanentemente.
Seu argumento envolve um período de transição — durante o qual a demanda por IA pode superar a capacidade de expansão da cadeia de suprimentos de semicondutores e data centers; a longo prazo, hardware e automação podem novamente tornar a computação mais barata.
Se o crescimento da receita de IA desacelerar, a capacidade dos modelos atingir um teto, modelos de código aberto se tornarem substitutos muito próximos, a eficiência dos serviços crescer mais rápido que a demanda, ou a expansão do fornecimento de semicondutores e energia elétrica superar as expectativas, o argumento seria enfraquecido.
O argumento de Dwarkesh Patel sobre o preço da computação 10x começa com uma ideia simples: se uma GPU puder hospedar agentes de IA que executam trabalho de conhecimento de alto valor, a disposição de pagar por essa GPU pode passar a refletir o valor desse trabalho, em vez do custo histórico do servidor.
Combinado com o rápido crescimento da receita da Anthropic e as estimativas de que a computação global de IA está se expandindo cerca de 3 vezes ao ano, o argumento ganha força. Se a demanda comercial por IA crescer mais rápido, o ajuste inevitavelmente ocorrerá por meio de margens de lucro, alocação de computação, aumento nos preços de infraestrutura ou alguma combinação desses fatores.
Essa previsão está longe de ser certa. Ganhos de eficiência energética, modelos de código aberto, sistemas especializados menores, novas fábricas de chips, novos aceleradores e uma desaceleração no crescimento de capacidade podem impedir o aumento de 10x. Previsões históricas de escassez de recursos também costumam subestimar a capacidade de adaptação.
O verdadeiro insight duradouro não é que a computação precise exatamente dobrar de preço 10 vezes, mas que IAs mais inteligentes podem elevar o valor econômico de cada GPU mais rápido do que o mundo físico consegue fabricar e fornecer energia para novas GPUs.
Comece com uma frase e tenha um site completo em minutos.



