For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/deepseek-v4-1-flash-1017-coding-benchmark-81aa0890.md.
A DeepSeek atualizou o V4.1 Flash para **DeepSeek-V4.1-Flash-1017**, disponível no site, no aplicativo e pela API. Os desenvolvedores podem ...
A DeepSeek atualizou o V4.1 Flash para DeepSeek-V4.1-Flash-1017, disponível no site, no aplicativo e pela API. Os desenvolvedores podem continuar usando o nome de modelo deepseek-flash; a atualização de outubro não altera o método de chamada da API nem os preços dos tokens do modelo.
O anúncio destaca um desempenho superior em programação e agentes, além de respostas mais curtas e menor tempo de execução das tarefas. A DeepSeek também disponibilizou os pesos do modelo e abriu suas APIs independentes Search e Fetch.
A fonte ilustra a atualização por meio de “programação por intenção” (vibe coding): descrever um aplicativo ou cenário e pedir a um agente que construa um protótipo funcional. Os exemplos são demonstrações: mostram o que foi produzido em casos selecionados, não um resultado garantido com um único prompt para todos os projetos.
O primeiro exemplo é uma cena tridimensional da Cidade Proibida. A demonstração alterna entre vistas elevadas e ângulos de câmera mais baixos, mostrando pátios, portões, áreas ao redor e detalhes arquitetônicos em um ambiente navegável.
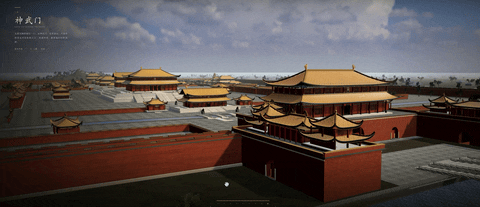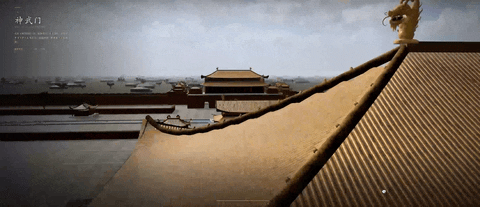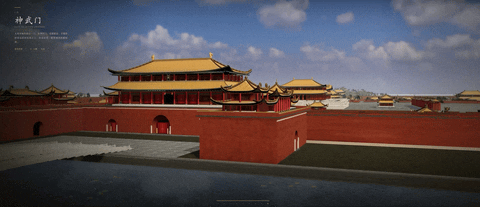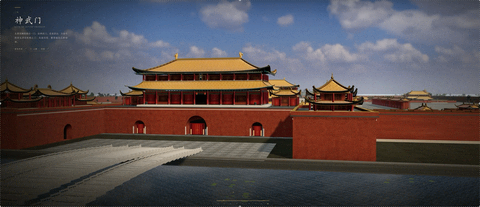
Demonstração da DeepSeek reproduzida no relatório de origem.
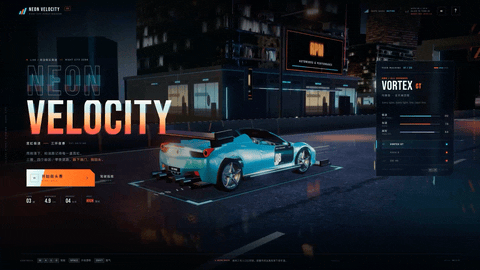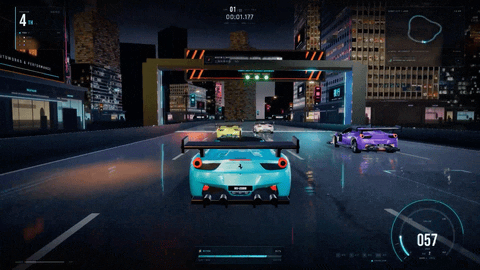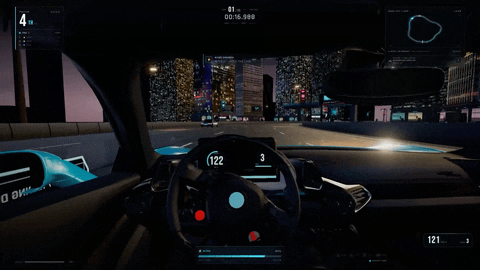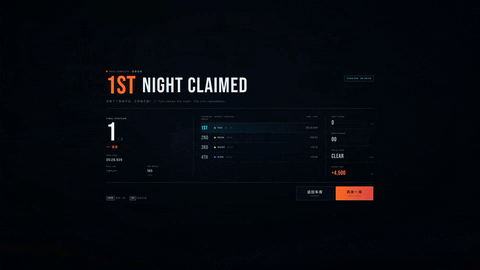
Em seguida, aparece um jogo de corrida para navegador. O fluxo apresentado inclui escolher um carro, iniciar uma corrida, dirigir por uma cidade iluminada por néon e chegar a uma tela de resultados. O relatório também descreve a alternância entre uma vista externa do veículo e uma perspectiva dentro do carro.
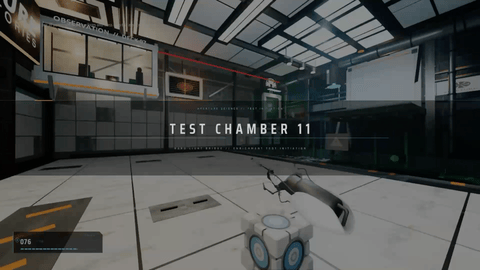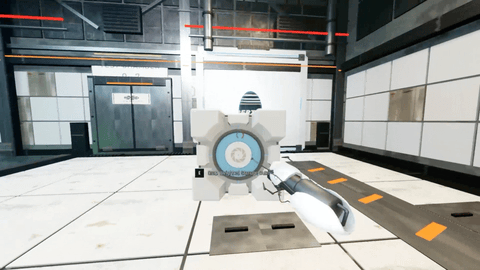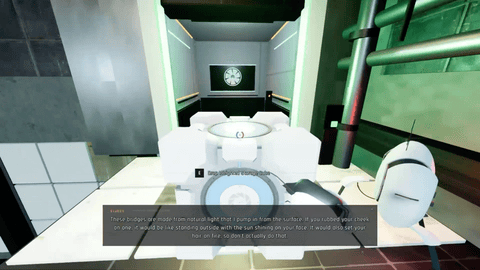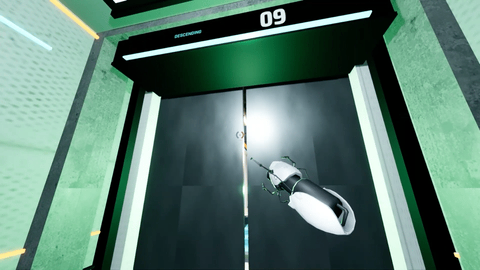
A demonstração seguinte, criada com Godot, é inspirada em Portal. Ela apresenta uma câmara de testes em primeira pessoa, movimentação pelo ambiente, objetos interativos e elementos semelhantes a portais. Deve ser entendida como um protótipo demonstrativo, não como um lançamento oficialmente licenciado do jogo da Valve.
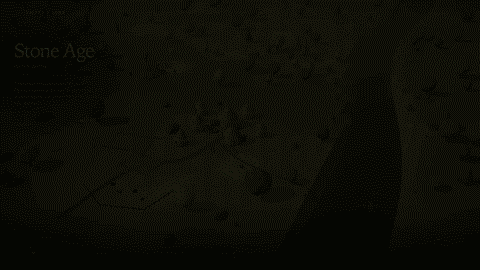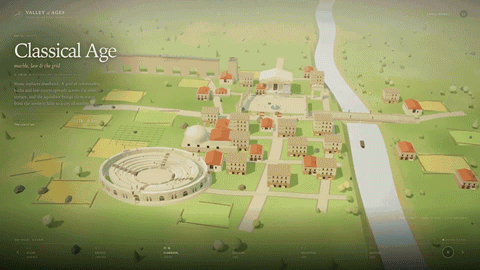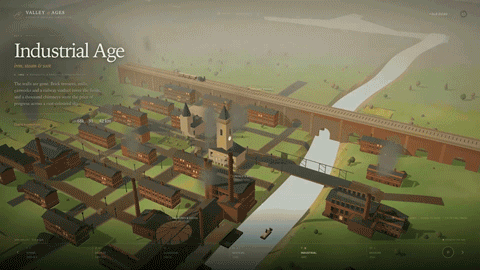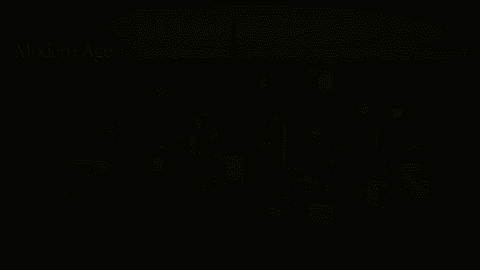
O quarto exemplo, Valley of Ages, apresenta um povoado que muda ao longo de diferentes períodos históricos. Edifícios e infraestrutura evoluem em torno da mesma paisagem fluvial, passando de povoamentos iniciais a formas urbanas industriais e modernas.
A fonte atribui as melhorias na criação de projetos do zero ao aprendizado por reforço com autoavaliação. O changelog oficial e o cartão do modelo consultados para este artigo confirmam a atualização de capacidade, mas não apresentam uma descrição completa desse processo de treinamento. Portanto, a explicação específica sobre o treinamento continua sendo uma afirmação atribuída ao relatório.
Esses exemplos apontam para um padrão de desenvolvimento útil: inspecionar um protótipo executável e, em seguida, revisar seu comportamento e apresentação. Uma demonstração selecionada não comprova que o resultado esteja pronto para produção, que haja direitos sobre recursos de terceiros ou qual foi o nível de iteração humana necessário para chegar ao resultado final.
A comparação oficial relata ganhos em raciocínio, programação, agentes e tarefas visuais. A tabela a seguir mantém os resultados anteriores e novos listados no cartão do modelo:
| Benchmark | V4.1 Flash anterior | V4.1 Flash 1017 |
|---|---|---|
| HLE, sem ferramentas | 36.8 / 39.1 somente texto | 42.6 / 44.0 somente texto |
| Terminal-Bench 4.0 | 31.2 | 42.3 |
| DeepSWE v1.1 | 74.2 | 77.0 |
| ProgramBench | 20.3 | 29.1 |
| NL2Repo-Bench | 65.4 | 68.2 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 |
| Agents' Last Exam | 31.8 | 35.4 |
| Apex Bench v1.1 | 64.6 | 72.1 |
| Chartography, com ferramentas | 78.9 | 83.0 |
| BabyVision, com ferramentas | 89.6 | 92.5 |
| ZeroBench-main, com ferramentas | 49.0 | 51.0 |
Os valores de HLE referentes somente a texto correspondem a um subconjunto e não devem ser confundidos com a pontuação completa do benchmark. A DeepSeek informa que o Terminal-Bench 4.0 usou o harness Claude Code, o DeepSWE v1.1 usou Mini-SWE-V2 e o ZeroBench-main usou Pass@5.
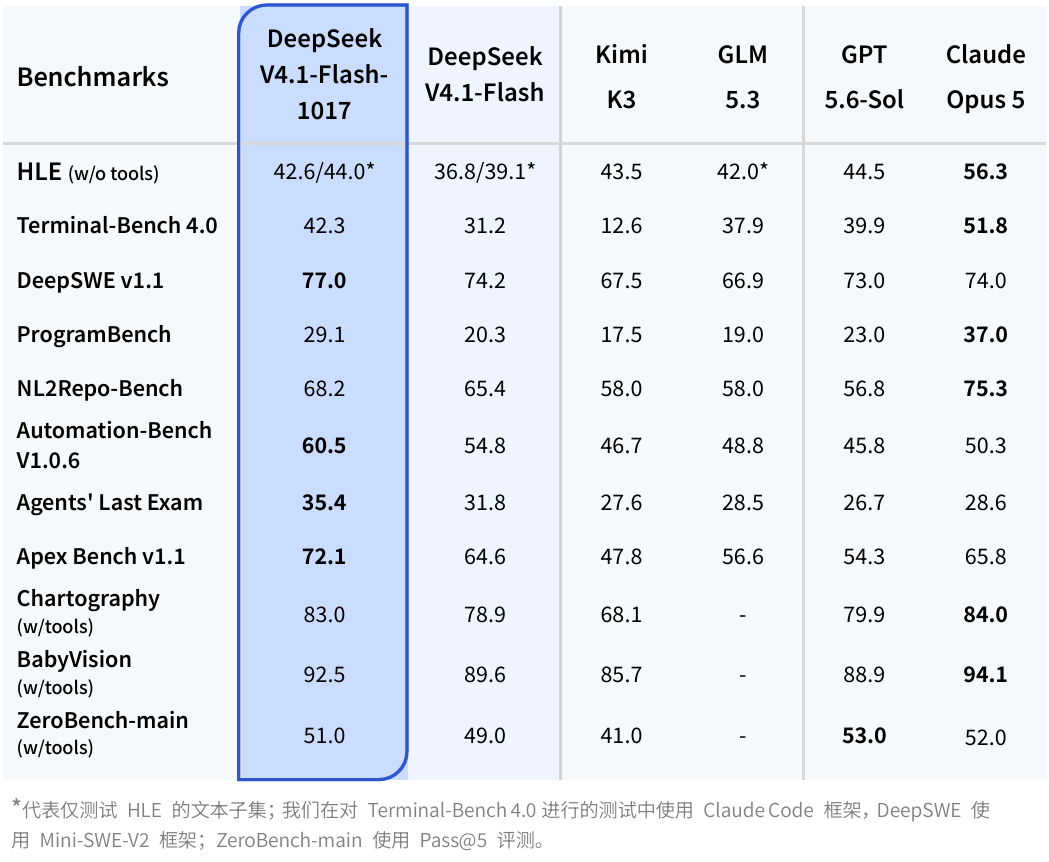
Tabela comparativa do editor reproduzida no relatório de origem.
Na tabela comparativa da DeepSeek, o novo modelo supera as alternativas listadas em DeepSWE, Automation-Bench, Agents' Last Exam e Apex Bench. Ele não lidera em todas as linhas: por exemplo, os resultados exibidos do Opus 5 continuam superiores no Terminal-Bench 4.0 e no ProgramBench. Afirmar que o modelo supera universalmente outros modelos de fronteira iria além do que esses resultados demonstram.
A fonte também destaca um resultado de 77% em DeepSWE Pass@1, com custo aproximado de US$ 0,20 por tarefa, na comparação de custos do editor, diante de um resultado de 74% para GPT-6 Astra. Trata-se de uma comparação específica entre benchmark e harness, não de uma classificação geral de preço ou capacidade para todo tipo de trabalho de programação.
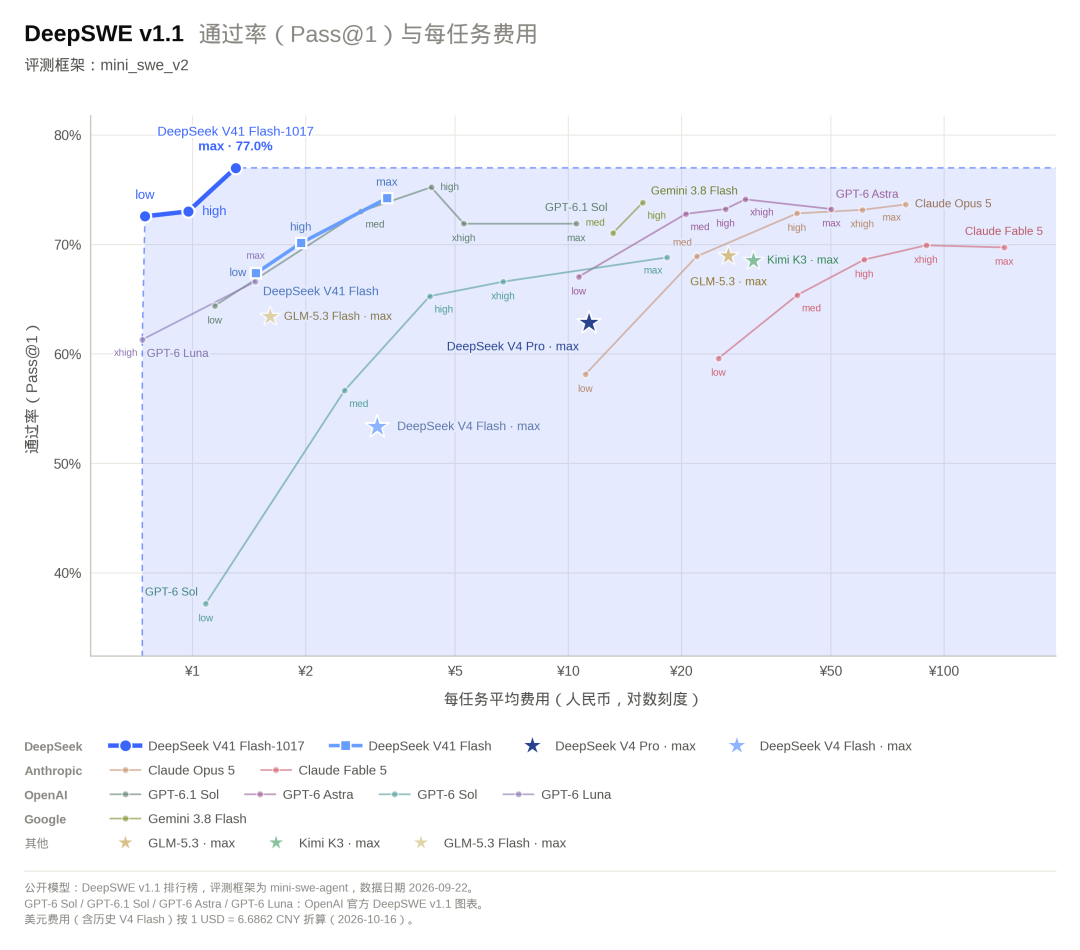
Comparação de custos por tarefa da DeepSeek, conforme reproduzida pela fonte.
A DeepSeek descreve a atualização como uma melhoria na fronteira de Pareto entre desempenho e custo em vários harnesses: mais tarefas concluídas com sucesso, menor tempo de execução e respostas mais curtas. Mesmo com as tarifas por token inalteradas, a conta total pode ser menor quando uma tarefa consome menos tokens ou exige menos tentativas, mas a economia real depende da carga de trabalho.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
O changelog recomenda DeepSeek Harness 0.2.1-rc.1 ou posterior para o novo modelo. Essa é uma recomendação para essa integração, não uma exigência para renomear o modelo da API.
A DeepSeek publica os pesos da versão 1017 em seu repositório oficial no Hugging Face, e a fonte também inclui um link para uma versão no ModelScope. O cartão oficial do modelo informa que o repositório e os pesos usam a Licença MIT.
Pesos abertos não significam que a implantação local seja leve. A página do Hugging Face lista 763 bilhões de parâmetros totais e direciona os usuários às instruções de inferência e conversão de pesos do repositório. Também informa que esta versão não tem um modelo de chat no formato Jinja: um codificador de referência e o kit de ferramentas mantido deepseek-recipe cuidam do formato dos prompts.
Junto com a atualização do modelo, a DeepSeek abriu duas APIs de conteúdo da Web:
A DeepSeek afirma que seu mecanismo interno indexa centenas de bilhões de páginas, processa centenas de milhões de solicitações diárias e filtra spam de SEO, manipulação de GEO e conteúdo de baixa qualidade gerado por IA. Essas são afirmações da empresa sobre escala e filtragem, não medições auditadas de forma independente neste artigo.
| API | Documentação em chinês | Documentação em inglês | Condição de cobrança |
|---|---|---|---|
| Search | RMB 5 por 1.000 solicitações bem-sucedidas | US$ 0,75 por 1.000 solicitações bem-sucedidas | HTTP 200 com um array de resultados não vazio |
| Fetch | RMB 5 por 1.000 solicitações bem-sucedidas | US$ 0,75 por 1.000 solicitações bem-sucedidas | HTTP 200 com o conteúdo da página retornado |
Solicitações com falha, tempos limite excedidos e resultados de busca vazios não são cobrados. A quantidade de resultados da busca não altera o preço por solicitação, e Search e Fetch são cobrados separadamente dos tokens do modelo.
Data de início da cobrança: A documentação informa que as chamadas de Search/Fetch no servidor feitas pela API DeepSeek no DeepSeek Harness, Claude Code ou Codex não são cobradas no momento. A cobrança por solicitação começa às 00:00, horário de Pequim, em 1º de novembro de 2026. Esse acordo temporário específico não deve ser descrito como acesso permanentemente gratuito à API Search.
O nome oficial do modelo continua sendo deepseek-flash. A DeepSeek informa que seu site, aplicativo e API passaram a usar a nova versão sem alterar, nesta atualização, o método de chamada nem os preços dos tokens do modelo.
A DeepSeek relata menor tempo de execução, respostas mais curtas e melhores resultados de desempenho e custo em suas avaliações. O custo total continua dependendo do consumo de tokens, das novas tentativas, das ferramentas e de o projeto gerado realmente atender à tarefa.
Sim. O cartão oficial no Hugging Face informa que o repositório e os pesos estão licenciados sob a MIT. A implantação local ainda exige infraestrutura adequada e o uso das instruções de codificação e inferência do repositório.
Não. É um resultado medido com o harness de avaliação Mini-SWE-V2, não uma garantia para um projeto diferente. As demonstrações visuais também precisam ser inspecionadas e testadas antes que seu código seja usado além de um protótipo.
Search localiza páginas relevantes na Web e retorna resultados estruturados. Fetch recupera o conteúdo de uma página específica em Markdown, sujeito à disponibilidade e às políticas de acesso do site.
As chamadas temporariamente não cobradas no servidor descritas para DeepSeek Harness, Claude Code e Codex terminam às 00:00, horário de Pequim, em 1º de novembro de 2026. Consulte a página de preços aplicável para verificar as tarifas atuais independentes e regionais, pois os tokens do modelo e as solicitações às ferramentas têm cobranças separadas.
O DeepSeek V4.1 Flash 1017 melhora os resultados de avaliação de programação e agentes publicados pela empresa, sem alterar o alias da API nem o preço dos tokens do modelo. As demonstrações mostram protótipos visuais completos, e os pesos estão disponíveis sob os termos da licença MIT.
O lançamento de Search e Fetch acrescenta um caminho independente para encontrar uma página e ler seu conteúdo, com cobrança por solicitação. Avalie em conjunto a qualidade do projeto, o custo total da tarefa e as cobranças das ferramentas antes de tomar uma decisão de implantação com base em um ganho de benchmark.
Comece com uma frase e tenha um site completo em minutos.



