O DeepSeek V4 Flash 0731 gerou uma combinação incomum de reações. Os desenvolvedores estão impressionados com suas pontuações em agentes de ...
O DeepSeek V4 Flash 0731 gerou uma combinação incomum de reações.
Desenvolvedores estão impressionados com suas pontuações em agentes de codificação.
Equipes de infraestrutura estão interessadas em seu contexto de 1 milhão de tokens e no baixo número de parâmetros ativos.
Plataformas de IA estão oferecendo uso gratuito e descontos agressivos.
E as redes sociais estão se enchendo de capturas de tela de protótipos cujas faturas de inferência relatadas são medidas em centavos, não em dólares.
Os exemplos mais amplamente compartilhados no artigo de origem incluíam:
Esses exemplos capturam o entusiasmo, mas também podem confundir várias coisas distintas:
O modelo é genuinamente barato.
Isso não significa que toda aplicação custará sete centavos.
A pergunta útil não é se um demo viral é reproduzível exatamente. É como o DeepSeek alcançou um salto tão grande de capacidade sem mudar a arquitetura base — e o que a nova economia significa para os desenvolvedores.
O preço oficial da API já era baixo antes da aplicação das promoções de terceiros.
O DeepSeek atualmente lista os seguintes preços por milhão de tokens:
| Tipo de uso | Preço do DeepSeek V4 Flash |
|---|---|
| Entrada, cache com acerto | $0,0028 |
| Entrada, cache com erro | $0,14 |
| Saída | $0,28 |
A API suporta:
low, high e max.Esses preços oficiais são a linha de base.
As plataformas podem então escolher:
É por isso que um desenvolvedor pode pagar o preço de tabela do DeepSeek enquanto outro não paga nada por um período limitado.
A OpenCode declarou publicamente que o DeepSeek Flash processou 8 trilhões de tokens em 1º de agosto por meio de sua plataforma.
A publicação detalha o número da seguinte forma:
5T tokens de uso gratuito
+
3T tokens por meio do OpenCode Go

A documentação Zen atual da OpenCode lista uma opção DeepSeek V4 Flash Free disponível por tempo limitado.
Essa é uma distinção importante.
O número de oito trilhões de tokens descreve o tráfego por meio da OpenCode, não o uso direto relatado pela DeepSeek em todas as plataformas.
Ainda assim, é um forte sinal de que modelos de baixo custo podem gerar uma demanda enorme quando são colocados dentro de um fluxo de trabalho popular de agente de codificação.
A Nous Research anunciou uma promoção de sete dias oferecendo o DeepSeek V4 Flash 0731 com 90% de desconto por meio do Nous Portal, em parceria com a Novita Labs.

A publicação promocional comparou o custo com desconto ao do Claude Fable 5 e afirmou uma diferença de preço de mais de 1.000 vezes em tarefas comparáveis.
Essa comparação depende de várias escolhas:
Uma comparação de preço por token é útil, mas a métrica mais significativa é:
Custo total por tarefa aceita
Um modelo que usa menos tokens caros pode ser mais barato do que um modelo de baixo preço que tenta repetidamente.
Por outro lado, quando um modelo de baixo preço também é capaz o suficiente para concluir a tarefa rapidamente, a vantagem de custo pode se tornar enorme.
A Cline anunciou inicialmente o uso gratuito do V4 Flash 0731 por meio de seu agente de codificação.
Uma publicação pública posterior afirmou que a cota gratuita foi triplicada porque a economia parecia sustentável.

O catálogo de modelos atual da Cline e os materiais do ClinePass incluem o DeepSeek V4 Flash como uma opção rápida e orientada a valor para tarefas de codificação focadas.
Cotas gratuitas e disponibilidade de modelos podem mudar, portanto, os usuários devem verificar a página do provedor ao vivo em vez de confiar em uma captura de tela antiga.
A lição mais ampla é mais duradoura.
Quando a inferência se torna barata o suficiente, uma plataforma de agentes pode usar o acesso gratuito como aquisição de clientes sem absorver
o mesmo custo que enfrentaria com um modelo premium de fronteira.
O artigo de origem inclui um painel mostrando:
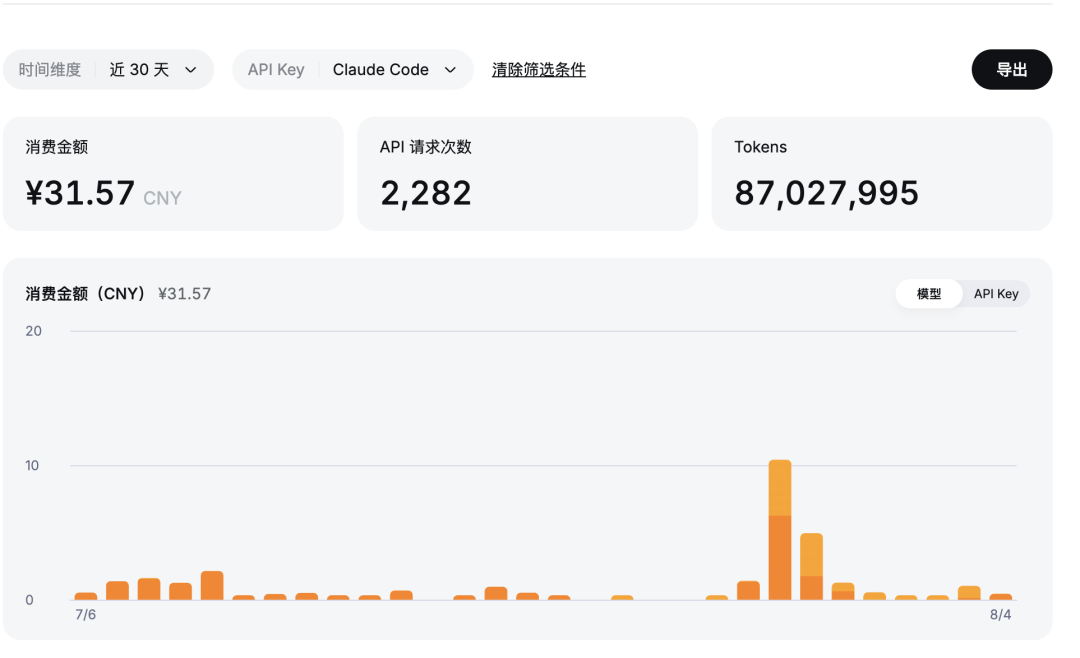
A captura de tela é útil porque demonstra a ordem de grandeza que os desenvolvedores podem observar em padrões de uso favoráveis.
Ela não revela informações suficientes para reconstruir a fatura com exatidão.
As variáveis ausentes incluem:
Um prompt de sistema longo e repetido pode ser extremamente barato quando atinge o cache.
Um prompt longo e único enviado uma vez é cobrado pelo preço de entrada com ausência de cache.
A saída também é muito mais cara do que a entrada com cache.
Para sistemas de agentes, essas diferenças dominam a fatura final.
O DeepSeek V4 Preview foi lançado em 24 de abril de 2026.
A família continha:
O lançamento do Preview estabeleceu a arquitetura principal:
O V4 Flash Preview foi posicionado como a alternativa menor, mais rápida e mais barata ao V4 Pro.
A atualização de 31 de julho mudou sua posição competitiva.
A DeepSeek afirma que o V4 Flash 0731 usa a mesma arquitetura e tamanho de modelo do V4 Flash Preview.
A atualização foi produzida pela execução de um novo processo de pós-treinamento.
Em forma simplificada:
Mesma arquitetura base pré-treinada
+
novo pós-treinamento e otimização de agentes
=
comportamento de agente de codificação muito mais forte
Isso é relevante porque mostra quanta capacidade pode permanecer latente em um modelo pré-treinado.
Arquitetura e contagem de parâmetros não são o produto inteiro.
O pós-treinamento determina a eficácia com que o modelo:
O cartão do modelo V4 Flash original descreve o modelo base como:
| Especificação | DeepSeek V4 Flash |
|---|---|
| Parâmetros MoE base totais | 284B |
| Parâmetros ativados | 13B |
| Comprimento do contexto | 1M |
| Licença | MIT |
| Modalidade principal | Texto |
| Precisão base | FP8 / precisão mista baixa dependendo do checkpoint |
O cartão do modelo 0731 afirma que o novo lançamento tem a mesma estrutura da variante DSpark e inclui um módulo anexo de decodificação especulativa.
Isso explica por que alguns metadados de arquivos do modelo podem mostrar
contagem total de checkpoints maior do que o valor base de 284B do MoE.
A descrição mais clara é:
O modelo MoE subjacente do V4 Flash permanece com aproximadamente 284B no total e 13B de parâmetros ativos, enquanto o lançamento 0731 inclui o componente adicional de decodificação especulativa DSpark no checkpoint publicado.
A decodificação especulativa usa um processo de rascunho rápido para propor vários tokens futuros.
O modelo principal então verifica essas propostas.
Quando as previsões são aceitas, o sistema pode produzir múltiplos tokens com menos trabalho sequencial.
O card do modelo 0731 da DeepSeek fornece suporte explícito ao DSpark para vLLM e SGLang.
Para vLLM, a configuração relevante é:
--speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Para SGLang, o card do modelo usa:
--speculative-algorithm DSPARK
O DSpark não melhora o raciocínio do modelo por si só.
É uma otimização de inferência destinada a reduzir a latência de decodificação ou aumentar a taxa de transferência, preservando a distribuição de saída do modelo alvo sob a configuração suportada.
A DeepSeek publica a seguinte comparação para o V4 Flash 0731:
| Benchmark | V4 Flash 0731 | V4 Flash Preview | V4 Pro Preview |
|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 61.8 | 72.1 |
| NL2Repo | 54.2 | 39.4 | 38.5 |
| CyberGym | 76.7 | 38.7 | 52.7 |
| DeepSWE | 54.4 | 7.3 | 12.8 |
| Toolathlon-Verified | 70.3 | 49.7 | 55.9 |
| Agents’ Last Exam | 25.2 | 15.8 | 16.5 |
| AutomationBench Public | 25.1 | 10.8 | 12.8 |
| DSBench-FullStack | 68.7 | 37.0 | 41.8 |
| DSBench-Hard | 59.6 | 25.8 | 31.1 |
O aumento mais drástico é no DeepSWE:
7.3 → 54.4
O CyberGym quase dobra:
38.7 → 76.7
O Terminal Bench 2.1 sobe mais de vinte pontos:
61.8 → 82.7
O novo modelo Flash também supera o V4 Pro Preview em todos os benchmarks da tabela publicada pela DeepSeek.
Isso é uma mudança importante para um modelo originalmente posicionado principalmente como a opção mais barata e rápida.
A tabela não deve ser lida como uma comparação pura de checkpoints brutos.
O card do modelo da DeepSeek inclui várias notas importantes.
Para tarefas públicas de agentes de código, a empresa usou:
DeepSeek Harness modo mínimo
Esforço de raciocínio: máximo
Temperatura: 1.0
Top-p: 0.95
O DeepSeek Harness não havia sido lançado publicamente no momento da verificação.
Isso significa que pesquisadores externos podem ainda não ser capazes de reproduzir o ambiente de software exato usado para os resultados publicados de agentes de código.
Dois testes também são internos:
Benchmarks internos podem ser úteis para o desenvolvimento de produtos, mas equipes independentes não podem inspecionar suas tarefas ocultas ou controles de contaminação.
A interpretação correta é:
A DeepSeek relata uma grande melhoria sob sua pilha de agentes e configuração de avaliação escolhidas. A reprodutibilidade pública melhorará quando o harness, prompts, logs e a configuração completa de avaliação estiverem disponíveis.
Um benchmark de código frequentemente mede um sistema completo:
Modelo
+
prompt do sistema
+
ferramentas de repositório
+
terminal

execução
+
gerenciamento de contexto
+
política de repetição
+
feedback de teste
+
lógica de envio de patch
O mesmo modelo pode pontuar de forma diferente quando um componente muda.
Um harness melhor pode:
Isso não torna o modelo irrelevante.
Significa que o resultado do benchmark pertence à combinação modelo-e-harness.
Os fortes números de 0731 sugerem que a DeepSeek melhorou tanto o comportamento de agente do modelo quanto o processo de avaliação ao redor.
A Artificial Analysis reporta uma pontuação de Índice de Inteligência de aproximadamente 50 para o DeepSeek V4 Flash 0731, cerca de dez pontos acima da versão Flash anterior.
A empresa independente de análise de modelos também descreve o V4 Flash como excepcionalmente barato em relação a outros sistemas de fronteira bem conhecidos.
A Reuters resumiu as descobertas da Artificial Analysis ao relatar um custo médio de teste de benchmark de aproximadamente três centavos de dólar americano sob sua metodologia.
Essa comparação apoia o argumento de valor.
Não significa que toda tarefa de produção custa três centavos.
A Artificial Analysis também relata resultados mais fracos em algumas medidas de confiabilidade do conhecimento.
Seu artigo sobre o V4 Flash 0731 observa:
Esses números são um lembrete útil.
Um modelo pode ser:
"Melhor valor" não é o mesmo que "melhor para toda tarefa."
O preço direto da API DeepSeek é:
| Categoria de cobrança | Preço por 1M de tokens |
|---|---|
| Entrada com cache hit | $0,0028 |
| Entrada com cache miss | $0,14 |
| Saída | $0,28 |
A diferença de preço entre cache hit e cache miss é enorme:
$0,14 ÷ $0,0028 = 50
Entrada em cache é cinquenta vezes mais barata que entrada sem cache.
Para agentes de longa duração, a estrutura do prompt torna-se arquitetura de custo.
Suponha que uma solicitação use:
100.000 tokens de entrada sem cache
20.000 tokens de saída
O custo direto do modelo é:
Entrada:
100.000 / 1.000.000 × $0,14
= $0,014

Saída:
20.000 / 1.000.000 × $0,28
= $0,0056

Total:
$0,0196
Isso é menos de dois centavos de dólar americano.
Agora suponha que o mesmo prefixo de 100.000 tokens esteja em cache:
Entrada em cache:
100.000 / 1.000.000 × $0,0028
= $0,00028

Saída:
20.000 / 1.000.000 × $0,28
= $0,0056

Total:
$0,00588
A saída agora domina a conta.
Esses exemplos explicam por que protótipos de codificação de baixo custo são plausíveis.
Eles não incluem:
Codificação agêntica raramente é uma única solicitação.
Um fluxo de trabalho típico pode incluir:
falha.
7. Edite novamente.
8. Execute os testes novamente.
9. Revise o diff.
10. Produza a resposta final.
Cada etapa pode gerar outra chamada de modelo.
Uma tarefa aparentemente pequena pode se tornar cara quando:
O V4 Flash reduz o preço desses erros.
Ele não os elimina.
A DeepSeek usa cache de contexto baseado em disco.
Quando o mesmo prefixo é reutilizado, os tokens de entrada correspondentes podem receber o preço menor de cache hit.
Bons candidatos para um prefixo estável incluem:
Um design simplificado de prompt é:
Prefixo estável reutilizável
+
nova solicitação do usuário
+
resultado mais recente da ferramenta
Um design menos favorável ao cache é:
Instruções reordenadas
+
resumo reescrito do repositório
+
carimbos de data/hora variáveis
+
metadados aleatórios de solicitação
+
nova solicitação do usuário
Pequenas alterações no prefixo podem reduzir a reutilização do cache.
Os desenvolvedores devem inspecionar os campos de uso de tokens, em vez de assumir que um prompt longo foi armazenado em cache.
A DeepSeek também oferece isolamento por user_id para privacidade e agendamento. A reutilização de cache e o isolamento de usuário devem ser projetados juntos para que o contexto de um cliente não seja acidentalmente misturado com o de outro.
A URL base oficial permanece:
https://api.deepseek.com
O ID do modelo é:
deepseek-v4-flash
A DeepSeek afirma que o ID estável da API serve automaticamente a versão Flash oficial mais recente.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Isso é conveniente, mas as equipes de produção devem registrar a impressão digital do modelo retornada e testar alterações, pois o comportamento por trás de um ID estável pode ser atualizado.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-flash",
    messages=[
        {
            "role": "user",
            "content": "Revise esta função e proponha uma refatoração segura.",
        }
    ],
)

print(response.choices[0].message.content)
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-flash",
    "messages": [
      {
        "role": "user",
        "content": "Escreva um pequeno CLI em Python que valide arquivos JSON."
      }
    ]
  }'
Os desenvolvedores devem verificar a referência da API ao vivo para os campos exatos de esforço de raciocínio e modo de pensamento suportados pelo seu endpoint e versão do SDK.
A documentação do modo de pensamento da DeepSeek afirma que, quando uma rodada inclui chamadas de ferramenta, o reasoning_content da mensagem do assistente deve ser passado de volta em solicitações subsequentes.
Um agente de múltiplas rodadas deve preservar:
contentreasoning_content
tool_callsDescartar o estado de raciocínio pode reduzir a continuidade ou causar problemas de validação de solicitação.
Isso é especialmente relevante ao integrar por meio de um cliente compatível com OpenAI que normalmente ignora campos de raciocínio específicos do provedor.
A DeepSeek oferece mais de uma interface.
Use o URL base padrão da DeepSeek e o ID do modelo:
deepseek-v4-flash
A DeepSeek também documenta uma interface no formato Anthropic.
Isso pode ajudar softwares construídos em torno de mensagens no estilo Claude a se conectarem à DeepSeek com menos alterações no aplicativo.
A compatibilidade não garante comportamento idêntico.
Campos específicos do provedor, histórico de raciocínio, esquemas de ferramentas, comportamento de segurança e tratamento de erros ainda exigem testes.
A DeepSeek afirma que o lançamento 0731 suporta nativamente o formato Responses API e foi adaptado para uso no estilo Codex.
Isso é importante para produtos de agentes de codificação que dependem cada vez mais de objetos de resposta com estado, chamadas de ferramentas e loops estruturados de agentes.
A DeepSeek lançou os pesos do V4 Flash 0731 no Hugging Face sob a Licença MIT.
Isso permite que desenvolvedores inspecionem, modifiquem, implantem e redistribuam o modelo sujeitos aos termos da licença.
O lançamento de pesos abertos oferece mais controle do que um modelo apenas por API.
As equipes podem:
A barreira prática é o hardware.
"Pesos abertos" não significa "roda em um notebook comum".
O card oficial do modelo 0731 fornece um exemplo de vLLM para um único nó 4×GB300:
vllm serve deepseek-ai/DeepSeek-V4-Flash-0731 \
  --trust-remote-code \
  --kv-cache-dtype fp8 \
  --block-size 256 \
  --data-parallel-size 4 \
  --enable-expert-parallel \
  --moe-backend deep_gemm_mega_moe \
  --attention-config '{"use_fp4_indexer_cache": true}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Este exemplo demonstra a classe de infraestrutura esperada para servir com qualidade total.
Não deve ser interpretado como a única configuração suportada.
A receita do vLLM pode adicionar suporte a outras topologias de GPU ao longo do tempo.
O exemplo oficial do SGLang é:
sglang serve \
  --trust-remote-code \
  --model-path deepseek-ai/DeepSeek-V4-Flash-0731 \
  --tp 4 \
  --moe-runner-backend flashinfer_mxfp4 \
  --speculative-algorithm DSPARK \
  --mem-fraction-static 0.90 \
  --chunked-prefill-size 4096 \
  --swa-full-tokens-ratio 0.1
Os pesos alvo e de rascunho vêm do mesmo checkpoint, então a documentação diz para não definir um caminho separado de modelo de rascunho especulativo.
Os mecanismos de inferência evoluem rapidamente.
Use o card do modelo atual e a receita do mecanismo de serviço, em vez de copiar um comando antigo de inicialização da versão Preview.
Mesmo que apenas cerca de
13B parâmetros estão ativos para um token, os pesos completos do modelo devem permanecer disponíveis em todo o sistema de serviço.
O planejamento de implantação deve considerar:
Quantizações menores podem tornar a experimentação possível em diferentes hardwares, mas podem alterar a qualidade, a velocidade ou o comprimento do contexto suportado.
Para a maioria dos desenvolvedores individuais, a API direta ou um provedor hospedado será mais fácil e mais barato do que o auto-hospedagem.
Existem três maneiras comuns de usar o V4 Flash.
| Rota | Principal vantagem | Principal desvantagem |
|---|---|---|
| API DeepSeek | Preço oficial e modelo oficial atual | Os dados saem do seu ambiente; o ID estável pode ser atualizado |
| Plataforma de terceiros | Cotas gratuitas, agentes integrados, faturamento mais fácil | Promoções e roteamento podem mudar |
| Pesos auto-hospedados | Controle máximo e privacidade | Requisitos significativos de hardware e engenharia |
A rota mais barata depende da carga de trabalho.
Uma cota gratuita do Cline ou OpenCode pode ser melhor para experimentação.
A API direta pode ser melhor para uso previsível em pequena escala.
O auto-hospedagem pode se tornar atraente apenas em volumes suficientemente altos e sustentados ou quando os requisitos de privacidade dominam.
O artigo de origem compara IA barata com a produção em massa de automóveis.
A analogia é imperfeita, mas útil.
Quando uma tecnologia se torna drasticamente mais barata, o mercado não compra simplesmente a mesma quantidade por menos dinheiro.
Novos usos se tornam possíveis.
Modelos de agentes de baixo custo podem suportar experimentos que anteriormente seriam rejeitados antes dos testes.
Exemplos incluem:
O valor não é que o modelo substitua toda a engenharia de software.
Ele reduz o custo de perguntar:
Vale a pena desenvolver esta ideia?
Geração barata pode produzir uma primeira demonstração convincente.
Um produto de produção ainda precisa de:
Uma conta de modelo de sete centavos não significa um negócio de sete centavos.
Significa que o primeiro experimento computacional pode ser barato o suficiente para ser tentado.
Isso muda quem pode participar e quantas ideias podem ser testadas.
O artigo de origem inclui um espaço de trabalho documental leve mostrado como um exemplo do que os desenvolvedores estavam construindo com agentes de codificação baratos.
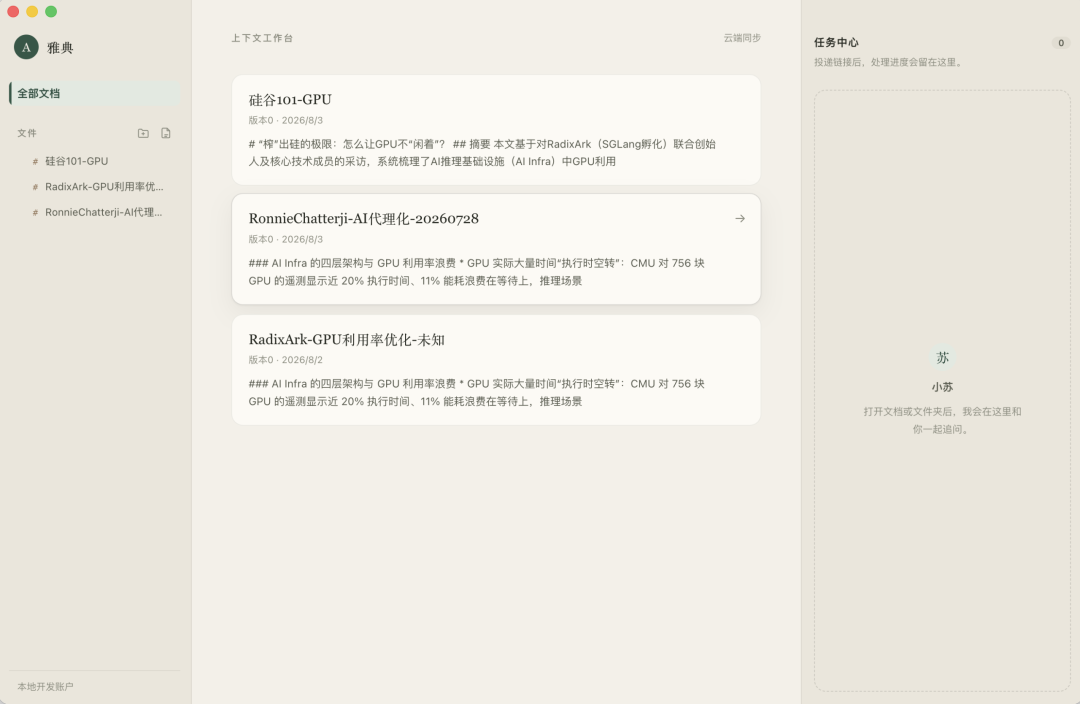
Uma captura de tela não pode estabelecer quanto do aplicativo foi produzido pelo modelo, quanto de edição humana foi necessária ou se o produto é seguro e sustentável.
Ela mostra o tipo de projeto que modelos de codificação de baixo custo tornam mais fácil de prototipar.
O V4 Flash 0731 é especialmente atraente quando:
Pode ser menos adequado quando:
Um roteador de modelos pode combinar o Flash com um sistema mais forte ou mais especializado.
Por exemplo:
Edições rotineiras de repositório
→ V4 Flash

Decisões de arquitetura ou segurança de alto risco
→ modelo mais forte + revisão humana
Quando as chamadas de modelo são caras, os desenvolvedores tentam minimizar cada solicitação.
Quando as chamadas se tornam baratas, um agente pode se dar ao luxo de:
Isso pode aumentar a confiabilidade.
Também pode desperdiçar tokens.
O objetivo certo não é o uso mínimo de tokens.
É:
Menor custo total que atinge a qualidade exigida
A DeepSeek descreve a API oficial do Flash como uma versão beta pública.
Preços, comportamento, limites e versões do modelo podem mudar.
Equipes de produção devem manter testes de regressão.
Os melhores resultados com agentes de código usam uma configuração de estrutura não publicada.
A reprodução independente exata ainda não é simples.
Saída, tentativas, ferramentas e contexto não armazenado em cache podem dominar o custo final.
Uma janela de 1 milhão de tokens é um limite de capacidade, não uma recomendação para enviar um milhão de tokens em cada solicitação.
Cargas de trabalho com preenchimento grande aumentam a latência e o custo.
A avaliação independente mostra que o valor e a força em codificação podem coexistir com uma alta taxa de alucinação em testes factuais.
Fatos críticos devem ser verificados em relação às fontes.
Modelos de baixo custo podem gerar mais código do que uma equipe pode inspecionar com segurança.
Testes automatizados, análise estática, verificação de dependências e revisão humana continuam sendo necessários.
Modelos gratuitos de terceiros e descontos podem desaparecer.
Não construa um modelo de negócios permanente em torno de um subsídio de sete dias ou por tempo limitado.
O ID do modelo deepseek-v4-flash aponta para a versão atual.
Uma atualização por trás desse ID pode alterar as saídas sem que haja mudança de código no seu aplicativo.
Mantenha instruções de sistema e definições de ferramentas consistentes para melhorar a reutilização de cache.
Não dependa apenas do total de tokens de entrada.
Defina um orçamento de saída realista para a tarefa.
Reserve max para tarefas que se beneficiam de deliberação mais longa.
Interrompa loops que não estão progredindo.
Use linters, testes, validadores de esquema e verificações determinísticas.
Escale somente quando a tarefa falhar em um teste ou exceder um limite de risco.
Inclua tentativas falhas e revisão humana.
O artigo de origem termina com um possível próximo passo no ecossistema de desenvolvedores da DeepSeek.
Tianyi Cui, identificado na fonte como o responsável pelo DeepSeek Harness, publicou uma mensagem de recrutamento para desenvolvedores de projetos open-source de agent-harness.
A mensagem convidava desenvolvedores interessados a compartilhar uma conta do GitHub e trabalhos open-source representativos para participar de testes internos.
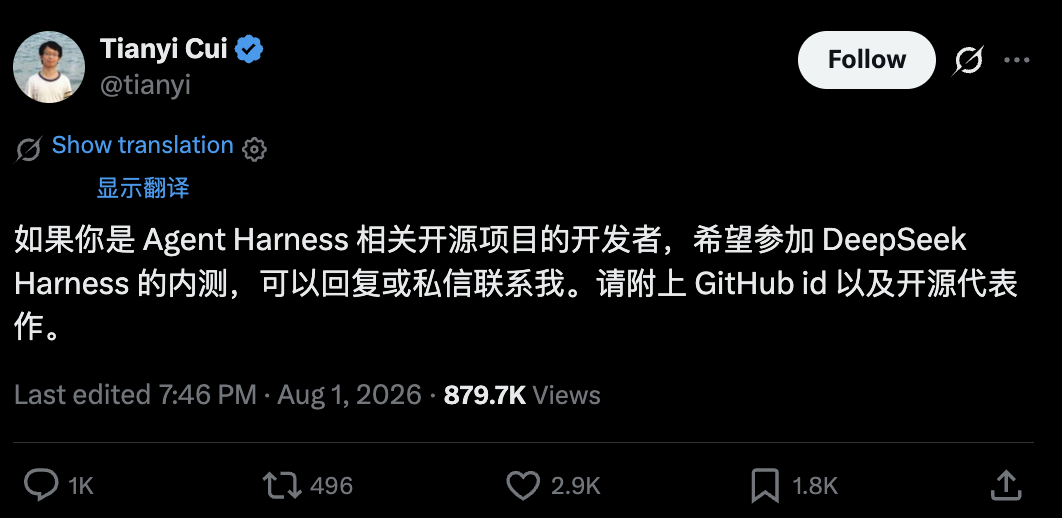
O changelog da DeepSeek de 31 de julho também afirma que o modo mínimo do DeepSeek Harness usado para avaliação de benchmarks está "a ser lançado em breve".
Até a verificação, não localizei:
As evidências apoiam esta conclusão mais restrita:
A DeepSeek está testando um agent harness e pretende lançar pelo menos parte do framework, mas o nome final do produto, o escopo público e o cronograma de lançamento permanecem não confirmados.
O modelo, a API e os pesos abertos estão disponíveis agora.
O harness ainda é um componente futuro do ecossistema.
Um harness de primeira parte poderia ajudar a DeepSeek a controlar toda a stack de agentes de codificação.
Ele poderia fornecer:
A DeepSeek já documenta integrações com harnesses externos e agentes de codificação.
Uma ferramenta de primeira parte poderia transformar otimizações específicas de benchmarks em um produto que desenvolvedores comuns possam usar.
Ela também poderia revelar quanto do salto nos benchmarks do V4 Flash 0731 vem do checkpoint e quanto vem do runtime do agente.
Vários desdobramentos determinarão se o momento do V4 Flash se tornará uma mudança duradoura no ecossistema.
A DeepSeek afirma que o lançamento oficial do V4 Pro seguirá a atualização do Flash.
A diferença de desempenho e preço entre Pro e Flash afetará as decisões de roteamento.
Um lançamento público melhoraria a reprodutibilidade dos benchmarks e daria aos desenvolvedores um framework de agente nativo do modelo.
O preço direto já é baixo, mas as promoções de terceiros podem não permanecer.
Inferência barata atrai um tráfego muito alto.
Latência, limites de taxa e confiabilidade serão importantes à medida que o uso escala.
vLLM, SGLang, fornecedores de hardware e projetos de quantização determinarão o quão acessível o self-hosting se tornará.
Mais avaliações públicas devem testar:
O DeepSeek V4 Flash 0731 é o lançamento oficial de 31 de julho do V4 Flash, atualmente servido através da API deepseek-v4-flash em beta público. A DeepSeek afirma que ele mantém a arquitetura e o tamanho base do modelo Preview, enquanto melhora substancialmente as capacidades de agente por meio de novo pós-treinamento.
A API oficial da DeepSeek lista US$ 0,14 por milhão de tokens de entrada sem cache, US$ 0,0028 por milhão de tokens de entrada com cache e US$ 0,28 por milhão de tokens de saída. Plataformas de terceiros podem oferecer preços diferentes, cotas gratuitas ou descontos temporários.
O artigo de origem cita um exemplo da comunidade com esse custo de modelo relatado. O exemplo não é acompanhado de prompts completos, logs de tokens, dados de cache, tentativas, custos de ferramentas ou registros de trabalho humano, portanto deve ser tratado como uma anedota, não como um orçamento garantido.
A DeepSeek relata 82,7 no Terminal Bench 2.1, 76,7 no CyberGym, 54,4 no DeepSWE, 70,3 no Toolathlon-Verified e 54,2 no NL2Repo. As avaliações públicas de agentes de código usaram o modo mínimo não lançado do DeepSeek Harness com esforço máximo de raciocínio.
Os pesos do modelo e o repositório são lançados sob a Licença MIT, portanto "pesos abertos" e uso amplamente permissivo são descrições precisas. Executar o checkpoint completo ainda exige infraestrutura substancial de múltiplas GPUs.
Sim, a DeepSeek publica pesos e instruções de serviço para vLLM e SGLang. Os exemplos oficiais em escala completa usam hardware avançado de múltiplas GPUs, portanto um laptop normal não é o ambiente alvo para o modelo completo.
A API oficial e a ficha do modelo especificam uma janela de contexto de 1 milhão de tokens. A API também lista um
comprimento máximo de saída de 384 mil tokens, mas usar o contexto ou a saída máximos pode aumentar significativamente a latência e o uso de recursos.
A DeepSeek referenciou publicamente um modo mínimo do Harness e recrutou desenvolvedores de harness de código aberto para testes internos. Um repositório público completo, a especificação final do produto e uma data de lançamento confirmada não foram localizados durante a verificação.
reasoning_content em chamadas de ferramentas.O DeepSeek V4 Flash 0731 mantém a base do modelo Preview
a arquitetura e o tamanho, mas usa novo pós-treinamento para produzir um grande salto no desempenho de agentes de codificação. A DeepSeek relata 82,7 no Terminal Bench 2.1, 76,7 no CyberGym e 54,4 no DeepSWE, embora os resultados públicos mais fortes de agentes de código dependam de uma configuração não publicada do DeepSeek Harness.
O preço oficial da API é excepcionalmente baixo: US$ 0,14 por milhão de tokens de entrada não armazenados em cache, US$ 0,0028 por milhão de tokens de entrada em cache e US$ 0,28 por milhão de tokens de saída. Cotas gratuitas e descontos de terceiros podem tornar o acesso ainda mais barato, mas essas promoções são temporárias e não devem ser confundidas com o preço permanente.
O lançamento de pesos abertos sob licença MIT, o contexto de 1 milhão de tokens, as APIs compatíveis com Responses e Anthropic, e o suporte em vLLM e SGLang tornam o modelo acessível tanto por rotas hospedadas quanto autogerenciadas. A implantação local completa continua sendo um projeto sério de infraestrutura com múltiplas GPUs.
Os protótipos virais de sete e cinquenta centavos são exemplos plausíveis de quão baixa a conta marginal do modelo pode chegar, mas não são estudos completos de custo do produto. Loops de agentes, tamanho da saída, falhas de cache, ferramentas, testes e trabalho humano ainda importam.
O DeepSeek V4 Flash 0731 é importante não porque todo aplicativo agora custa alguns centavos, mas porque a codificação agêntica capaz se tornou barata o suficiente para que muito mais desenvolvedores experimentem em escala significativa.
Comece com uma frase e tenha um site completo em minutos.



